Tag Archivio per: intelligenza artificiale

Di Gianluigi Bonanomi. Guida verificata il 14 ottobre 2026. Gli esempi numerici e i giocatori indicati con nomi di fantasia sono simulazioni didattiche, non consigli sulla giornata in corso.

L’avatar di Gianluigi Bonanomi come fantallenatore con lavagna tattica e computer
AI per il Fantacalcio: usare dati, regole e domande migliori per scegliere con più criterio.

Il Fantacalcio ha una caratteristica meravigliosa: persone che per acquistare una lavatrice confrontano tre recensioni possono discutere per un’ora sull’opportunità di spendere metà del budget per un attaccante. Poi, quando quell’attaccante prende cinque, la responsabilità è del mister. O del calendario. O di un complotto.

Adesso nella stanza dell’asta può entrare un altro personaggio: l’intelligenza artificiale. Le puoi chiedere di leggere un listone, confrontare due acquisti, controllare i crediti rimasti o spiegarti perché stai costruendo una squadra con sei scommesse e nessuna certezza. Se però la interroghi come un oracolo, rischi di ottenere una risposta molto convincente su una realtà che non esiste più.

In questa guida propongo un uso concreto dell’intelligenza artificiale per il Fantacalcio: preparazione dell’asta, assistenza durante i rilanci, formazione, scambi, analisi della stagione e gestione della lega. Con prompt pronti da adattare, conti leggibili e limiti dichiarati. L’obiettivo è migliorare le decisioni, senza vendere il sogno del chatbot che sa già chi farà doppietta domenica.

Cosa trovi nella guida

Che cosa può fare davvero l’AI per il Fantacalcio

Conviene distinguere tre lavori. Il primo è organizzare le informazioni: riassumere il regolamento, pulire una tabella, trovare incongruenze. Il secondo è valutare alternative: confrontare moduli, budget e scambi usando dati disponibili. Il terzo è fare previsioni: stimare un rendimento o una probabilità con un modello statistico.

Un chatbot che scrive bene non diventa automaticamente un modello predittivo sportivo. Per una decisione ripetibile servono dati aggiornati, criteri espliciti e calcoli controllabili. È utile combinare un assistente conversazionale con statistiche e strumenti specializzati; va verificato, caso per caso, che cosa l’assistente possa effettivamente leggere.

Un esempio importante sono gli expected goals, o xG. Nella spiegazione di Hudl, il valore esprime la probabilità stimata che un tiro diventi gol in base alle caratteristiche considerate dal modello. Un tiro da 0,2 xG non è un quinto di gol già guadagnato: è una stima su situazioni comparabili. Userei gli xG come un elemento del ragionamento, insieme a minuti e contesto, senza trasformare una singola partita in una profezia.

Per il quadro più ampio delle applicazioni sportive puoi leggere anche il mio approfondimento sull’intelligenza artificiale nel calcio.

ChatGPT per il Fantacalcio e app dedicate: quale scegliere?

Non esiste un vincitore universale. Se vuoi lavorare sul tuo regolamento e sui tuoi file, un assistente generalista può essere comodo. Se vuoi previsioni già organizzate per il gioco, ha senso esaminare prodotti dedicati. Quella che segue è una ricognizione delle funzioni descritte dai rispettivi fornitori, verificata il 14 ottobre 2026: non una classifica basata su un campionato di test comparativi.

Strumento Uso da valutare Controllo prima di affidarsi
ChatGPT con i tuoi file Organizzare tabelle, leggere regole, discutere scenari, preparare analisi. Quali file può elaborare nel tuo account? Quali dati ha ricevuto davvero? Le formule sono riproducibili?
FantaData Il sito presenta listoni, stime di FantaMedia, supporto asta, formazione e scambi. Come sono valutate le previsioni? Il rendimento pubblicizzato dal fornitore non è una verifica indipendente.
FantaGPT di Fantacalcio-Online Il fornitore descrive un assistente che usa rosa, crediti e regole della lega, con collegamento MCP. Quali dati sono stati importati? Quali autorizzazioni concede il collegamento?
Predixsport La pagina presenta stime di fantavoto, titolarità e confronto delle formazioni. La beta dichiara un perimetro Classic e specifiche regole supportate. Verificare la compatibilità.
Fantaiuto La pagina descrive formazione, confronti, scambi e supporto al budget d’asta. Non confondere il suo indice proprietario con una probabilità o con un fantavoto.

Per consultare le descrizioni originali: funzioni di FantaData, assistente FantaGPT di Fantacalcio-Online, perimetro del Fantacalcio su Predixsport e strumenti di Fantaiuto. Controlla sul sito le condizioni economiche e le funzioni disponibili quando decidi: possono cambiare.
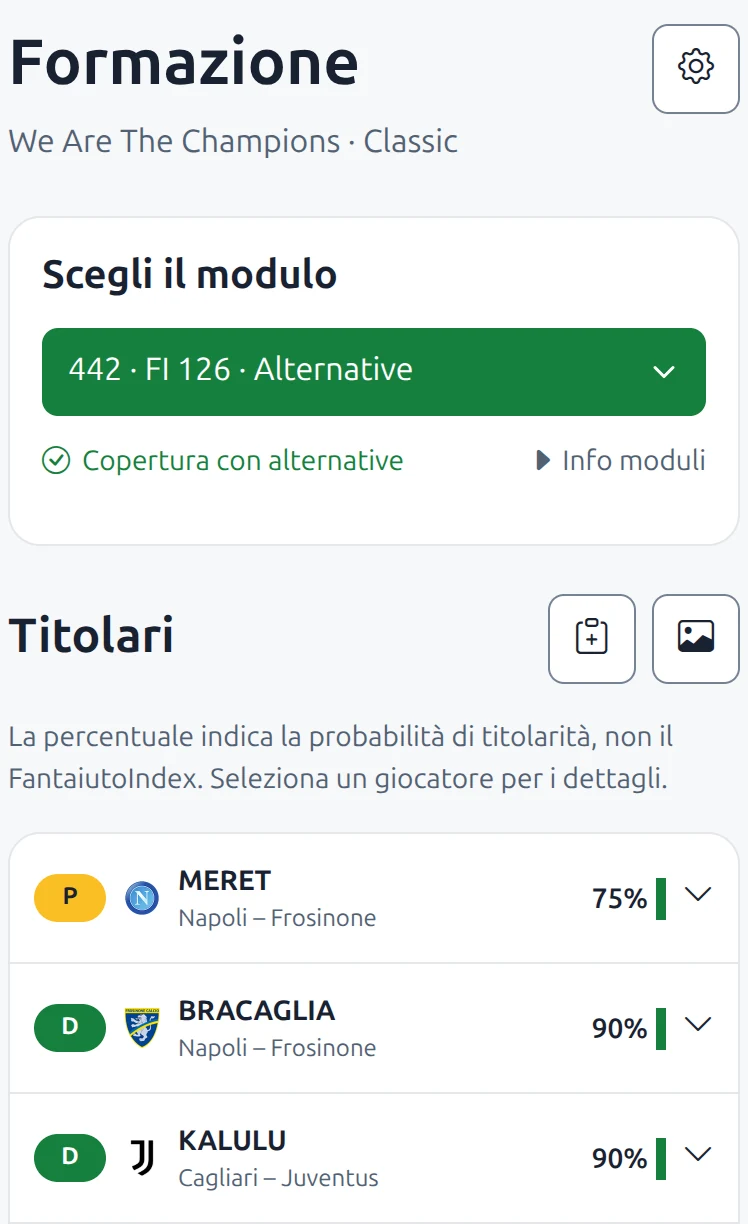
Schermata dimostrativa ufficiale di Fantaiuto con selezione del modulo e indicatori dei giocatori
Schermata dimostrativa pubblicata da Fantaiuto. Illustra l’interfaccia del servizio; i valori mostrati non sono raccomandazioni di questa guida per il prossimo turno.

La schermata aiuta a capire un equivoco: un numero accanto a un giocatore va interpretato. È una media storica? Un indice costruito dall’app? Una probabilità? Sono grandezze diverse. Prima di confrontarle, devi sapere che cosa misurano.
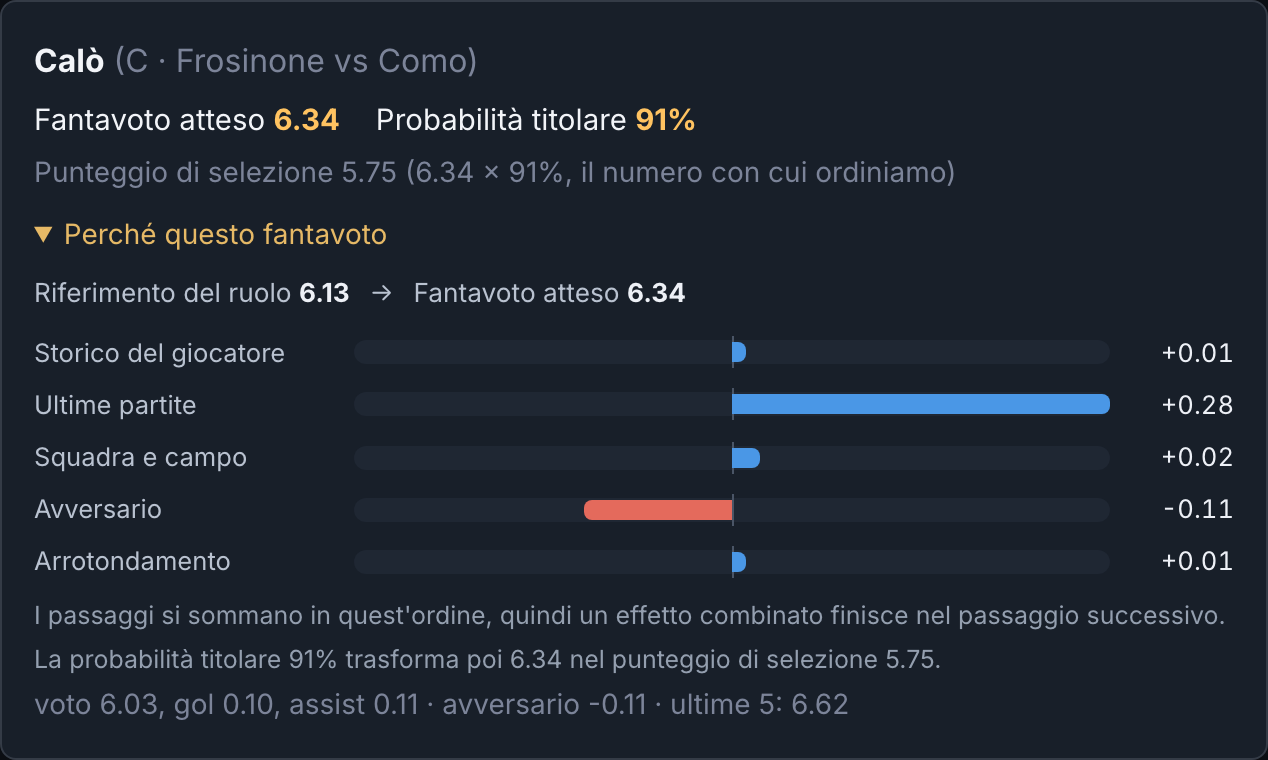
Schermata ufficiale Predixsport con fantavoto atteso, probabilità di titolarità e fattori del modello
Schermata di esempio pubblicata da Predixsport. La pagina distingue fantavoto atteso e probabilità di partire titolare. L’immagine documenta una funzione dichiarata, non dimostra l’accuratezza futura del modello.

Prima del prompt: prepara regolamento, rosa e fonti

Il primo documento da dare all’assistente è il regolamento della tua lega. Fantacalcio.it chiarisce che le regole delle leghe private sono personalizzabili. Dimensione della rosa, bonus, sostituzioni e modificatori cambiano il problema. Una risposta sensata in una lega può essere sbagliata nella tua.

Prepara una cartella o una conversazione di lavoro con quattro elementi: regolamento effettivo, rosa aggiornata, elenco degli svincolati e tabella delle statistiche. Aggiungi il calendario quando serve. Per ruoli e valori consulta il listone di quotazioni e FVM di Fantacalcio.it; per la disponibilità prepartita controlla le probabili formazioni e gli aggiornamenti ufficiali delle squadre. Riporta sempre fonte, stagione e momento del controllo.

Per lavorare su una tabella, preferisco un file esportato legittimamente o dati incollati in colonne. La guida ufficiale di OpenAI alla preparazione dei dati mostra il flusso di caricamento e controllo di un file. Verifica le funzioni effettivamente presenti nel tuo account; se una funzione manca, puoi comunque fornire una piccola tabella nel messaggio.

Campo Perché serve Errore da prevenire
ID, nome, squadra, ruolo Identificare il calciatore e i vincoli. Omonimi, trasferimenti e ruoli di stagioni diverse.
Stagione e data di aggiornamento Capire a quale fotografia si riferisce il dato. Scambiare un file vecchio per un aggiornamento live.
Minuti, presenze, partite a voto Distinguere rendimento e disponibilità. Confrontare campioni molto diversi senza segnalarlo.
Media voto e FantaMedia Separare voto base e punteggio con bonus/malus. Usare colonne simili come se fossero equivalenti.
xG, eventuali xA e loro provider Aggiungere metriche di qualità delle occasioni. Unire definizioni o modelli non omogenei.
Prezzo, crediti residui, slot liberi Valutare acquisti realizzabili. Proporre un affare che rende impossibile completare la rosa.
Stato prepartita e fonte Gestire dubbi e aggiornamenti. Trasformare un’ipotesi di titolarità in una formazione ufficiale.

Chiedi prima un controllo di qualità: righe duplicate, dati mancanti, nomi incoerenti, separatori decimali e denominatori diversi. Uno zero vuol dire zero; una cella vuota può voler dire che il dato non è stato rilevato. Se l’AI riempie i vuoti con l’immaginazione, la tua squadra diventa un romanzo.

Prompt Fantacalcio per ChatGPT: il metodo G.O.L. applicato alla lega

Per impostare il lavoro uso il mio metodo G.O.L. per i prompt di ChatGPT: Guidare, Obiettivo, Limiti. Guida l’assistente indicando il compito; definisci il risultato; metti vincoli e controlli. Questo è un modello da copiare, sostituendo i campi tra parentesi.

GUIDARE
Agisci come assistente di analisi per la mia lega di Fantacalcio.
Prima estrai dai documenti le regole effettive e chiedimi conferma
solo sui punti ambigui che cambiano la decisione.

OBIETTIVO
Aiutami a [preparare l’asta / schierare / valutare uno scambio].
Stagione: [stagione]. Sistema: [Classic o Mantra].
Partecipanti: [numero]. Budget: [crediti].
Rosa e regole: [allegati o tabella].
Data e ora del controllo: [data, ora, fuso orario].

LIMITI
Usa solo i giocatori e i dati forniti o verificati con una fonte.
Non inventare ruoli, prezzi, infortuni, probabilità o notizie.
Se non puoi consultare il web, dichiaralo e usa solo gli allegati.
Separa dati osservati, stime del fornitore e ipotesi dell’analisi.
Per ogni dato variabile riporta fonte e data di aggiornamento.
Controlla vincoli e budget con calcoli espliciti e riproducibili.
Restituisci: proposta, alternativa, motivi, dati mancanti,
rischi e condizioni che farebbero cambiare la scelta.

La richiesta di fonti non garantisce che le fonti siano corrette. Apri i collegamenti e verifica che sostengano quello che l’assistente ha scritto. Anche un prompt ben progettato richiede controllo.

AI per l’asta del Fantacalcio: 10 applicazioni pratiche

1. Trasformare il regolamento in una scheda operativa

Invece di iniziare dai nomi, fai estrarre le condizioni che incidono sulle scelte. Il risultato utile è una scheda verificabile, con il riferimento al punto del documento da cui arriva ogni regola.

Leggi il regolamento allegato. Estrai sistema di gioco, composizione
rosa, budget, bonus/malus, moduli, modificatori, sostituzioni e scadenze.
Indica se una voce è esplicita, ambigua o assente. Cita il paragrafo.
Non completare le lacune usando le regole di altre leghe.

2. Pulire il listone senza perdere calciatori

Una pulizia fatta male può cancellare un omonimo o un giocatore che ha cambiato squadra. Chiedi una copia normalizzata e un registro delle modifiche, mantenendo gli identificativi originali.

Controlla il listone: duplicati, omonimi, ruoli mancanti, numeri
salvati come testo e squadre incoerenti. Non eliminare righe in automatico.
Proponi le correzioni e confronta il numero di righe prima e dopo.

3. Costruire fasce di acquisto motivate

Una graduatoria dal primo all’ultimo nome può dare una precisione ingannevole. Le fasce aiutano a individuare alternative, soprattutto quando una stima è incerta. Definisci prima i criteri: rendimento, disponibilità e costo sono dimensioni diverse.

Usando solo questi dati, costruisci fasce per ruolo. Distingui
rendimento osservato, continuità di impiego e costo. Spiega le soglie
scelte e segnala quando i dati non consentono di separare due giocatori.

4. Preparare tre piani di budget

Esempio inventato: con 500 crediti puoi confrontare tre ripartizioni. Sono scenari da discutere, non percentuali universalmente vincenti. La somma deve rimanere 500, compresa la riserva.

Scenario didattico Portieri Difesa Centrocampo Attacco Riserva
Equilibrato 30 65 145 240 20
Difesa valorizzata 35 100 135 210 20
Attacco prioritario 25 50 120 285 20
Con 500 crediti costruisci tre piani alternativi per la mia lega.
Per ciascuno verifica la somma, il costo minimo degli slot e le rinunce.
Non proporre prezzi individuali senza una base dati o un’ipotesi dichiarata.

5. Stimare il valore rispetto a un sostituto

Chiediti quanto guadagni rispetto all’alternativa che riusciresti davvero a comprare. In una simulazione, un giocatore stimato a 7,0 e un sostituto a 6,3 hanno un vantaggio di 0,7 punti a presenza confrontabile. Su 20 presenze ipotizzate sono 14 punti. Il conto dipende dalle ipotesi: non è una previsione certificata né un prezzo d’asta automatico.

Confronta ogni obiettivo con un sostituto acquistabile dello stesso
ruolo. Usa lo stesso orizzonte e le stesse ipotesi sulle presenze.
Calcola il vantaggio atteso e mostra come cambia se gioca meno.

6. Simulare un’asta con avversari diversi

Puoi allenarti a reagire a rincari e occasioni mancate. Le strategie degli avversari vanno presentate come scenari ipotetici: l’AI non legge nella testa dei tuoi amici, anche se sul gruppo WhatsApp qualcuno sembra convinto del contrario.

Simula un’asta con 8 partecipanti e 500 crediti. Usa solo il listone
allegato. Crea avversari con strategie dichiarate e inventate.
Dopo ogni acquisto aggiorna budget e slot. Se perdo il mio primo
obiettivo, mostrami due alternative coerenti con il piano.

7. Calcolare il rilancio massimo sostenibile

Qui serve aritmetica. Se restano 137 crediti e devi comprare ancora 8 calciatori compreso quello in asta, con prezzo minimo di 1 credito devi conservarne almeno 7 per gli altri. Il tetto teorico è quindi 137 − 7 = 130. Se vuoi anche 15 crediti di margine aggiuntivo, diventa 115. È un limite di sostenibilità, non una valutazione del giocatore.

Mi restano 137 crediti e 8 acquisti, incluso quello corrente.
Prezzo minimo 1. Voglio 15 crediti di margine oltre ai minimi.
Calcola il tetto teorico e il tetto prudente. Poi verifica i minimi
necessari per ciascun ruolo: non basta contare gli slot complessivi.

8. Aggiornare il piano dopo un acquisto costoso

Quando spendi più del previsto, il piano iniziale va ricalcolato. La risposta utile non è “ottimo colpo”, ma quali obiettivi diventano incompatibili e dove ridurre la spesa.

Ho speso 18 crediti oltre il piano per questo acquisto.
Aggiorna i budget residui senza cambiare retroattivamente le spese.
Proponi due riallocazioni e indica quali alternative diventano necessarie.

9. Leggere il tabellone con una foto e verificare l’OCR

Se il tuo strumento consente di leggere immagini, una fotografia del tabellone può essere un punto di partenza. Va confermata la trascrizione prima di fare conti: un 13 letto come 73 cambia tutta l’asta.

Trascrivi questa foto in una tabella: giocatore, acquirente e prezzo.
Segnala le celle poco leggibili senza indovinarle. Fermati prima
dell’analisi e fammi controllare la trascrizione. Poi riconcilia
la somma degli acquisti con i crediti residui di ogni squadra.

10. Misurare i rincari nella tua asta

Con un listino di riferimento comparabile, puoi confrontare prezzi pagati e stime iniziali. Un rapporto di 1,20 indica, in quel campione e rispetto a quel riferimento, prezzi del 20% superiori. Se il riferimento è debole, anche l’indicatore lo è.

Per ogni ruolo confronta somma dei prezzi pagati e somma dei valori
di riferimento dei medesimi giocatori. Mostra numerosità e rapporto.
Non estendere il risultato ai ruoli senza acquisti né a tutta la lega
se il campione è piccolo. Indica le anomalie del riferimento.

Formazione Fantacalcio con l’AI: 6 casi per scegliere chi schierare

11. Ragionare su un ballottaggio con una panchina reale

Chiedere “meglio A o B?” senza panchina e regole è un problema incompleto. Conta che cosa succede se uno non prende voto, oltre alla probabilità di partire titolare.

Confronta questi due giocatori per la giornata indicata usando
le fonti allegate. Distingui titolarità, probabilità di voto se
disponibile e rendimento condizionato al voto. Considera la riserva
e le regole di sostituzione. Non inventare percentuali mancanti.

Ecco una simulazione semplificata con un solo ballottaggio, riserva sempre disponibile e nessun limite ai cambi rilevante. Se Aurora ha probabilità di voto 0,70 e fantapunteggio medio condizionato al voto 7,5, mentre la riserva vale 6,0, il valore atteso del posto è 0,70 × 7,5 + 0,30 × 6,0 = 7,05. Per Boreale, con probabilità 0,95 e punteggio condizionato 6,8, diventa 0,95 × 6,8 + 0,05 × 6,0 = 6,76. Cambiando riserva o condizioni può cambiare la scelta.

Attenzione: probabilità di voto e probabilità di partire titolare non coincidono. E se il fornitore ha già incluso il rischio di assenza nel suo punteggio atteso, moltiplicarlo di nuovo può contare due volte lo stesso rischio.

Esempio didattico del valore atteso di un posto in formazione con riserva: Aurora 7,05 e Boreale 6,76
Calcolo illustrativo con nomi e dati inventati. La riserva e le regole fanno parte della decisione.

12. Confrontare moduli con il modificatore difesa

Confronta l’intera formazione. In un esempio inventato, un 3-4-3 vale 72 punti attesi; un 4-3-3 vale 71 prima del modificatore. Se il bonus fosse +3 con probabilità 0,50 e zero negli altri casi, il contributo atteso sarebbe 1,5 e il secondo modulo arriverebbe a 72,5. Le probabilità sono ipotesi didattiche: vanno stimate o lasciate come scenari, mai spacciate per dati.

Confronta tutti i moduli ammessi usando solo la mia rosa.
Applica le soglie esatte del modificatore. Se mancano le distribuzioni
dei voti, mostra scenari senza inventare probabilità. Distingui
punteggio base, modificatore e rischio legato alle sostituzioni.

13. Ordinare la panchina per copertura

Una panchina piena di giocatori interessanti può lasciare scoperto il ruolo sbagliato. Chiedi la spiegazione dell’ordine e alcuni casi limite, non soltanto una lista.

Ordina la panchina secondo il regolamento allegato.
Mostra che cosa succede se non prendono voto uno, due o tre titolari
nei ruoli critici. Evidenzia i casi in cui rischio di giocare in dieci.

14. Controllare gli incastri nel Mantra

Nel sistema Mantra di Fantacalcio.it contano ruoli, compatibilità dei moduli e meccanismi di sostituzione. Fornisci all’assistente i ruoli del listone corretto e le impostazioni effettive della lega. La verifica finale va fatta nella piattaforma con cui giochi.

Sistema Mantra: usa esclusivamente i ruoli allegati e le regole
della mia lega. Costruisci due formazioni valide. Verifica per ogni
posto la compatibilità del ruolo e mostra gli scenari di sostituzione.
Non convertire ruoli Classic in ruoli Mantra per intuizione.

15. Confrontare i portieri con il calendario

Puoi chiedere una rotazione su più turni, purché calendario e disponibilità siano aggiornati. Separerei il criterio “avversario apparentemente più semplice” da una probabilità numerica di porta inviolata: la seconda richiede una fonte o un modello.

Confronta questi portieri per i prossimi 5 turni sulla base
del calendario allegato. Riporta casa/trasferta, disponibilità e
criteri della scelta. Se mancano stime affidabili sui gol subiti,
offri scenari qualitativi, senza assegnare probabilità arbitrarie.

16. Fare un controllo prima della scadenza

La formazione di venerdì mattina può essere superata venerdì sera. Il controllo deve riportare l’ora dell’ultimo aggiornamento e distinguere fonti ufficiali, notizie e ipotesi. La scadenza è quella della tua lega.

Controlla la mia formazione rispetto alle fonti aggiornate che
ti fornisco. Elenca solo i cambiamenti rilevanti, con fonte e ora.
Se non hai accesso a dati nuovi, dichiaralo. Verifica gli undici,
la panchina, i vincoli e la scadenza prima di suggerire modifiche.

Scambi e asta di riparazione con l’intelligenza artificiale

17. Valutare uno scambio guardando chi giocherà davvero

La somma delle FantaMedie può ingannare. In un esempio inventato, ricevere un giocatore da 7,4 e uno da 6,3 cedendone due da 6,9 e 6,5 sembra conveniente: 13,7 contro 13,4. Ma se il secondo nuovo acquisto resta sempre in panchina, quel confronto non descrive l’effetto sulla formazione.

Confronta la mia migliore formazione e la copertura prima e dopo
lo scambio. Usa lo stesso orizzonte e le stesse ipotesi sulle presenze.
Evidenzia chi entra negli undici e chi sostituisce. Se non possiamo
stimare il rendimento futuro, separa i dati storici dagli scenari.

18. Cercare svincolati adatti a un bisogno preciso

“Trovami una sorpresa” è vago. “Mi serve un difensore disponibile perché ne ho due indisponibili” è già un compito utile. Usa la lista degli svincolati della tua lega: un nome interessante già posseduto da un rivale non risolve il problema.

Da questa lista di svincolati seleziona alternative per coprire
il bisogno descritto. Escludi chi non è acquistabile o supera il budget.
Motiva le proposte con dati disponibili e indica quali verifiche
prepartita o di ruolo mancano.

19. Esaminare un rendimento anomalo senza promettere il rimbalzo

Un giocatore con pochi gol e occasioni di buona qualità merita un approfondimento, non un acquisto automatico. Prima di aspettarti un recupero devi controllare minuti, ruolo, qualità del dato e ampiezza del campione. Lo scarto tra gol e xG è un indizio da interpretare.

Individua nel dataset gli scarti tra gol e xG e mostra minuti
e dimensione del campione. Non dire che un giocatore “deve” segnare.
Per ciascun caso elenca spiegazioni alternative e dati da verificare.

20. Preparare uno scambio comprensibile per entrambe le parti

L’AI può aiutarti a formulare una proposta leggibile, collegando esigenze reali delle due rose. Se deve inventare notizie o sostenere che un rendimento futuro sia certo per convincere l’altro, stai usando male lo strumento.

Partendo da queste due rose, proponi uno scambio consentito dalle
regole che risponda a un bisogno di ciascuna squadra. Scrivi un messaggio
breve con motivazione e rischi. Non nascondere informazioni rilevanti
e non presentare stime come garanzie.

Analizzare la stagione, progettare un agente e gestire la lega

21. Separare qualità della scelta e risultato

Un attaccante rimasto in panchina che segna non dimostra da solo che hai sbagliato. Valuta che cosa sapevi prima della scadenza. Conserva la proposta dell’assistente e confrontala, a fine turno, con una regola di riferimento semplice.

Analizza queste scelte usando solo le informazioni disponibili
prima della consegna. Separa errore nei dati, errore nel ragionamento
ed esito sfavorevole ma plausibile. Confronta la proposta AI con la
mia regola di riferimento, senza usare dati futuri per giustificarla.

22. Scoprire squilibri nella rosa

Una tabella può mostrare troppi acquisti costosi nello stesso ruolo o più riserve che competono per uno slot. Prima di attribuire un punteggio complessivo alla squadra, chiedi un elenco concreto di coperture e dipendenze.

Esamina la composizione della rosa: budget per ruolo, alternative
utilizzabili, concentrazione sulla stessa squadra e ruoli scoperti.
Non assegnare un voto complessivo arbitrario. Indica tre interventi
possibili e che cosa dovrei cedere o sacrificare per realizzarli.

23. Progettare un assistente che prepara un report

Un’automazione utile può leggere le fonti consentite, aggiornare una tabella e preparare un rapporto prima della scadenza. Deve esistere una vera integrazione: scrivere “avvisami venerdì” in una chat non dimostra che un processo sia stato attivato. Verifica esecuzione, orario e consegna.

Progetta un flusso, senza attivarlo: fonti autorizzate, frequenza,
orario Europe/Rome, controlli sui dati e canale del report.
Il report deve includere aggiornamenti, formazione proposta,
alternative e dati mancanti. Prevedi un avviso se una fonte non risponde.
La consegna della formazione resta una mia azione.

Una connessione MCP, quando disponibile e compatibile con il tuo assistente, può mettere a disposizione dati strutturati. Nella descrizione tecnica di FantaGPT, la chiave è associata a una lega e il collegamento descritto non consente di schierare o acquistare. È un esempio utile di differenza tra accesso ai dati e capacità di agire. Non incollare chiavi personali in chat condivise o schermate pubbliche.

24. Rendere il regolamento più chiaro per il presidente di lega

Puoi chiedere all’AI di cercare contraddizioni e formulare esempi, lasciando le decisioni ai partecipanti. È particolarmente utile prima dell’inizio della stagione, quando puoi chiarire una regola senza cambiarla a partita già giocata.

Revisiona questo regolamento senza modificarne le scelte.
Trova contraddizioni, termini ambigui e casi non coperti.
Per ciascuno proponi due formulazioni alternative ed esempi.
Non presentare nessuna modifica come già approvata dalla lega.

25. Creare la cronaca della giornata senza inventare episodi

Report, nomi delle squadre, pagelle ironiche e messaggi per il gruppo possono essere applicazioni divertenti. Usa risultati reali forniti e tieni separata la satira dalle informazioni sportive. È anche un buon esercizio per un laboratorio sull’AI.

Scrivi la cronaca ironica della giornata usando solo questi risultati.
Non inventare gol, infortuni o dichiarazioni. Tono da gruppo di amici,
nessun attacco personale. Chiudi con tre osservazioni sui dati,
distinguendole chiaramente dalle battute.

Un video da guardare con spirito critico e una prova da fare

Il tema è stato affrontato anche da Lorenzo Cantarini nel video “FANTACALCIO E CHATGPT: HO FATTO LA FORMAZIONE CON LA A.I.”, richiamato nell’approfondimento di Fanta.Soccer su AI, aste e formazioni. È uno spunto per discutere l’esperimento: una singola formazione riuscita o sbagliata non basta a valutare un sistema.

Video esterno su YouTube. Se il player non viene caricato, apri il video su YouTube. Il contenuto è un esempio sul tema, non una guida ai nomi da schierare nella stagione corrente.

Per una prova più seria, scegli prima una regola di riferimento: per esempio la tua procedura abituale, scritta chiaramente. Registra poi, prima delle partite, la formazione proposta dall’AI, i dati usati, l’orario e le motivazioni. Confronta i due metodi per più giornate sulle stesse rose e sulle stesse regole, senza correggere a posteriori le proposte. Ti interessano punteggio, frequenza degli errori nei vincoli, copertura dei ruoli e tempo impiegato.

Puoi trasformarlo in un laboratorio: un gruppo lavora con un prompt generico, uno con regolamento e dati puliti, uno con un assistente che deve dichiarare le incertezze. Il confronto non deve decretare il “chatbot più tifoso”, ma mostrare come cambia la qualità del lavoro quando cambia il contesto. È un esercizio che si collega bene ai miei corsi su AI generativa, agenti e prompt engineering.

Gli errori che fanno perdere valore all’AI nel Fantacalcio

  • Chiedere nomi aggiornati senza dati aggiornati. Verifica stagione, squadra, ruolo e disponibilità.
  • Usare una media storica come previsione certa. È una descrizione di ciò che è successo, non una promessa.
  • Chiedere percentuali e accettarle comunque. Senza fonte o modello esplicito, un numero preciso può essere solo decorazione.
  • Sommare quotazioni come se fossero prezzi della tua asta. Servono confronti omogenei e un riferimento alla tua lega.
  • Dimenticare la panchina. Il valore di uno slot dipende anche dalle sostituzioni.
  • Riutilizzare una risposta vecchia. Un consiglio dipende dal momento e dai dati con cui è stato prodotto.
  • Credere che l’AI abbia letto un sito o un file. Fatti indicare cosa ha consultato e controllalo.
  • Valutare il sistema dopo una sola giornata. Registra anche una regola di confronto e gli errori, senza selezionare solo i casi riusciti.

Domande frequenti sull’intelligenza artificiale per il Fantacalcio

Si può usare ChatGPT per fare la formazione del Fantacalcio?

Puoi usarlo come supporto fornendo rosa, regole e dati aggiornati. Chiedi una proposta con alternative, fonti e controlli sui vincoli. Verifica la formazione nella piattaforma della tua lega prima di consegnarla: una risposta plausibile non certifica che gli undici siano validi o disponibili.

Qual è la migliore AI per il Fantacalcio?

Dipende dal compito e dalle regole supportate. Un assistente generalista è flessibile nel lavoro sui tuoi documenti; un servizio dedicato può offrire dati e stime già organizzati. Senza un test comparativo indipendente non è corretto assegnare il titolo di migliore. Controlla aggiornamento, trasparenza, compatibilità e risultati registrati.

Esiste un’AI per il Fantacalcio gratis?

Le condizioni cambiano. Puoi iniziare con tabelle e prompt se le funzioni necessarie sono disponibili nel tuo account. Alcuni servizi presentano prove o funzioni gratuite, altre attività richiedono un pagamento. Verifica sulla pagina ufficiale limiti, durata della prova ed eventuali rinnovi prima di scegliere.

Come si usa l’AI durante l’asta?

Prepara listone e piano prima dell’asta, poi aggiorna acquisti, budget e slot a ogni passaggio. Le richieste più utili riguardano rilancio massimo sostenibile, alternative e conseguenze di una spesa extra. Conferma la trascrizione degli acquisti: un prezzo errato compromette tutti i calcoli successivi.

L’AI funziona anche per il Mantra?

Può aiutarti a confrontare alternative, ma deve avere ruoli e regole Mantra corretti. Non tutti i servizi dedicati supportano questo sistema. Verifica sulla documentazione del prodotto e controlla l’ammissibilità della formazione nella piattaforma della lega.

L’AI può vincere il Fantacalcio al mio posto?

Non può garantire il risultato. Può aiutare a organizzare informazioni e a rendere le scelte più coerenti. L’efficacia concreta va valutata su proposte registrate prima delle partite e confrontate con una procedura di riferimento, senza ignorare costi, tempo e dati mancanti.

Il miglior acquisto può essere una domanda fatta bene

Per iniziare non chiederei “chi farà più gol?”. Prenderei la mia rosa, il regolamento e una scelta concreta: due giocatori da confrontare, un rilancio da valutare, uno scambio che mi lascia perplesso. Chiederei dati, alternative e condizioni che cambiano la risposta.

È una lezione che vale anche fuori dal Fantacalcio: un assistente diventa più utile quando gli diamo un problema definito e informazioni controllabili. Poi domenica il tuo attaccante può comunque colpire il palo al novantesimo. Il prompt, almeno quello, non avrà colpe.

Vuoi portare questo metodo in un corso sull’AI?

Il Fantacalcio è un terreno concreto per imparare a lavorare con dati, prompt, scenari e assistenti. Progetto workshop su AI generativa e agenti per aziende e organizzazioni, adattando esempi e laboratori al pubblico. Contattami per costruire un percorso formativo, oppure usa il modulo qui sotto.
    Qualche dettaglio sul corso (facoltativo)

    Qualche dettaglio sull’evento (facoltativo)

    Bastano poche righe. Se hai già una data o un obiettivo, aggiungili.

    I campi con * sono obbligatori.

    Un piatto di verdure torna in cucina quasi intatto. Il giorno dopo succede di nuovo. Il terzo giorno, stessa scena. Possiamo archiviare la faccenda con un «ai bambini le verdure non piacciono», oppure cominciare a fare domande: la porzione è eccessiva? La preparazione funziona? Il tempo per mangiare è sufficiente?

    È qui che l’intelligenza artificiale può diventare interessante: rendendo visibile, e analizzabile, ciò che normalmente finisce nel cestino.

    Il caso è Hoooly Food, al centro della partnership annunciata tra Vivenda Spa e Ganiga. Il comunicato presenta un sistema che analizza gli avanzi dei pasti e li trasforma in informazioni per migliorare la gestione delle mense. Un’applicazione concreta dell’AI, da valutare con una domanda altrettanto concreta: quanto cibo permette davvero di risparmiare?

    Vivenda e Ganiga: il progetto che porta l’AI nelle mense

    Vivenda Spa, società del Gruppo La Cascina, opera nella ristorazione collettiva, anche scolastica, sanitaria e aziendale. Ganiga sviluppa tecnologie per la gestione intelligente dei rifiuti: la scheda ospitata dall’Agenzia ICE descrive la famiglia Hoooly, basata su sensori, intelligenza artificiale e analisi dei dati, comprese applicazioni per le cucine.

    La partnership viene presentata in vista della Giornata mondiale dell’alimentazione del 16 ottobre 2026, promossa dall’Organizzazione delle Nazioni Unite per l’alimentazione e l’agricoltura, la FAO.

    Una precisazione sul linguaggio: Ganiga si presenta come partner di Google for Startups. Parlare di «startup di Google» può far pensare a una società del gruppo. Il programma di Google per le startup AI offre invece supporto, risorse e servizi alle imprese partecipanti. È più corretto descrivere quel rapporto senza suggerire un’appartenenza societaria.

    Come funziona Hoooly Food contro lo spreco alimentare

    Secondo il comunicato, il sistema usa telecamere e visione artificiale nei punti di raccolta dei vassoi per identificare i residui e produrre informazioni utilizzabili dalla cucina. Nella descrizione pubblicata direttamente da Ganiga, Hoooly Food riconosce gli alimenti e stima volume e peso dalle immagini, senza bilancia. I dati sono disponibili in una dashboard; l’azienda descrive anche un agente AI dedicato al supporto delle decisioni.

    La distinzione conta: una stima ricavata da una fotografia va verificata rispetto a misurazioni di riferimento. Prima di usare quei numeri per modificare acquisti e preparazioni, chiederei quanto sono accurati, con quali alimenti e in quali condizioni operative.

    Il valore potenziale sta nel collegare le osservazioni alle decisioni: individuare pietanze spesso avanzate, confrontare giornate e menù, verificare se una modifica riduce gli scarti. Qui parliamo soprattutto di visione artificiale e analisi dei dati, con un supporto decisionale dichiarato dal produttore.

    Perché misurare gli avanzi ha senso

    Il problema ha dimensioni enormi. Il Food Waste Index Report 2024 del Programma delle Nazioni Unite per l’ambiente, UNEP, realizzato con WRAP, stima che nel 2022 siano stati generati 1,05 miliardi di tonnellate di rifiuti alimentari, comprese le parti non commestibili, tra famiglie, servizi di ristorazione e commercio al dettaglio. Alla ristorazione è attribuito il 28% del totale.

    Attenzione al perimetro: sono stime globali riferite al 2022, non dati sulle mense italiane e nemmeno sui risultati di Hoooly Food. Servono a capire la rilevanza del problema, non a certificare l’efficacia di un prodotto.

    Per approfondire, qui sotto trovi la presentazione del rapporto, collegata dalla pagina ufficiale dell’evento UNEP. Il video è in inglese.

    Un piatto avanzato non spiega perché è avanzato

    Immaginiamo, come esempio, che una mensa registri molti avanzi di broccoli. Il dato può suggerire una verifica. Non dimostra automaticamente che i broccoli non piacciano: potremmo dover controllare porzioni, cottura, temperatura o organizzazione del servizio.

    Confondere una traccia osservabile con la sua causa è una scorciatoia pericolosa. Un algoritmo può aiutare a trovare regolarità; l’interpretazione richiede confronto con cuochi, personale e utenti.

    Proporrei inoltre di distinguere almeno tre flussi: scarti di preparazione, cibo preparato ma non servito e avanzi nei piatti. Un sistema concentrato sul rientro dei vassoi osserva una parte del processo. Per decidere quanto preparare domani, vorrei collegare quel dato anche a presenze, prenotazioni e quantità effettivamente servite.

    «Azzerare gli scarti» è un obiettivo, non un risultato dimostrato

    Nel comunicato ricorrono espressioni molto ambiziose, dall’eliminazione dello spreco alla precisione scientifica. Il documento, però, non riporta una sperimentazione con numero di mense coinvolte, durata, confronto iniziale e finale o percentuali di riduzione.

    Anche la presentazione di una tecnologia come brevettata non documenta, da sola, il risparmio ottenuto sul campo. Per valutare questo progetto chiederei:

    • Scarti per pasto servito: come cambiano prima e dopo l’intervento, distinguendo i diversi flussi?
    • Attendibilità delle stime: quanto si discostano i valori ricavati dalle immagini da pesature di controllo?
    • Costi e lavoro: qual è il risparmio netto, considerando anche installazione, servizio e gestione?
    • Qualità del pasto: gli scarti diminuiscono mantenendo adeguatezza delle porzioni e soddisfazione degli utenti?

    Sono criteri che proporrei per un progetto pilota, non risultati già ottenuti da Vivenda e Ganiga. Una sperimentazione utile dovrebbe confrontare periodi e condizioni comparabili, spiegando anche che cosa è cambiato nel menù e nel servizio.

    L’AI utile si riconosce dalle decisioni che migliora

    Questo caso mi interessa perché offre un buon punto di partenza per parlare di AI in azienda: un problema riconoscibile, informazioni da raccogliere, persone che devono decidere e risultati da verificare.

    Una dashboard piena di grafici serve a poco se nessuno modifica il processo. L’esperimento diventa interessante quando una cucina cambia una preparazione o una porzione, misura ciò che succede e conserva la modifica solo se funziona.

    È l’approccio che propongo nei miei corsi su AI, agenti e comunicazione digitale: partire dalle attività e dagli obiettivi, scegliere gli strumenti, verificare gli effetti.

    Hoooly Food merita attenzione come proposta tecnologica. Per capire se manterrà le promesse, serviranno dati sul campo. E il dato più convincente sarà il cibo che riusciremo a evitare di buttare.

    Vuoi portare questo approccio nella tua azienda o nel tuo ente? Raccontami il progetto nel modulo di contatto: possiamo costruire un percorso di formazione a partire dai vostri processi e obiettivi.

      Il tuo nome (richiesto)

      La tua email (richiesto)

      Oggetto

      Il tuo messaggio

      Di Gianluigi Bonanomi · Verifica aggiornata al 13 ottobre 2026

      Un data center viene colpito, una curva precipita e qualcuno vede finalmente la prova: dietro il consenso online di certi movimenti politici europei ci sarebbero server russi. Spenti quelli, spariti i sostenitori. È una storia potente. Ha un evento concreto, un grafico e un colpevole. Le manca però il passaggio decisivo: dimostrare che il grafico misuri proprio ciò che gli stiamo facendo dire.

      La domanda merita attenzione, perché mette insieme guerra, infrastrutture digitali, propaganda e intelligenza artificiale. Ma il punto interrogativo nel titolo va preso sul serio. Le fonti verificate non dimostrano che gli attacchi a Yandex abbiano stroncato i bot politici attivi in Europa. E una diminuzione del traffico automatizzato non basta a sostenere questa conclusione.

      Gli attacchi a Yandex sono confermati

      Reuters ha documentato gli attacchi dell’8 e 9 ottobre 2026 ai data center Yandex di Sasovo e della regione di Kaluga. Secondo le dichiarazioni riportate dall’agenzia, il primo è stato fermato e il secondo parzialmente messo fuori uso.

      L’11 ottobre, Reuters ha riferito un terzo attacco nella regione di Vladimir: Yandex ha annunciato lo spegnimento completo del centro e l’indisponibilità di alcuni servizi.

      Questi sono fatti documentati. Attribuire a quelle interruzioni la fine di una rete di propaganda europea è invece un’altra affermazione, che richiede altre prove. Un’infrastruttura danneggiata ci dice che qualcosa può aver smesso di funzionare. Non identifica automaticamente le attività coinvolte, i loro responsabili o i loro destinatari.

      Yandex e bot politici: la parola che genera l’equivoco

      Nel linguaggio comune, “bot russo” richiama un profilo finto che pubblica slogan e amplifica messaggi politici. In una dashboard tecnica, “bot” può indicare tutt’altro. La documentazione di Cloudflare distingue programmi automatizzati con funzioni diverse: ricerca e indicizzazione, raccolta di dati per addestrare modelli e attività di agenti che operano per conto di una persona.

      In particolare, Cloudflare descrive YandexBot come il principale robot di indicizzazione del motore di ricerca Yandex. Il suo compito dichiarato è raccogliere pagine per la ricerca. La sua etichetta non identifica una rete di account politici.

      Elemento osservato Che cosa indica Che cosa non dimostra da solo
      Crawler di ricerca Un programma visita pagine per indicizzarle. La presenza di profili che fanno propaganda.
      Traffico automatizzato Richieste attribuite a software. L’obiettivo politico di quelle richieste.
      Account politico automatizzato Un profilo svolge attività attraverso software. Chi lo controlla e chi lo finanzia.
      Interruzione di una rete Una parte dell’infrastruttura non comunica normalmente. La cessazione di tutte le operazioni di influenza.

      È come vedere diminuire i furgoni in una strada e concludere che sia finito il contrabbando. Prima bisogna sapere quali furgoni, che cosa trasportavano e dove stavano andando.

      Che cosa misurano davvero i grafici Cloudflare

      La pagina Cloudflare Radar dedicata ad AS13238, la rete Yandex, riporta traffico e richieste HTTP, con una distinzione fra attività automatizzata e umana. Non è un contatore di post favorevoli all’AfD o ad altri partiti. Inoltre, traffico di una rete e attività di uno specifico crawler sono misure diverse: anche fra grafici tecnici non possiamo cambiare oggetto senza accorgercene.

      Per sostenere una tesi politica servirebbero dati sulle piattaforme, sugli account e sui contenuti. Quanti profili sono diventati inattivi? Erano già stati identificati come parte di una campagna coordinata? Quali messaggi pubblicavano? Esiste un collegamento verificato con l’infrastruttura colpita?

      Senza queste informazioni, una curva in discesa resta una curva in discesa. Il fatto che compaia il nome di un’azienda russa non le attribuisce un significato politico.

      Il grafico sull’AfD non offre una prova affidabile

      Il 12 ottobre, The Verge ha ricostruito la circolazione di un grafico associato all’AfD. La provenienza dei dati non risulta stabilita; vengono segnalate anomalie temporali e un sospetto di generazione con AI. Quel sospetto non è una verifica definitiva dell’origine dell’immagine.

      La distinzione conta: non serve dimostrare come sia stata prodotta un’immagine per riconoscere che non può sostenere una conclusione se mancano dati verificabili e metodo. Un grafico dovrebbe permettere di risalire al dataset, alle definizioni, all’intervallo temporale e al procedimento di analisi. La veste professionale non sostituisce nessuno di questi elementi.

      Le operazioni russe di influenza sono documentate, ma non provano questa storia

      Contestare questo collegamento non significa negare il problema. Il terzo rapporto del Servizio europeo per l’azione esterna, pubblicato nel marzo 2025, mappa infrastrutture usate da attori stranieri, soprattutto Russia e anche Cina, per manipolare lo spazio informativo dell’Unione europea e dei Paesi partner.

      Un caso concreto compare nel comunicato del Dipartimento di Giustizia degli Stati Uniti del 9 luglio 2024: sequestro di due domini e mandati di perquisizione relativi a 968 account social. Secondo gli atti citati, la rete usava AI per creare false identità e diffondere messaggi favorevoli agli obiettivi del governo russo.

      Qui troviamo account, infrastrutture e un’attribuzione motivata. È il tipo di documentazione da cercare. Non dimostra però che quella rete dipendesse dai data center Yandex colpiti nell’ottobre 2026.

      Bisogna anche evitare un salto politico: “sovranista” ed “estremista” non sono sinonimi. Un’attività online favorevole a un partito non dimostra che il partito la controlli. E l’esistenza di manipolazioni non autorizza a considerare artificiale tutto il suo consenso. Ogni attribuzione richiede prove specifiche.

      Che cosa servirebbe per collegare bombardamenti e bot politici

      Per verificare l’ipotesi proporrei cinque controlli:

      1. Definire il campione: quali account, piattaforme, Paesi e movimenti politici?
      2. Motivare la classificazione: perché quei profili sarebbero automatizzati e parte di una rete coordinata?
      3. Documentare l’infrastruttura: quali elementi li collegano ai sistemi colpiti?
      4. Confrontare prima e dopo: con date, fusi orari e criteri di raccolta coerenti.
      5. Verificare spiegazioni alternative: sospensioni degli account, variazioni nella raccolta dei dati, altre interruzioni o cambiamenti nell’attività della campagna.

      La contemporaneità renderebbe l’ipotesi interessante. Non basterebbe a dimostrarla. Anche un calo reale di messaggi politici andrebbe spiegato prima di attribuirlo a uno specifico attacco.

      Un video per distinguere notizie, opinioni e prove

      Per approfondire il metodo, propongo la lezione TED-Ed di Damon Brown How to choose your news. È una risorsa sull’alfabetizzazione ai media, non una prova sul caso Yandex.

      Un ottimo esercizio di alfabetizzazione digitale

      Porterei questo caso in un laboratorio: un titolo, un grafico e la domanda “quale passaggio non è dimostrato?”. È un esercizio utile anche quando usiamo l’AI per analizzare documenti. Chiederei al chatbot di separare osservazioni, interpretazioni e prove mancanti, poi controllerei ogni riferimento.

      Un prompt da provare: “Analizza questa affermazione senza presupporre che sia vera. Identifica il fenomeno misurato, le fonti primarie e le prove necessarie per sostenere il nesso causale. Se un dato manca, segnalalo; non ricostruirlo per plausibilità.”

      È un’attività che si può integrare nei miei corsi su AI e comunicazione digitale. L’obiettivo è imparare a formulare domande migliori e a riconoscere quando una risposta convincente ha superato le prove disponibili.

      Al 13 ottobre 2026, possiamo parlare di attacchi confermati ai data center Yandex. Possiamo parlare di operazioni russe di influenza documentate. Non possiamo saldare le due cose e annunciare che siano stati stroncati i bot a sostegno dei movimenti estremisti e sovranisti europei.

      La disinformazione va verificata anche quando la notizia che la riguarda ci piace. Altrimenti rischiamo di combatterla condividendo un’altra storia non dimostrata.

      Vuoi un corso su AI, verifica delle fonti e comunicazione digitale?

      Scrivimi per progettare un laboratorio pratico per la tua azienda o il tuo ente.

        Qualche dettaglio sul corso (facoltativo)

        Qualche dettaglio sull’evento (facoltativo)

        Bastano poche righe. Se hai già una data o un obiettivo, aggiungili.

        I campi con * sono obbligatori.

        Chiedi a un chatbot un dato che non conosce davvero. Invece di fermarsi, spesso costruisce una risposta plausibile, la rifinisce con tono sicuro e te la consegna come se avesse appena consultato un’enciclopedia. È un problema che chi usa ChatGPT, Gemini, Claude o Copilot incontra prima o poi. Ma la premessa va corretta: i chatbot a volte dicono «non lo so». Il punto è che non riconoscono sempre in modo affidabile quando dovrebbero dirlo.

        La spiegazione non è che l’intelligenza artificiale “mente” con intenzione. Dipende da come vengono addestrati i modelli, da come stimano la propria incertezza e da quali risposte i sistemi di valutazione tendono a premiare.

        Un chatbot genera la risposta più probabile, non consulta un archivio di fatti verificati

        Un modello linguistico di grandi dimensioni (LLM) viene pre-addestrato, in sintesi, a prevedere quale token abbia più probabilità di venire dopo una sequenza di testo. Impara regolarità linguistiche e associazioni dai dati di addestramento, che possono contenere informazioni corrette, errori, contraddizioni e contenuti ormai superati. Questa capacità produce risposte fluenti, ma la probabilità che una frase suoni coerente non coincide con la probabilità che sia vera.

        Nel rapporto tecnico di GPT-4, OpenAI descrive proprio questa differenza: il pre-addestramento insegna a prevedere la continuazione del testo; il post-addestramento, incluso il reinforcement learning from human feedback (RLHF), orienta il modello a seguire meglio le istruzioni e a comportarsi da assistente. Non significa però che il chatbot acquisisca un rilevatore infallibile della verità o un accesso diretto a una banca dati completa e aggiornata.

        Cosa succede durante l’addestramento

        Dopo il pre-addestramento, una fase di fine-tuning supervisionato può mostrare al modello esempi di conversazioni desiderabili. In seguito, valutatori umani possono confrontare più risposte e indicare quali preferiscono; un modello di ricompensa e tecniche di ottimizzazione come RLHF aiutano a rendere più probabili le risposte giudicate migliori. I dettagli cambiano tra fornitori e modelli, e spesso non sono pubblici: non esiste una ricetta unica per tutti i chatbot.

        Qui nasce un compromesso delicato. Una risposta dettagliata, diretta e ben scritta può apparire più utile di un rifiuto o di una dichiarazione d’incertezza. Ma una risposta cauta può essere la scelta giusta se mancano dati. Nel post che presentava ChatGPT, OpenAI indicava esplicitamente tre difficoltà: durante l’RLHF non c’è sempre una fonte di verità con cui confrontare la risposta; addestrare il modello a essere più prudente può indurlo a rifiutare anche domande a cui saprebbe rispondere; e l’esempio scritto da un dimostratore umano può non riflettere ciò che il modello stesso conosce.

        In più, un modello non possiede necessariamente una stima ben calibrata della propria competenza. Può avere appreso un fatto ma non sapere di saperlo, oppure produrre una risposta sicura senza basi sufficienti. Il tono è parte della generazione linguistica, non un certificato di accuratezza.

        Cosa dicono gli studi sulle risposte sbagliate e sull’incertezza

        Nel 2022, Stephanie Lin, Jacob Hilton e Owain Evans hanno presentato TruthfulQA, un benchmark di 817 domande in 38 categorie, progettato per far emergere risposte che ripetono convinzioni errate diffuse. Nei modelli testati allora, il migliore era veritiero nel 58% delle risposte, contro il 94% ottenuto dalle persone. Sono risultati di modelli di quel periodo, non una classifica degli assistenti disponibili oggi; mostrano però perché imitare il testo umano non basta per distinguere un fatto da un luogo comune falso.

        La difficoltà di stimare l’incertezza è stata studiata anche da Zhengbao Jiang e colleghi in una ricerca pubblicata su Transactions of the Association for Computational Linguistics. Esaminando T5, BART e GPT-2 in compiti di domanda e risposta, gli autori hanno rilevato che le probabilità dei modelli non erano ben calibrate rispetto alla correttezza. In altre parole, una maggiore sicurezza numerica non corrispondeva in modo affidabile a una maggiore probabilità di avere ragione.

        Un lavoro di Anthropic del 2022, “Language models (mostly) know what they know”, ha mostrato che alcuni modelli possono stimare se una risposta proposta sia corretta e che è possibile addestrarli a stimare la probabilità di “sapere” la risposta. Gli autori hanno però rilevato difficoltà di calibrazione quando la stima viene trasferita a compiti nuovi. Quindi la metacognizione artificiale è possibile, ma non si attiva come un interruttore universale.

        Nel 2024, un articolo pubblicato agli atti dell’Association for Computational Linguistics ha studiato come identificare le lacune di conoscenza e astenersi dal rispondere. Gli approcci di collaborazione tra modelli hanno migliorato, in alcuni esperimenti, l’accuratezza dell’astensione fino al 19,3% rispetto alla baseline più forte. È una prova che si può insegnare ai sistemi a fermarsi meglio, ma anche che l’autovalutazione del singolo modello non sempre basta.

        Un’analisi pubblicata su Nature nel 2026 aggiunge un punto sugli incentivi: se un benchmark premia soprattutto le risposte corrette e penalizza l’astensione, i modelli e i team che li sviluppano ricevono una spinta a indovinare. In uno studio con quattro modelli di frontiera, gli autori mostrano come cambiano le risposte quando la valutazione riconosce il valore del «non lo so». La metrica scelta può dunque influenzare il comportamento che si cerca di migliorare.

        Come ottenere risposte più oneste: cinque rimedi pratici

        1. Imposta una regola di astensione. Scrivi: «Se non hai elementi sufficienti, dichiaralo. Non completare i vuoti con ipotesi presentate come fatti».
        2. Fornisci le fonti e delimita il perimetro. Per un documento o una procedura, allega il testo e chiedi di rispondere solo sulla base di quel materiale, indicando il passaggio che sostiene ogni affermazione. Chiedi esplicitamente di segnalare ciò che non è presente nei documenti.
        3. Separa fatti, inferenze e informazioni mancanti. Chiedi tre sezioni distinte: “documentato”, “dedotto” e “non verificabile con i dati disponibili”. Questa struttura rende più visibili i salti logici.
        4. Per i fatti aggiornati, attiva ricerca e fonti primarie. Specifica una data di riferimento e chiedi link a leggi, documentazione ufficiale, paper o pagine istituzionali. Un modello senza ricerca web non può verificare un cambiamento recente solo perché gli viene chiesto di farlo.
        5. Controlla le affermazioni importanti fuori dalla chat. Un secondo modello può aiutare a individuare incongruenze, ma può condividere gli stessi errori. Per decisioni professionali o dati rilevanti, verifica la fonte originale o usa uno strumento deterministico, e chiedi una revisione umana quando il rischio lo giustifica.

        Prompt da riutilizzare:

        Rispondi usando solo le informazioni supportate dalle fonti che ti fornisco o che puoi verificare. Per ogni affermazione fattuale importante indica la fonte e il passaggio rilevante. Distingui i fatti dalle inferenze. Se i dati non bastano, scrivi chiaramente «non lo so con le informazioni disponibili» e indica quale elemento servirebbe per rispondere. Non inventare citazioni o riferimenti.

        La frase «dimmi quanto sei sicuro» può aiutare a capire dove il chatbot avverte un dubbio, ma non va presa come una misura oggettiva: gli studi sulla calibrazione mostrano che le stime di confidenza possono essere inaffidabili, soprattutto in domini o compiti diversi da quelli su cui sono state valutate.

        Per chi progetta un assistente: misurare anche quando si ferma

        Un sistema affidabile non dovrebbe essere valutato soltanto sul numero di risposte corrette. Serve misurare anche quante volte risponde quando le prove sono insufficienti, quante volte si astiene a torto e quanto rischio rimane tra le risposte che ha scelto di dare. In letteratura questo compromesso viene spesso descritto come selezione tra copertura e rischio: rispondere a meno domande può abbassare gli errori, ma l’astensione deve essere mirata e utile.

        In un assistente aziendale, si può restringere la risposta alle fonti approvate, collegare il sistema a documenti aggiornati, mostrare i riferimenti, impostare soglie di escalation e passare a una persona i casi incerti o ad alto impatto. Il lavoro ACL sulla collaborazione tra modelli e il recente studio su Nature indicano entrambi che astensione ed evidenze vanno progettate e valutate, non affidate a una formula magica nel prompt.

        Un video utile per approfondire

        Adam Kalai dell’Institute for Advanced Study spiega perché l’addestramento e i criteri di valutazione possono incoraggiare i modelli a indovinare invece di astenersi.

        Domande frequenti

        I chatbot mentono quando inventano una risposta?

        Di norma non nel senso umano di mentire con un’intenzione consapevole. Generano testo plausibile senza garantire che ogni affermazione sia verificata. Per questo si parla di allucinazione o confabulazione.

        Chiedere «dimmi se non lo sai» risolve il problema?

        Può ridurre alcune risposte inventate, soprattutto se si forniscono fonti e si chiarisce quando astenersi. Non garantisce però che il modello riconosca tutti i propri limiti: le istruzioni migliorano il comportamento, non trasformano la stima di sicurezza in una verifica infallibile.

        Qual è il modo più sicuro di usare un chatbot per una ricerca?

        Usalo per orientarti, organizzare domande e confrontare ipotesi; chiedi evidenze verificabili; controlla i riferimenti nelle fonti originali. Per informazioni recenti usa ricerca web e indica la data. Per decisioni ad alto impatto, non delegare il controllo finale al chatbot.

        La risposta migliore a volte è fermarsi

        Un assistente utile non è quello che riempie ogni silenzio. È quello che sa distinguere una risposta sostenuta dai dati da un’ipotesi ben confezionata, e che rende visibile la differenza. Fino a quando questa capacità non sarà abbastanza affidabile, la regola pratica resta semplice: chiedi prove, fornisci contesto e verifica ciò che conta.

        Se stai progettando un corso, un assistente AI o un percorso di formazione su questi temi, raccontami il tuo progetto.

          Qualche dettaglio sul corso (facoltativo)

          Qualche dettaglio sull’evento (facoltativo)

          Bastano poche righe. Se hai già una data o un obiettivo, aggiungili.

          I campi con * sono obbligatori.

          Dal 23 ottobre 2026 l’Italia avrà nuove regole nazionali per accompagnare l’applicazione dell’AI Act. Il decreto legislativo 7 ottobre 2026, n. 179 riguarda i poteri delle autorità nazionali e l’uso dell’intelligenza artificiale nella formazione, nella scuola, nella pubblica amministrazione, nel lavoro e in altri settori.

          Il titolo può far pensare a un manuale completo per usare ChatGPT in classe o in ufficio. Non è così. Il decreto combina regole operative, indirizzi e deleghe: in alcuni casi fissa già principi e obblighi; in altri rimanda a decreti attuativi e linee guida. Per capire che cosa cambia conviene guardare agli articoli, senza trasformare ogni passaggio in una nuova “rivoluzione dell’AI”.

          Decreto IA 179/2026: cosa cambia a scuola

          L’articolo 36 consente alle scuole di promuovere attività formative sull’intelligenza artificiale nell’ambito della propria autonomia e in coerenza con l’educazione civica. L’obiettivo dichiarato è sviluppare, fin dal primo ciclo, conoscenze e capacità per usare l’IA in modo consapevole e valutarne le implicazioni etiche, sociali e civiche.

          Il decreto apre anche alla didattica STEAM, cioè all’integrazione tra scienze, tecnologia, ingegneria, arte e matematica, e prevede l’aggiornamento delle indicazioni nazionali e delle linee guida pertinenti. Il testo, però, non introduce un programma identico e obbligatorio per tutte le scuole: le attività si collocano nell’autonomia scolastica e nel PTOF.

          L’articolo 38 prevede che un decreto del Ministero dell’Istruzione definisca criteri e modalità per la formazione dei docenti, da adottare entro 90 giorni dall’entrata in vigore del provvedimento. La formazione dovrà occuparsi anche di rischi, distorsioni, privacy, sicurezza, valutazione critica delle informazioni e progettazione didattica. Fino all’adozione del nuovo decreto restano applicabili le linee guida ministeriali del 2025.

          Gli Uffici scolastici regionali possono promuovere comitati tecnico-etici territoriali, non sono obbligati a istituirli. Tra i compiti possibili: sostenere la sperimentazione, monitorare gli usi didattici e aiutare le scuole ad aggiornare regolamenti e patti educativi. La direzione è sensata: insegnare a interrogare e verificare i sistemi, non limitarsi a vietarli o a consegnare agli studenti un elenco di prompt. La legge da sola, però, non forma nessuno: serviranno docenti preparati, tempo, strumenti adeguati e regole comprensibili anche alle famiglie.

          Per approfondire il tema della tecnologia in classe, si può leggere anche la mia guida per insegnanti e famiglie sull’uso consapevole dell’intelligenza artificiale a scuola.

          Alfabetizzazione AI anche per gli adulti

          L’articolo 39 affida ai Centri provinciali per l’istruzione degli adulti (CPIA) un ruolo nell’alfabetizzazione degli adulti all’uso dell’IA. I percorsi potranno includere laboratori, attività pratiche e riconoscimento delle competenze acquisite, anche per sostenere l’inserimento o il reinserimento nel lavoro.

          È un punto meno appariscente del capitolo sulla scuola, ma importante: l’alfabetizzazione digitale non riguarda soltanto chi è già in aula o lavora in un’azienda tecnologica. Se l’IA entra nei servizi, nella ricerca di lavoro e nelle attività quotidiane, lasciare indietro gli adulti con meno opportunità di formazione allargherebbe il divario digitale.

          Intelligenza artificiale nella Pubblica Amministrazione

          Per la pubblica amministrazione il decreto prevede un coordinamento delle politiche di reclutamento, formazione e riqualificazione del personale. Il Ministro per la Pubblica amministrazione dovrà definire un quadro minimo di competenze sull’IA e potrà avvalersi della Scuola nazionale dell’amministrazione, di Formez PA e di altri soggetti.

          La formazione, dunque, è una parte della trasformazione, non un accessorio da aggiungere dopo l’acquisto del software. Un ente può introdurre un assistente per riassumere documenti o preparare bozze; deve comunque decidere chi verifica i risultati, come si gestiscono i dati e dove resta la responsabilità del procedimento.

          Qui si innesta anche la legge italiana n. 132 del 2025 sull’intelligenza artificiale: per la PA l’IA è uno strumento di supporto, mentre la persona conserva autonomia e responsabilità sui provvedimenti. Il decreto 179/2026 aggiunge indirizzi e formazione per il personale pubblico, ma non trasforma l’algoritmo nel nuovo responsabile dell’ufficio. Peccato per lui: almeno così non può andare in ferie.

          IA e lavoro: le decisioni finali restano umane

          L’articolo 41 affronta uno dei punti più delicati: le decisioni che incidono sul rapporto di lavoro. Se un datore utilizza sistemi di IA per valutazioni delle prestazioni, provvedimenti disciplinari o decisioni sulla modifica o cessazione del rapporto, la decisione finale non può essere adottata soltanto sulla base di un trattamento automatizzato. Deve essere riservata a una persona fisica con un potere effettivo e autonomo.

          Il decreto precisa che la ricerca e selezione delle candidature non rientrano tra le decisioni finali considerate dal comma. È una distinzione che non va letta come un “liberi tutti” per gli algoritmi di recruiting: restano applicabili gli altri obblighi pertinenti, compresi quelli europei su protezione dei dati e sistemi ad alto rischio.

          Il lavoratore può chiedere una motivazione comprensibile della decisione, con indicazione dell’eventuale ruolo dell’IA e dei principali parametri considerati. Il datore deve fornire l’informativa prevista prima dell’avvio del trattamento; le decisioni che violano il requisito dell’intervento umano effettivo sono dichiarate nulle dal testo. Il consenso del lavoratore, inoltre, non è una scorciatoia per aggirare il divieto.

          La regola si affianca alle tutele del Regolamento generale sulla protezione dei dati (GDPR), in particolare l’articolo 22, e alla disciplina italiana già prevista per l’uso di sistemi automatizzati nel lavoro. Non basta inserire un responsabile umano nella procedura: quel responsabile deve poter capire, contestare e modificare il risultato, invece di limitarsi a timbrarlo.

          La sicurezza sul lavoro entra nella valutazione dei rischi

          L’articolo 42 collega l’introduzione dell’IA nei luoghi di lavoro alla tutela della salute e della sicurezza. Se un sistema incide sull’organizzazione, sui ritmi produttivi, sulle modalità di esecuzione della prestazione o su processi rilevanti per la sicurezza, va considerato nella valutazione dei rischi prevista dal decreto legislativo 81/2008. I lavoratori devono inoltre ricevere informazione e formazione sui rischi specifici e sulle misure di prevenzione.

          Installare un sistema che assegna turni, misura tempi o influenza procedure operative non è solo una scelta informatica. Può cambiare il lavoro delle persone e i rischi a cui sono esposte. Questi aspetti vanno valutati, non scoperti dopo il primo problema.

          Sanità e professioni: attenzione alle regole attuative

          Il decreto contiene anche disposizioni settoriali. Per la sanità, la normativa prevede una piattaforma di IA gestita da AGENAS, con servizi di supporto per professionisti sanitari, medici e utenti. I suggerimenti destinati ai professionisti sono descritti come non vincolanti: la responsabilità clinica non viene trasferita alla piattaforma.

          Per professioni e altri ambiti, varie disposizioni si inseriscono nel quadro della legge 132/2025 e dei decreti delegati. Per questo è prudente distinguere fra ciò che la norma stabilisce già e ciò che dovrà essere precisato da linee guida, decreti e regole di settore. Il testo europeo dell’AI Act rimane il riferimento comune; il decreto italiano ne organizza l’attuazione nazionale e disciplina alcuni contesti specifici.

          Che cosa possono fare subito scuole, enti e aziende

          Il decreto non impone a ogni organizzazione lo stesso corso o lo stesso strumento. Offre però una traccia concreta per prepararsi:

          • Mappare gli usi dell’IA: quali sistemi vengono utilizzati, da chi e per quali attività.
          • Chiarire i ruoli: chi controlla gli output, chi prende le decisioni e chi risponde degli errori.
          • Formare in base ai compiti e ai rischi: non basta una dimostrazione generica del chatbot.
          • Rivedere privacy, sicurezza e procedure: soprattutto quando sono coinvolti dati personali o decisioni sulle persone.
          • Documentare le regole interne: uso consentito, verifiche richieste, limiti e modalità per segnalare problemi.
          • Seguire gli atti attuativi: alcuni dettagli dipendono da decreti e linee guida ancora da adottare.

          Per le aziende, il principio europeo di alfabetizzazione sull’IA è già previsto dall’articolo 4 dell’AI Act: chi fornisce o utilizza sistemi deve adottare misure per sostenere un livello adeguato di competenze tra le persone coinvolte. Il nuovo decreto aggiunge regole italiane per ambiti specifici, come scuola, PA, lavoro e sicurezza.

          Ho approfondito il tema della formazione nell’articolo “Formazione AI obbligatoria in azienda: cosa chiede l’AI Act e come prepararsi”. Per un percorso operativo, consulta anche i miei corsi di AI generativa e AI literacy per aziende, professionisti, enti e scuole.

          La legge stabilisce il perimetro, la formazione farà la differenza

          Il decreto legislativo 179/2026 non rende automaticamente più competenti scuole, amministrazioni o imprese. Definisce però una direzione: l’IA va accompagnata da competenze, attenzione ai diritti e responsabilità umana, soprattutto quando incide su istruzione, lavoro e servizi pubblici.

          La prova concreta arriverà nell’attuazione: nei decreti ministeriali, nelle linee guida, nei regolamenti interni e nella qualità della formazione. È lì che si capirà se l’alfabetizzazione sull’IA diventerà una competenza utile o resterà una voce elegante nei documenti. Perché saper aprire un chatbot è facile; capire quando non fidarsi della sua risposta richiede ancora un po’ di lavoro.

          Parliamo di AI in azienda

          Se la tua organizzazione sta introducendo strumenti di intelligenza artificiale, posso aiutarti a progettare un percorso di formazione concreto per dipendenti e manager, oppure a portare questi temi in un evento o in un progetto di consulenza. Raccontami di cosa hai bisogno: ti risponderò per valutare insieme il passo successivo.

            Qualche dettaglio sul corso (facoltativo)

            Qualche dettaglio sull’evento (facoltativo)

            Bastano poche righe. Se hai già una data o un obiettivo, aggiungili.

            I campi con * sono obbligatori.

            C’è chi al mattino manda fiori, glitter e tazzine di caffè. Io ho pensato di aggiungere tre notizie sull’intelligenza artificiale. Il nome della rubrica era praticamente scritto: Buongiornissimo AI. Sottotitolo: Tre notizie prima del caffè.

            L’idea è costruire un appuntamento quotidiano per Instagram, Facebook e LinkedIn: tre notizie recenti, spiegate in italiano, con un commento leggermente ironico e il mio avatar come protagonista. Una piccola redazione del mattino, con una tazzina al posto della riunione di coordinamento.

            La parte interessante è il percorso: dalla richiesta detta a voce alla definizione di un processo che comprende ricerca, verifica, scrittura, immagini, collegamenti ai social e programmazione. Ecco come l’ho impostato, comprese le correzioni fatte durante il lavoro.

            1. Sono partito dal risultato, detto a voce

            La prima richiesta era questa: ogni mattina alle sette trovare le tre migliori notizie delle ultime ventiquattro ore, soprattutto dagli Stati Uniti, e raccontarle con tre immagini con protagonista il mio avatar.

            Inizialmente pensavo a un reel. Avevo indicato pubblico, frequenza, contenuti, personaggio e destinazioni. Avevo anche chiesto proposte per il titolo della rubrica, suggerendo “Buongiornissimo AI”.

            Tra le alternative c’erano “Caffè corretto AI”, “AI, sveglia!” e “La notte porta algoritmi”. Ho confermato la prima idea. La sua ironia si abbina bene al tono che cerco anche nella mia rubrica Tecnorisate: tecnologia spiegata con un sorriso, senza rinunciare al senso critico.

            2. Ho cambiato il formato: dal reel al carosello

            A un certo punto ho corretto la richiesta: «Una variante non per fare il reel, ma per un carosello». Questo passaggio cambia il lavoro da svolgere. Il prodotto finale diventa una sequenza di immagini con testo leggibile, invece di un video da montare, sonorizzare e sottotitolare.

            Il formato approvato comprende quattro immagini in 4:5: una copertina e tre schede, una per notizia. La copertina rende riconoscibile la rubrica; le schede sviluppano i contenuti.

            La sequenza desiderata è semplice: che cosa è successo, perché conta e una breve osservazione ironica. Se la battuta occupa tutto lo spazio e la notizia scompare, abbiamo preparato una cartolina, non una rassegna.

            3. Ho chiesto ricerca online e verifica delle notizie

            La ricerca delle notizie è un passaggio distinto dalla loro riscrittura. Nel brief ho chiesto novità delle ultime ventiquattro ore, con attenzione particolare agli Stati Uniti e ai temi che seguo: AI generativa, chatbot, agenti, applicazioni concrete, lavoro e comunicazione.

            Il criterio editoriale prevede almeno cinque risorse autorevoli complessive: annunci originali, documentazione, studi e testate affidabili. Quando possibile, un annuncio aziendale va confrontato con una fonte indipendente.

            Ho inserito una regola fondamentale: distinguere la data dell’articolo dalla data dell’evento. Una notizia vecchia ripresa oggi resta una notizia vecchia. E se non emergono tre aggiornamenti solidi, il processo deve segnalarlo e preparare meno schede. Il numero tre è un formato editoriale, non una licenza per inventare.

            4. Ho dato all’avatar un’identità visiva precisa

            La richiesta per la grafica era molto concreta: il mio avatar che beve un caffè, con i simboli di ChatGPT, Gemini, Claude e altri strumenti visibili dentro la tazzina. Un’immagine volutamente illustrativa, che rende riconoscibile la rubrica.

            Il riferimento deve essere il mio avatar originale. L’obiettivo è conservare volto, abbigliamento e identità, cambiando la scena in funzione della notizia. La documentazione di OpenAI sulla generazione di immagini descrive sia la creazione sia la modifica di immagini: nel mio progetto, il riferimento visivo e gli esempi approvati servono a guidare questa continuità.

            Ho guardato le immagini una alla volta e, dopo aver approvato tutte e tre, ho indicato che lo stile doveva restare quello. Questa approvazione va tradotta in un riferimento stabile accessibile anche alle esecuzioni future: palette, composizione, carattere dell’avatar, posizione dei titoli e livello di dettaglio.

            Nel video seguente mostro un test collegato: come creo varianti del mio avatar con ChatGPT. È il contesto visivo da cui nasce anche questa rubrica.

            5. Ho chiesto di verificare i collegamenti ai tre social

            Sapevo di aver collegato Instagram e LinkedIn, mentre non ero sicuro di Facebook. Ho quindi chiesto una verifica tramite Composio. Nella conversazione il collegamento Facebook è passato attraverso un’autorizzazione aggiuntiva, che ho completato.

            Il ruolo di Composio è mettere a disposizione strumenti per agire sulle applicazioni collegate, come spiega la sua documentazione sul funzionamento delle sessioni e degli strumenti. La documentazione sull’autenticazione chiarisce il ruolo delle connessioni agli account. Per il mio flusso, occorre verificare anche quale profilo o Pagina verrà usato e quali operazioni sono effettivamente autorizzate.

            Le destinazioni previste sono Instagram @gbonanomi, il mio profilo LinkedIn e la Pagina Facebook “Gianluigi Bonanomi Formatore sulla Comunicazione Digitale”. Un account collegato è un prerequisito; la prova del risultato resta la pubblicazione riuscita, con il relativo link.

            Anche il formato va precisato: su Instagram voglio un carosello; su Facebook un post con più foto; su LinkedIn un post con più immagini. Microsoft documenta il formato MultiImage di LinkedIn. Un documento PDF è un’opzione diversa e non fa parte del formato confermato per questa prova.

            6. Ho approvato un esempio prima della ricorrenza

            Prima di chiedere la programmazione, ho voluto vedere il primo carosello. Ho approvato le immagini una alla volta e autorizzato la pubblicazione sui tre canali. Il registro del 12 ottobre conserva gli esiti separati: Instagram e Facebook risultano pubblicati e verificati; per LinkedIn la creazione è riuscita, mentre la lettura successiva ha restituito un errore di accesso. Quel limite non va confuso con una pubblicazione fallita e non giustifica un secondo invio.

            Questo test serve a valutare l’intero percorso: qualità della selezione, sintesi dei testi, riconoscibilità dell’avatar, leggibilità e resa sui social. La sola presenza di immagini convincenti non dimostra che tutti i passaggi successivi funzionino.

            Copertina Buongiornissimo AI con avatar e caffè.
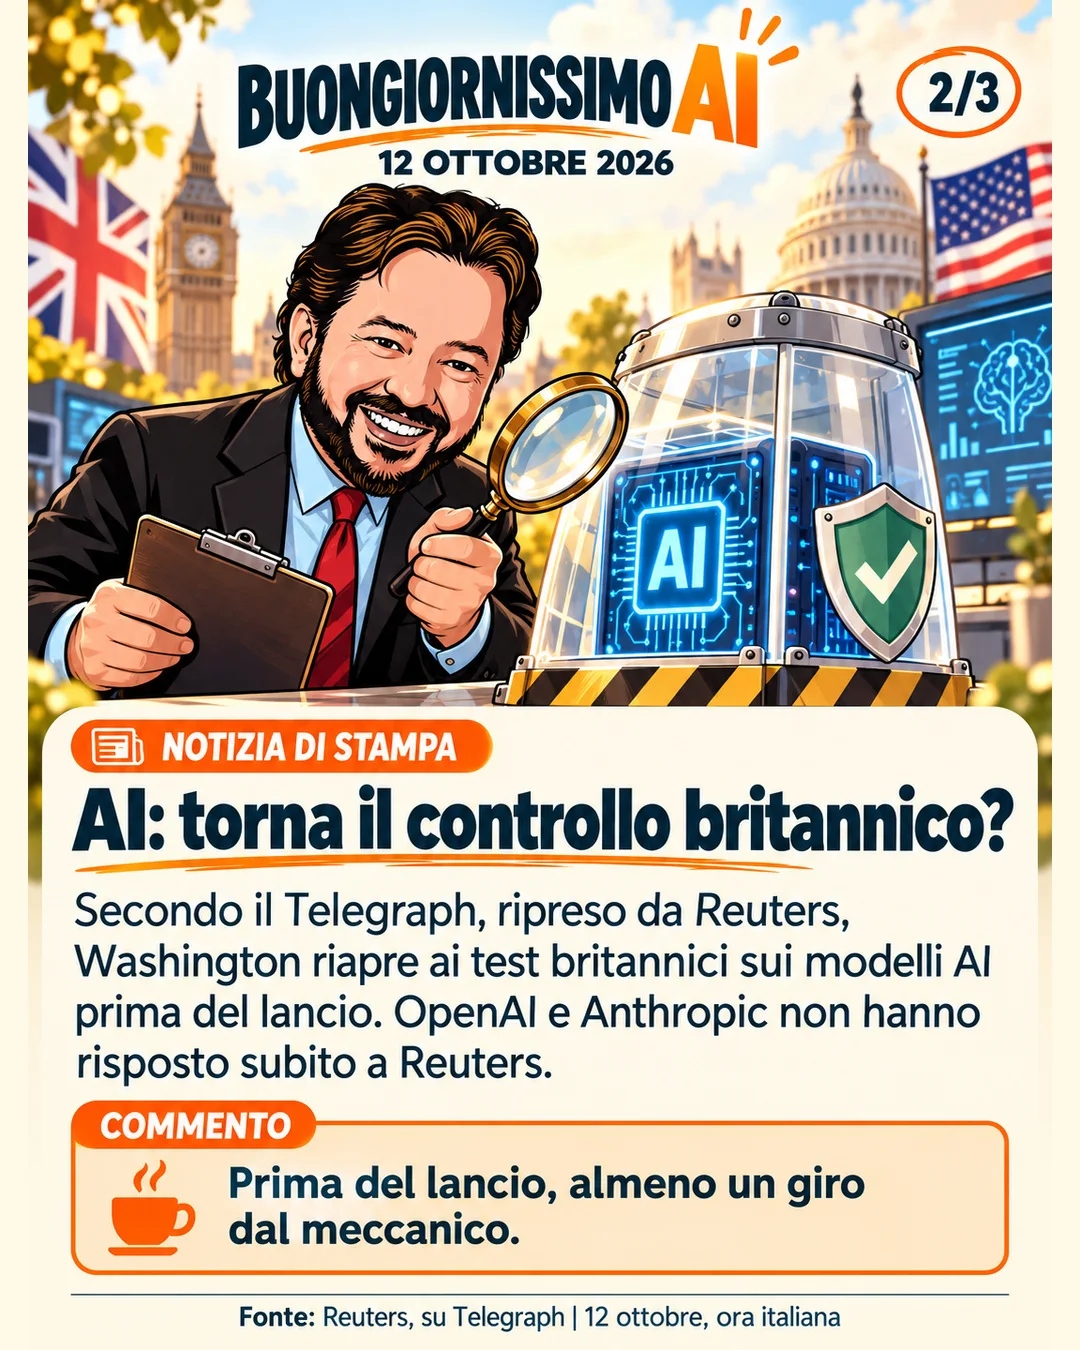
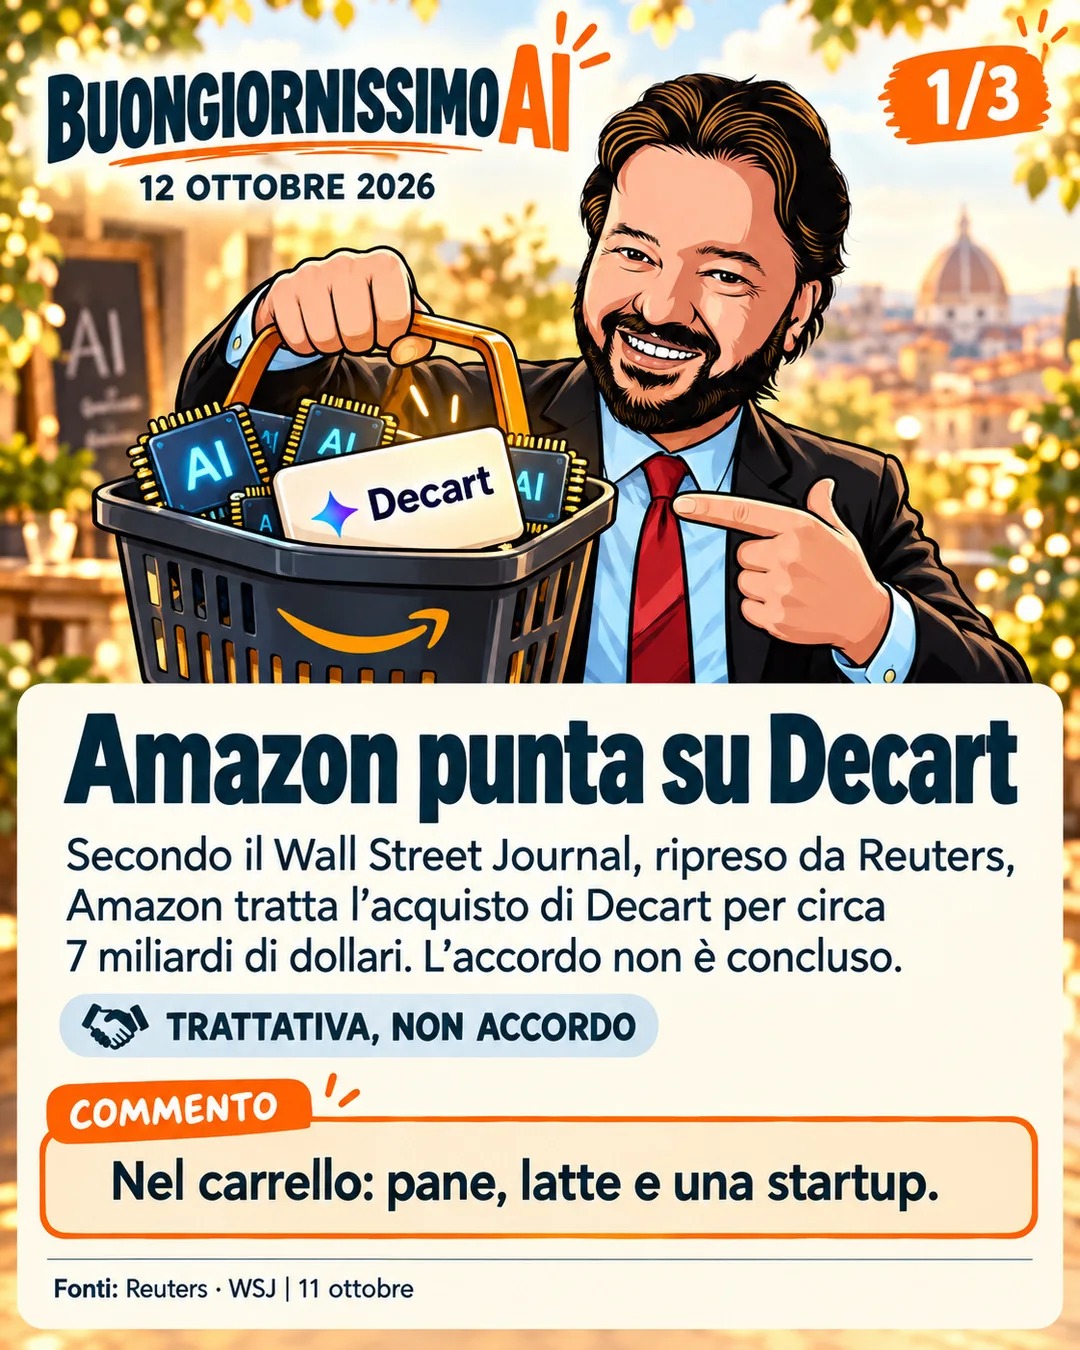
            Scheda 1 del primo carosello Buongiornissimo AI del 12 ottobre 2026.
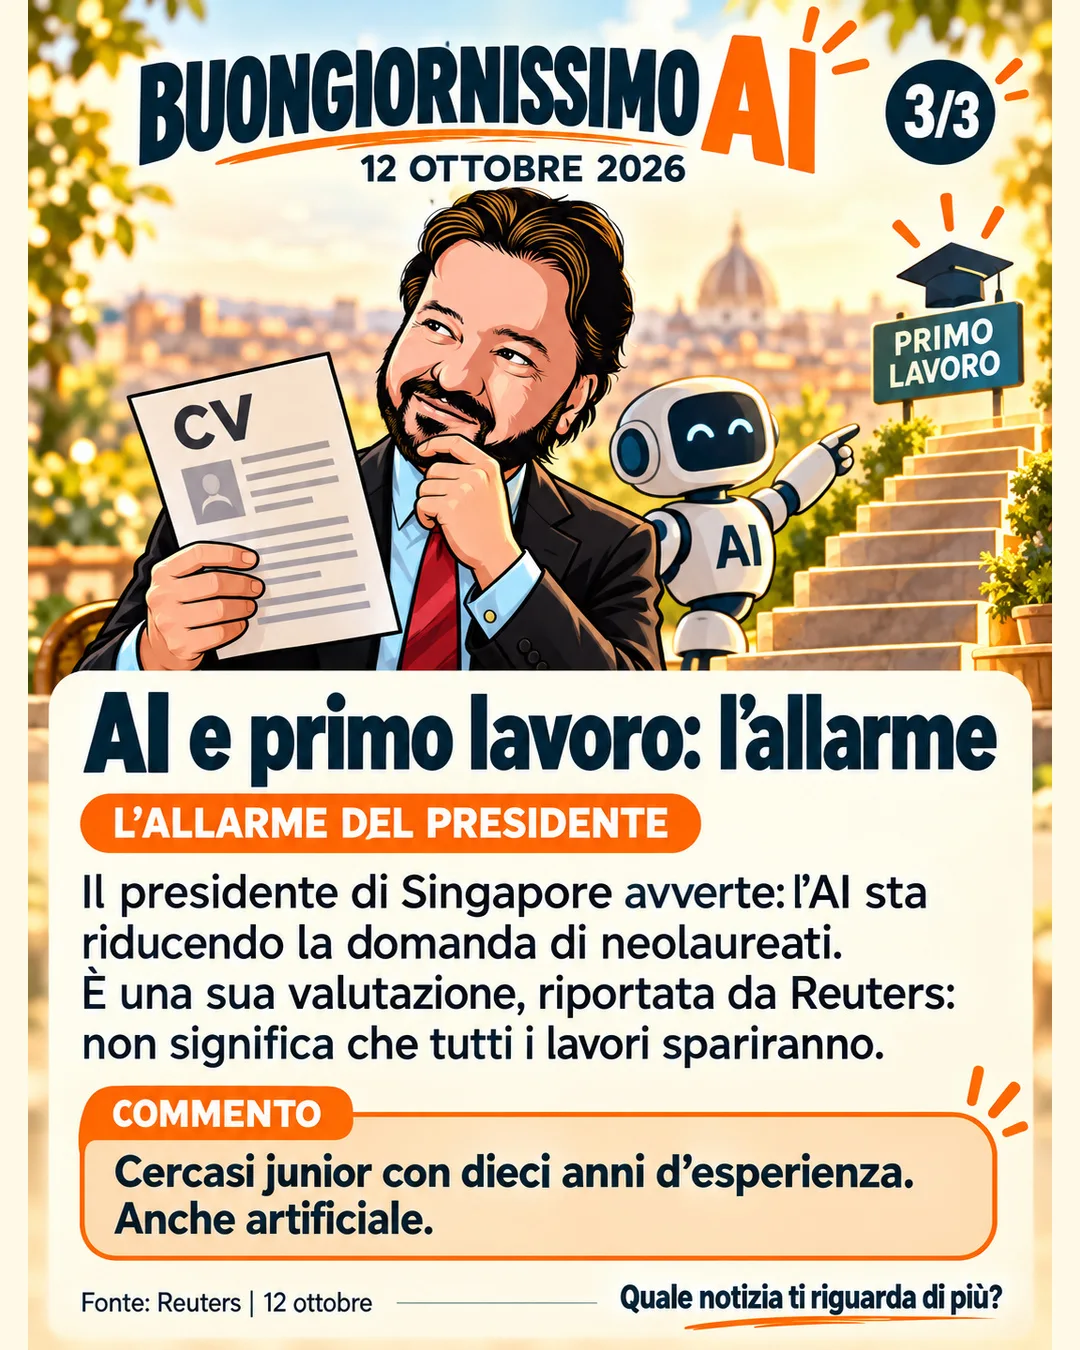
            Scheda 2 del primo carosello Buongiornissimo AI del 12 ottobre 2026.
            Scheda 3 del primo carosello Buongiornissimo AI del 12 ottobre 2026.

            7. Come impostare la programmazione quotidiana delle 7

            La richiesta finale è stata di aggiungere “Buongiornissimo AI” alle azioni già presenti, senza interrompere le altre. Il numero delle azioni disponibili va controllato nel pannello aggiornato; il conteggio riportato durante una conversazione non sostituisce quella verifica.

            La documentazione sulle attività programmate di ChatGPT distingue l’orario o l’evento che avvia il lavoro dal prompt che descrive cosa eseguire. Specifica inoltre che le attività compatibili possono usare skill e plugin. Nel mio caso occorre rendere disponibili ricerca, riferimento dell’avatar e strumenti di pubblicazione anche durante l’esecuzione programmata.

            I passaggi da completare sono questi:

            1. Salvare il brief editoriale e gli esempi visivi approvati.
            2. Verificare che i collegamenti ai tre canali siano utilizzabili dal contesto programmato.
            3. Misurare la durata di una prova completa, dalla ricerca alla pubblicazione.
            4. Impostare una ricorrenza quotidiana nel fuso Europe/Rome, con preparazione anticipata se l’obiettivo è l’uscita alle 7.
            5. Salvare nell’azione il prompt completo, le destinazioni e l’autorizzazione alla pubblicazione automatica.
            6. Controllare che l’azione risulti attiva e verificare le prime esecuzioni, con esito separato per ogni piattaforma.

            L’azione quotidiana è stata creata e attivata, con avvio della ricerca e produzione alle 7, nel fuso Europe/Rome, dal 13 ottobre 2026. I post vengono pubblicati al termine della preparazione. Avviare il lavoro alle 7 non garantisce un’uscita esattamente alle 7: ricerca e generazione richiedono tempo. Per una maggiore puntualità occorre misurare i tempi e anticipare la preparazione.

            Il prompt operativo per Buongiornissimo AI

            Ogni giorno prepara “Buongiornissimo AI”, sottotitolo “Tre notizie prima del caffè”, per Gianluigi Bonanomi.
            
            Obiettivo: avviare ricerca e produzione ogni mattina alle 7:00, fuso Europe/Rome, su Instagram @gbonanomi, sul profilo LinkedIn di Gianluigi Bonanomi e sulla sua Pagina Facebook verificata. Pubblica al termine della preparazione.
            
            Cerca online tre notizie distinte sull’AI delle ultime 24 ore rispetto alla ricerca, soprattutto dagli Stati Uniti. Consulta almeno cinque risorse autorevoli complessive. Verifica date, nomi, numeri e disponibilità; separa annunci, indiscrezioni e fatti. Evita ripetizioni usando lo storico accessibile. Se non trovi tre notizie solide, riduci il numero delle schede e segnala il motivo.
            
            Per ogni notizia prepara un titolo di massimo otto parole, una spiegazione breve, una frase sulla sua utilità e un commento ironico riconoscibile come tale. Italiano naturale, nessuna emoji, nessun trattino lungo.
            
            Crea quattro immagini separate: copertina più tre notizie, in 4:5 (1080 × 1350). Usa l’avatar originale e gli esempi visivi salvati. Mantieni lo stesso stile. La copertina deve rendere riconoscibili nome e data della rubrica. Se il riferimento non è accessibile, segnala il blocco senza inventare un avatar sostitutivo.
            
            Prepara una didascalia per Instagram e Facebook e una versione adatta a LinkedIn. Riporta le fonti con link e associazione alle notizie nella didascalia o in un commento accessibile, secondo le possibilità del canale.
            
            Verifica accuratezza, refusi, avatar, leggibilità, ordine e disponibilità dei file. Pubblica automaticamente sui tre canali autorizzati: carosello Instagram, post con più foto Facebook, post con più immagini LinkedIn.
            
            Controlla separatamente l’esito di ogni pubblicazione e restituisci i link. Non ripubblicare sui canali già riusciti se uno fallisce. In caso di risultato incerto, controlla prima di riprovare. Conserva materiali, notizie e identificativi per evitare duplicati. Non dichiarare riuscite operazioni prive di conferma.

            Le skill danno continuità al lavoro

            In questo progetto le funzioni da coordinare sono cinque: ricerca delle notizie, verifica editoriale, scrittura, generazione delle immagini e pubblicazione. La ricorrenza stabilisce quando attivarle.

            Una skill può raccogliere regole riutilizzabili: tono, criteri di selezione, struttura delle schede e controlli. In questa configurazione l’azione richiama Library per recuperare avatar, esempio approvato e registro; Composio per usare i canali collegati; la generazione immagini per produrre le nuove schede. Le istruzioni della rubrica sono salvate nel prompt dell’azione, senza attribuire alla prova una skill dedicata che non è stata creata.

            La cosa che volevo ottenere era questa: trasformare un’idea detta a voce in un appuntamento editoriale con regole chiare e uno stile riconoscibile. Il caffè può essere disegnato dall’AI. Le notizie, prima di servirle, vanno controllate.

            Vuoi progettare un’automazione per i tuoi contenuti?

            Nei miei corsi lavoriamo su casi concreti come questo: definiamo obiettivi, fonti, stile e controlli, poi mettiamo alla prova il processo. Se vuoi capire come applicarlo alla tua attività, scrivimi.

              Il tuo nome (richiesto)

              La tua email (richiesto)

              Oggetto

              Il tuo messaggio

              Pagavo 60 euro su Fiverr per farmi realizzare delle varianti del mio avatar. A un certo punto ho provato ad affidare la stessa operazione a ChatGPT. Il risultato mi ha soddisfatto: per quella specifica esigenza ho ottenuto rapidamente ciò che cercavo, senza commissionare un’altra lavorazione.

              Da qui nasce il mio video “ChatGPT sta già sostituendo i grafici?”. Vi mostro il test e parto da una domanda che sento continuamente durante i miei corsi: l’intelligenza artificiale ci ruberà il lavoro? Non sono convinto che lo ruberà a tutti. Ma liquidare il problema con “la creatività umana è insostituibile” mi sembra altrettanto sbrigativo.

              Guarda il video: il mio test con ChatGPT al posto di Fiverr

              Prima di ragionare su professioni e scenari, guardate che cosa è successo in questo caso concreto. Nel video mostro l’operazione sul mio avatar e spiego perché ho smesso di acquistare quella specifica prestazione su Fiverr.

              Puoi anche guardare il video direttamente su YouTube. Tenete a mente una distinzione: ottenere una variante di un’immagine già definita e progettare un’identità visiva sono lavori con obiettivi e responsabilità diversi.

              Da 60 euro a un abbonamento: il risparmio va capito

              Nel mio caso, il confronto era tra una lavorazione da 60 euro e un abbonamento che, nel racconto del test, considero nell’ordine dei 20 euro al mese. È un confronto riferito alla mia esperienza, non un listino aggiornato di ChatGPT né una promessa di ottenere qualsiasi lavoro grafico a quel prezzo.

              Se una singola prestazione evitata vale più del costo mensile dello strumento, il vantaggio economico può essere immediato. Per valutare davvero il risparmio, però, bisogna considerare anche il tempo per dare istruzioni, selezionare le proposte e correggere eventuali difetti. Un risultato che giudico adatto alle mie slide non è automaticamente un file pronto per ogni impiego professionale.

              E la formula “perfetto in un secondo”? Rende bene lo stupore, ma non è un benchmark. La formulazione che preferisco è questa: un risultato rapidamente utilizzabile per la mia esigenza. Velocità e qualità vanno valutate sull’intero processo, non soltanto sul momento in cui compare l’immagine.

              AI e lavoro: distinguere le mansioni dalle professioni

              Un mestiere è composto da molte attività. Un grafico può discutere il brief, studiare il pubblico, progettare un sistema visivo, produrre varianti, verificare la coerenza e gestire revisioni. Automatizzare una di queste attività cambia il mestiere; non dimostra, da solo, che l’intera professione sia scomparsa.

              Il rapporto 2025 dell’Organizzazione internazionale del lavoro (ILO), realizzato con NASK, stima che un lavoratore su quattro nel mondo sia in un’occupazione con qualche grado di esposizione all’AI generativa. Gli autori indicano la trasformazione del lavoro come esito più probabile, perché molte occupazioni comprendono attività che richiedono ancora un contributo umano. Esposizione non significa posti già persi.

              Non sarebbe corretto, però, trasformare questa distinzione in una rassicurazione universale. Se una parte consistente dei ricavi di un professionista arriva da prestazioni che i clienti iniziano a svolgere da soli, la perdita di incarichi può essere reale anche se il nome della professione continua a esistere. Nel mio piccolo, ho smesso di acquistare un servizio: per chi lo vendeva, quella domanda è venuta meno.

              Lo studio di Ole Teutloff e colleghi sulla domanda di freelance, pubblicato nel Journal of Economic Behavior & Organization, osserva su una piattaforma online un calo della domanda per alcune competenze sostituibili, come scrittura e traduzione, rispetto alla tendenza controfattuale. È un risultato circoscritto a quel mercato e a quelle attività: non misura tutti i grafici e non consente di generalizzare il mio test a un intero settore. Mostra però perché il problema degli incarichi va preso sul serio.

              Il valore del grafico: decidere che cosa deve comunicare un’immagine

              Continuo a vedere valore nel professionista che sa capire un problema di comunicazione, scegliere una direzione, motivarla e portarla fino alla consegna. Per esempio: a chi deve parlare quell’avatar? In quale contesto verrà usato? Deve trasmettere autorevolezza, ironia o vicinanza? Quali elementi devono restare riconoscibili nelle diverse versioni?

              Sono le domande che propongo di mettere al centro del servizio. L’AI può aiutare anche a esplorare idee e soluzioni, ma qualcuno deve stabilire criteri, valutare il risultato e assumersi la responsabilità della scelta. Vendere questa capacità richiede di renderla visibile al cliente, non soltanto di dichiararsi creativi.

              Il rischio riguarda anche attività meno ripetitive di quanto immaginiamo. Nello studio sperimentale di Fabrizio Dell’Acqua e colleghi, nella versione del 2023, i consulenti con GPT-4 miglioravano velocità e qualità su compiti compatibili con le capacità del sistema, ma su un compito esterno a quella frontiera producevano meno spesso una soluzione corretta. La ricerca riguarda quel modello e quei compiti: la lezione utile è imparare a valutare dove l’assistenza funziona e dove serve un controllo più attento.

              La creatività umana non è una polizza contro l’automazione

              Dire che la “vera creatività” resterà sempre esclusivamente umana può essere una posizione filosofica. Non la userei come garanzia economica. Un cliente può scegliere un risultato che considera utile e originale senza dover risolvere prima il dibattito sulla coscienza delle macchine.

              La ricerca di Anil R. Doshi e Oliver P. Hauser, pubblicata su Science Advances nel 2024, aiuta a complicare il quadro: in un esperimento sulla scrittura di racconti, accedere a idee generate dall’AI migliorava le valutazioni di creatività, qualità e piacevolezza, soprattutto per gli autori inizialmente meno creativi. Al tempo stesso, i racconti assistiti risultavano più simili fra loro. Non è uno studio sul graphic design, ma suggerisce un’opportunità e un rischio: ottenere proposte migliori e finire tutti nella stessa zona delle idee.

              Per questo consiglio di usare l’AI anche come interlocutore creativo, continuando a cercare riferimenti, esperienze e scelte riconoscibili. La capacità di selezionare e modificare le proposte diventa parte del lavoro. Ho affrontato un cambiamento simile nell’articolo su come l’AI sta rivoluzionando le presentazioni: produrre più facilmente i materiali rende ancora più utile progettare bene il messaggio.

              Harari, il senso del lavoro e le scelte che restano nostre

              Il riferimento a Yuval Noah Harari invita ad allargare lo sguardo. Nelle FAQ pubblicate sul suo sito ufficiale, lo storico descrive sia scenari di esclusione dal lavoro sia scenari nei quali la tecnologia libera le persone da attività faticose e consente di sviluppare il proprio potenziale. Sottolinea che l’esito dipende dalle scelte umane, non da un destino tecnologico già scritto.

              La mia lettura è che il tempo risparmiato possa essere reinvestito nella progettazione, nella relazione con il cliente e nella qualità delle decisioni. Non attribuisco a Harari la formula “automatizzare l’esecuzione per concentrarsi sul senso” come se fosse una sua citazione: è il modo in cui io traduco questa riflessione nel lavoro quotidiano.

              E non avviene automaticamente. Un’azienda può usare il tempo guadagnato per formare le persone, migliorare il servizio oppure chiedere più produzione a parità di risorse. L’AI apre possibilità; la scelta organizzativa decide come distribuirne i benefici.

              Parti da una tua attività e guarda il test

              L’esperimento che suggerisco è semplice: scegliete una prestazione circoscritta, definite prima che cosa rende il risultato accettabile e confrontate il processo abituale con quello assistito dall’AI. Misurate tempo complessivo, qualità, correzioni e costo. Poi chiedetevi quali parti richiedano ancora la vostra competenza e come valorizzarle.

              Guardate il mio test nel video “ChatGPT sta già sostituendo i grafici?” e provate a riportarlo al vostro lavoro. Quale prestazione potrebbe smettere di essere acquistata? Quale competenza, invece, potreste offrire meglio grazie al tempo guadagnato?

              Guarda il video su YouTube e valuta il risultato del test.

              Vuoi sperimentare l’AI nel lavoro del tuo team?

              Nei miei corsi per aziende, professionisti ed enti partiamo da attività concrete, definiamo criteri di qualità e proviamo a capire dove l’AI può aiutare. Se vuoi organizzare un laboratorio su questi temi, scrivimi indicando il pubblico e le attività sulle quali vorresti lavorare.

                Il tuo nome (richiesto)

                La tua email (richiesto)

                Oggetto

                Il tuo messaggio

                Immaginate questa telefonata: «Papà, ho avuto un problema. Mi servono dei soldi subito. Ti prego, non chiamare nessuno». Dall’altra parte sentite una voce familiare. Oppure siete in amministrazione e arriva un messaggio vocale del titolare: «Fai questo bonifico adesso, poi ti spiego». Sono due scene esemplificative, non il racconto di episodi che mi sono accaduti. Ma pongono una domanda molto concreta: basta riconoscere una voce per sapere chi sta parlando?

                Con i deepfake vocali, la risposta è no. E una delle contromisure più accessibili consiste nel concordare in anticipo una parola segreta, o meglio una breve frase segreta, con i propri familiari. In azienda un accordo simile può aiutare, purché resti dentro una procedura di verifica. Mi piace questa soluzione perché si può spiegare senza aprire un manuale di informatica. Però va usata bene: una parola corretta non è un lasciapassare per un bonifico.

                Che cosa sono le truffe con deepfake vocali

                Un deepfake vocale è un audio sintetico o manipolato che imita la voce di una persona. La Federal Trade Commission, l’autorità statunitense per la tutela dei consumatori, spiega che un truffatore può sfruttare una breve registrazione, anche ricavata da contenuti pubblicati online, per simulare la voce di un familiare. Non esiste una durata magica dell’audio che renda ogni imitazione perfetta: la qualità dipende dallo strumento e dal materiale disponibile.

                Il messaggio può arrivare come telefonata o nota vocale. Non occorre immaginare sempre una conversazione generata in tempo reale: anche un breve audio preparato può servire a rendere credibile una richiesta. Nell’allerta del 15 maggio 2025, il Federal Bureau of Investigation (FBI) ha documentato una campagna di messaggi e audio generati con l’AI che impersonavano alti funzionari statunitensi. La clonazione della voce è dunque anche uno strumento per conquistare fiducia e ottenere accesso agli account.

                In famiglia: la falsa emergenza mette fretta

                Nel nostro esempio, una figlia dice di avere perso il telefono, di essere bloccata o di aver bisogno di un pagamento urgente. Il genitore prova ad aiutare. Il truffatore aggiunge fretta e isolamento: «Non dirlo alla mamma», «Non chiamarmi, questo telefono non riceve», «Manda subito». Il copione mira a far partire il pagamento prima della verifica.

                La FTC descrive proprio le false emergenze familiari rese più convincenti dalla clonazione vocale e raccomanda di contattare la persona usando un numero già noto. Se non risponde, suggerisce di cercarla attraverso altri familiari o amici. È un passaggio essenziale: l’impossibilità di raggiungerla subito non conferma la storia raccontata dal chiamante.

                Una parola segreta contro i deepfake vocali: come sceglierla

                La proposta non è una mia invenzione. Nell’avviso dell’Internet Crime Complaint Center dell’FBI del 3 dicembre 2024, tra le contromisure compare esplicitamente una parola o frase segreta familiare per verificare l’identità. Lo stesso documento descrive l’uso di audio sintetici per impersonare parenti in difficoltà.

                Ecco come propongo di trasformare quel consiglio in un’abitudine concreta:

                • Scegliete insieme una breve frase insolita e facile da ricordare. Evitate nomi, compleanni, scuole e informazioni che avete già pubblicato. «Il tostapane va in vacanza» è soltanto un esempio inventato per questo articolo: proprio perché è pubblico, non usatelo.
                • Concordatela in un momento tranquillo e riservato. Coinvolgete chi potrebbe ricevere una richiesta, compresi i nonni. Spiegate quando serve e fate una prova.
                • Tenetela separata dalle password degli account. Non riutilizzate credenziali, PIN o codici bancari. Non pubblicatela e non lasciatela in messaggi o documenti facilmente accessibili.
                • Chiedete la frase senza suggerirla. «Qual è la nostra frase?» è diverso da «La frase era il tostapane, vero?». Se la dite voi, avete appena regalato la risposta.
                • Cambiatela se viene esposta. Se l’avete pronunciata a un sospetto truffatore o temete che qualcuno l’abbia letta, concordatene una nuova attraverso un contatto verificato.

                Se la persona sbaglia o non ricorda, non concludete automaticamente che l’emergenza sia falsa: una persona davvero in difficoltà potrebbe confondersi. Fermate il pagamento e verificate per un’altra strada. La frase serve ad aggiungere un controllo, non a decidere se qualcuno meriti aiuto.

                La regola da ricordare: chiedi, chiudi, richiama

                Una richiesta urgente di denaro o dati dovrebbe attivare questa sequenza: chiedi la frase, chiudi la chiamata, richiama il numero che conosci già. Non usare quello indicato nel nuovo messaggio. Se non riesci a verificare, coinvolgi un altro contatto fidato. Anche se la frase è corretta, una richiesta insolita merita conferma.

                Il limite è semplice: un segreto può essere rubato, ascoltato o fatto rivelare con un inganno. Una volta noto, può essere pronunciato anche dalla voce falsa. Per questo considero la parola segreta un controllo in più, non una protezione infallibile. Non comunicate mai codici di accesso temporanei per “dimostrare chi siete”: l’FBI avverte anche del furto dei codici di autenticazione attraverso queste campagne.

                In azienda: il capo deve rispettare la procedura

                Torniamo al falso titolare. «Sono in riunione, non posso parlare. Paga questo nuovo fornitore». Una frase di verifica concordata con un gruppo ristretto può far emergere un problema, ma non dovrebbe autorizzare un’operazione. Se tutti in azienda conoscono lo stesso segreto e lo scrivono ovunque, quel controllo perde gran parte del suo valore.

                Nella guida al Business Email Compromise, le frodi che sfruttano comunicazioni aziendali apparentemente legittime, l’FBI raccomanda di verificare richieste di pagamento e cambiamenti delle coordinate attraverso un contatto diretto, prestando particolare attenzione alla fretta. Il consiglio riguarda le frodi via email, ma applicarlo anche alle richieste vocali è una precauzione organizzativa sensata.

                La procedura che suggerisco alle aziende prevede:

                • Richiamata su un recapito già verificato per richieste insolite e cambi di IBAN, usando la rubrica aziendale o l’anagrafica del fornitore.
                • Seconda approvazione per pagamenti rilevanti o fuori dalle modalità abituali, secondo soglie definite dall’organizzazione.
                • Conferma nel sistema previsto per i pagamenti, con verifica di beneficiario, importo e causale. Un audio non deve sostituire l’autorizzazione.
                • Possibilità di sospendere l’operazione senza rimproveri. La verifica deve essere consentita anche quando la richiesta sembra arrivare dall’amministratore delegato.

                La frase utile per chi lavora in amministrazione è: «Verifico attraverso il canale concordato e poi procedo». Questa può essere pubblica: è una regola di lavoro, non il segreto di autenticazione.

                Perché non basta cercare una voce metallica

                Accenti strani, pause e risposte incoerenti possono insospettire, ma non sono un test affidabile. Una cattiva connessione può rendere strana anche una chiamata autentica. Il National Cyber Security Centre britannico segnala che i contenuti sintetici diventano più difficili da distinguere e che gli strumenti di rilevamento possono essere inefficaci o inaffidabili. Affidare tutto all’orecchio, o a un’app che promette un verdetto definitivo, lascia quindi un vuoto nella verifica.

                Per vedere un esempio giornalistico del problema, questo servizio di NBC News del marzo 2023, in inglese, racconta il rischio delle chiamate che imitano la voce di un familiare. È un approfondimento d’archivio, non una misura della diffusione attuale delle truffe.

                Una prova da fare prima della telefonata

                Dedicate pochi minuti a una simulazione concordata, senza clonare voci e senza spaventare nessuno. Una persona interpreta una richiesta insolita di denaro; l’altra chiede la frase, interrompe e richiama il contatto già noto. Poi invertite i ruoli. In ufficio aggiungete il passaggio della seconda approvazione. Se durante la prova nessuno sa chi chiamare, avete trovato qualcosa da sistemare prima di una vera emergenza.

                Per chi vuole lavorare sul tema con i figli, nel mio corso sull’intelligenza artificiale per genitori con Fastweb Digital Academy c’è anche un modulo dedicato ai deepfake e alla verifica dei contenuti.

                Se avete già disposto un pagamento sospetto, contattate subito la banca o il servizio usato per pagare e chiedete quali interventi siano ancora possibili, senza dare per certo il recupero. Conservate messaggi e dettagli dell’operazione; in azienda avvisate immediatamente chi gestisce sicurezza e amministrazione. La tempestività nel contattare l’intermediario è raccomandata anche dalla guida dell’FBI alle frodi BEC.

                Il consiglio che lascio è molto pratico: concordate oggi una frase riservata e una procedura di richiamata. Non serve smettere di fidarsi dei familiari o dei colleghi. Serve dare alla fiducia un modo per verificare chi sta davvero chiedendo qualcosa. Una voce può essere imitata; la vostra procedura deve continuare a valere anche quando quella voce sembra perfetta.

                Vuoi organizzare un corso sull’AI e sui rischi dei deepfake?

                Organizzo corsi e workshop per aziende, enti e associazioni sull’uso consapevole dell’intelligenza artificiale, con esempi pratici e simulazioni. Se vuoi approfondire questi temi con il tuo team o organizzare un incontro per famiglie e genitori, scrivimi usando il modulo qui sotto.

                  Il tuo nome (richiesto)

                  La tua email (richiesto)

                  Oggetto

                  Il tuo messaggio

                  Puoi indicare il pubblico, il tema e il formato dell’incontro che hai in mente.

                  Quando si parla di intelligenza artificiale, l’Italia sembra spesso il Paese che arriva alla festa quando stanno già sparecchiando. Gli altri costruiscono i modelli, noi discutiamo se sia opportuno usarli. Una rappresentazione efficace, soprattutto per un titolo. Ma quanto è corretta?

                  La domanda da cui partire è molto concreta: esistono LLM italiani, cioè grandi modelli linguistici sviluppati da realtà del nostro Paese? Sì. Ci sono progetti universitari, modelli industriali e adattamenti di tecnologie internazionali. Per capire che cosa rappresentano, però, dobbiamo distinguere la ricerca dalla pubblicità e l’origine di un modello dalle prestazioni che riesce a dimostrare.

                  Che cosa significa davvero “LLM italiano”

                  Un LLM è il modello che elabora e genera linguaggio; un chatbot è uno dei modi con cui possiamo utilizzarlo. Un’interfaccia in italiano, magari con un nome evocativo e il tricolore nel logo, non basta a dimostrare che sotto ci sia un modello sviluppato in Italia.

                  Per orientarsi, propongo di separare quattro domande: chi lo sviluppa? Su quali dati viene addestrato? Parte da un modello già esistente? Dove viene eseguito? Sono aspetti distinti, che possono combinarsi in modi diversi.

                  Addestrare da zero significa costruire le capacità del modello attraverso il preaddestramento, anziché partire dai pesi già appresi da un altro LLM. Adattare un modello significa intervenire su una base esistente, per esempio con ulteriore addestramento o con esempi di istruzioni e risposte. Il paper scientifico su Minerva, presentato a CLiC-it 2024, affronta proprio questa distinzione e il controllo sui dati e sul vocabolario che il preaddestramento consente.

                  Un progetto derivato può essere molto utile e richiedere competenze importanti. Basta descriverlo per quello che è. Anche il luogo di esecuzione è un’altra questione: un modello straniero può funzionare su un server italiano. Il passaporto del produttore e l’indirizzo del data center non sono la stessa informazione.

                  LLM italiani: alcuni progetti documentati

                  Quella che segue è una selezione di progetti verificabili, con caratteristiche diverse. Non è una classifica né un censimento completo. Le informazioni sono state controllate il 9 ottobre 2026; dove si parla di capacità dichiarate dai produttori, queste non vanno confuse con risultati di una mia prova comparativa.

                  Minerva: dalla Sapienza a ChatMinerva

                  Minerva nasce dal gruppo Sapienza NLP della Sapienza Università di Roma, guidato da Roberto Navigli. Il progetto coinvolge la Fondazione FAIR e utilizza il supercomputer Leonardo di CINECA. Il sito ufficiale di Minerva documenta una famiglia di modelli preaddestrati da zero su dati in italiano e inglese, con taglie da 350 milioni a 7 miliardi di parametri.

                  C’è anche una distinzione utile per chi vuole provarlo: Minerva indica la famiglia di modelli; ChatMinerva è l’assistente che li porta dentro un’esperienza d’uso. Il sito presenta un percorso di industrializzazione con Babelscape e funzioni per lavorare con documenti e immagini. L’esistenza di questi servizi non rende automaticamente tutte le funzioni proprietà del solo modello linguistico di base.

                  Velvet: modelli multilingue sviluppati da Almawave

                  Velvet è la famiglia di LLM sviluppata da Almawave. La scheda tecnica ufficiale di Velvet-14B descrive modelli sviluppati da zero e addestrati sull’infrastruttura Leonardo di CINECA. Le taglie indicate sono 2 e 14 miliardi di parametri; le lingue comprendono italiano, inglese, francese, tedesco, spagnolo e portoghese.

                  La scheda indica una licenza Apache 2.0. È un elemento concreto per chi valuta integrazioni e personalizzazioni, ma non è una certificazione di qualità per ogni compito. La stessa documentazione riconosce possibili risposte inesatte e la necessità di verificare il comportamento nelle applicazioni specifiche.

                  FastwebMIIA: modello e offerta per imprese e PA

                  FastwebMIIA, Modello Italiano di Intelligenza Artificiale, è documentato nella model card ufficiale pubblicata da Fastweb. La versione descritta ha 7 miliardi di parametri ed è stata progettata e addestrata con attenzione alla lingua e al contesto culturale italiani.

                  Qui la licenza merita attenzione: la distribuzione pubblica prevede condizioni per usi non commerciali e determinati usi interni; per gli impieghi commerciali è prevista una licenza distinta. La pagina dell’offerta aziendale FastwebMIIA presenta anche modalità on-premise e private cloud. Quindi esistenza del modello, accesso ai pesi e condizioni di impiego sono tre informazioni da controllare separatamente.

                  LLaMAntino: adattare una base internazionale all’italiano

                  LLaMAntino-3-ANITA mostra un’altra strada. Il paper di Marco Polignano, Pierpaolo Basile e Giovanni Semeraro descrive l’adattamento di Meta Llama 3 nella versione da 8 miliardi di parametri, con addestramento su dati italiani e inglesi e successivo allineamento delle risposte.

                  È dunque un progetto di adattamento, non un modello preaddestrato da zero in Italia. Questa precisazione aiuta a capire da dove arrivano le capacità iniziali e quali dipendenze tecnologiche rimangono. Non sminuisce il lavoro: migliorare una base esistente può essere una scelta razionale.

                  Domyn: modelli per contesti aziendali regolamentati

                  Per Domyn conviene evitare elenchi fermi ai primi annunci. Il resoconto tecnico pubblicato il 15 aprile 2026 presenta Domyn-Large, da 263 miliardi di parametri, e richiama i precedenti Italia-10B e Colosseum-355B.

                  Il documento spiega che Domyn-Large parte da Colosseum-355B e impiega compressione, ulteriore preaddestramento e fine-tuning, nel quadro della collaborazione con NVIDIA. Il progetto punta a compiti come generare interrogazioni per database e lavorare con informazioni aziendali strutturate. Queste sono capacità e risultati descritti dagli sviluppatori: per un acquisto vanno verificati sul proprio caso d’uso. Colosseum-355B è un modello; il nome Colosseum viene usato anche per un’infrastruttura di calcolo. Meglio non confonderli.

                  EngGPT2: un altro esempio di sviluppo industriale

                  Un rapporto tecnico del maggio 2026 su EngGPT2MoE-16B-A3B documenta il modello di Engineering e lo confronta con diversi LLM italiani e internazionali. L’architettura è di tipo Mixture of Experts: 16 miliardi di parametri complessivi, con 3 miliardi attivi.

                  Il rapporto illustra risultati differenti secondo il benchmark, compreso quello italiano ITALIC. Essendo un preprint firmato da autori che includono gli sviluppatori, lo considero documentazione da esaminare, non una certificazione indipendente di superiorità. Ma è un ulteriore elemento concreto contro l’idea che in Italia non si sviluppino LLM.

                  Un video per capire il contesto europeo

                  Per approfondire il tema delle infrastrutture e dell’AI sovrana, propongo il keynote di Jensen Huang al GTC Paris 2025, richiamato anche nel resoconto tecnico di Domyn. È la prospettiva di NVIDIA, quindi va ascoltata tenendo presente il ruolo commerciale del relatore.

                  https://www.youtube.com/watch?v=X9cHONwKkn4

                  Esistere e guidare il mercato sono due cose diverse

                  Questi progetti bastano a smentire l’affermazione “non esistono LLM italiani”. Non bastano a dimostrare che l’Italia guidi il mercato mondiale o che uno di questi modelli sia migliore di qualsiasi alternativa internazionale.

                  Per sostenere un primato servono confronti aggiornati e riproducibili: stessi compiti, versioni dichiarate, impostazioni comparabili, costi e tempi di esecuzione misurati. Un numero di parametri più alto non è, da solo, una prova di maggiore utilità. E vincere un benchmark non equivale a rispondere correttamente alle domande dei dipendenti di un’azienda.

                  Nel mio lavoro di formazione, la domanda che proporrei a un’organizzazione è più concreta: quale sistema svolge bene il compito che vogliamo affidargli, con un costo sostenibile e condizioni di gestione adeguate? Un assistente per cercare informazioni nei manuali di un’azienda e un chatbot generalista hanno esigenze diverse. Cercare un unico campione nazionale per entrambi rischia di essere un esercizio di tifo.

                  L’Italia partecipa anche attraverso le infrastrutture

                  La partita comprende anche la capacità di mettere calcolo e competenze a disposizione di chi sviluppa applicazioni. La scheda ufficiale EuroHPC dell’AI Factory italiana IT4LIA descrive un’iniziativa coordinata da CINECA, con servizi per preparazione dei dati, addestramento ed esecuzione dei modelli.

                  Il comunicato EuroHPC del 22 aprile 2026 documenta la firma del contratto per potenziarne la capacità di calcolo. Lo stesso comunicato precisa che IT4LIA fornisce già risorse e servizi a PMI e startup dall’aprile 2025, sfruttando l’infrastruttura esistente, in particolare Leonardo. Il nuovo supercomputer è un potenziamento distinto: la firma del contratto non dimostra che sia già interamente operativo.

                  Ne ho discusso anche nell’articolo “L’America crea, la Cina copia, l’Europa regolamenta?”: le formule geografiche sono comode per raccontare una competizione, ma rischiano di nascondere le collaborazioni e le diverse parti della filiera.

                  Come valuterei un LLM italiano in azienda

                  Propongo un test semplice da organizzare, anche durante un workshop. Prepariamo un piccolo insieme di documenti non riservati e una ventina di domande realistiche. Alcune devono avere una risposta nei documenti; altre devono essere volutamente senza risposta, per verificare se il sistema ammette di non sapere.

                  Facciamo svolgere gli stessi compiti a più sistemi, distinguendo sempre il modello dall’applicazione che lo usa. Misuriamo correttezza, fedeltà ai documenti, rispetto delle istruzioni, qualità dell’italiano, tempi e costo. Registriamo anche quanto lavoro umano serve per correggere gli errori. È una proposta di valutazione pratica, non il resoconto di un test già svolto.

                  Prima dell’impiego reale, chiederei inoltre al fornitore la versione del modello, la licenza applicabile e come vengono gestiti documenti, conversazioni e accessi. La nazionalità del produttore non sostituisce queste risposte. Un tricolore sul sito non è una scheda tecnica.

                  La domanda utile: che cosa vogliamo costruire con l’AI?

                  La mia lettura è che l’Italia abbia progetti credibili da conoscere e mettere alla prova, senza bisogno di raccontarli come campioni imbattibili. Ricerca, sviluppo industriale, adattamento di modelli e infrastrutture sono contributi diversi; riconoscerli permette di discutere opportunità e dipendenze con maggiore precisione.

                  Per imprese e Pubblica Amministrazione, partirei dai processi da migliorare: documenti da trovare, informazioni da estrarre, richieste da gestire, attività da semplificare. Poi sceglierei il modello e il sistema più adatti, italiano o internazionale, sulla base delle prove.

                  Gli LLM italiani esistono. La partita da giocare è trasformarli, insieme alle altre tecnologie disponibili, in strumenti utili e verificabili. Il rischio che vedo è fermarsi alternativamente al disfattismo o all’orgoglio da comunicato stampa. In entrambi i casi, il lavoro vero resta da fare.

                  Se vi dicessi che per migliorare l’efficienza di un’azienda bisogna cominciare dal volante, probabilmente pensereste a una metafora da consulente. Nel caso di UPS, invece, il volante c’entra davvero.

                  La storia è famosa: i furgoni marroni evitano di svoltare a sinistra. Una scelta apparentemente bizzarra, che nasconde una domanda interessante: il percorso che sembra più diretto è anche quello più conveniente?

                  Prima, però, togliamo di mezzo un equivoco. “I furgoni UPS non girano a sinistra” funziona benissimo come titolo, ma è una semplificazione. UPS ha incorporato nella pianificazione dei percorsi criteri per ridurre le svolte a sinistra, soprattutto quando comportano rischi o inefficienze. Non si tratta di un divieto assoluto. Il resoconto del progetto pubblicato da INFORMS, l’associazione scientifica dedicata alla ricerca operativa e all’analisi dei dati, parla proprio di minimizzazione delle svolte, con una forte motivazione legata alla sicurezza.

                  Già questa precisazione contiene una lezione: una buona regola operativa deve saper gestire le eccezioni.

                  Perché UPS evita le svolte a sinistra

                  Pensiamo a un incrocio in un Paese dove si guida a destra. Per svoltare a sinistra può essere necessario attraversare il flusso dei veicoli provenienti dalla direzione opposta. Occorre aspettare, valutare le distanze e trovare il momento giusto.

                  Una strada può quindi apparire conveniente sulla mappa e diventare meno interessante quando consideriamo attese, manovre e condizioni reali.

                  Nel paper UPS Optimizes Delivery Routes, pubblicato nel 2017 sulla rivista scientifica Interfaces, gli autori spiegano come abbiano penalizzato nel modello le svolte a sinistra e gli attraversamenti a zigzag su strade trafficate, per scoraggiare comportamenti potenzialmente meno sicuri.

                  Attenzione: da questo non discende che fare tre svolte a destra sia sempre meglio che farne una a sinistra. Dipende dalla rete stradale, dal traffico, dai semafori e dalle consegne.

                  La domanda utile diventa: quanto costa davvero questa scelta, considerando l’intero giro?

                  ORION: dietro il volante c’è un problema matematico

                  Il sistema protagonista di questa storia si chiama ORION, acronimo di On-Road Integrated Optimization and Navigation.

                  Il suo compito è organizzare la sequenza delle consegne e dei ritiri tenendo conto dei vincoli operativi. Il paper del 2017 descrive un sistema di ottimizzazione basato su tecniche metaeuristiche: metodi che cercano soluzioni di buona qualità in problemi troppo complessi per essere affrontati enumerando ogni possibilità.

                  La complessità nasce anche dalla necessità di rispettare orari e mantenere una certa coerenza nei percorsi quotidiani. Il giro matematicamente interessante deve poi essere praticabile da una persona, con un furgone carico, in una città reale.

                  Un dettaglio raccontato da UPS rende bene l’idea. Nel comunicato del 2018 dedicato a UPSNav, l’azienda spiega che la navigazione deve arrivare anche alle baie di carico e agli accessi effettivi per le consegne, che possono trovarsi dalla parte opposta rispetto all’ingresso principale di un edificio.

                  Chiunque abbia cercato l’ingresso merci di un capannone può capire il problema. Essere arrivati all’indirizzo giusto e trovarsi nel posto giusto sono due risultati diversi.

                  Quanto ha risparmiato UPS? Evitiamo di mischiare i numeri

                  Nel comunicato del 29 gennaio 2020 sull’evoluzione di ORION, UPS dichiarava risparmi di circa 100 milioni di miglia percorse e 10 milioni di galloni di carburante all’anno dall’introduzione del sistema.

                  Sono dati aziendali, riferiti al periodo della comunicazione. E soprattutto riguardano l’intero sistema di ottimizzazione, non il solo fatto di evitare alcune svolte.

                  Attribuire tutto il risultato alle svolte a destra sarebbe una scorciatoia narrativa. E, parlando di percorsi, sarebbe anche piuttosto ironico.

                  Il valore nasce dalla combinazione di dati, pianificazione, sequenze di visita, navigazione e modalità operative. La svolta a sinistra è il dettaglio memorabile che permette di raccontare un lavoro molto più ampio.

                  È intelligenza artificiale? Sì, ma non immaginiamoci ChatGPT al volante

                  Qui conviene distinguere le tecnologie.

                  Il paper scientifico del 2017 descrive soprattutto ricerca operativa e ottimizzazione matematica. Nel comunicato del 2020, UPS presenta ORION come una tecnologia che utilizza algoritmi avanzati, intelligenza artificiale e machine learning, annunciando la possibilità di ricalcolare i percorsi durante la giornata.

                  Raccontare questo caso come se fosse nato da una domanda fatta a un chatbot sarebbe fuorviante.

                  Per me, però, il collegamento con l’AI generativa è interessante sul piano del metodo: prima di chiedere a uno strumento di migliorare un’attività, dobbiamo capire che cosa vogliamo migliorare e come misureremo il risultato.

                  “Fammi lavorare più velocemente” è una richiesta vaga. Ridurre i tempi di risposta mantenendo la qualità, evitare errori oppure diminuire i passaggi necessari sono obiettivi diversi. Possono richiedere interventi diversi.

                  Quali sono le svolte a sinistra della nostra azienda?

                  Propongo di usare questa storia come esercizio di osservazione.

                  Una “svolta a sinistra”, in questa metafora, è un passaggio che sembra naturale perché lo abbiamo sempre fatto, ma il cui costo complessivo merita di essere verificato.

                  Pensiamo a tre situazioni ipotetiche.

                  Un preventivo passa da quattro persone. Possiamo chiedere all’AI di velocizzarne la stesura. Prima, però, chiediamoci dove si accumula il ritardo: nella scrittura, nella ricerca delle informazioni o nelle approvazioni?

                  Una riunione produce un verbale che nessuno consulta. Trascriverla automaticamente può essere utile. Vale anche la pena verificare se il risultato necessario fosse un verbale completo oppure un elenco di decisioni, responsabili e scadenze.

                  Una presentazione commerciale contiene quaranta slide. Possiamo utilizzare gli strumenti che ho raccontato nell’articolo su come creare presentazioni con l’AI. Ma potremmo prima domandarci quali informazioni servono davvero al cliente per decidere.

                  Sono esempi da analizzare, non ricette universali. Un’approvazione può essere indispensabile; una riunione può prevenire un errore costoso. Per questo bisogna distinguere i vincoli reali dalle abitudini.

                  Un prompt per trovare i passaggi da ripensare

                  Ecco un esercizio che propongo a partire dal caso UPS. Scegliete un processo circoscritto e descrivetelo usando informazioni che siete autorizzati a condividere nello strumento scelto.

                  Agisci come analista di processi aziendali. Aiutami a esaminare questo processo: [descrizione].

                  L’obiettivo che voglio migliorare è: [obiettivo misurabile].

                  Questi sono i passaggi attuali, i ruoli coinvolti, i tempi disponibili e i vincoli: [informazioni].

                  Prima di proporre soluzioni, fammi cinque domande per individuare le informazioni mancanti.

                  Poi identifica attese, duplicazioni, rilavorazioni e passaggi di consegne. Distingui i vincoli documentati dalle abitudini che sarebbe utile verificare.

                  Proponi tre modifiche sperimentabili su piccola scala. Per ciascuna indica beneficio atteso, rischi, dati da raccogliere e condizioni che suggerirebbero di interrompere il test.

                  Valuta dove potrebbero essere utili semplificazione organizzativa, automazione tradizionale o AI generativa. Non inventare tempi, costi o percentuali di risparmio. Presenta le tue proposte come ipotesi da verificare.

                  Lo userei per preparare un confronto con le persone che svolgono quel lavoro. Le loro risposte potrebbero smentire la proposta apparentemente più brillante del chatbot. Sarebbe un risultato utile.

                  Il cambiamento deve funzionare anche fuori dal software

                  Un aspetto del caso UPS merita più attenzione del famoso incrocio.

                  Lo studio di BSR sull’adozione di ORION, realizzato anche attraverso interviste al personale UPS, descrive le difficoltà nel portare il sistema dal laboratorio all’uso quotidiano. Servivano prove sul campo, formazione, comunicazione e cambiamenti nel modo di misurare il successo. Anche la qualità delle mappe richiedeva verifiche e correzioni.

                  È una lezione che porterei in qualsiasi progetto aziendale sull’AI: nel piano di lavoro devono esserci anche il tempo per sperimentare, le persone coinvolte e i criteri con cui decidere se continuare.

                  Per approfondire il caso originale, si può guardare la presentazione video del progetto UPS per il premio Franz Edelman 2016, pubblicata da INFORMS.

                  https://www.youtube.com/watch?v=vyqIuXB_Qug

                  La domanda che mi porto via da questa storia è semplice: quali passaggi del nostro lavoro continuiamo a considerare convenienti senza averne mai misurato il costo?

                  Prima di accelerare con l’AI, dedicherei un po’ di tempo a rispondere. Potremmo scoprire che una parte del percorso non serve più.