Tag Archivio per: intelligenza artificiale

Customer experience e AI funzionano insieme quando l’intelligenza artificiale aiuta a capire i clienti, preparare decisioni e lavorare meglio sulle relazioni. Servono dati leggibili, un obiettivo preciso, contesto e persone capaci di valutare il risultato. È il filo conduttore del mio intervento al webinar Customer Experience e Business Development ai tempi dell’AI, che si è svolto il 21 settembre 2026.

L’incontro è stato organizzato da Surwiz, in collaborazione con Crono e con Merakyn come media partner. Ho partecipato alla tavola rotonda insieme ad Alessandro Di Maio, cofondatore di Surwiz, e Alex Roggero, cofondatore di Crono. A moderare il confronto c’era Lorenzo D’Amelio di Merakyn.

Il mio contributo era quello di un formatore che incontra ogni giorno aziende e professionisti alle prese con questi strumenti: portare esempi, mettere in discussione qualche abitudine e mostrare come passare dall’esperimento occasionale a un uso consapevole dell’AI.

La registrazione del webinar

Qui trovi la registrazione completa. Nell’articolo riprendo i miei interventi e aggiungo un esercizio applicativo per tradurli nel lavoro quotidiano.

Customer experience e AI: avere tanti dati non basta

Lorenzo mi ha chiesto perché continuiamo ad associare l’abbondanza di dati alla qualità delle decisioni. Ho risposto partendo da una situazione che incontro spesso nei corsi: qualcuno mi descrive un problema e mi chiede come risolverlo con l’intelligenza artificiale. Poi scopro che gli serve soprattutto mettere ordine in quattro file e costruire una dashboard.

In quel caso può bastare un buon lavoro di business intelligence. La scelta dello strumento deve seguire il problema. Prima occorre capire quali informazioni abbiamo, quanto sono aggiornate e quale decisione vogliamo prendere. Altrimenti aggiungiamo un’interfaccia brillante sopra dati disordinati.

Nel webinar ho raccontato anche la distanza tra le realtà strutturate e quelle più piccole che incontro nella formazione. Alcune lavorano con sistemi integrati; altre si reggono ancora su fogli Excel e informazioni sparse. Il punto di partenza cambia parecchio.

L’AI può aiutare a interpretare quei materiali e a individuare piste di lavoro, soprattutto se conosce il contesto dell’azienda. Ma collegare un archivio non significa averne automaticamente risolto incoerenze, duplicati e lacune. Una risposta plausibile va sempre confrontata con le fonti.

Il metodo Socrate: fai fare le domande all’AI

Uno dei suggerimenti più pratici che ho dato è molto semplice: fatti intervistare dall’intelligenza artificiale. Passiamo tanto tempo a cercare la domanda perfetta, mentre spesso non abbiamo ancora chiarito abbastanza il problema.

Io chiamo questo approccio “Socrate”, con un po’ di ironia. Dai all’assistente un obiettivo e chiedigli di raccogliere da te le informazioni mancanti. L’accorgimento decisivo è aggiungere: fammi una domanda alla volta e aspetta la mia risposta. Altrimenti arriva un questionario infinito, non un dialogo.

Ecco una traccia operativa, rielaborata per questo articolo a partire dall’esempio del webinar:

Voglio capire perché alcuni clienti non rinnovano il nostro servizio. Aiutami a definire un’analisi utile. Prima di proporre soluzioni, intervistami: fammi una domanda alla volta e aspetta la mia risposta. Chiarisci obiettivo, tipo di clienti, dati disponibili, periodo osservato e vincoli. Distingui ciò che sappiamo dalle ipotesi. Alla fine proponi un piccolo piano di verifica, indicando quali informazioni mancano.

È un esercizio utile anche senza caricare subito documenti. Posso spiegare il problema, farmi aiutare a delimitarlo e decidere solo dopo quali dati siano necessari e utilizzabili. Le domande dell’assistente possono già farmi vedere un limite della mia impostazione.

Dal prompt al contesto: costruire un secondo cervello

Durante il confronto è tornata più volte l’idea del second brain, il secondo cervello. Nel mio intervento l’ho collegata a un assistente configurato sul nostro lavoro: sa chi siamo, quali obiettivi abbiamo e quali materiali può consultare.

Una richiesta isolata costringe il modello a riempire molti vuoti. Un contesto pertinente gli permette di lavorare su informazioni più utili. Questo richiede selezione: documenti corretti, istruzioni chiare e accessi coerenti con il compito. Riempire la conversazione di materiale a caso non è una strategia.

La distinzione è approfondita anche da Anthropic nella guida al context engineering per gli agenti AI: oltre al testo del prompt, conta l’insieme delle informazioni disponibili al sistema, compresi strumenti, documenti e cronologia.

Ho raccontato anche alcune mie sperimentazioni, dalla creazione di un videogioco didattico sui prompt a un prototipo di CRM costruito con l’aiuto dell’AI. Il valore di questi esempi sta nella possibilità di esplorare un’idea e verificarne l’utilità. Un prototipo, prima di diventare un sistema aziendale, richiede controlli su dati, accessi, affidabilità e manutenzione.

L’AI rende impersonale il rapporto con i clienti?

La domanda di Lorenzo toccava un’obiezione frequente: se usiamo tutti gli stessi strumenti, finiremo per comunicare tutti allo stesso modo? Nel webinar sono stato piuttosto provocatorio su questo punto. Se produciamo email intercambiabili, dobbiamo interrogarci su come stiamo usando lo strumento.

Ho indicato due ingredienti che possono cambiare il risultato: il nostro stile di scrittura e la conoscenza della relazione con il cliente. Da una parte esempi selezionati di come comunichiamo; dall’altra lo storico pertinente, il problema aperto, le richieste già fatte e gli impegni presi.

La personalizzazione utile consiste, per esempio, nel ricordare che un cliente ha già segnalato un disservizio e sta aspettando una risposta concreta. Mettere il suo nome in apertura non basta. Né serve una mail elegante che ignori tutto quello che è successo prima.

Su un piano più generale, lo studio Generative AI at Work di Erik Brynjolfsson, Danielle Li e Lindsey Raymond, disponibile anche su Microsoft Research, ha osservato benefici dall’assistenza generativa nel customer support, con risultati diversi a seconda dell’esperienza degli operatori. È un caso di ricerca specifico, non una promessa di produttività valida per qualsiasi azienda.

Il mio criterio resta molto concreto: il cliente riceve una risposta corretta, pertinente e capace di aiutarlo? Se abbiamo risparmiato cinque minuti ma gli abbiamo fatto perdere mezz’ora, abbiamo ottimizzato la cosa sbagliata.

Persone e agenti AI: come dividersi il lavoro

Alex Roggero ha portato nel confronto il tema del lavoro commerciale e della collaborazione tra persone e agenti. Mi sono agganciato a questo ragionamento insistendo sulla configurazione degli strumenti e sulla qualità del contributo umano.

Per chiarire cosa intendo, ho raccontato un episodio familiare: mia moglie, insegnante, doveva preparare un progetto per un bando scolastico. Abbiamo impostato un assistente sui materiali del bando, ottenuto una proposta e poi rivisto il testo. Lei ha modificato anche un’attività che non la convinceva. Il progetto è stato finanziato e, quando sono arrivati i complimenti, si è sentita a disagio per l’aiuto ricevuto dall’AI.

Per me quell’episodio mostra bene il lavoro che rischiamo di rendere invisibile: riconoscere l’opportunità, scegliere lo strumento, fornirgli i materiali, dare istruzioni, valutare la proposta e correggerla. L’approvazione finale richiede competenza e responsabilità. Questo vale anche per una risposta a un cliente o una proposta commerciale.

La guida di Anthropic Building effective agents distingue i flussi predefiniti dai sistemi in cui il modello sceglie dinamicamente passaggi e strumenti. Raccomanda di partire da soluzioni semplici e aggiungere complessità quando serve. È un criterio utile anche in azienda: prima definiamo il compito e come valutarlo, poi decidiamo quanta autonomia concedere.

Dati aziendali e AI: regole chiare prima degli automatismi

Un altro mio intervento ha riguardato l’uso non governato dell’AI, spesso chiamato shadow AI: le persone adottano strumenti per lavorare, ma l’organizzazione non sa quali informazioni vi inseriscono e con quali garanzie.

Ho suggerito di partire da strumenti scelti consapevolmente, un vademecum operativo e formazione. Nel ragionamento ho distinto materiali già pubblici, come una brochure, da procedure interne, contratti, informazioni sui clienti e dati particolarmente delicati. Metterli tutti nello stesso contenitore è un errore.

Le indicazioni pratiche che ricavo da quel passaggio sono queste:

  1. Stabilire quali strumenti e account usare. Valutare condizioni del servizio, trattamento dei dati, accessi e configurazioni con chi ne ha la competenza in azienda. Un abbonamento a pagamento, da solo, non certifica la conformità di qualsiasi utilizzo.
  2. Caricare il minimo necessario. Se basta un campione depurato dei dati personali, partire da quello. Anche anonimizzazione e soluzioni locali richiedono verifiche: non sono scorciatoie che eliminano ogni rischio.
  3. Separare l’uso professionale da quello personale. Durante il webinar ho evocato la serie Severance proprio per rendere memorabile questa separazione. Materiali di lavoro e account personali non devono mescolarsi senza controllo.
  4. Formare le persone sui casi reali. Quali documenti posso usare? Quali output devo controllare? Quando devo chiedere aiuto? Un vademecum funziona se permette di rispondere a queste domande.

Per approfondire, le FAQ della Commissione europea sull’alfabetizzazione AI collegano le competenze al contesto d’uso e ai rischi. È un riferimento utile per impostare la formazione, da affiancare alla valutazione delle regole applicabili alla propria organizzazione.

Decidere più velocemente significa decidere meglio?

La domanda conclusiva di Lorenzo era volutamente scomoda: l’AI ci aiuta a capire meglio i clienti oppure accelera le decisioni sbagliate?

Ho risposto distinguendo velocità di esecuzione e qualità del lavoro. Un report pronto in mezz’ora invece che in dieci ore può essere un progresso enorme. Bisogna però verificare che mantenga profondità, accuratezza e comprensione del problema.

Nel caso dei clienti, l’AI può aiutare a sintetizzare recensioni, analizzare ticket, individuare ricorrenze e suggerire azioni. Se il campione è incompleto, vecchio o rappresenta soltanto una parte della clientela, rischiamo di accelerare un’analisi già distorta in partenza. A questo si aggiungono gli errori del modello e le informazioni inventate.

Il profilo sui rischi dell’AI generativa del National Institute of Standards and Technology (NIST) offre un quadro per affrontare, tra gli altri, i rischi legati a confabulazioni e privacy. Tradotto nel lavoro quotidiano: chiedere riscontri, verificare i risultati e definire responsabilità deve far parte del processo.

Ho chiuso con una battuta che sintetizza bene il mio intervento: prima dell’AI potevamo capire male il cliente lentamente; oggi possiamo capirlo male in tempo reale.

Un esercizio per portare questi spunti in azienda

Per applicare il rapporto tra customer experience e AI, propongo di iniziare da un problema circoscritto. Per esempio: capire perché un gruppo di clienti ha chiesto più volte assistenza sullo stesso passaggio. Questo esercizio è un’elaborazione pratica dei temi discussi, non un caso aziendale raccontato nel webinar.

  1. Definisci la decisione. Vuoi riscrivere una procedura, correggere una comunicazione o approfondire un problema del servizio?
  2. Seleziona i materiali utilizzabili. Scegli un periodo, chiarisci cosa manca e prepara i dati secondo le regole aziendali.
  3. Fatti intervistare. Usa il metodo Socrate per far emergere obiettivi, vincoli e ipotesi implicite.
  4. Chiedi un’analisi verificabile. Per ogni tema emerso, fatti indicare i riscontri nei materiali e le informazioni mancanti. Tieni separate evidenze e interpretazioni.
  5. Controlla e prova un’azione. Confronta l’analisi con chi gestisce quei clienti, scegli un intervento limitato e stabilisci come capire se ha funzionato.

È così che vedo il valore dell’intelligenza artificiale nella relazione con i clienti: un aiuto a fare domande più precise, comprendere meglio le informazioni e preparare azioni che qualcuno sappia valutare. Sono temi su cui lavoro anche nel mio corso ChatGPT per aziende e professionisti, adattando esempi ed esercizi ai processi reali dei partecipanti.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
Inviaci email

Il corso “Comunicare attraverso i social media” su Syllabus aiuta i dipendenti pubblici a usare i canali social in modo efficace, consapevole e coerente con la missione della Pubblica Amministrazione. Il percorso dura 3 ore e 15 minuti, è articolato in due livelli e affronta regole, strategia, scelta dei canali, crisi, promozione degli eventi e impiego responsabile dell’intelligenza artificiale.

Non è un corso per trasformare un Comune in un influencer. È un percorso per evitare che la comunicazione istituzionale sia un albo pretorio con i like.

Un corso sui social media nella PA consigliato da chi lo ha seguito

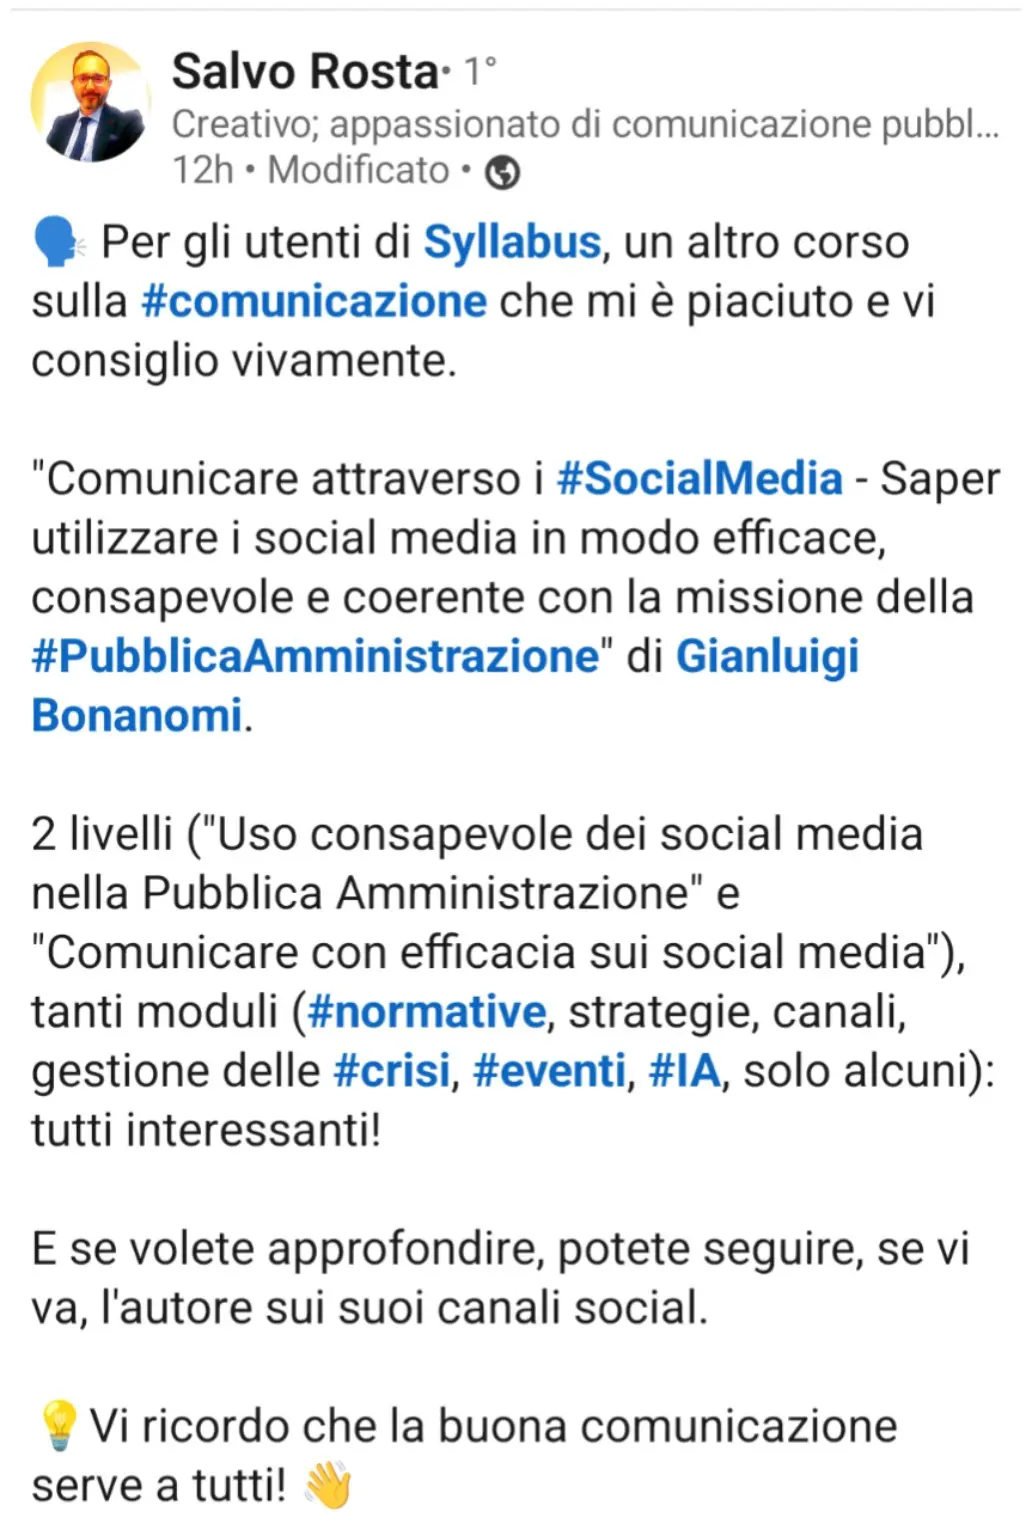
L’idea di questo articolo nasce da una recensione pubblicata su LinkedIn da Salvo Rosta. Il suo giudizio è netto: il corso gli è piaciuto e lo consiglia vivamente agli utenti di Syllabus. Nel post mette in evidenza la varietà dei moduli, dalle normative alla strategia, fino alla gestione delle crisi, agli eventi e all’intelligenza artificiale.

Recensione LinkedIn di Salvo Rosta sul corso social media per la Pubblica Amministrazione
Il post LinkedIn di Salvo Rosta dedicato al corso su Syllabus.

Una recensione di questo tipo vale più di uno slogan. Arriva da una persona che ha seguito il percorso e ne ha riconosciuto utilità e concretezza. Ringrazio Salvo per aver condiviso pubblicamente il suo riscontro.

Che cos’è “Comunicare attraverso i social media” su Syllabus

“Comunicare attraverso i social media” è un programma formativo disponibile sulla piattaforma Syllabus del Dipartimento della Funzione Pubblica. L’obiettivo dichiarato è sviluppare la capacità di utilizzare i social media in modo efficace, consapevole e coerente con la missione della Pubblica Amministrazione.

La durata complessiva indicata è di 3 ore e 15 minuti, oltre al tempo necessario per i test. Anche il Politecnico di Torino, nella propria pagina dedicata all’offerta Syllabus, conferma struttura, durata e finalità del programma.

I due livelli del corso

Livello Obiettivo operativo
Uso consapevole dei social media nella Pubblica Amministrazione Comprendere ruolo, responsabilità, vincoli e rischi dei canali social istituzionali.
Comunicare con efficacia sui social media Passare dalle regole alla pratica: strategia, contenuti, canali, eventi, crisi e nuovi strumenti.

I nuclei tematici messi in evidenza nella recensione comprendono:

  • normativa e responsabilità della comunicazione istituzionale;
  • strategia e coerenza con la missione dell’ente;
  • scelta dei canali e adattamento dei linguaggi;
  • gestione dei commenti, delle criticità e delle crisi;
  • promozione di iniziative, servizi ed eventi;
  • uso dell’intelligenza artificiale nella produzione e nell’organizzazione dei contenuti.

La sequenza è sensata: prima si capisce che cosa può e deve fare una Pubblica Amministrazione sui social, poi si lavora su come farlo bene.

Perché un corso social media per la Pubblica Amministrazione serve davvero

La Legge 7 giugno 2000, n. 150 inquadra le attività di informazione e comunicazione delle amministrazioni pubbliche. I social non sostituiscono siti istituzionali, URP e canali ufficiali. Aggiungono però un punto di contatto diretto, rapido e pubblico con cittadini e stakeholder.

Il problema nasce quando l’ente apre una pagina perché “ormai ce l’hanno tutti” e poi improvvisa. I sintomi sono familiari: comunicati stampa incollati su Facebook, locandine illeggibili sul telefono, risposte affidate all’umore del momento, foto pubblicate senza controlli, emergenze gestite con ritardo.

Le Linee guida AgID per la promozione dei servizi digitali ricordano che comunicazione, marketing e racconto devono favorire la conoscenza e l’utilizzo dei servizi pubblici da parte di cittadini e imprese. È esattamente qui che una formazione specifica fa la differenza: trasforma il social da vetrina autoreferenziale a strumento di servizio.

Che cosa dovrebbe saper fare un comunicatore pubblico sui social

Al termine di un buon percorso, il partecipante dovrebbe essere in grado di:

  1. definire obiettivi e pubblici prima di scegliere la piattaforma;
  2. distinguere informazione istituzionale, comunicazione politica e promozione dei servizi;
  3. costruire un piano editoriale sostenibile anche con risorse limitate;
  4. scrivere contenuti chiari, accessibili e utili;
  5. stabilire procedure di moderazione e risposta;
  6. gestire crisi, errori e ondate di commenti senza improvvisare;
  7. misurare risultati collegati a servizi e comportamenti, non soltanto like;
  8. usare l’AI come supporto, mantenendo controllo umano, riservatezza e verifica delle informazioni.

Una media policy istituzionale chiarisce finalità, contenuti e regole dei canali. La social media policy del Garante per la protezione dei dati personali offre un esempio concreto: stabilisce pertinenza, uso di fonti attendibili, rispetto della riservatezza e gestione dei contenuti non ammessi.

Per approfondire il tema ho pubblicato anche una guida su come scrivere una social media policy e una raccolta di esempi di LinkedIn nella Pubblica Amministrazione.

Il video: sette suggerimenti per usare LinkedIn nella PA

In questo intervento per PA Social mostro come LinkedIn possa diventare uno spazio di comunicazione istituzionale e professionale, non il deposito digitale dei comunicati stampa.

Intelligenza artificiale e comunicazione pubblica: utile, ma con metodo

Inserire l’intelligenza artificiale in un corso sui social media per la PA è ormai necessario. Può aiutare a generare varianti di un testo, semplificare un contenuto, proporre una scaletta, trasformare informazioni in FAQ o adattare un messaggio a canali diversi. Non può decidere da sola che cosa l’ente debba pubblicare.

Servono controlli sulle fonti, sui dati personali, sul tono istituzionale e sui possibili errori. Per questo, nei miei percorsi per gli enti, collego la comunicazione digitale alla formazione sull’uso responsabile dell’AI. Chi vuole approfondire può consultare il mio corso AI per Comuni e la pagina dedicata alla formazione AI per enti pubblici.

A chi è rivolto il corso

Il percorso è particolarmente utile per:

  • dipendenti e funzionari di Comuni, Province, Regioni e amministrazioni centrali;
  • addetti URP, uffici stampa e comunicazione istituzionale;
  • social media manager e digital manager della PA;
  • responsabili di servizi che devono comunicare scadenze, procedure e opportunità;
  • operatori di biblioteche, musei, aziende sanitarie, università ed enti culturali;
  • dirigenti chiamati a definire regole, responsabilità e flussi di approvazione.

Il Vademecum “Pubblica Amministrazione e social media” di Formez PA indica come destinatari proprio le persone che, con ruoli e responsabilità diversi, partecipano al processo di comunicazione degli enti pubblici.

Dal corso Syllabus a un laboratorio personalizzato per l’ente

Syllabus offre una base comune e facilmente accessibile agli utenti della piattaforma. Un Comune o un ente può poi trasformare quella base in un percorso applicato ai propri problemi reali.

Un laboratorio personalizzato può includere:

  • audit dei canali social già attivi;
  • definizione di obiettivi, pubblici e indicatori;
  • revisione o creazione della social media policy;
  • costruzione di un piano editoriale su servizi, scadenze ed eventi;
  • simulazione di una crisi social;
  • esercitazioni di scrittura per Facebook, Instagram, LinkedIn e YouTube;
  • uso guidato dell’AI per ideare, riscrivere e verificare contenuti;
  • procedure di approvazione e coordinamento tra uffici.

È il passaggio dalla conoscenza generale al lavoro quotidiano. Ed è lì che la formazione produce risultati visibili.

Domande frequenti sul corso social media per la PA

Dove si trova il corso?

Il percorso è disponibile sulla piattaforma Syllabus. Accesso e assegnazione dipendono dalle modalità previste dalla piattaforma e dall’amministrazione di appartenenza.

Quanto dura?

La durata indicata è di 3 ore e 15 minuti, oltre al tempo di esecuzione dei test.

Quanti livelli comprende?

Due: “Uso consapevole dei social media nella Pubblica Amministrazione” e “Comunicare con efficacia sui social media”.

È adatto soltanto agli addetti stampa?

No. È utile a chiunque contribuisca ai contenuti, alle risposte ai cittadini, alla promozione dei servizi o alla gestione delle emergenze comunicative.

È possibile organizzare un’edizione su misura?

Sì. Il percorso può essere adattato a dimensione dell’ente, canali utilizzati, competenze iniziali e casi reali, in presenza oppure online.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

No: l’intelligenza artificiale non condanna gli insegnanti alla disoccupazione e non trasforma automaticamente gli studenti in una generazione di incapaci. Ma può rendere inutile il docente che si limita a trasferire informazioni e può indebolire lo studente che delega alla macchina ogni fatica cognitiva. Il futuro della scuola dipenderà da come verrà progettato l’uso dell’AI, non dalla semplice presenza di ChatGPT in classe.

Questa è la risposta breve. Quella più scomoda richiede di smontare due profezie molto popolari: «gli insegnanti perderanno il lavoro» e «i ragazzi diventeranno tutti più stupidi».

La survey Spaggiari: l’AI è già nel lavoro degli insegnanti

Una recente indagine intitolata Docenti e intelligenza artificiale: tra opportunità, timori e bisogno di guida, promossa da Spaggiari, La Fabbrica Società Benefit e ANP – Associazione Nazionale Presidi, ha coinvolto 1.294 insegnanti di scuole di ogni ordine e grado.

I dati, presentati il 17 settembre 2026 al Senato e disponibili sia nella pagina ufficiale di Spaggiari sia nella registrazione integrale di Radio Radicale, raccontano una scuola molto meno immobile di quanto si pensi:

  • il 72% dei rispondenti usa l’AI almeno una volta alla settimana;
  • il 22% la usa ogni giorno;
  • il 67% ha imparato da autodidatta;
  • il 47% considera il risparmio di tempo il vantaggio principale;
  • il 34% non la usa ancora direttamente con gli studenti.

Gli impieghi sono molto concreti: ricerca di informazioni, progettazione di attività, preparazione di verifiche, scrittura di verbali, relazioni ed email.

Serve però una cautela metodologica. Il campione è autoselezionato: ha risposto chi ha scelto di partecipare. Non possiamo quindi concludere che il 72% di tutti gli insegnanti italiani usi l’AI ogni settimana. Possiamo dire che, tra quasi 1.300 docenti interessati al tema, l’adozione è già molto avanzata. La differenza non è un cavillo statistico.

L’AI farà perdere il lavoro agli insegnanti?

Se insegnare significasse leggere una dispensa, riassumere un capitolo e preparare dieci domande a risposta multipla, avremmo un problema. Un chatbot svolge già queste attività in pochi secondi, ventiquattr’ore su ventiquattro e senza riunioni di dipartimento.

Ma il lavoro reale di un insegnante comprende anche ciò che un modello linguistico non può assumersi: osservare una classe, riconoscere una difficoltà non dichiarata, costruire fiducia, gestire un conflitto, motivare chi ha smesso di provarci, scegliere quando intervenire e assumersi la responsabilità educativa e valutativa.

L’AI automatizza compiti, non inghiotte automaticamente un’intera professione. Il rischio più realistico è una redistribuzione del lavoro: meno tempo per produrre materiali standard, più tempo per progettare esperienze, dare feedback, verificare fonti e seguire le persone.

Anche l’OECD Digital Education Outlook 2026 parla di strumenti capaci di augmentare l’insegnamento preservando l’autonomia professionale del docente. L’Organizzazione per la cooperazione e lo sviluppo economico insiste sulla co-progettazione con insegnanti e studenti, perché una tecnologia educativa efficace non nasce sostituendo la pedagogia con un pulsante.

La mia provocazione è questa: non sarà l’AI a licenziare gli insegnanti. Potrebbe però mettere in crisi l’insegnante che compete con l’AI sul suo terreno peggiore, la produzione seriale di contenuti. Il docente più prezioso sarà quello che fa ciò che la macchina non sa fare da sola: creare contesto, porre domande migliori, valutare il processo e tenere viva la responsabilità dello studente.

L’AI renderà gli studenti più stupidi?

È possibile usarla esattamente in quel modo. Basta trasformarla in una macchinetta distributrice di compiti finiti: domanda, copia, incolla, consegna. Il risultato può sembrare corretto mentre l’apprendimento è quasi nullo.

Uno studio pubblicato nel 2025 sui Proceedings of the National Academy of Sciences ha sperimentato l’uso di GPT-4 con quasi mille studenti delle scuole superiori impegnati in esercizi di matematica. Durante la pratica, l’AI migliorava la prestazione. Quando però lo strumento veniva tolto, il gruppo che aveva usato il chatbot generalista mostrava un peggioramento rispetto a chi aveva lavorato senza AI. Una versione progettata come tutor, con vincoli e suggerimenti graduali invece delle soluzioni pronte, riduceva il danno.

Traduzione brutale: ottenere una risposta migliore non significa aver imparato di più. La prestazione appartiene al sistema formato da studente più AI; la competenza personale si vede quando lo studente sa ragionare anche senza stampella.

Esiste però anche l’evidenza opposta. Un esperimento controllato pubblicato su Scientific Reports ha confrontato un tutor AI costruito secondo principi pedagogici con una lezione universitaria di active learning in fisica. In quelle condizioni specifiche, gli studenti con il tutor hanno ottenuto maggiori guadagni di apprendimento in meno tempo e hanno dichiarato più coinvolgimento e motivazione.

I due studi non si contraddicono. Dicono la stessa cosa con risultati diversi: la progettazione didattica conta più del marchio del chatbot. Un’AI che regala la soluzione sostituisce lo sforzo. Un’AI che fa domande, offre indizi, adatta la difficoltà e obbliga a spiegare il ragionamento può sostenere lo sforzo.

Il vero pericolo: confondere il compito finito con l’apprendimento

La scuola ha spesso premiato il prodotto finale: il tema, la relazione, la soluzione, la presentazione. L’AI produce prodotti finali con una facilità imbarazzante. Continuare a valutare soltanto quelli significa invitare gli studenti a delegare proprio la parte che vorremmo osservare.

Serve spostare l’attenzione sul processo:

  • far mostrare fonti, passaggi e revisioni;
  • chiedere una difesa orale delle scelte;
  • confrontare una risposta umana e una generata dall’AI;
  • inserire errori plausibili da individuare e correggere;
  • alternare attività con AI, con tutor AI e senza AI;
  • valutare la qualità delle domande, non soltanto quella delle risposte.

L’UNESCO raccomanda un approccio centrato sulla persona, attento a privacy, età, sicurezza, equità e progettazione pedagogica. Le linee guida europee del 2026 affidano esplicitamente agli insegnanti un ruolo centrale nell’uso etico dell’AI, nella comprensione dei dati e nello sviluppo del pensiero critico contro disinformazione e manipolazione.

Altro che mestiere in estinzione. Più gli studenti avranno accesso a macchine capaci di produrre risposte credibili, più serviranno adulti competenti nel far distinguere una risposta elegante da una risposta vera.

Il dato più preoccupante della survey non è quello che sembra

Mi preoccupa meno il fatto che il 72% dei rispondenti usi l’AI e molto di più che il 67% abbia imparato da solo. L’autodidatta può essere brillante, ma non è una strategia di sistema.

Quando gli strumenti entrano nella scuola prima delle regole condivise, ogni docente diventa contemporaneamente sperimentatore, responsabile privacy, verificatore delle fonti, progettista didattico e tecnico informatico. Troppo, anche per il professore più volenteroso.

La formazione utile non può limitarsi a «ecco dieci prompt». Deve insegnare almeno quattro competenze:

  1. progettazione pedagogica: decidere quando l’AI aiuta e quando sottrae apprendimento;
  2. verifica: controllare fonti, errori, omissioni e bias;
  3. protezione dei dati: sapere che cosa non inserire nei chatbot e quali strumenti sono autorizzati;
  4. valutazione autentica: osservare comprensione, processo e capacità di trasferire ciò che si è imparato.

È il taglio che propongo anche nel mio corso sull’intelligenza artificiale per insegnanti: strumenti concreti, certo, ma dentro un metodo che mantenga umano il giudizio e attivo il cervello dello studente.

Una regola semplice per la classe: prima il cervello, poi l’AI, poi di nuovo il cervello

Propongo una sequenza elementare:

  1. Prima: lo studente formula un’ipotesi, prova una soluzione o dichiara ciò che sa.
  2. Durante: usa l’AI per ricevere domande, controesempi, spiegazioni alternative o feedback.
  3. Dopo: ricostruisce il ragionamento senza copiare l’output e spiega che cosa ha cambiato.

Se eliminiamo il primo passaggio, l’AI pensa al posto dello studente. Se eliminiamo il terzo, non sappiamo chi abbia imparato: il ragazzo o il chatbot.

Quindi: insegnanti disoccupati e studenti più stupidi?

No, non è un destino tecnologico. È una possibilità organizzativa.

Avremo studenti cognitivamente più fragili se premieremo la risposta pronta, tollereremo la delega totale e chiameremo «competenza» la capacità di incollare un testo ben scritto. Avremo studenti più forti se useremo l’AI come sparring partner, tutor socratico, simulatore di obiezioni e generatore di feedback.

Avremo insegnanti marginalizzati se li ridurremo a correttori di elaborati prodotti dalle macchine. Avremo insegnanti ancora più importanti se daremo loro formazione, strumenti affidabili, tempo e autonomia per progettare l’apprendimento.

La tecnologia non ha ancora emesso la sentenza. La scuola sta scrivendo il verdetto, una lezione alla volta.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Claude ha certamente un posizionamento da intelligenza artificiale colta, professionale e moralmente consapevole. Ma definirla semplicemente snob sarebbe ingiusto: dietro la comunicazione sofisticata di Anthropic ci sono scelte tecniche, commerciali ed etiche reali, insieme a contraddizioni altrettanto reali.

Claude non ti risponde. Ti accoglie.

Non sembra un chatbot incontrato in metropolitana alle sette del mattino. Ha più l’aria di qualcuno che ha letto Hannah Arendt, beve caffè monorigine e, prima di darti un consiglio, vuole assicurarsi che siano state considerate tutte le implicazioni etiche.

Da qui la domanda, volutamente provocatoria: Claude di Anthropic è un’intelligenza artificiale fighetta?

Con “fighetta” non intendo dire inutile, debole o incompetente. Al contrario. Intendo un prodotto che comunica una certa superiorità culturale: più riflessivo, più rispettoso, più elegante, più attento alla privacy e meno disposto a sporcarsi le mani rispetto ai concorrenti.

Perché Claude viene percepita come l’AI elegante

ChatGPT è diventato un prodotto popolare. Lo usa lo studente, il pensionato, il manager, il candidato che deve sistemare il curriculum e quello che gli chiede i numeri del Superenalotto.

Claude, invece, ha conquistato inizialmente soprattutto sviluppatori, professionisti, ricercatori e utenti che lavorano con documenti complessi. Non è una semplice impressione. Secondo il rapporto 2025 State of Generative AI in the Enterprise di Menlo Ventures, Anthropic avrebbe raggiunto una posizione di leadership nella spesa aziendale per modelli linguistici nel campione analizzato. È un dato prodotto da una società di venture capital, quindi non va trattato come un censimento universale, ma indica un posizionamento enterprise molto forte. Anche la Developer Survey 2025 di Stack Overflow segnalava una diffusione rilevante dei modelli Claude Sonnet fra gli sviluppatori.

Il pubblico di riferimento influenza inevitabilmente il carattere percepito del prodotto.

Claude non è stato presentato come l’amico che sa fare tutto. Anthropic lo ha definito fin dall’inizio un assistente “helpful, honest and harmless”, cioè utile, onesto e non dannoso. Una formula che sembra più il programma elettorale di un filosofo morale che lo slogan di un software. La presentazione ufficiale di Claude insisteva proprio su affidabilità, prevedibilità e possibilità di controllarne tono e comportamento.

Anche il nome contribuisce. ChatGPT sembra il codice di un elettrodomestico. Gemini richiama costellazioni e missioni spaziali. Claude porta il nome di una persona, presumibilmente con un riferimento a Claude Shannon, padre della teoria dell’informazione. Già questo ti fa sentire in difetto se lo usi soltanto per riscrivere una mail.

Anthropic vende un prodotto o una visione morale?

Anthropic si presenta come una società di ricerca e sicurezza dell’intelligenza artificiale. Il suo elemento più riconoscibile è la Constitutional AI, un metodo con cui il modello viene addestrato a valutare e correggere le proprie risposte sulla base di un insieme esplicito di principi.

Nel paper originale sulla Constitutional AI, i ricercatori di Anthropic descrivono un processo nel quale il modello genera risposte, le critica alla luce di una “costituzione”, le riscrive e successivamente impara dalle preferenze prodotte da un altro sistema di AI.

È un approccio interessante perché rende almeno parzialmente visibili i criteri normativi usati per orientare il chatbot. Ma attenzione: Claude non possiede una coscienza morale e non “crede” nei diritti umani. Risponde secondo schemi appresi e criteri stabiliti durante l’addestramento.

La Costituzione di Claude resta inoltre il risultato di scelte umane. La stessa Anthropic riconosce che decidere quali principi inserire attribuisce agli sviluppatori un potere enorme. Nel 2023 l’azienda ha coinvolto circa mille cittadini statunitensi in un esperimento di Collective Constitutional AI. Il progetto ha evidenziato differenze tra i valori scelti internamente e quelli indicati dal campione pubblico, soprattutto su imparzialità, accessibilità e formulazione positiva delle regole.

È un segnale di apertura, ma mille americani non rappresentano l’umanità.

Un altro studio sulle opinioni globali rappresentate nei modelli linguistici, pubblicato da ricercatori di Anthropic, ha rilevato che le risposte tendevano ad avvicinarsi maggiormente alle opinioni diffuse negli Stati Uniti e in alcune popolazioni europee e sudamericane. Persino un’AI costituzionale, quindi, può incorporare una geografia culturale dei valori.

La costituzione non elimina il problema. Lo rende più visibile. Ed è già qualcosa.

Una comunicazione che profuma di biblioteca

Nel febbraio 2026 Anthropic ha pubblicato un manifesto intitolato Claude is a space to think. La promessa è che le conversazioni con Claude resteranno prive di pubblicità e di inserimenti commerciali non richiesti.

La motivazione è interessante: quando parliamo con un assistente AI condividiamo problemi lavorativi, dubbi personali, documenti e informazioni che difficilmente inseriremmo in un motore di ricerca. Secondo Anthropic, introdurre annunci in questo spazio potrebbe creare un conflitto tra l’interesse dell’utente e quello dell’inserzionista.

Fin qui, applausi.

Poi arriva la frase che definisce perfettamente il posizionamento: Claude deve essere uno spazio pulito nel quale pensare e lavorare. Non una piazza, non un supermercato, non un social network. Piuttosto un taccuino ben rilegato, possibilmente appoggiato su una scrivania di legno chiaro.

Questa è comunicazione. Ed è comunicazione molto ben costruita.

Anthropic vuole che Claude venga associato a concentrazione, profondità, lavoro intellettuale e assenza di distrazioni. È il contrario del modello basato su engagement, pubblicità e permanenza sulla piattaforma.

Il rischio è che questo linguaggio produca un effetto collaterale: far sembrare Claude l’AI di chi si considera più consapevole degli altri.

Quello che usa ChatGPT chiede una ricetta. Quello che usa Claude “esplora le implicazioni sistemiche dell’alimentazione contemporanea”. Sto scherzando, ma non troppo.

Claude rispetta davvero di più la privacy?

Qui occorre separare la percezione dai contratti.

Per le offerte aziendali Anthropic dichiara che prompt, documenti e risultati non vengono utilizzati per addestrare i modelli per impostazione predefinita. È un elemento importante per imprese, professionisti e organizzazioni che trattano informazioni riservate.

Per gli account personali la situazione è diversa. La Privacy Policy di Anthropic prevede che input e output possano essere utilizzati per migliorare i modelli, salvo disattivazione nelle impostazioni. Esistono inoltre eccezioni per conversazioni segnalate dai sistemi di sicurezza o inviate esplicitamente come feedback.

Il Privacy Center di Claude spiega che, quando un utente autorizza l’uso delle conversazioni, queste vengono scollegate dall’identificativo dell’account e sottoposte a processi destinati a filtrare o oscurare i dati sensibili.

Privacy di Claude: affermazioni e realtà

Affermazione Valutazione
Claude non usa mai le conversazioni per l’addestramento Falso per gli account consumer
Gli utenti personali possono opporsi Sì, attraverso le impostazioni
I dati aziendali vengono usati per addestrare Claude Non per impostazione predefinita
Anthropic non raccoglie dati tecnici e di utilizzo Falso
Claude garantisce privacy assoluta No, nessun servizio cloud può prometterla

Bisogna inoltre evitare di confondere due questioni differenti: la protezione delle conversazioni inserite dall’utente e la presenza di dati personali nel materiale originariamente usato per addestrare i modelli.

La ricerca ha dimostrato che i modelli linguistici possono, in determinate condizioni, memorizzare e restituire sequenze presenti nei dati di addestramento. Nel paper peer-reviewed Extracting Training Data from Large Language Models, presentato a USENIX Security 2021, i ricercatori riuscirono a estrarre da GPT-2 frammenti testuali contenenti anche nomi, email e numeri di telefono. Lo studio non riguardava Claude, ma dimostra perché la privacy nei modelli linguistici non possa essere ridotta a uno slogan aziendale.

Anthropic appare più esplicita di altri concorrenti su principi e controlli. Questo non trasforma Claude in una cassaforte. Se un documento non dovrebbe uscire dall’azienda, non basta scegliere il chatbot con l’aria più educata.

Anthropic ha davvero rotto con il Pentagono per motivi etici?

Questa vicenda è il principale argomento di chi considera Anthropic la società moralmente più coerente del settore. Ma va raccontata con precisione.

Anthropic non è un’azienda pacifista. Claude era già utilizzato negli apparati statunitensi per intelligence, pianificazione operativa, simulazioni e operazioni informatiche. La società aveva inoltre ottenuto un accordo con un valore massimo di 200 milioni di dollari.

Lo scontro nacque quando il Pentagono chiese di poter usare il modello per tutti gli impieghi consentiti dalla legge. Anthropic rifiutò di eliminare due limiti:

  • impiego per la sorveglianza interna di massa;
  • impiego in armi completamente autonome capaci di selezionare e colpire bersagli senza controllo umano.

Nella dichiarazione del 26 febbraio 2026, Dario Amodei sostenne che gli attuali modelli non fossero abbastanza affidabili per decisioni autonome di vita o di morte e che l’AI potesse trasformare dati legalmente acquistabili in sistemi di sorveglianza incompatibili con i valori democratici.

Il Pentagono replicò di non voler realizzare nessuno dei due scenari, ma pretese la possibilità di utilizzare Claude per qualsiasi finalità legale. Secondo Reuters, il rifiuto mise a rischio il contratto e portò alla minaccia di classificare Anthropic come rischio per la catena di approvvigionamento.

La designazione arrivò nel marzo 2026. Anthropic la contestò in tribunale, sostenendo che fosse una ritorsione. Un’ordinanza della Corte distrettuale della California ritenne plausibile che alcuni provvedimenti governativi eccedessero quanto necessario per proteggere la sicurezza nazionale e fossero motivati anche dalle critiche pubbliche dell’azienda. La controversia proseguì su più fronti giudiziari. Il quadro legale, quindi, era ben più complesso del titolo “Anthropic rompe con il Pentagono”. La dichiarazione successiva di Amodei ribadiva infatti la volontà di continuare a collaborare con le forze armate, mantenendo soltanto quelle due eccezioni.

La lettura equilibrata è questa: Anthropic non rifiutò il settore militare. Accettò però un costo economico e politico pur di non rinunciare a due limiti dichiarati pubblicamente.

È una scelta etica? Sì, almeno in parte.

È anche una scelta strategica di posizionamento? Quasi certamente.

Le due cose possono convivere. Un’azienda può difendere sinceramente un principio e contemporaneamente trasformarlo in reputazione, differenziazione e valore commerciale.

Etica autentica o sofisticato marketing?

La tentazione è dividere il mondo in santi e ipocriti.

Da una parte Anthropic, che parla di sicurezza, diritti e controllo. Dall’altra le aziende che inseguono crescita, pubblicità e diffusione di massa.

La realtà è meno cinematografica.

Anthropic è una società sostenuta da colossi come Amazon e Google. Vende abbonamenti, API e contratti enterprise. Compete per fatturato, talenti, potenza di calcolo e quote di mercato. Non è un’organizzazione umanitaria.

Anche l’etica può diventare un vantaggio competitivo.

La Constitutional AI differenzia tecnicamente il prodotto. La promessa di assenza di pubblicità lo differenzia economicamente. Lo scontro con il Pentagono lo differenzia politicamente. La comunicazione sobria lo differenzia culturalmente.

Questo non rende false le sue scelte. Impone però di valutarle attraverso comportamenti verificabili, non soltanto attraverso manifesti ben scritti.

Un buon criterio potrebbe essere questo:

  1. L’azienda pubblica principi verificabili?
  2. Accetta conseguenze economiche per difenderli?
  3. Applica gli stessi principi quando diventano scomodi?
  4. Offre agli utenti controlli comprensibili?
  5. Consente verifiche indipendenti sui propri modelli?
  6. Ammette limiti, errori e conflitti di interesse?

Anthropic ottiene risultati interessanti sui primi punti. Sugli ultimi, come tutto il settore, ha ancora parecchia strada da percorrere.

Anche il tono di Claude influenza la nostra fiducia

Quando giudichiamo un chatbot non valutiamo soltanto l’accuratezza. Ne interpretiamo tono, prudenza, empatia e sicurezza.

Un preprint del 2026 su antropomorfismo e fiducia, basato su oltre duemila interazioni uomo-LLM, ha rilevato che calore comunicativo, competenza percepita ed empatia cognitiva influenzano fiducia, utilità percepita e vicinanza relazionale. Il lavoro non riguarda specificamente Claude e, trattandosi di un preprint, i risultati vanno considerati provvisori. Offre però una chiave di lettura utile.

Claude tende a esprimersi in modo composto, collaborativo e prudente. Questa personalità può comunicare maggiore affidabilità. Può anche sembrare paternalistica, evasiva o eccessivamente diplomatica.

  • Per un utente è cautela.
  • Per un altro è censura.
  • Per qualcuno è eleganza.
  • Per qualcun altro è puzza sotto il naso.

Non esiste, al momento, una solida ricerca scientifica che dimostri che Claude sia percepito dal pubblico come “snob”. Questa è un’interpretazione culturale del marchio, non un dato sperimentale.

Quindi Claude è davvero un’intelligenza artificiale fighetta?

Un po’ sì.

Lo è nella comunicazione, nel lessico e nell’immaginario costruito attorno al prodotto. Claude si presenta come l’assistente che non vuole venderti nulla, non vuole farti perdere tempo, legge documenti lunghi, riflette prima di rispondere e possiede perfino una Costituzione.

È l’AI che non ti invita a “scatenare la creatività”. Preferisce aiutarti a “pensare con maggiore chiarezza”.

Ma ridurla a un vezzo per intellettuali sarebbe un errore. Claude è diventato uno strumento importante per programmatori e imprese, e Anthropic ha trasformato alcuni principi in limiti tecnici, contrattuali e commerciali. Nel confronto con il Pentagono ha accettato conseguenze concrete, pur senza rinnegare la collaborazione militare.

Sulla privacy, invece, il quadro è meno eccezionale di quanto suggerisca la reputazione. Le differenze tra account consumer ed enterprise sono decisive, le conversazioni personali possono essere utilizzate per l’addestramento se non si interviene sulle impostazioni e nessun modello cloud è immune dai problemi generali legati ai dati.

La mia conclusione?

Claude è un’intelligenza artificiale fighetta, ma non nel senso di un prodotto tutto posa e niente sostanza. È una fighetta con il badge enterprise, una Costituzione nello zaino e le scarpe antinfortunistiche.

A volte il suo tono può infastidire. A volte la comunicazione di Anthropic sembra suggerire: “Noi non siamo come gli altri”.

Però, in un mercato nel quale molte aziende parlano di principi finché non compare un contratto importante, averne almeno due che resistono davanti a 200 milioni di dollari non è proprio irrilevante.

Resta una domanda da fare a tutte le aziende dell’AI, Anthropic compresa: quanto valgono i vostri principi quando smettono di essere una campagna di comunicazione e iniziano a costare davvero?

Per sperimentare Claude e gli altri assistenti in modo più consapevole, puoi partire anche dalla mia raccolta di prompt per l’intelligenza artificiale generativa, ricordando che nessun prompt sostituisce la verifica delle fonti e la responsabilità umana.

FAQ su Claude, Anthropic, privacy ed etica

Claude e Anthropic sono la stessa cosa?

No. Anthropic è la società che sviluppa Claude. Claude è il nome della famiglia di modelli e dell’assistente di intelligenza artificiale.

Claude è più sicuro di ChatGPT?

Non è possibile dare una risposta assoluta. Anthropic utilizza tecniche specifiche come la Constitutional AI e pubblica numerosi documenti sulla sicurezza. La sicurezza effettiva dipende però dal modello, dal tipo di utilizzo, dalle configurazioni e dai criteri adottati per misurarla.

Claude usa le conversazioni per addestrare i modelli?

Per gli account consumer Anthropic può utilizzare input e output, salvo disattivazione nelle impostazioni. Per i servizi commerciali e aziendali i dati non vengono usati per l’addestramento per impostazione predefinita.

Anthropic ha interrotto il contratto con il Pentagono?

La vicenda è più complessa. Anthropic ha rifiutato di eliminare due limitazioni relative a sorveglianza interna di massa e armi completamente autonome. Il governo statunitense ha quindi adottato provvedimenti contro l’azienda, successivamente contestati in tribunale.

Claude è l’intelligenza artificiale degli snob?

È una definizione ironica, non una categoria scientifica. La comunicazione di Anthropic punta su riflessione, sicurezza, lavoro professionale e assenza di pubblicità. Questo posizionamento può far percepire Claude come un prodotto più colto, elitario o sofisticato rispetto ad altri chatbot.

La Constitutional AI rende Claude moralmente neutrale?

No. La Constitutional AI rende più espliciti alcuni principi usati nell’addestramento, ma quei principi sono comunque selezionati, interpretati e applicati da persone e organizzazioni inserite in uno specifico contesto culturale.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Risposta breve: no, entro il 2036 non avremo tutti un robot domestico umanoide in casa. È invece molto realistico aspettarsi abitazioni con più robot specializzati, capaci di pulire, sorvegliare, trasportare piccoli oggetti e assistere anziani o persone con disabilità. Una minoranza potrà acquistare o noleggiare un robot mobile con braccia. Il maggiordomo generalista che cucina, riordina, piega il bucato e gestisce ogni imprevisto resterà probabilmente un prodotto costoso e imperfetto.

La distinzione conta. Un robot aspirapolvere è già un robot domestico. Un umanoide che capisce la casa, manipola oggetti diversi e lavora senza supervisione è un problema enormemente più difficile. Nei video sembrano separati da pochi aggiornamenti software. Nella realtà, in mezzo ci sono scale, bambini, animali, calzini, bicchieri fragili, privacy e responsabilità.

Che cosa intendiamo per robot domestico?

Con “robot domestico” si possono indicare almeno tre categorie molto diverse:

  • robot specializzati, come aspirapolvere, tagliaerba, lavavetri e sistemi per la sorveglianza;
  • robot mobili con braccia, progettati per pochi compiti concreti, per esempio raccogliere vestiti o riordinare una stanza;
  • robot umanoidi generalisti, capaci in teoria di muoversi negli spazi pensati per le persone e usare gli stessi oggetti che usiamo noi.

Dire “avremo tutti un robot” senza specificare quale equivale a chiedere se tutti avranno un computer mettendo nella stessa categoria una calcolatrice e un data center.

Dove siamo nel 2026: molti video, pochi umanoidi al lavoro

I numeri ridimensionano l’entusiasmo. Secondo i dati dell’International Federation of Robotics anticipati da Reuters il 21 settembre 2026, nel 2025 sono stati venduti nel mondo circa 7.000 robot umanoidi per usi industriali e professionali. Molti sono finiti in centri di ricerca o aziende che li usano per raccogliere dati e addestrare modelli, non per svolgere lavoro produttivo. Nel 2024 erano stati venduti circa 199.000 robot di servizio professionali, soprattutto per trasporto, ospitalità e pulizia.

Settemila unità sono un segnale di mercato, non un’invasione. Anche le fabbriche automobilistiche, che hanno ambienti più controllati di un appartamento, stanno sperimentando spesso con pochi robot per impianto.

Questo è un buon antidoto alla AI FOMO: una dimostrazione spettacolare non equivale a un prodotto affidabile, economico e pronto a lavorare otto ore al giorno.

Che cosa dice la ricerca scientifica sui robot in casa

Una casa è un ambiente ostile per un robot

Per noi una cucina è familiare. Per una macchina è un ambiente non strutturato che cambia continuamente. Una tazza può essere nel lavello, sul tavolo o dietro una confezione. Una maglietta è deformabile. Una porta può essere socchiusa. Il pavimento può essere bagnato. Ogni oggetto richiede percezione, pianificazione, presa, controllo della forza e capacità di recuperare dagli errori.

Una rassegna del 2025 pubblicata su IEEE/CAA Journal of Automatica Sinica identifica quattro problemi centrali per i robot di servizio: localizzazione, navigazione, manipolazione e autonomia di lungo periodo. Gli autori sottolineano che l’ambiente domestico aperto, dinamico e non strutturato limita ancora l’impiego su larga scala.

Il benchmark Stanford elenca mille lavori domestici

Il progetto BEHAVIOR-1K della Stanford University raccoglie 1.000 attività domestiche realistiche, costruite a partire da sondaggi su ciò che le persone vorrebbero delegare. Le attività sono simulate in 50 ambienti interattivi con oltre 10.000 oggetti. Il dato interessante non è soltanto il numero: dimostra quanto sia lunga la coda dei casi possibili. Pulire una macchia e piegare un asciugamano richiedono competenze fisiche diverse.

I modelli visione-linguaggio-azione stanno accelerando

Nel 2025 Google DeepMind ha presentato Gemini Robotics, un modello capace di collegare immagini, istruzioni linguistiche e azioni. Nelle prove mostrate riconosce oggetti, reagisce ai cambiamenti e svolge compiti delicati, come piegare origami o inserire uno snack in un sacchetto. DeepMind dichiara per Gemini Robotics-ER un tasso di successo da due a tre volte superiore a Gemini 2.0 in alcune valutazioni end-to-end.

È un progresso importante, ma il confronto è relativo a un modello precedente, non al tasso di affidabilità richiesto in una casa. Se un robot riesce nove volte su dieci, il video può essere ottimo. Se la decima volta lascia cadere una pentola accanto a un bambino, il prodotto non è ancora pronto.

Ogni casa richiede apprendimento continuo

Un lavoro accettato alla conferenza IEEE ICRA 2024 ha testato per due mesi un’architettura di apprendimento continuo su un robot mobile incaricato di recuperare oggetti. La ricerca di Ayub, Nehaniv e Dautenhahn mostra che il robot può adattarsi ai cambiamenti usando pochi esempi forniti dalle persone. Mostra anche il limite: il risultato riguarda un compito circoscritto in laboratorio, non un assistente universale.

Tre esempi concreti di robot domestici

1X NEO: il maggiordomo umanoide da 20.000 dollari

1X ha annunciato NEO come robot umanoide per la casa. Il prezzo Early Access è di 20.000 dollari, con un futuro abbonamento da 499 dollari al mese. L’azienda promette consegne iniziali negli Stati Uniti nel 2026 ed espansione in altri mercati dal 2027. NEO dovrebbe piegare il bucato, sistemare scaffali, recuperare oggetti e gestire semplici attività. Quando non conosce un compito, il proprietario può prenotare l’intervento remoto di un esperto 1X che lo guida.

Quest’ultimo dettaglio è decisivo: il robot può apparire autonomo, ma parte dell’intelligenza può ancora essere umana e remota. Funziona, ma apre domande evidenti su costo, latenza e presenza di telecamere dentro casa.

Isaac 1: ruote, due braccia e compiti più circoscritti

Weave Robotics propone Isaac 1, un robot mobile su ruote pensato per raccogliere vestiti, gestire ceste, piegare il bucato, rifare il letto e riordinare oggetti. Costa 7.999 dollari oppure 449 dollari al mese. Le prime consegne sono indicate per l’autunno 2026 in California. Il funzionamento è autonomo per i flussi dichiarati, con assistenza in teleoperazione quando necessaria.

La scelta delle ruote non è un ripiego. Riduce costi, consumo energetico e rischio di caduta. Per molte case, il robot utile potrebbe assomigliare più a un mobile semovente con due braccia che a C-3PO.

Il test indipendente del Wall Street Journal

Le dimostrazioni ufficiali mostrano il meglio. Un test del Wall Street Journal su NEO è utile perché evidenzia anche lentezza, limiti operativi e ruolo dell’assistenza remota. È il confronto corretto tra promessa e uso quotidiano.

Quanto potrebbe costare un robot domestico entro il 2036?

Le stime finanziarie vanno trattate come scenari, non come orari ferroviari. Morgan Stanley Research prevede un’adozione relativamente lenta fino alla metà degli anni Trenta e un’accelerazione successiva. La stessa analisi stima per il 2050 circa 80 milioni di umanoidi nelle case, contro una quota molto maggiore destinata a usi industriali e commerciali. Negli Stati Uniti ipotizza un umanoide soltanto nel 10% delle abitazioni nel 2050.

Questa è la mia stima ragionata per il 2036, costruita sui prezzi già annunciati e sul probabile calo dei componenti. Non è una previsione scientifica:

Tipo di robot nel 2036 Possibile costo Diffusione plausibile
Robot specializzato evoluto 500-3.000 euro Comune nelle case con reddito medio e alto
Robot mobile con braccia e compiti limitati 5.000-15.000 euro oppure 200-500 euro al mese Minoranza di famiglie e servizi assistenziali
Umanoide generalista realmente affidabile 20.000-60.000 euro, manutenzione esclusa Prodotto premium, non di massa

Il prezzo di acquisto non sarà l’unico costo. Serviranno assistenza, ricambi, batterie, assicurazione, connessione, aggiornamenti software e forse un abbonamento per l’elaborazione in cloud o la teleoperazione. Il modello economico potrebbe assomigliare più a un’automobile con servizi digitali che a un elettrodomestico.

I cinque ostacoli che i video promozionali mostrano poco

  1. Affidabilità. Una casa non tollera facilmente errori fisici, soprattutto vicino a persone fragili.
  2. Velocità. Un compito riuscito in dieci minuti può essere tecnicamente notevole e praticamente inutile se una persona lo svolge in trenta secondi.
  3. Autonomia energetica. Motori, sensori e calcolo consumano energia. Ricaricare spesso riduce il valore del servizio.
  4. Privacy e sicurezza informatica. Un robot vede stanze, oggetti, abitudini e persone. La ricerca sulla fiducia nei robot domestici studia interfacce che rendano visibili raccolta dati e possibilità di intervento. Non basta una pagina di condizioni lunga trenta schermate.
  5. Responsabilità. Chi risponde se il robot rompe un oggetto, ferisce qualcuno o viene usato da remoto in modo improprio? In Europa entrano in gioco sicurezza del prodotto, protezione dei dati e, a seconda delle funzioni, il Regolamento europeo sull’intelligenza artificiale.

Per questo il controllo umano resterà centrale. Ho spiegato la differenza tra human-in-the-loop e human-on-the-loop parlando di agenti software. Con un robot fisico la distinzione diventa ancora più concreta: chi controlla, quando può intervenire e come si ferma la macchina?

Quanti italiani potrebbero averne uno nel 2036?

Non esiste oggi una base abbastanza solida per una percentuale precisa. La mia stima per l’Italia distingue tre scenari:

  • scenario prudente: meno dell’1% delle famiglie possiede un robot mobile manipolatore o umanoide; i robot specializzati continuano a moltiplicarsi;
  • scenario centrale: tra l’1% e il 5% delle famiglie usa un robot con braccia, acquistato o in abbonamento, soprattutto per assistenza e gestione della casa;
  • scenario molto ottimistico: tra il 5% e il 15%, possibile soltanto con prezzi sotto i 10.000 euro, affidabilità elevata, assistenza capillare e regole chiare.

“Tutti” rimane irrealistico anche nello scenario più favorevole. Il vero salto potrebbe avvenire prima nei servizi per anziani, nelle residenze assistite, negli alberghi e nelle imprese di pulizia. Sono contesti in cui il costo si distribuisce su più utenti e i compiti possono essere standardizzati.

La mia conclusione: sì ai robot in casa, no al maggiordomo universale per tutti

Entro dieci anni molti di noi parleranno con oggetti capaci di vedere, comprendere istruzioni e agire. Le abitazioni più tecnologiche avranno una piccola squadra di macchine specializzate. Alcune famiglie proveranno robot mobili dotati di braccia. Pochissime avranno un umanoide davvero generalista.

Il passaggio più probabile non sarà dal nulla a un maggiordomo robotico. Sarà una progressione: aspirapolvere più intelligente, dispositivi coordinati, bracci mobili, assistenza remota, nuovi compiti scaricabili. In altre parole, il robot domestico arriverà a pezzi prima di arrivare tutto intero.

La parte più interessante riguarda l’intelligenza che orchestra questi dispositivi. È la versione fisica di ciò che sta già accadendo con agenti AI e second brain: memoria, contesto, pianificazione e strumenti trasformano un comando in una sequenza di azioni. Con una differenza: se un agente software sbaglia una tabella, possiamo correggerla. Se un robot sbaglia presa, raccogliamo i cocci.

Domande frequenti

Un robot domestico può già pulire e riordinare tutta la casa?

No. I prodotti attuali svolgono bene compiti specializzati. I modelli più avanzati promettono raccolta del bucato e riordino, ma hanno ancora limiti di velocità, autonomia e affidabilità e possono ricorrere all’assistenza remota.

Quanto costa oggi un robot umanoide per la casa?

Nel 2026 1X propone NEO in Early Access a 20.000 dollari o, in futuro, a 499 dollari al mese. Isaac 1, non umanoide e su ruote, è annunciato a 7.999 dollari o 449 dollari al mese. Prezzi, disponibilità e funzioni possono cambiare.

Il robot registrerà quello che succede in casa?

Per lavorare deve usare sensori, telecamere e microfoni. Le domande da porre sono dove vengono elaborati i dati, per quanto tempo vengono conservati, chi può accedervi e quando interviene un operatore remoto.

Entro il 2036 avremo davvero tutti un robot?

Probabilmente avremo molti più robot domestici specializzati. Un robot generalista in ogni casa è incompatibile con i dati attuali su prezzo, affidabilità e ritmo di adozione.

Fonti

Per questa analisi ho consultato i dati 2025 dell’International Federation of Robotics riportati da Reuters il 21 settembre 2026; il benchmark BEHAVIOR-1K della Stanford University; la rassegna 2025 di Zhang e colleghi su IEEE/CAA Journal of Automatica Sinica; il lavoro di Ayub, Nehaniv e Dautenhahn accettato a IEEE ICRA 2024; la documentazione tecnica di Google DeepMind su Gemini Robotics; l’analisi di mercato 2025 di Morgan Stanley; la documentazione ufficiale di 1X NEO e Weave Robotics Isaac 1; lo studio ACM del 2025 su privacy e fiducia nei robot domestici; il quadro normativo della Commissione europea.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Un corso su LinkedIn e AI dovrebbe insegnare a migliorare profilo, contenuti e relazioni, ma anche a verificare le presunte regole dell’algoritmo. L’intelligenza artificiale può aiutarti a organizzare le idee e scrivere meglio. Non conosce, per questo, una formula segreta per moltiplicare la visibilità.

Mi è stata sottoposta un’infografica intitolata How the LinkedIn algorithm works in 2026. Sette riquadri, numeri precisi, promesse rassicuranti. I primi 90 minuti deciderebbero tutto. Un salvataggio varrebbe cinque like. Un commento da otto a quindici. Sembra il listino della borsa delle interazioni.

Ho controllato le sette affermazioni confrontandole con documentazione tecnica, paper e benchmark. Il risultato è una guida pratica per chi cerca “LinkedIn AI corso” e vuole imparare un metodo verificabile. Per cominciare dalle basi, trovi anche il mio videocorso LinkedIn gratuito sull’ottimizzazione del profilo.

Verifica delle fonti: 20 settembre 2026. Le valutazioni riguardano le informazioni pubbliche consultate, non il codice interno di LinkedIn. Gli esempi didattici sono dichiarati come tali.

L’infografica sull’algoritmo LinkedIn 2026: verifica delle sette affermazioni

Una distinzione preliminare: “non verificato” non significa automaticamente “falso”. Significa che non ho trovato una fonte adeguata per presentare quella frase come un fatto. Un benchmark, inoltre, descrive un campione: non rivela da solo il funzionamento del ranking.

Affermazione dell’infografica Esito della verifica Come usarla correttamente
Il 70% della reach si decide nei primi 60-90 minuti; commenti e salvataggi iniziali decidono la distribuzione. Percentuale e finestra decisiva non documentate nelle fonti consultate. Rispondere quando si è disponibili è una scelta organizzativa. Non esiste qui una prova che il post scada dopo 90 minuti.
Un salvataggio vale 5 like e 2 commenti; i contenuti salvabili ottengono più distribuzione di qualsiasi altro contenuto. Moltiplicatori non verificati. Anche il primato assoluto è privo di prova. Creare risorse utili ha senso. Non attribuire loro un rendimento algoritmico fisso.
I commenti valgono 8-15 like; quelli articolati segnalano conversazioni autentiche, mentre “Great post!” viene escluso dalla distribuzione. Pesi non verificati. La preferenza per contributi sostanziali è coerente con le comunicazioni della piattaforma; l’esclusione automatica di una frase breve non è dimostrata. Aggiungere un esempio, una domanda pertinente o un’obiezione motivata.
Il tempo di permanenza conta più dei like; 60 secondi di lettura battono 50 like con letture da 3 secondi. Segnale reale, confronto numerico non provato. Favorire comprensione e utilità senza allungare artificialmente i testi.
360Brew legge headline, informazioni ed esperienze prima di distribuire ogni post; un profilo vago riduce sempre la reach. Attribuzione a 360Brew non giustificata. Il ruolo dei segnali di profilo va distinto dalla presunta penalità universale. Rendere chiaro il proprio lavoro ai lettori, evitando promesse sul ranking.
I documenti hanno engagement medio del 6,6%, il più alto del 2026; sfogliarli aumenta il dwell time e il valore algoritmico. Dato rintracciabile, generalizzazione scorretta. Il 6,6% compare nel Q2 2026 di Socialinsider, con i multi-immagine al 6,9%. Il meccanismo causale non è provato dal benchmark. Distinguere periodo, campione, formato e metrica.
La coerenza tematica batte la dimensione della rete; cambiare argomento confonde 360Brew. Consiglio editoriale trasformato in legge. Nessuna prova di questo confronto universale. Scegliere temi riconoscibili e sperimentare collegamenti pertinenti.

C’è persino un problema di coerenza interna. Se un salvataggio equivale a cinque like e a due commenti, un commento dovrebbe valere 2,5 like. Il riquadro successivo ne indica da otto a quindici. Senza spiegare contesti diversi, i due conti non tornano. Questo non dimostra quali siano i pesi reali: dimostra che quei numeri non possono essere utilizzati insieme come una formula.

360Brew e Feed SR: che cosa dicono davvero i paper

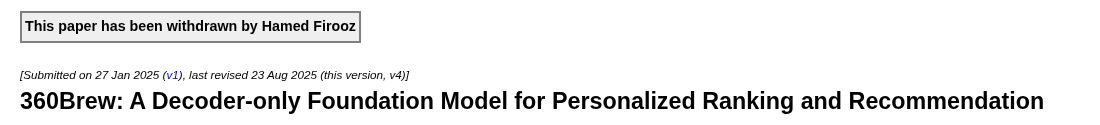
Il paper su 360Brew di Hamed Firooz e colleghi, presentato nel gennaio 2025, descriveva un modello di ricerca pre-production da 150 miliardi di parametri. La scheda arXiv segnala il ritiro; la nota amministrativa riguarda il diritto del depositante ad accettare la licenza. Il ritiro, da solo, non dimostra che i risultati tecnici fossero sbagliati. Ma quel documento non autorizza a descrivere 360Brew come il motore che decide oggi la visibilità di ogni post.

Screenshot arXiv: avviso di ritiro e titolo del paper 360Brew
Estratto della scheda arXiv di 360Brew, consultata il 20 settembre 2026. L’avviso di ritiro è visibile sopra il titolo.

Un riferimento più pertinente è An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking, di Lars Hertel, Gaurav Srivastava e colleghi. La versione consultata è del 16 settembre 2026. Gli autori descrivono Feed Sequential Recommender, o Feed SR, e dichiarano l’impiego sulla maggior parte del traffico del feed. Riportano test A/B con un aumento del 2,10% del tempo trascorso e del 3,52% della metrica che raggruppa like, commenti e ricondivisioni rispetto al modello precedente.

Sono risultati del sistema nel suo insieme. Non significano che un tuo post guadagnerà il 3,52%, né che un commento abbia un valore fisso. Il paper descrive una sequenza di interazioni e previsioni di azioni: non un tariffario pubblico per creator.

Screenshot arXiv del paper su Feed SR con revisione del 16 settembre 2026
La scheda del paper su Feed SR: titolo e data della revisione consultata.

La spiegazione ufficiale Engineering the next generation of LinkedIn’s Feed, firmata da Hristo Danchev il 12 marzo 2026, distingue la selezione dei contenuti candidati dal loro ordinamento. Descrive modelli che utilizzano significato dei contenuti, segnali professionali del lettore e storia delle interazioni. Gli aggiornamenti possono riguardare anche post già esistenti che ricevono nuove interazioni. Non pubblica la regola del “70% entro 90 minuti”.

Attenzione anche a una confusione frequente: i dati del tuo profilo che aiutano a personalizzare ciò che leggi non dimostrano automaticamente una penalità per ciò che pubblichi. Una headline chiara resta una buona scelta di comunicazione. Per esempio, “Consulente commerciale per aziende manifatturiere” permette a un potenziale cliente di orientarsi meglio di “Professionista appassionato di sfide”.

Tempo di lettura e commenti: i segnali esistono, i moltiplicatori no

Il tempo di permanenza non è un’invenzione dell’infografica. In Understanding dwell time to improve LinkedIn feed ranking, del 12 maggio 2020, il team di LinkedIn spiega l’uso del dwell time nel feed e dopo il clic, anche per individuare contenuti rapidamente saltati. È una fonte tecnica storica, non una descrizione completa del sistema del 2026. Non stabilisce l’equivalenza “60 secondi battono 50 like”.

La mia indicazione pratica: togli attriti alla lettura. Una spiegazione può richiedere dieci righe o dieci slide. Se aggiungo sette slide vuote per trattenere le persone, sto progettando un ostacolo, non una lezione.

Sull’autenticità c’è una comunicazione più recente: Keeping conversations real on LinkedIn, di Laura Lorenzetti, pubblicata il 20 maggio 2026. LinkedIn ammette l’uso dell’AI come supporto alla scrittura, ma annuncia interventi sui contenuti generici, sulle risposte che ripetono il post e sui commenti automatizzati su larga scala. Non dice che ogni ringraziamento breve sia falso.

Esempio didattico: sotto un post sulla formazione aziendale, “Concordo, tema fondamentale” aggiunge poco. “Nel tuo esempio manca il tempo per verificare l’output: come lo includeresti nell’esercitazione?” apre una questione precisa. Non servono cinque frasi quando ne basta una utile.

Il 6,6% dei documenti LinkedIn: leggere bene un benchmark

Il report LinkedIn Benchmarks 2026 di Socialinsider permette di rintracciare quel numero: nell’aggiornamento del secondo trimestre 2026 i documenti nativi sono al 6,6% di engagement medio, mentre i post multi-immagine sono al 6,9%. La tabella annuale indica invece il 7% per i documenti sui dati 2025.

La metodologia annuale dichiara 1,3 milioni di post di 16.645 pagine aziendali, tra gennaio 2024 e dicembre 2025. La pagina aggiunge aggiornamenti trimestrali, ma non si può attribuire automaticamente al solo Q2 l’intero campione annuale. Il tasso è calcolato rispetto alle impression, non ai follower. Sono dati osservazionali di un fornitore di analytics, non un esperimento causale di LinkedIn sui profili personali.

Un PDF e un album di immagini sono inoltre formati distinti. Dire “i caroselli fanno sempre il 6,6%” perde queste differenze. Per scegliere, partirei dalla domanda del lettore: un procedimento può diventare un documento; una visita a uno stabilimento può essere raccontata con fotografie. Misurerei poi i risultati sul mio pubblico.

LinkedIn e AI: corso pratico in cinque esercizi

La parte utile comincia qui. Propongo un piccolo laboratorio per consulenti, commerciali, professionisti e responsabili marketing. Puoi svolgerlo con un assistente AI testuale, usando materiali che hai titolo a condividere. Gli output sono bozze da controllare prima della pubblicazione.

1. Migliorare il profilo partendo da prove

Raccogli il testo attuale del profilo, una descrizione dei servizi e due esperienze documentate. Chiedi una diagnosi prima della riscrittura.

Agisci come un revisore del mio profilo LinkedIn. Il pubblico è [target] e voglio essere riconoscibile per [competenza]. Analizza headline, informazioni ed esperienze che incollo. Indica cinque passaggi generici e le domande necessarie per renderli concreti. Proponi tre headline usando solo le informazioni presenti. Non inventare clienti, certificazioni, anni di esperienza o risultati. Segna con [DA VERIFICARE] ciò che manca.

Esempio didattico: per un professionista che lavora realmente con PMI manifatturiere, “Aiuto le PMI manifatturiere a organizzare il processo commerciale” è una proposta più comprensibile di “Sales ninja orientato al successo”. Va usata soltanto se descrive ciò che fa davvero.

Per rivedere le basi prima di usare l’AI, il mio videocorso LinkedIn gratis offre dieci videopillole su profilo, posizionamento, keyword, esperienze e networking. È una base sul profilo; gli esercizi di questo articolo aggiungono il lavoro con l’AI.

2. Trasformare un’esperienza in un post verificabile

Parti da appunti reali: una domanda ricevuta, un errore corretto, una scelta progettuale. Un aneddoto inventato resta inventato anche se il chatbot lo racconta bene.

Trasforma questi appunti in una bozza LinkedIn per [pubblico]. Mantieni il mio punto di vista: [tesi]. Struttura: problema concreto, esempio, limite, domanda finale pertinente. Massimo 1.300 caratteri. Niente emoji, superlativi o statistiche aggiunte. Non attribuirmi esperienze assenti dagli appunti. Elenca separatamente le affermazioni da verificare e conserva i link alle fonti che ti fornisco.

Controllo finale: saprei rispondere se qualcuno mi chiedesse come ho ottenuto quel dato? Se no, cerco la fonte o elimino il dato. Se l’episodio contiene informazioni riservate di un cliente, preparo un esempio anonimo o un caso esplicitamente ipotetico.

3. Progettare un documento utile da conservare

Esempio didattico per un consulente AI: un PDF intitolato “Cinque controlli prima di usare un documento aziendale con un chatbot”. Ogni pagina contiene un controllo, una domanda e un esempio. Il formato segue il lavoro da svolgere.

Progetta una scaletta di sei slide sul tema [tema] per [pubblico]. Usa soltanto le fonti e gli appunti allegati. Per ogni slide scrivi titolo, messaggio principale, esempio e fonte, se necessaria. La prima deve spiegare l’utilità del documento; l’ultima deve contenere una checklist. Segnala informazioni mancanti. Evita slide riempitive e promesse di performance.

Prima di caricarlo, leggi il PDF sul telefono. Controlla dimensioni del testo, contrasto, ordine delle pagine e leggibilità dei collegamenti. Un contenuto “salvabile” deve essere utilizzabile anche domani.

4. Preparare una conversazione senza automatizzare il rapporto

L’AI può aiutarti a capire un testo prima di intervenire. La risposta pubblica deve riflettere ciò che pensi e conosci.

Riassumi la tesi di questo post in due frasi. Individua una domanda rimasta aperta e un possibile limite. Proponi tre spunti per un commento, senza scriverli come mie esperienze. Non fingere che conosca l’autore. Aspetta che io scelga lo spunto e aggiunga il mio punto di vista.

La verifica è semplice: se cancellassi il riferimento al post originale, il commento funzionerebbe sotto qualunque contenuto? Se sì, probabilmente è troppo generico.

5. Analizzare i risultati senza scambiare correlazione e causa

Prepara una tabella dei tuoi post con data, argomento, formato, impression, reazioni, commenti, clic e salvataggi quando disponibili. Aggiungi un campo per le conversazioni professionali pertinenti e uno per le richieste ricevute. Non confondere gli zeri con i dati mancanti.

Analizza questa tabella dei miei post LinkedIn. Distingui risultati osservati, ipotesi e dati mancanti. Confronta formati e argomenti usando numerosità, mediana e dispersione quando i dati lo consentono. Non dedurre i pesi dell’algoritmo. Se calcoli un tasso, esplicita numeratore e denominatore. Proponi due esperimenti editoriali cambiando una variabile alla volta. Non attribuire vendite ai post senza evidenze.

Come esercizio, puoi osservare i post dopo 24 ore e dopo sette giorni, mantenendo uguali le finestre di confronto. Sono scelte di misurazione del laboratorio, non scadenze imposte dall’algoritmo. Con pochi post parlerai di indizi, non di conclusioni statistiche robuste.

L’AI migliora la scrittura? Uno studio utile, con limiti precisi

Shakked Noy e Whitney Zhang hanno studiato l’uso di ChatGPT in compiti di scrittura professionale con 453 partecipanti. Il lavoro, Experimental evidence on the productivity effects of generative artificial intelligence, è stato pubblicato su Science nel 2023. Il resoconto del Massachusetts Institute of Technology, con collegamento al paper, riporta un tempo medio ridotto del 40% e una qualità valutata superiore del 18%.

Lo studio non misurava la reach su LinkedIn. I compiti non richiedevano lo stesso contesto aziendale e la stessa verifica fattuale di molte attività reali. È una base per sperimentare un assistente alla scrittura, non una prova che i post generati ottengano più clienti.

Nel laboratorio separerei quindi due misure: tempo necessario per produrre una bozza affidabile, compresa la revisione, e risultati del contenuto pubblicato. Risparmiare venti minuti e pubblicare un errore non è il miglioramento che cerchiamo.

Come scegliere un corso LinkedIn AI

Valuterei un corso dai materiali che permette di costruire e dai controlli che insegna. Ecco la mia checklist:

  • Profilo: il lavoro parte da pubblico, competenze e prove?
  • Prompt: le richieste includono fonti, vincoli e gestione delle informazioni mancanti?
  • Contenuti: si lavora su esperienze reali e revisioni, oltre che sulle prime bozze?
  • Relazioni: gli esercizi favoriscono conversazioni pertinenti?
  • Misurazione: si distinguono visibilità, interazioni, contatti e opportunità?
  • Algoritmo: il docente separa documentazione ufficiale, benchmark e ipotesi?

Se un programma promette il trucco definitivo per aggirare l’algoritmo, chiederei la fonte, la data e il metodo di verifica. È un ottimo esercizio già prima dell’iscrizione.

Domande frequenti su LinkedIn, AI e formazione

Posso usare l’AI per scrivere i post LinkedIn?

Sì, come supporto per struttura e formulazione. La comunicazione di LinkedIn sull’autenticità richiede che post e commenti rappresentino la voce e la prospettiva dell’autore. Verifica fatti, esempi e tono prima di pubblicare.

I primi 90 minuti decidono davvero tutto?

Non ho trovato nelle fonti tecniche consultate una conferma della finestra universale e della percentuale indicate nell’infografica. Conviene usare finestre di osservazione costanti, evitando di giudicare un contenuto soltanto dai primi minuti.

Il videocorso LinkedIn gratuito comprende questo laboratorio AI?

Il videocorso collegato insegna le basi dell’ottimizzazione del profilo. Il laboratorio AI è descritto in questo articolo: puoi affiancarlo alle videopillole, senza confondere i due materiali.

Come posso organizzare un corso LinkedIn e AI per l’azienda?

Puoi scrivermi tramite il form qui sotto indicando destinatari, livello di partenza e obiettivo: personal branding, comunicazione, social selling o ricerca di opportunità professionali. Possiamo costruire esercitazioni su profili e materiali pertinenti al tuo contesto.

Per iniziare subito: guarda il videocorso LinkedIn gratuito, scegli un esercizio di questa guida e confronta la bozza dell’AI con le prove che hai a disposizione. Il primo risultato da cercare è un profilo più chiaro e un contenuto di cui puoi rispondere personalmente.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Come si allena un modello AI? Si parte da dati ed esempi, si misura l’errore e si aggiornano i parametri per migliorare il risultato. Nei modelli linguistici generativi, al pretraining possono seguire allenamenti mirati e feedback. Una metafora calcistica aiuta a distinguere queste fasi dalle istruzioni che scriviamo in un prompt.

Per capire come si allena un’intelligenza artificiale, proviamo a entrare in un campo da calcio. Ci sono esercizi, errori da correggere, un allenatore e una partita che dirà se tutto quel lavoro è servito.

La lavagna tattica, però, non basta. Posso disegnare il più bel 4-3-3 della storia: se i giocatori non sanno controllare il pallone, resterà un magnifico progetto d’arredamento dello spogliatoio.

Con l’AI possiamo distinguere in modo simile la preparazione delle capacità di base, gli allenamenti mirati e le istruzioni per affrontare un compito. Qui parlerò soprattutto dei modelli linguistici generativi, quelli che producono testo. La metafora serve a orientarsi: un modello non ha muscoli, intenzioni o voglia di vincere il derby.

1. I dati: il materiale della scuola calcio

Immaginate di preparare una squadra facendole vedere soltanto rigori. Quando arriveranno un calcio d’angolo o un contropiede, avrete qualche problema.

Questa immagine aiuta a capire perché conta ciò su cui un modello viene allenato. I dati sono gli esempi da cui ricava regolarità. Per un modello linguistico possono essere testi di natura diversa: il lavoro iniziale su un ampio insieme di testi si chiama pretraining. È una delle basi del percorso descritto nella ricerca Language Models are Few-Shot Learners.

Nella nostra scuola calcio, quindi, i dati sono il repertorio degli esercizi e delle situazioni di gioco. Se quel repertorio è limitato, dobbiamo stare attenti a ciò che pretendiamo dalla squadra.

Pretraining: avatar di Gianluigi Bonanomi insegna i fondamentali a robot calciatori
Pretraining: la scuola calcio.

2. Il pretraining: imparare i fondamentali

Prima degli schemi del mister vengono stop, passaggi e controllo del pallone. Nel caso dei modelli linguistici autoregressivi, un esercizio fondamentale consiste nel prevedere il token successivo, cioè la prossima unità di testo, che può essere una parola o un suo frammento.

Immaginiamo la frase: «L’attaccante tira e segna un…». “Gol” è una continuazione plausibile. Il modello assegna probabilità alle possibili continuazioni: durante l’allenamento queste previsioni vengono confrontate con il testo effettivo.

Ripetere questo esercizio su molti esempi permette di sviluppare capacità linguistiche utilizzabili in compiti diversi. Il lavoro su GPT-3 mostra proprio il rapporto fra pretraining e capacità di affrontare compiti presentati attraverso il testo. Prevedere il seguito di una frase, però, non equivale a verificarne la verità.

La loss misura l’errore e l’ottimizzatore aggiorna i parametri: allenamento con Bonanomi
L’errore guida l’allenamento.

3. Come si allena un modello AI: tiro, errore, correzione

Un giocatore calcia fuori. L’allenatore osserva il gesto, suggerisce una correzione e gli fa riprovare. Nell’AI la correzione è matematica.

Il modello produce una previsione. Una funzione, chiamata loss, misura quanto quella previsione sia lontana dall’obiettivo dell’esercizio. Un algoritmo di ottimizzazione aggiorna i parametri, i valori numerici che regolano il comportamento del modello, cercando di ridurre la loss. Il ciclo si ripete su molti esempi. La guida di Google sulla discesa del gradiente illustra questo meccanismo di correzione progressiva.

La loss somiglia al criterio con cui il mister valuta l’esercizio; l’ottimizzatore al meccanismo con cui vengono applicati gli aggiustamenti. Sono ruoli diversi. Ecco il cuore dell’addestramento: cambiano i parametri del modello.

Fine-tuning e feedback spiegati da Bonanomi con una lavagna tattica
Fine-tuning e feedback.

4. Il fine-tuning: imparare il gioco del mister

Ora la squadra sa giocare. Vogliamo però che impari un certo stile: costruzione dal basso, passaggi rapidi, attenzione alle consegne.

Il fine-tuning supervisionato può essere visto come un allenamento mirato su esempi del comportamento desiderato. Per un assistente, questi esempi possono mostrare come rispondere a una richiesta, organizzare una spiegazione o rispettare un formato.

La ricerca su InstructGPT descrive un percorso che parte da dimostrazioni scritte da persone per migliorare la capacità di seguire le istruzioni. Nella metafora: il mister mostra come vorrebbe fosse eseguita l’azione.

5. Il feedback: scegliere le azioni migliori

Due giocatori arrivano davanti alla porta. Uno tenta un tiro impossibile, l’altro passa al compagno libero. Il mister valuta quale scelta preferisce.

Anche nell’addestramento di un assistente si possono confrontare risposte alternative. Nel percorso di RLHF, apprendimento per rinforzo dal feedback umano, descritto nello studio su InstructGPT, le preferenze raccolte servono ad allenare un modello di ricompensa, poi usato per guidare ulteriori aggiornamenti dell’assistente.

Non esiste un’unica ricetta. La Direct Preference Optimization, o DPO, utilizza le preferenze con un metodo diverso, evitando di addestrare separatamente quel modello di ricompensa. È descritta nella ricerca di Rafailov e colleghi.

La domanda da allenatore diventa interessante: che cosa stiamo premiando? Se applaudissimo soltanto le giocate spettacolari, potremmo ritrovarci una squadra bravissima a fare colpi di tacco e pochissimo interessata al risultato.

Bonanomi osserva una partita nuova: test del modello e differenza tra prompt e addestramento
Il test è una partita nuova.

6. La verifica: giocare una partita nuova

Segnare sempre nello stesso esercizio, contro lo stesso portiere, non basta. Serve una prova in condizioni che non siano già state memorizzate.

Per valutare un modello si separano i dati di training, usati per allenarlo, quelli di validazione, utili a orientare le scelte di sviluppo, e quelli di test, riservati alla valutazione finale. Google sottolinea che i test devono usare esempi nuovi, senza duplicati del training, e rappresentativi degli impieghi reali. Fonte: Dividing the original dataset.

Nella metafora calcistica sono allenamenti, amichevoli per aggiustare la preparazione e prova finale. L’overfitting è il rischio di diventare troppo bravi sugli esercizi già incontrati e poco efficaci sulle situazioni nuove. Una squadra campione dei coni, insomma.

7. E il prompt? Sono le istruzioni dalla panchina

«Allarga il gioco sulla destra». È una consegna per l’azione in corso. Non equivale a rifare tutta la preparazione atletica.

Un prompt funziona, nella nostra metafora, come quella consegna. Può includere obiettivi, vincoli ed esempi. Il modello li usa nel contesto della richiesta: questo, di per sé, non aggiorna i suoi parametri. Il lavoro su GPT-3 distingue esplicitamente l’uso di esempi nel testo dall’aggiornamento dei parametri.

Perciò, quando diciamo «sto allenando l’AI» perché le stiamo scrivendo istruzioni, spesso stiamo usando un’espressione imprecisa. Possiamo guidarla nella conversazione senza aver avviato un vero processo di addestramento.

Per approfondire un’altra distinzione importante, ho preparato anche una guida alla memoria di ChatGPT: personalizzazione delle risposte e addestramento del modello vanno tenuti separati.

La metafora in una tabella

Nel calcio Nel modello AI
Repertorio di esercizi Dati di addestramento
Scuola calcio e fondamentali Pretraining
Criterio per valutare l’errore Funzione di loss
Aggiustamenti durante la preparazione Aggiornamento dei parametri
Allenamenti mirati Fine-tuning
Valutazione delle scelte di gioco Feedback e preferenze
Partita di verifica Test su esempi nuovi
Consegna dalla panchina Prompt

Un esercizio da portare in aula

Propongo di prendere un compito concreto, per esempio rispondere a un reclamo, e scrivere prima una richiesta generica. Poi aggiungiamo destinatario, obiettivo, limiti e un esempio di risposta ben costruita. Infine confrontiamo i risultati.

Abbiamo cambiato l’allenamento del modello? No: abbiamo migliorato le consegne. È un piccolo esperimento per distinguere ciò che il modello ha imparato durante la preparazione da ciò che gli chiediamo di fare adesso.

La prossima volta che un’AI sbaglia un passaggio, proviamo quindi a farci tre domande: le capacità sono adeguate al compito? Le istruzioni erano chiare? Abbiamo verificato il risultato? Dalla panchina si vede meglio la partita quando si sa che cosa osservare.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

No: l’approvazione di Tesla FSD Supervised in Slovenia non significa che sia arrivata la guida autonoma. Il sistema disponibile sulle Tesla resta al livello 2 SAE: accelera, frena e sterza, ma chi siede al volante deve sorvegliarlo in ogni momento e rimane responsabile. Il Cybercab, invece, può operare senza conducente, ma soltanto entro condizioni e aree definite. Per questo si parla di livello 4, non di livello 5.

La differenza può sembrare accademica. In realtà decide chi deve guardare la strada, chi deve intervenire quando qualcosa va storto e chi porta la responsabilità della guida. Cambia tutto.

Tesla FSD approvato in Slovenia: che cosa è successo davvero

L’8 settembre 2026 la Slovenia ha autorizzato l’uso sulle proprie strade di Tesla Full Self-Driving (Supervised). È il sesto Paese europeo a farlo. La notizia, riportata da Quattroruote, può facilmente generare un equivoco: “Full Self-Driving” suona come “l’auto guida da sola”.

Non è così. La Slovenian Traffic Safety Agency, citata da Reuters, parla di riconoscimento temporaneo del sistema FSD Supervised e di integrazione graduale sotto controllo normativo e di sicurezza. Reuters lo definisce correttamente un sistema di assistenza alla guida che controlla l’auto, ma richiede al conducente di prestare attenzione.

Anche Tesla, nella propria documentazione ufficiale, usa la parola decisiva: Supervised. Il sistema può condurre l’auto quasi ovunque, ma sotto la supervisione del guidatore.

Tradotto: la Slovenia ha autorizzato una funzione avanzata. Non ha promosso la Tesla al livello 5 e nemmeno al livello 3.

I livelli SAE spiegati senza il marketing

La classificazione SAE non assegna un voto all’automobile. Descrive una specifica funzione di guida, indicando che cosa fa il sistema e che cosa deve ancora fare la persona. La sintesi della National Highway Traffic Safety Administration è molto chiara.

Livello Che cosa fa il sistema Ruolo della persona
0 Avvisi o interventi momentanei Guida e controlla tutto
1 Gestisce sterzo oppure velocità e frenata Guida e sorveglia
2 Gestisce insieme sterzo, accelerazione e frenata Deve sorvegliare continuamente
3 Guida in condizioni specifiche e può chiedere la ripresa del controllo Può non sorvegliare costantemente, ma deve essere pronto a intervenire
4 Guida senza conducente entro un dominio operativo definito È passeggero finché il sistema resta nel proprio dominio
5 Guida ovunque, su qualunque strada e in tutte le condizioni gestibili da un umano È sempre passeggero

Il salto più ingannevole è quello tra livello 2 e livello 3. Al livello 2 il sistema esegue molte azioni, ma il guidatore continua a guidare dal punto di vista funzionale e legale. Se legge un messaggio perché “tanto fa tutto l’auto”, sta usando male il sistema.

Perché Tesla FSD Supervised resta al livello 2

FSD può cambiare corsia, affrontare incroci, seguire il percorso, regolare la velocità e reagire al traffico. Eppure tre elementi lo mantengono al livello 2:

  • Il conducente deve osservare la strada.
  • Il conducente deve intervenire immediatamente.
  • Il conducente rimane responsabile della guida.

Un software può fare moltissimo e restare un assistente. Il nome “Full Self-Driving” descrive un’ambizione commerciale, non la categoria tecnica attuale del prodotto.

La questione umana non è secondaria. Uno studio del 2025 pubblicato su European Transport Research Review ha testato 31 persone in simulatore: lavorare al computer, guardare video o telefonare peggiorava la qualità della ripresa del controllo. Lo studio riguarda il livello 3, ma mostra perché affidare all’essere umano il ruolo di “paracadute” non è banale. L’attenzione non si riaccende premendo un pulsante.

Il Tesla Cybercab è livello 5?

No. Il Cybercab può essere considerato un sistema di livello 4 quando opera senza conducente dentro il proprio dominio operativo. Non diventa livello 5 solo perché non ha volante e pedali.

Dal 3 settembre 2026 Tesla ha iniziato a impiegare un piccolo numero di Cybercab ad Austin. Il veicolo a due posti non dispone dei normali comandi manuali. Proprio questa configurazione ha attirato l’attenzione della NHTSA: il 15 settembre l’autorità statunitense ha chiesto a Tesla chiarimenti sulla certificazione, sui limiti geografici, sugli orari di funzionamento e sull’eventuale presenza di comandi temporanei. Lo riferisce Reuters nell’articolo sull’indagine NHTSA.

Queste domande descrivono perfettamente la distanza dal livello 5. Un robotaxi che lavora in alcune zone di Austin, con regole, mappe operative e condizioni definite, può fare a meno del guidatore ma non può affrontare automaticamente qualsiasi strada del pianeta, dalla nebbia in Val Padana a una nevicata alpina, da un cantiere improvvisato a un sentiero sterrato.

Livello 4 non significa “quasi livello 5”

I livelli non sono tacche di una batteria. Il livello 4 può essere molto autonomo dentro un perimetro e del tutto indisponibile fuori. Il livello 5 elimina il perimetro. È una differenza enorme: tecnica, economica, normativa e assicurativa.

Waymo offre già un esempio maturo di livello 4 nei territori in cui opera. Uno studio peer reviewed del 2025 su 56,7 milioni di miglia senza conducente ha rilevato tassi inferiori rispetto ai benchmark umani in diverse categorie di incidente, comprese quelle con pedoni e ciclisti. È un risultato importante, ma non prova il livello 5: i dati provengono da città e domini operativi selezionati. Dimostrano che il livello 4 può essere utile e sicuro in contesti delimitati.

Perché il livello 5 è ancora lontano

La parte difficile non è far viaggiare bene un’auto nel 99% delle situazioni comuni. È gestire il residuo imprevedibile senza un essere umano pronto a salvare la scena.

Restano almeno cinque ostacoli:

  1. I casi rari. Animali, lavori stradali insoliti, gesti ambigui degli agenti, segnaletica danneggiata, allagamenti, comportamenti irrazionali degli altri utenti.
  2. Il maltempo e la visibilità. Pioggia intensa, neve, nebbia, sole basso e sensori sporchi riducono la qualità della percezione.
  3. La validazione. Gli eventi davvero pericolosi sono rari, quindi servono simulazioni, prove su strada e metriche comparabili. La ricerca parla di “curse of rarity”: più lo scenario è raro e complesso, più diventa difficile dimostrare statisticamente la sicurezza.
  4. Regole e responsabilità. Omologazione, assicurazione, responsabilità del produttore e comportamento in emergenza cambiano tra Paesi.
  5. Costi e scalabilità. Sensori, calcolo, mappatura, assistenza remota e gestione della flotta devono funzionare a costi sostenibili.

Nel settore dei trasporti l’AI sta già producendo valore anche senza promettere automobili onnipotenti. Ho raccolto altri esempi concreti di intelligenza artificiale applicata ai trasporti, dalla manutenzione alla pianificazione, fino alla gestione documentale.

Quanto manca alla vera guida autonoma?

Per il livello 4 la risposta è: è già qui, ma a isole. Robotaxi senza conducente operano in zone definite di alcune città. L’espansione sarà graduale, città per città e caso d’uso per caso d’uso.

Per il livello 5 non esiste una data scientificamente credibile. La più recente indagine McKinsey tra 91 operatori ed esperti del settore, pubblicata nel gennaio 2026, ha rilevato un allungamento medio delle previsioni di uno o due anni. La diffusione su larga scala dei robotaxi di livello 4 viene collocata intorno al 2030; i test urbani di livello 4 sulle auto private intorno al 2032. Inoltre, il gruppo più numeroso degli intervistati ritiene che nel 2035 il mercato di massa delle auto private sarà ancora centrato su funzioni di livello 2 avanzato.

Questa è una previsione industriale, non un calendario garantito. Sul livello 5 il dato più corretto è proprio l’assenza di una scadenza affidabile. Potrebbe richiedere molti anni, forse decenni, e potrebbe non essere economicamente sensato in ogni veicolo e in ogni luogo.

Come leggere le prossime notizie sulla guida autonoma

Quando leggi che un’auto “guida da sola”, verifica quattro cose:

  • chi deve sorvegliare la strada;
  • chi deve intervenire in caso di errore;
  • dove e in quali condizioni il sistema può funzionare;
  • se si parla di un prodotto acquistabile, di un test o di una flotta commerciale limitata.

La Slovenia ha aperto la porta a FSD Supervised, non alla scomparsa del guidatore. Il Cybercab ha aperto quella del robotaxi di livello 4, ma non può ancora portarci ovunque. La guida autonoma sta arrivando per territori, condizioni e casi d’uso. Il livello 5, per ora, resta sul cartello in fondo alla strada.

Domande frequenti

Tesla FSD è davvero guida autonoma?

No. FSD Supervised è un sistema SAE di livello 2: controlla sterzo, accelerazione e frenata, ma il conducente deve sorvegliare e intervenire.

La Slovenia ha approvato Tesla FSD?

Sì. Nel settembre 2026 la Slovenia ha riconosciuto temporaneamente l’uso di FSD Supervised sulle proprie strade. L’approvazione riguarda un sistema di assistenza alla guida, non un’automobile di livello 5.

Il Cybercab è livello 4 o livello 5?

Il funzionamento senza conducente entro aree e condizioni definite corrisponde al livello 4. Il livello 5 richiederebbe funzionamento universale, senza limitazioni operative paragonabili.

Quando arriverà il livello 5?

Non esiste una previsione affidabile. Gli esperti collocano la diffusione ampia del livello 4 nel prossimo decennio, mentre il livello 5 non ha oggi una data credibile.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

L’intelligenza artificiale può già alleggerire il lavoro quotidiano degli autotrasportatori: leggere documenti, controllare scadenze, confrontare contratti, analizzare dati di viaggio e trasformare una riunione in un verbale operativo. Oggi, 19 settembre 2026, ne ho parlato a Roma all’Assemblea nazionale di Confartigianato Trasporti.

Il criterio che ho proposto è molto concreto: partire da un’attività frequente, ripetitiva e verificabile. L’AI non guida il camion e non sostituisce chi conosce il mestiere. Può però togliere dal tavolo parecchio lavoro amministrativo e aiutare a vedere prima errori, scadenze e anomalie.

Assemblea nazionale 2026 di Confartigianato Trasporti

L’evento si è svolto all’Auditorium Confartigianato di Roma con il titolo “Guidare il cambiamento. L’autotrasporto del futuro”. Il programma ha affrontato la transizione energetica, le tecnologie per il trasporto e le prospettive del settore. Alle 11.30 sono intervenuto nella sessione “L’AI a servizio dell’autotrasporto: strumenti e strategie di sviluppo” insieme a Dario Rusconi, partner di BECAP ed esperto di controllo di gestione.

Nel corso della mattinata sono intervenuti rappresentanti di Confartigianato Trasporti, istituzioni e imprese della filiera. Il tema comune era chiaro: innovare significa tradurre tecnologia e normativa in scelte pratiche per le aziende.

Nel resoconto ufficiale dell’Assemblea nazionale, Confartigianato sottolinea che gli interventi curati da me e Dario Rusconi hanno approfondito l’impatto dell’innovazione tecnologica, della digitalizzazione e dell’intelligenza artificiale nella gestione delle aziende di autotrasporto. È un passaggio importante: l’AI è entrata nel confronto nazionale di categoria come strumento operativo, non come semplice tema da convegno.

Gianluigi Bonanomi all'Assemblea nazionale 2026 di Confartigianato Trasporti a Roma
All’Assemblea nazionale 2026 di Confartigianato Trasporti, Roma, 19 settembre 2026.

Dove serve davvero l’AI per gli autotrasportatori

Documenti e normativa, contratti e preventivi, dati, riunioni e procedure: sono questi gli ambiti nei quali l’AI generativa può produrre un risultato utile già oggi. Ho mostrato due strumenti complementari: ChatGPT per creare, rielaborare, calcolare e cercare; Gemini Notebook per interrogare fonti caricate e ottenere risposte con citazioni.

La regola pratica è semplice: ChatGPT quando bisogna produrre o trasformare un contenuto; Gemini Notebook quando bisogna capire e incrociare documenti controllati. In entrambi i casi l’output va verificato.

AI per autotrasportatori: 10 esempi pratici

1. Trasformare ricevute e fatture in una nota spese

Si parte dalle fotografie di scontrini, pedaggi, taxi, alberghi e carburante. L’AI estrae data, fornitore, descrizione, metodo di pagamento e importo, segnala i dati illeggibili e prepara una tabella da esportare in Excel. Il controllo finale resta indispensabile, soprattutto quando una ricevuta copre parzialmente un’altra o manca un importo.

Prompt di esempio: “Leggi queste ricevute. Crea una tabella con data, esercente, categoria, importo, metodo di pagamento e nota. Non inventare i dati non leggibili: contrassegnali come da verificare.”

2. Studiare una circolare

Una circolare può diventare una checklist operativa o una FAQ. L’AI deve indicare che cosa cambia, da quando, per chi, quali scadenze introduce e quali azioni richiede. Per ridurre il rischio di interpretazioni creative bisogna pretendere pagina e passaggio della fonte.

Prompt di esempio: “Riassumi in 10 punti. Indica cambiamenti, destinatari, scadenze e rischi. Cita pagina e passaggio.”

3. Interrogare CCNL e accordi

Caricando più fonti controllate si possono confrontare orari, riposi, trasferte, regole ed eccezioni. La risposta utile non è un riassunto generico, ma una tabella che colleghi ogni affermazione alla fonte e alla pagina.

Prompt di esempio: “Usa solo le fonti caricate. Crea una tabella con regola, eccezioni, fonte, pagina e azione richiesta.”

4. Controllare le scadenze

CQC, ADR, patenti, visite e formazione possono confluire in uno scadenzario ordinato per urgenza. Prima di creare un promemoria, l’AI deve segnalare date mancanti o incongruenti. In questo modo l’azienda evita di trasformare un dato incompleto in una falsa certezza.

Prompt di esempio: “Crea uno scadenzario con conducente, documento, scadenza, anticipo consigliato e livello di urgenza. Evidenzia i dati mancanti.”

5. Leggere un contratto prima di firmarlo

L’AI può accendere una spia su responsabilità, penali, pagamenti, recesso, assicurazioni e foro competente. Non sostituisce l’avvocato. Prepara però un elenco di domande mirate e rende più veloce il controllo professionale.

Prompt di esempio: “Evidenzia clausola, significato semplice, rischio da 1 a 5, conseguenza pratica e domanda da fare all’avvocato.”

6. Confrontare due versioni di un documento

Un regolamento, un contratto o un capitolato può cambiare in poche righe dentro cento pagine. L’AI può ignorare le variazioni grafiche e isolare le differenze sostanziali, distinguendo l’impatto operativo da quello economico.

Prompt di esempio: “Confronta A e B. Mostra testo precedente, testo nuovo, impatto operativo, impatto economico e azione consigliata.”

7. Leggere i dati del tachigrafo

L’AI può segnalare anomalie nei tempi di guida e nelle pause, ma deve applicare soltanto le soglie presenti nelle fonti. La Commissione europea raccoglie le regole su tempi di guida e periodi di riposo e dedica una sezione specifica al tachigrafo nel trasporto stradale. Il controllo umano viene prima di qualsiasi decisione disciplinare o organizzativa.

Prompt di esempio: “Segnala anomalia, valore, soglia, scostamento e priorità. Non applicare regole assenti dalle fonti.”

8. Ridurre consumi e chilometri a vuoto

Lo storico dei viaggi può far emergere tempi di attesa, tratte vuote, consumi e margini anomali. L’AI aiuta a ordinare i casi per impatto economico. Non deve però confondere una correlazione con una causa: se mancano carico, percorso, meteo o stile di guida, la spiegazione resta un’ipotesi.

Prompt di esempio: “Ordina le anomalie per impatto economico. Distingui fatti e ipotesi e chiedi i dati mancanti.”

9. Preparare un preventivo più trasparente

Carburante, pedaggi, ore, attese e ritorno a vuoto possono essere esplicitati in un modello con tre scenari: prudente, realistico e favorevole. Ogni formula deve rimanere visibile, così l’imprenditore può correggere le ipotesi e difendere il margine.

Prompt di esempio: “Mostra ogni formula. Crea scenario prudente, realistico e favorevole. Non inventare i valori mancanti.”

10. Trasformare un audio in un verbale operativo

Una registrazione autorizzata di riunione può diventare un verbale con decisioni, attività, responsabili, scadenze e questioni aperte. Il vantaggio non è la trascrizione parola per parola, ma una lista di azioni che qualcuno possa davvero seguire.

Prompt di esempio: “Elimina le ripetizioni senza cambiare il significato. Chiudi con una tabella delle azioni e una sintesi in cinque righe.”

Per altri modelli riutilizzabili si può partire dalla mia raccolta di prompt per il prompt engineering, adattando sempre obiettivo, fonti, formato dell’output e limiti.

Quali controlli servono prima di usare l’AI in azienda

Una risposta ben scritta può essere sbagliata. Nei processi dell’autotrasporto conviene adottare almeno questi controlli:

  • usare documenti aggiornati e riconoscibili;
  • chiedere citazioni puntuali quando si lavora su norme, contratti e procedure;
  • separare fatti, calcoli, ipotesi e suggerimenti;
  • anonimizzare i dati personali e commerciali quando possibile;
  • far verificare il risultato al professionista competente;
  • conservare il file originale e la traccia del controllo svolto.

Il quadro europeo dell’AI Act richiama responsabilità, trasparenza e competenze nell’uso dei sistemi di intelligenza artificiale. Per un’impresa significa anche formare chi usa questi strumenti e stabilire quali dati non devono essere caricati.

Da dove partire domani mattina

Scegliere un solo processo, con documenti non critici e un risultato facile da controllare. Per esempio: trasformare dieci ricevute in una tabella oppure confrontare due versioni della stessa procedura. Si misura il tempo impiegato, si contano gli errori e si decide se il metodo merita di diventare una procedura.

La tecnologia diventa utile quando entra in un flusso di lavoro e lascia tracce verificabili. Nel trasporto, dove scadenze, margini e conformità hanno conseguenze molto concrete, questa prudenza non rallenta l’innovazione: la rende utilizzabile.

Domande frequenti sull’AI per autotrasportatori

L’AI può controllare automaticamente il rispetto dei tempi di guida?

Può analizzare dati e segnalare scostamenti rispetto alle soglie fornite, ma non dovrebbe decidere da sola. Occorre verificare qualità dei dati, normativa applicabile ed eventuali eccezioni.

Meglio ChatGPT o Gemini Notebook?

Dipende dal compito. ChatGPT è adatto a creare e rielaborare contenuti. Gemini Notebook è utile quando la risposta deve restare ancorata a un insieme di fonti caricate e citate.

Si possono caricare contratti e dati degli autisti?

Solo dopo aver verificato policy aziendale, base giuridica, condizioni del servizio e misure di protezione. Quando possibile conviene anonimizzare o pseudonimizzare i dati e usare account aziendali approvati.

Qual è il primo progetto AI per una piccola azienda di trasporto?

Un processo frequente, ripetitivo e a basso rischio: note spese, scadenzari o confronto tra versioni di documenti. Il test deve avere un responsabile, una metrica di tempo e una verifica degli errori.

Fonti e approfondimenti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Risposta breve: il reddito universale può diventare uno degli strumenti con cui distribuire una parte dei guadagni prodotti dall’intelligenza artificiale, ma non è ancora una risposta pronta all’uso. L’Unione europea ha registrato una nuova iniziativa dei cittadini, non ha approvato una legge. Gli esperimenti disponibili mostrano benefici sulla sicurezza economica e sul benessere, ma risultati misti sul lavoro. Il vero problema non è soltanto decidere se versare denaro a tutti: è stabilire quanto, a chi, con quali imposte e senza impoverire sanità, scuola, formazione e politiche attive.

La domanda, però, non è più fantascienza: se una quota crescente del valore viene prodotta da modelli, robot e agenti AI, come facciamo a evitare che il reddito resti legato soltanto alla vendita del lavoro umano?

Che cosa propone davvero l’iniziativa europea sul reddito universale

Il punto di partenza è la nuova iniziativa dei cittadini europei sul reddito di base incondizionato. La decisione di esecuzione (UE) 2026/1798 ricostruisce la procedura con precisione: la proposta è stata presentata il 14 maggio 2026, modificata il 16 giugno e registrata dalla Commissione il 7 luglio 2026.

I promotori collegano esplicitamente il reddito di base alla rapida evoluzione di intelligenza artificiale e robotica. Chiedono alla Commissione di usare gli strumenti giuridici disponibili per favorirne l’introduzione negli Stati membri e di formulare una raccomandazione.

Qui serve un evidenziatore rosso. Registrare un’iniziativa non significa approvarne il contenuto. La stessa Commissione precisa che la registrazione non certifica la correttezza fattuale delle affermazioni dei promotori. Significa soltanto che la richiesta, dopo la modifica, rientra nel quadro delle competenze su cui l’Unione può intervenire con orientamenti di politica economica e occupazionale.

Inoltre, una iniziativa dei cittadini europei deve raccogliere almeno un milione di dichiarazioni di sostegno valide e raggiungere soglie minime in almeno sette Paesi. Anche se ci riesce, obbliga la Commissione a esaminarla e rispondere, non ad approvare automaticamente una legge. Quindi l’idea è politicamente concreta, ma istituzionalmente siamo ancora all’inizio del percorso.

Reddito universale, reddito minimo e imposta negativa non sono la stessa cosa

Modello Chi riceve Condizioni Esempio
Reddito universale di base Tutti gli individui della platea prevista Nessuna prova dei mezzi e nessun obbligo di lavorare Un importo mensile uguale per tutti
Reddito minimo garantito Persone o famiglie sotto una soglia Verifica del reddito, talvolta altri requisiti Sostegno mirato contro la povertà
Imposta negativa sul reddito Chi guadagna meno di una soglia fiscale Il trasferimento diminuisce quando il reddito cresce Credito fiscale rimborsabile
Dividendo sociale o dell’AI Tutti, oppure una platea ampia Legato ai rendimenti di un fondo o a entrate specifiche Distribuzione di una quota dei profitti o dei beni comuni

Queste differenze non sono accademiche. Un assegno di 200 euro che si aggiunge al welfare è una cosa. Un reddito di 1.000 euro che sostituisce pensioni, sussidi e servizi è un’altra. Chiamare entrambe le cose UBI rende il dibattito più rumoroso e meno utile.

Esiste davvero una crisi occupazionale causata dall’intelligenza artificiale?

La risposta onesta, oggi, è: vediamo segnali seri di trasformazione e alcuni danni concentrati, ma non abbiamo ancora la prova di una disoccupazione tecnologica di massa.

Il rapporto 2025 dell’International Labour Organization stima che un lavoratore su quattro si trovi in un’occupazione con un certo grado di esposizione alla GenAI. Solo il 3,3% dell’occupazione globale ricade però nella categoria di esposizione più alta. La conclusione dell’ILO è importante: nella maggior parte dei casi è più probabile la trasformazione del lavoro rispetto alla cancellazione completa della professione.

Negli Stati Uniti è emerso un segnale più inquietante. La revisione dell’agosto 2026 del working paper Canaries in the Coal Mine? dello Stanford Digital Economy Lab, basata su dati amministrativi delle buste paga, stima che l’occupazione dei lavoratori di 22-25 anni nelle professioni esposte all’AI sia del 19% inferiore al livello che avrebbe raggiunto mantenendo il passo dei coetanei meno esposti. La distanza nasce soprattutto da minori assunzioni e si concentra nei lavori in cui l’AI sostituisce compiti umani. Gli autori, però, non trovano uno spiazzamento diffuso nell’intera economia e definiscono i risultati indicatori descrittivi iniziali, non stime causali definitive.

Non bisogna commettere due errori opposti:

  • trasformare l’esposizione teorica in licenziamenti già avvenuti;
  • ignorare i primi effetti perché il tasso generale di disoccupazione non è esploso.

Il problema potrebbe presentarsi non come una fila improvvisa di milioni di disoccupati, ma come meno assunzioni junior, carriere d’ingresso più strette, salari polarizzati e potere contrattuale spostato verso chi possiede capitale, dati e modelli. Chi vuole capire la tecnologia senza trattarla come un’unica scatola nera può approfondire anche le differenze tra deep learning e apprendimento per rinforzo.

Il dibattito non nasce con ChatGPT: da Thomas Paine a Martin Luther King

L’idea di separare almeno una parte del reddito dal lavoro salariato attraversa più di due secoli.

Thomas Paine: la ricchezza naturale appartiene anche alla comunità

Nel 1797, in Agrarian Justice, Thomas Paine propose un fondo finanziato attraverso la proprietà fondiaria per corrispondere una dotazione ai giovani e una rendita agli anziani. Non era ancora il reddito universale moderno, ma conteneva un’intuizione decisiva: se qualcuno si appropria in modo esclusivo di una risorsa comune, una parte del valore dovrebbe tornare a tutti.

Bertrand Russell: meno culto del lavoro, più tempo umano

In Elogio dell’ozio, Bertrand Russell attaccava l’idea morale per cui lavorare molte ore sarebbe sempre virtuoso. Se la tecnologia aumenta la produttività, sosteneva, il guadagno dovrebbe tradursi anche in più tempo libero. È una domanda ancora attuale: se l’AI fa in dieci minuti ciò che richiedeva tre ore, il dividendo diventa soltanto margine per l’impresa o anche tempo restituito alle persone?

Martin Luther King Jr.: combattere direttamente la mancanza di reddito

Nel 1967, in Where Do We Go from Here: Chaos or Community?, Martin Luther King Jr. sostenne la garanzia di un reddito come via diretta contro la povertà. Il suo argomento resta potente: molte politiche tentano di curare separatamente casa, istruzione e salute, ma una parte di quei problemi nasce dall’insufficienza di denaro.

Philippe Van Parijs: la libertà deve essere reale

Il filosofo politico Philippe Van Parijs ha costruito una delle difese più sistematiche del reddito di base. La libertà formale non basta se una persona non dispone delle risorse minime per rifiutare un lavoro degradante, studiare, assistere un familiare o avviare un progetto. Il reddito di base diventa così un’infrastruttura di libertà reale, non un premio all’inattività.

L’obiezione repubblicana: perché pagare chi sceglie di non contribuire?

La critica filosofica più dura riguarda la reciprocità. Se la cooperazione sociale produce risorse, è giusto che ne benefici anche chi potrebbe contribuire e decide di non farlo? Il famoso caso dei surfisti di Malibu associato al dibattito su John Rawls riassume il problema. Una società equa deve proteggere chi non può lavorare, ma deve anche decidere che cosa chiedere a chi può farlo.

Qui non esiste una soluzione tecnica neutrale. Reddito universale significa scegliere quale rapporto vogliamo tra libertà, merito, bisogno, cura e partecipazione sociale.

Negli Stati Uniti il reddito di base è discusso da decenni

Gli Stati Uniti sono un laboratorio strano: diffidano del welfare universale, ma hanno prodotto alcune delle proposte e sperimentazioni più influenti.

  • Milton Friedman sostenne l’imposta negativa sul reddito, una soluzione di mercato per sostituire programmi assistenziali frammentati con un trasferimento semplice.
  • Richard Nixon presentò nel 1969 il Family Assistance Plan, una forma di reddito minimo per famiglie con figli. Passò alla Camera ma non divenne legge.
  • L’Alaska Permanent Fund Dividend distribuisce dal 1982 ai residenti idonei un dividendo annuale legato ai rendimenti della ricchezza petrolifera. Non permette di vivere senza lavorare, ma dimostra che un dividendo universale finanziato da una risorsa comune può durare nel tempo.
  • Andrew Yang, durante le primarie democratiche del 2020, portò nel dibattito nazionale il Freedom Dividend da 1.000 dollari al mese, motivandolo soprattutto con automazione e intelligenza artificiale.
  • Sam Altman ha proposto un fondo di equità nazionale alimentato da imposte sul valore delle aziende e della terra, con dividendi distribuiti ai cittadini. È l’idea del reddito non come assistenza, ma come quota di proprietà dell’economia automatizzata.

Negli USA la proposta unisce famiglie politiche lontane. A sinistra piace perché riduce povertà e precarietà. Ad alcuni libertari piace perché semplifica la burocrazia e amplia la libertà individuale. Ma la coalizione si rompe su una domanda: il reddito universale deve aggiungersi ai servizi oppure sostituirli?

Che cosa ci dicono gli esperimenti

Esperimento Disegno Risultato utile Limite
OpenResearch, USA Circa 1.000 persone a basso reddito hanno ricevuto 1.000 dollari al mese per tre anni; il gruppo di controllo 50 dollari Più flessibilità e spesa per bisogni essenziali; riduzione modesta della partecipazione e delle ore lavorate Trasferimento temporaneo e campione a basso reddito, non intera popolazione
Stockton SEED 125 residenti hanno ricevuto 500 dollari al mese per due anni Migliore stabilità finanziaria e benessere; nel primo anno aumentò anche l’occupazione a tempo pieno Campione piccolo e programma filantropico
Alaska Dividendo annuale universale finanziato da un fondo sovrano Lo studio pubblicato sull’American Economic Journal: Economic Policy non rileva una diminuzione dell’occupazione complessiva e osserva più part-time Importo variabile e insufficiente per essere un reddito di sussistenza
Finlandia 2.000 disoccupati hanno ricevuto 560 euro al mese nel 2017-2018 Migliore benessere percepito e sicurezza economica, effetti occupazionali contenuti Non era universale: riguardava persone già disoccupate

Lo studio più ampio negli Stati Uniti, coordinato da OpenResearch, è particolarmente istruttivo. Il paper sugli effetti occupazionali ha osservato una riduzione di circa 2 punti percentuali nella partecipazione al mercato del lavoro e di 1,3-1,4 ore lavorate a settimana. Non è il crollo della voglia di lavorare annunciato dai critici, ma non è nemmeno un effetto nullo.

Questa è la lezione generale: il denaro incondizionato cambia le scelte, ma non le cambia tutte nella stessa direzione. Qualcuno lavora un po’ meno, qualcuno cerca un impiego migliore, qualcuno studia, cura un figlio, affronta una spesa sanitaria o apre una microattività. Valutare soltanto le ore lavorate significa confondere il mercato del lavoro con l’intera vita.

I principali argomenti a favore del reddito universale nell’era dell’AI

  1. Assicura la transizione. Un impiegato amministrativo può frequentare un corso di sei mesi senza accettare il primo lavoro disponibile per pagare l’affitto.
  2. Riduce la trappola dei sussidi. Se il trasferimento non sparisce appena si guadagna un euro in più, accettare un incarico breve o avviare un’attività diventa meno rischioso.
  3. Riconosce lavoro non pagato. Cura familiare, volontariato e formazione producono valore sociale anche quando non generano una busta paga.
  4. Aumenta il potere contrattuale. Chi dispone di una base economica può rifiutare condizioni abusive e negoziare meglio.
  5. Distribuisce il dividendo tecnologico. Se l’AI è stata costruita anche su ricerca pubblica, infrastrutture, dati e conoscenza collettiva, una quota dei rendimenti può tornare alla collettività.
  6. Semplifica una parte della burocrazia. Un trasferimento automatico riduce controlli, stigma ed errori di esclusione.

Le obiezioni più serie, non le caricature

  1. Il costo lordo è enorme. In un Paese con 50 milioni di adulti, 500 euro al mese equivalgono a 300 miliardi di euro l’anno. Il costo netto può essere molto inferiore grazie a imposte e sostituzione di alcune prestazioni, ma la scala resta gigantesca.
  2. Pagare anche i ricchi sembra uno spreco. I sostenitori rispondono che l’universalità elimina stigma e burocrazia e che il fisco recupera il trasferimento dai redditi alti. Funziona solo se il sistema fiscale è davvero progressivo.
  3. Può indebolire alcuni incentivi al lavoro. L’evidenza non mostra una fuga generalizzata dal lavoro, ma riduzioni moderate esistono e variano in base all’importo e al disegno.
  4. Rischia di diventare un cavallo di Troia. Se 500 euro sostituiscono sanità, scuola, disabilità e casa, il risultato può essere meno protezione, non più libertà.
  5. Non risolve l’offerta. Se mancano abitazioni, medici o asili, più denaro può aumentare prezzi e rendite senza creare i servizi mancanti.
  6. Può socializzare i costi e privatizzare i profitti. Le imprese automatizzano, i proprietari incassano e lo Stato paga il reddito con le imposte sul lavoro residuo: sarebbe il contrario di un dividendo tecnologico.

Il Fondo Monetario Internazionale sintetizza bene il triangolo dei compromessi: copertura, generosità e sostenibilità fiscale. Non possiamo massimizzare contemporaneamente tutte e tre senza indicare entrate nuove o tagli altrove.

Come si potrebbe finanziare un reddito universale legato all’AI

Illustrazione del valore prodotto dall'intelligenza artificiale che alimenta un fondo pubblico, i servizi e un dividendo ai cittadini

Dire “tassiamo i robot” è una buona battuta e una cattiva base imponibile. Che cos’è un robot? Un braccio industriale, un software, un agente AI, una licenza cloud? Una politica credibile dovrebbe combinare più fonti:

  • fiscalità generale progressiva, perché il reddito di base è parte del patto sociale e non una tassa punitiva su una singola tecnologia;
  • tassazione effettiva delle rendite e dei profitti straordinari, evitando che la mobilità internazionale delle imprese svuoti la base fiscale;
  • fondo sovrano o fondo sociale che possieda quote diversificate dell’economia e distribuisca una parte dei rendimenti, sul modello concettuale dell’Alaska;
  • dividendo sui beni comuni digitali, collegato all’uso commerciale di dati, ricerca pubblica, spettro e infrastrutture;
  • carbon dividend, restituendo ai cittadini parte delle entrate da prezzi e aste sulle emissioni;
  • riordino selettivo dei trasferimenti monetari, senza eliminare servizi e protezioni legate a bisogni specifici.

La proposta più interessante non è il sussidio pagato dai lavoratori, ma la proprietà diffusa di una piccola quota del capitale automatizzato. Se la produttività dell’AI cresce, cresce anche il fondo che paga il dividendo. In questo modo i cittadini non ricevono l’elemosina dei vincitori: possiedono una frazione del motore economico.

Cinque esempi concreti di che cosa cambierebbe

1. La segretaria amministrativa che vede automatizzato metà del lavoro

Un reddito di base parziale non le garantisce una nuova professione, ma le consente di ridurre l’orario e formarsi su controllo dei processi, relazione con il cliente e supervisione dell’AI.

2. Il giovane programmatore che non trova più il primo impiego

Il rischio segnalato dai dati statunitensi riguarda proprio l’ingresso. Il trasferimento può finanziare un apprendistato, un progetto open source o sei mesi di ricerca. Ma deve essere accompagnato da percorsi che ricostruiscano il ponte tra formazione e lavoro.

3. L’artigiano che usa agenti AI

L’AI gli fa risparmiare dieci ore alla settimana tra preventivi, email e documenti. Il dividendo non serve a sostituirlo: serve a distribuire una parte dei guadagni di produttività anche a chi opera in mercati dove quei guadagni non si trasformano subito in salari più alti.

4. La caregiver familiare

Non perde il lavoro a causa dell’AI, perché il suo lavoro non era pagato nemmeno prima. Un reddito individuale riconosce almeno in parte il valore della cura e riduce la dipendenza economica dal nucleo familiare.

5. Il lavoratore di una fabbrica automatizzata

Se la produzione aumenta con meno addetti, il reddito universale può attutire la transizione. Ma senza partecipazione agli utili, contrattazione, formazione e investimenti territoriali, rischia di essere soltanto il cerotto applicato dopo la chiusura.

Quanto è concreta, allora, l’idea?

La mia valutazione è questa:

  • Molto concreta come esperimento e reddito garantito mirato. Esistono decine di programmi, dati e strumenti amministrativi.
  • Concreta come dividendo parziale. L’Alaska dimostra che un pagamento universale finanziato da un fondo può sopravvivere per decenni.
  • Politicamente possibile come credito fiscale o reddito minimo semplificato. È più vicino ai sistemi esistenti e costa meno di un UBI pieno.
  • Ancora poco concreta come reddito europeo sufficiente per vivere. L’iniziativa non specifica importo, base imponibile, rapporto con il welfare e ripartizione delle competenze tra UE e Stati.
  • Urgente come domanda distributiva. Anche senza disoccupazione di massa, l’AI può concentrare reddito e potere. Aspettare la catastrofe occupazionale per discutere le regole sarebbe irresponsabile.

La posizione più ragionevole non è “reddito universale subito” né “non servirà mai”. È progettare ora sperimentazioni più lunghe e ampie, conti trasparenti e meccanismi di finanziamento legati al capitale, misurando occupazione, salute, istruzione, imprenditorialità, prezzi e potere contrattuale.

Tre video per capire il dibattito

Reddito universale spiegato in modo visuale

Il video di Kurzgesagt presenta in modo accessibile definizione, vantaggi, costi e obiezioni. È un buon punto di partenza, non una conclusione.

Rutger Bregman: la povertà è mancanza di denaro

La tesi favorevole ai trasferimenti incondizionati è esposta con efficacia. Va poi confrontata con costi, disegno fiscale e risultati degli esperimenti.

Il lavoro nell’era dell’intelligenza artificiale

Il documentario di PBS FRONTLINE mostra perché automazione, produttività e lavoro devono essere discussi insieme, prima che la redistribuzione diventi una misura d’emergenza.

Domande frequenti

Il reddito universale è già stato approvato dall’Unione europea?

No. La Commissione ha registrato un’iniziativa dei cittadini europei. La registrazione permette la raccolta dei sostegni e apre un percorso politico, ma non crea un diritto al pagamento e non obbliga l’UE ad approvare una legge.

L’intelligenza artificiale sta già eliminando milioni di posti?

Non esiste ancora una prova di disoccupazione tecnologica di massa. Esistono però segnali di contrazione in alcune occupazioni e fasce d’età, insieme a un’ampia trasformazione dei compiti. L’esposizione all’AI non equivale automaticamente alla perdita del posto.

Con il reddito universale le persone smettono di lavorare?

Gli studi non mostrano un abbandono generalizzato del lavoro. Alcuni rilevano riduzioni moderate della partecipazione o delle ore, altri nessun effetto sull’occupazione complessiva. Contano importo, durata, platea e condizioni economiche.

Il reddito universale sostituirebbe pensioni, sanità e scuola?

Non necessariamente. È una scelta politica. Un modello può aggiungere una base monetaria e mantenere i servizi; un altro può sostituire alcune prestazioni. La seconda opzione è anche la più rischiosa per persone con disabilità, malattie o bisogni elevati.

Qual è la soluzione più realistica nel breve periodo?

Un reddito di base parziale o un credito fiscale rimborsabile, accompagnato da servizi pubblici, formazione, assicurazione salariale e un fondo sociale alimentato anche dai rendimenti dell’economia automatizzata.

Conclusione: non chiediamoci soltanto se lavoreremo

Il reddito universale non è una bacchetta magica e l’AI non è ancora una macchina che ha cancellato il lavoro. Ma la domanda posta dall’iniziativa europea è corretta: in un’economia in cui il contributo del lavoro umano può diminuire in molti processi, il diritto a vivere deve dipendere interamente dalla capacità di vendere ore sul mercato?

La risposta non può essere un assegno senza politica industriale, formazione o servizi. Ma neppure la solita promessa che nasceranno nuovi lavori e che tutti, in qualche modo, si adatteranno. La proposta più solida combina quattro elementi: reddito di base parziale, servizi universali, diritto alla formazione permanente e proprietà collettiva di una quota del capitale tecnologico.

Altrimenti rischiamo il paradosso perfetto: macchine sempre più produttive, società sempre più ricche e persone sempre più spaventate. Non sarebbe un fallimento dell’intelligenza artificiale. Sarebbe un fallimento delle nostre istituzioni.

Fonti principali

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email