Le truffe legate a ChatGPT non sono truffe commesse dal chatbot. Sono frodi che sfruttano il nome, la popolarità o l’aspetto di ChatGPT per rubare credenziali, denaro e dati personali. In altri casi, i criminali usano l’intelligenza artificiale generativa per creare messaggi, immagini, voci e video più credibili.

Il punto è proprio questo: oggi una truffa può essere scritta in un italiano perfetto, avere una grafica professionale e perfino parlare con la voce di una persona che conosciamo. Il vecchio consiglio “guarda se ci sono errori grammaticali” non basta più.

Che cosa sono le truffe ChatGPT?

Con l’espressione truffe ChatGPT si indicano principalmente due fenomeni:

  • falsi siti, app, email o servizi che si presentano come ChatGPT o OpenAI;
  • frodi tradizionali rese più persuasive dall’AI generativa, come phishing, falsi investimenti, clonazione vocale e impersonificazione.

L’FBI, tramite l’Internet Crime Complaint Center, ha segnalato che i criminali utilizzano testi generati dall’AI per rendere più credibili campagne di social engineering, spear phishing e frodi finanziarie. Le immagini artificiali possono creare profili falsi e documenti contraffatti, mentre audio e video sintetici possono imitare familiari, dirigenti o personaggi pubblici.

Le 7 truffe più comuni legate a ChatGPT

1. Il falso sito di ChatGPT

Il dominio assomiglia a quello autentico, la pagina riproduce colori e interfaccia del servizio e invita ad accedere. In realtà, username e password finiscono nelle mani del truffatore. La regola più semplice è digitare direttamente l’indirizzo ufficiale o usare l’app scaricata dai canali indicati da OpenAI.

2. L’app gratuita che installa malware

“ChatGPT Pro gratis”, “ChatGPT senza limiti” o “nuova versione premium sbloccata” sono esche efficaci. Il file da installare può contenere software malevolo, rubare password salvate nel browser oppure attivare abbonamenti indesiderati. Se un’offerta sembra troppo generosa, probabilmente il prodotto sei tu. O, peggio, lo è il tuo conto corrente.

3. La falsa email sul rinnovo dell’abbonamento

Il messaggio annuncia un pagamento rifiutato, la sospensione dell’account o un rimborso urgente. Il pulsante conduce a una pagina contraffatta che chiede carta di credito e credenziali. Non usare il collegamento ricevuto: entra nel tuo account attraverso il sito ufficiale e controlla lì lo stato del piano.

4. Il finto supporto tecnico

Qualcuno si presenta come “assistenza ChatGPT”, magari dopo un commento pubblicato sui social, e propone di recuperare l’account o risolvere un blocco. Chiede accesso remoto al computer, un codice di verifica o un pagamento. Un tecnico autentico non ha bisogno della tua password né del codice temporaneo ricevuto sul telefono.

5. Il metodo di investimento “creato da ChatGPT”

Una pubblicità promette guadagni automatici grazie a un algoritmo segreto, spesso accompagnata da recensioni inventate o da un video manipolato di un personaggio famoso. ChatGPT diventa un bollino di autorevolezza applicato a un investimento che non offre garanzie verificabili. L’AI non trasforma una promessa di rendimento facile in un investimento affidabile.

6. La truffa con voce clonata

Una telefonata o un messaggio vocale sembra provenire da un figlio, un collega o dal titolare dell’azienda. C’è sempre un’emergenza: un incidente, un pagamento da effettuare subito, una password da comunicare. La voce può essere sintetizzata partendo da pochi secondi di audio pubblico. In famiglia e in azienda conviene concordare una parola segreta e richiamare la persona usando un numero già conosciuto.

7. Il finto esperto che vende prompt miracolosi

Non ogni corso mediocre è una truffa, naturalmente. Il confine viene superato quando si promettono risultati garantiti, certificazioni inesistenti, accessi privilegiati a OpenAI o formule che produrrebbero automaticamente reddito. I prompt possono migliorare il lavoro, non abolire competenze, responsabilità e fatica.

Come riconoscere una truffa ChatGPT in 30 secondi

  • Controlla l’indirizzo completo: non fidarti soltanto di logo e grafica.
  • Diffida dell’urgenza: scadenze immediate e minacce servono a impedirti di ragionare.
  • Non comunicare codici temporanei: password, OTP e codici di recupero non vanno condivisi.
  • Verifica su un secondo canale: richiama la persona o apri il sito ufficiale senza usare il link ricevuto.
  • Controlla la promessa: guadagni certi, versioni “segrete” e accessi gratuiti illimitati sono segnali d’allarme.
  • Fermati prima di pagare: una pausa di due minuti può evitare un danno di migliaia di euro.

Il National Cyber Security Centre britannico ricorda che il phishing può arrivare tramite email, SMS, siti, telefonate e pubblicità. Cloudflare suggerisce di controllare con attenzione l’URL e, in caso di dubbio, contattare direttamente il soggetto che avrebbe inviato il messaggio.

Che cosa fare se hai già cliccato o pagato

  1. Interrompi subito ogni contatto con il presunto operatore.
  2. Se hai inserito credenziali, cambia la password da un dispositivo affidabile e non riutilizzare quella vecchia.
  3. Attiva l’autenticazione a più fattori e chiudi le sessioni che non riconosci.
  4. Se hai fornito dati bancari, contatta immediatamente banca o gestore della carta.
  5. Conserva email, numeri, ricevute, indirizzi web e schermate come prove.
  6. Segnala l’accaduto alla Polizia Postale o alle autorità competenti.

OpenAI pubblica una guida specifica su come proteggere l’account e una procedura per chi nota attività non riconosciute. Per le frodi in generale, la Federal Trade Commission mette a disposizione un portale di segnalazione. In Italia il riferimento operativo resta la Polizia Postale.

ChatGPT rende davvero le truffe più pericolose?

Sì, ma non perché l’AI abbia inventato l’inganno. Lo rende più economico, veloce e scalabile. Un criminale può produrre centinaia di messaggi personalizzati, tradurli bene e creare identità digitali plausibili. Europol ha evidenziato il potenziale uso illecito dei grandi modelli linguistici per frodi, impersonificazione e cybercrime.

La conseguenza pratica è scomoda: un testo perfetto non è più una prova di autenticità. Dobbiamo spostare l’attenzione dalla qualità del messaggio alla verifica della fonte, del canale e della richiesta.

Domande frequenti sulle truffe ChatGPT

ChatGPT può chiedermi la password via email?

No. Non comunicare mai password o codici di autenticazione tramite email, chat, telefono o messaggi social.

Come verifico se un’app ChatGPT è autentica?

Parti dal sito ufficiale di OpenAI dedicato al download e controlla sviluppatore, dominio e permessi richiesti.

Una voce perfettamente identica è una prova?

No. La clonazione vocale rende possibile imitare una persona. Interrompi la chiamata e richiamala su un numero che possiedi già.

ChatGPT garantisce investimenti o guadagni?

No. Diffida di chi usa il nome di ChatGPT per promettere rendimenti certi, trading automatico infallibile o reddito senza rischio.

La difesa migliore resta molto umana

La tecnologia cambia, il meccanismo psicologico rimane: paura, urgenza, avidità, autorità. Le truffe funzionano quando ci costringono a reagire prima di verificare. La contromisura non è diventare esperti di deepfake. È costruire una piccola abitudine: fermarsi, controllare e chiedere conferma attraverso un canale indipendente.

Vuoi formare dipendenti, collaboratori o cittadini a un uso più sicuro e consapevole dell’intelligenza artificiale? Contattami per progettare un intervento su AI generativa, comunicazione digitale e prevenzione delle frodi.

Scegliere il corso di laurea nell’era dell’intelligenza artificiale non è mai stato così complicato. Qualche settimana fa, a fine lezione, uno studente mi ha fatto la domanda che temevo da mesi: “Prof, ma se l’AI impara tutto quello che studio io, che senso ha laurearsi?”. Ho fatto una pausa teatrale (trucco da formatore: quando non hai la risposta pronta, prendi tempo con eleganza). Poi ho risposto con un’altra domanda: “Tu all’università cosa vai a prendere: nozioni o una testa?”.

Questo articolo nasce da lì. E da un pezzo uscito su 24+ del Sole 24 Ore, firmato da Luca Mari e Cristiano Sacchi, che mette nero su bianco un problema enorme: il metodo con cui abbiamo sempre scelto il corso di laurea nell’era dell’intelligenza artificiale ha smesso di funzionare.

La risposta breve

Se hai fretta, eccola: nell’era dell’intelligenza artificiale il criterio migliore per scegliere un corso di laurea non è più “quale lavoro sarà richiesto tra 5 anni” (previsione ormai inaffidabile), ma “quale percorso mi insegna un metodo per produrre, valutare e comunicare conoscenza”. In breve: scegli il corso che ti costruisce la mente più adattabile, non quello che promette il posto più sicuro.

Ora ti spiego perché. Con i dati.

Corso di laurea e intelligenza artificiale: il vecchio metodo di scelta

Per decenni il ragionamento è stato questo: guardo i dati di AlmaLaurea e dell’ISTAT sull’occupazione dei laureati, incrocio le mie inclinazioni con gli sbocchi professionali, scelgo. Un metodo sensato, che però si regge su due presupposti:

  • che il mercato del lavoro cambi abbastanza lentamente da rendere affidabile una previsione a 5-6 anni, il tempo di una laurea magistrale;
  • che le competenze imparate all’università restino rilevanti per buona parte della carriera.

Fino a ieri funzionava. Quando mi sono iscritto a Scienze Politiche (nel secolo scorso, tecnicamente), nessuno immaginava che il mio lavoro di giornalista cartaceo sarebbe evaporato nel giro di quindici anni. Eppure il mondo cambiava piano: c’era il tempo di adattarsi.

Oggi no. Oggi entrambi i presupposti scricchiolano.

Il paradosso delle classifiche sui “lavori del futuro”

Facciamo un esempio concreto. Il Future of Jobs Report 2025 del World Economic Forum contiene un paradosso istruttivo:

  • se guardi la crescita percentuale, i lavori che esplodono sono specialisti di AI, big data, sviluppatori software;
  • se guardi i numeri assoluti di nuovi occupati, in cima trovi lavoratori agricoli, autisti, infermieri, insegnanti, addetti all’edilizia.

Le due classifiche non si contraddicono: una professione di nicchia può crescere del 40% e generare comunque meno posti di un mestiere consolidato che cresce del 5%. Ma il punto è un altro: le classifiche sui lavori del futuro dicono quello che vuoi fargli dire, a seconda della variabile che scegli. Come gli oroscopi, ma con più grafici.

E l’AI ha aggiunto la variabile che manda in tilt tutto il modello: non sappiamo se stiamo vivendo una discontinuità radicale del mondo del lavoro o una trasformazione graduale. Mari e Sacchi lo dicono con onestà rara: non è che i dati storici non siano più rilevanti; è che non sappiamo se lo sono. Peggio dell’incertezza sulla risposta c’è solo l’incertezza sulla domanda.

Gli studenti se ne sono già accorti

Un sondaggio Gallup dell’ottobre 2025 su quasi 4.000 studenti universitari americani fotografa la situazione: circa la metà ha preso in considerazione l’idea di cambiare corso di studi per l’impatto dell’AI sul mercato del lavoro. Solo il 30% non ci ha pensato affatto.

Certo, il mercato americano è più dinamico del nostro. Ma quando metà degli studenti di un Paese ripensa il proprio percorso a causa di una tecnologia, non è un’ansia passeggera: è un segnale.

Corso di laurea e intelligenza artificiale: il nuovo criterio di scelta

Qui arriva la parte che mi interessa da formatore. Se l’AI sa già spiegare teorie scientifiche, scrivere codice, analizzare testi e proporre strategie aziendali (con errori, certo, ma con una competenza che cresce ogni semestre), il valore dell’università non può più essere solo il trasferimento di contenuti.

Il valore sta nel metodo: ogni disciplina, oltre ai contenuti, ti installa un sistema operativo mentale.

  • La matematica non ti insegna solo a calcolare: ti educa al rigore.
  • Le scienze sperimentali ti insegnano il rapporto tra ipotesi ed evidenze (utile anche per smontare le bufale su WhatsApp, fidati).
  • Il diritto ti abitua a ragionare per principi e interpretazioni.
  • La storia ti insegna che il contesto conta più del singolo evento.
  • La filosofia ti allena a capire quali domande meritano di essere poste. Che poi è l’abilità numero uno di chi lavora con l’AI: io la chiamo la cassetta degli attrezzi del prompt, i filosofi la chiamavano dialettica (avevano ragione loro, con duemila anni di anticipo).

Attenzione: questo non significa che le famose soft skill battano le competenze disciplinari. Significa che il metodo si impara solo attraverso i contenuti, sporcandosi le mani con problemi veri. Non esiste un corso di “pensiero critico” in pillole: esiste il pensiero critico che ti resta addosso dopo tre anni di analisi matematica o di esegesi delle fonti.

Se ti interessa il tema, ho scritto anche di come l’intelligenza artificiale possa darci l’illusione di sapere e di chi controlla davvero gli agenti AI: due approfondimenti utili per capire dove serve ancora il pensiero critico umano.

Corso di laurea e intelligenza artificiale: le 5 domande da fare agli open day

Andiamo sul concreto. Se tu (o tuo figlio, o tua figlia) state scegliendo l’università, agli open day non chiedere solo “quali sbocchi professionali ha questo corso”. Chiedi anche:

  1. Come si studia qui? Lezioni frontali e nozioni da ripetere, o progetti, laboratori, problemi aperti? Il secondo modello allena l’adattabilità.
  2. Come viene usata l’AI nel corso? Se la risposta è “la vietiamo”, diffida. Se è “la integriamo e ti insegniamo a valutarne gli output”, sei nel posto giusto.
  3. Quanto spazio c’è per l’errore? I percorsi che ti fanno sbagliare in ambiente protetto insegnano a convivere con l’incertezza. Quelli che premiano solo la risposta esatta preparano a un mondo che non esiste più.
  4. Che tipo di domande fanno gli esami? Domande a risposta chiusa misurano la memoria (dove l’AI ti batte già). Domande aperte misurano il ragionamento.
  5. Cosa fanno i laureati dopo 5 anni, non dopo 1? Il primo impiego dice poco; la traiettoria dice tutto.

E resta valida la domanda di sempre, quella sulle inclinazioni personali. Solo che oggi va integrata con una più profonda, suggerita proprio da Mari e Sacchi: che genere di mente voglio costruirmi?

La prossima volta che qualcuno ti chiede “cosa devo studiare per non farmi rubare il lavoro dall’AI?”, giragli questo articolo. E poi fagli la domanda che ho fatto al mio studente: all’università vai a prendere nozioni o una testa?

Corso di laurea e intelligenza artificiale: domande frequenti (FAQ)

L’intelligenza artificiale rende inutile la laurea?

No. Restano ambiti, come medicina, architettura e ingegneria, in cui la formazione specialistica è la base della responsabilità professionale che la società non è disposta a delegare alle macchine. Cambia però il valore aggiunto della laurea: sempre meno accumulo di nozioni, sempre più metodo di ragionamento.

Quali lauree sono più al riparo dall’AI?

Nessuna classifica è affidabile: le previsioni dipendono dalle variabili scelte (orizzonte temporale, area geografica, scenari tecnologici). Il Future of Jobs Report 2025 del WEF mostra che le classifiche cambiano radicalmente se misuri la crescita in percentuale o in posti di lavoro assoluti.

Conviene scegliere una laurea STEM per colpa dell’AI?

Non per forza. Le discipline umanistiche allenano capacità che l’AI rende più preziose: porre le domande giuste, valutare argomenti, distinguere il plausibile dal convincente. La scelta migliore resta il percorso che unisce le tue inclinazioni a un metodo di apprendimento attivo.

Gli studenti stanno cambiando facoltà per l’AI?

Negli Stati Uniti circa la metà degli studenti universitari ha considerato di cambiare percorso per l’impatto dell’AI sul lavoro (sondaggio Gallup, ottobre 2025, su quasi 4.000 studenti).

Il nuovo petrolio non si trova sottoterra. Si trova online.

È fatto di informazioni pubbliche, documenti, immagini, profili social, siti aziendali,
metadati, registri, annunci di lavoro e piccoli indizi digitali che, presi singolarmente,
sembrano insignificanti.

Il valore emerge quando qualcuno riesce a raccoglierli, collegarli, interpretarli e
trasformarli in conoscenza.

È questo il tema della puntata di Chiedilo all’Esperto, il format di
Byteway dedicato alla tecnologia, alla cybersecurity e al mondo
digitale, alla quale ho partecipato insieme a
Gianluca Boccacci.

Il punto di partenza della conversazione è stato il libro che abbiamo scritto insieme:

Il nuovo petrolio (online). OSINT e intelligenza artificiale: a caccia di dati pubblici nell’era dei chatbot
.

In sintesi: oggi il problema non è trovare informazioni.
Il problema è capire quali siano affidabili, come collegarle e che cosa farne.
L’intelligenza artificiale accelera il lavoro, ma non elimina la necessità di metodo,
verifica e pensiero critico.

Guarda l’intervista completa

Nel video parliamo di informazioni pubbliche, ricerca online, AI, sicurezza,
offensive security e delle nuove opportunità che le tecnologie digitali offrono
alle persone e alle imprese.

Che cosa significa davvero OSINT?

OSINT è l’acronimo di Open Source Intelligence, cioè intelligence ricavata
da fonti aperte.

Detta così sembra una disciplina riservata ad analisti, investigatori ed esperti di
sicurezza. In realtà riguarda sempre più spesso anche aziende, professionisti,
giornalisti, comunicatori, ricercatori e responsabili delle risorse umane.

Fare OSINT non significa semplicemente cercare un nome su Google.
Significa seguire un processo:

  • definire una domanda di ricerca;
  • individuare le fonti utili;
  • raccogliere le informazioni disponibili pubblicamente;
  • valutarne attendibilità, provenienza e aggiornamento;
  • confrontare dati provenienti da fonti diverse;
  • trasformare gli indizi in una conclusione ragionata;
  • documentare il percorso seguito.

La differenza tra una normale ricerca online e un’attività OSINT sta soprattutto
nel metodo.

Le informazioni, infatti, non diventano automaticamente conoscenza solo perché
sono accessibili. Servono contesto, verifica e capacità di collegamento.

Perché le informazioni sono il nuovo petrolio digitale

Per molti anni abbiamo ripetuto che “i dati sono il nuovo petrolio”.
È una metafora efficace, ma incompleta.

Il petrolio greggio, da solo, serve a poco. Deve essere estratto, lavorato,
raffinato e trasformato.

Lo stesso vale per i dati.

Un elenco di informazioni non genera necessariamente valore.
Il valore nasce dalla capacità di:

  • selezionare ciò che conta;
  • eliminare il rumore;
  • riconoscere schemi e relazioni;
  • individuare anomalie e contraddizioni;
  • produrre una conoscenza utilizzabile per decidere.

Questo è uno degli aspetti centrali affrontati nell’intervista:
non vince chi possiede più dati, ma chi sa porre le domande migliori e
interpretare correttamente le risposte.

Che cosa cambia con l’intelligenza artificiale

L’intelligenza artificiale generativa ha cambiato profondamente il lavoro sulle
informazioni.

Un chatbot può aiutare a sintetizzare documenti, confrontare testi, costruire
cronologie, estrarre entità, organizzare appunti, individuare incongruenze e
formulare nuove ipotesi di ricerca.

In altre parole, l’AI può rendere interrogabile una grande quantità di materiale
che prima sarebbe stato difficile analizzare manualmente.

Ma qui occorre evitare un equivoco.

L’intelligenza artificiale non trasforma automaticamente una ricerca
mediocre in una buona indagine.

Può velocizzare anche gli errori. Può proporre collegamenti deboli, confondere
persone omonime, utilizzare informazioni non aggiornate o presentare come certo
ciò che è soltanto probabile.

Per questo l’AI deve essere considerata un acceleratore del lavoro analitico,
non un sostituto del giudizio umano.

Il pericolo delle briciole digitali

Durante una giornata normale disseminiamo online una quantità impressionante di
informazioni.

Una fotografia scattata in ufficio può mostrare un badge, un monitor o un documento.
Un annuncio di lavoro può rivelare tecnologie, fornitori e progetti futuri.
Un post pubblicato da un dipendente può anticipare una trasferta, una partnership
o una riorganizzazione.

Ogni elemento, isolato, può sembrare innocuo.

Ma un osservatore competente può unire queste briciole digitali e costruire un
quadro sorprendentemente preciso.

Il rischio non è sempre ciò che pubblichiamo. Spesso è ciò che gli altri possono
dedurre collegando quello che abbiamo pubblicato.

Questo riguarda le persone, ma anche le organizzazioni.

La sicurezza informatica non dipende soltanto da firewall, antivirus e password.
Dipende anche dalla consapevolezza con cui dipendenti, manager e collaboratori
gestiscono le informazioni pubbliche.

OSINT e AI per le aziende: alcuni esempi concreti

L’unione tra OSINT e intelligenza artificiale può essere utilizzata in moltissimi
contesti professionali.

Analisi dei concorrenti

È possibile confrontare siti, comunicati stampa, offerte di lavoro, brevetti,
profili social, bilanci e interventi pubblici per capire come si sta muovendo
un concorrente.

Preparazione di un incontro commerciale

Prima di incontrare un potenziale cliente si possono raccogliere informazioni
pubbliche sull’azienda, sul settore, sui decisori e sui problemi emersi nelle
comunicazioni ufficiali.

Verifica di persone e organizzazioni

Le fonti aperte possono aiutare a controllare la coerenza di un profilo,
verificare esperienze dichiarate e identificare possibili segnali di rischio.
Naturalmente, sempre nel rispetto della legge e senza trasformare la ricerca
in sorveglianza invasiva.

Cybersecurity e prevenzione

Le aziende possono osservare dall’esterno quali informazioni sensibili stanno
esponendo involontariamente: nomi dei sistemi utilizzati, indirizzi email,
documenti dimenticati online, credenziali compromesse o dettagli sulle
infrastrutture.

Giornalismo e verifica delle fonti

Immagini, video, luoghi, date, profili e dichiarazioni possono essere confrontati
per ricostruire un evento e ridurre il rischio di diffondere contenuti falsi
o manipolati.

Reputazione digitale

L’analisi delle fonti pubbliche consente di capire come un’organizzazione viene
raccontata online, quali temi le vengono associati e dove stanno emergendo
criticità reputazionali.

La domanda non è “che cosa sa Internet di me?”

Una domanda tipica è: “Che cosa sa Internet di me?”.

Ma probabilmente non è la domanda più interessante.

Sarebbe meglio chiedersi:

  • quali informazioni su di me sono accessibili?
  • quali sono ancora aggiornate?
  • quali sono inesatte o fuori contesto?
  • che cosa si può dedurre collegandole?
  • quali informazioni sto esponendo senza rendermene conto?
  • come potrebbero essere usate da un cliente, un concorrente o un attaccante?

Questa è la vera educazione digitale di cui abbiamo bisogno.

Non basta sapere usare gli strumenti. Dobbiamo comprendere le conseguenze
informative delle nostre azioni.

AI e OSINT: servono ancora più spirito critico

Oggi possiamo chiedere a un chatbot di analizzare decine di documenti in pochi
minuti. È una possibilità straordinaria.

Ma più lo strumento diventa potente, più aumentano le responsabilità di chi lo usa.

Occorre verificare le fonti, distinguere i fatti dalle ipotesi, documentare i
passaggi e non confondere una risposta linguisticamente convincente con una
risposta necessariamente vera.

Il rischio più grande non è che l’intelligenza artificiale non sappia qualcosa.

È che risponda bene anche quando sta sbagliando.

Per questo, nel lavoro con OSINT e AI, considero fondamentali cinque regole:

  1. Partire da una domanda precisa.
  2. Usare più fonti indipendenti.
  3. Separare i fatti dalle interpretazioni.
  4. Verificare manualmente le conclusioni importanti.
  5. Rispettare privacy, legge ed etica.

Il libro “Il nuovo petrolio (online)”

La puntata di Chiedilo all’Esperto prende spunto dal libro
Il nuovo petrolio (online). OSINT e intelligenza artificiale: a caccia di
dati pubblici nell’era dei chatbot
, pubblicato da Ledizioni e scritto
insieme a Gianluca Boccacci.

Nel libro proviamo a spiegare come la ricerca da fonti aperte stia cambiando
nell’epoca dell’intelligenza artificiale generativa.

Non è un manuale per spiare le persone e non è nemmeno un catalogo di strumenti.
È un invito a sviluppare un modo più consapevole e metodico di lavorare con le
informazioni.

Perché tra una montagna di dati e una decisione intelligente c’è ancora qualcosa
che nessun software può garantire automaticamente: il pensiero critico.

Puoi approfondire il contenuto del libro nell’articolo:

OSINT e AI: perché le informazioni pubbliche sono diventate il nuovo petrolio digitale
.

Puoi inoltre consultare la pagina dedicata ai miei

libri ed ebook su intelligenza artificiale e comunicazione digitale
.

Conclusione: il valore è nel metodo

Ringrazio Giuseppe Emanuele e Byteway per
l’invito e per aver creato uno spazio di confronto concreto su tecnologia,
sicurezza e innovazione.

E ringrazio naturalmente Gianluca Boccacci, compagno di questa avventura editoriale
e professionale.

La conclusione della nostra chiacchierata può essere riassunta così:


le informazioni sono ovunque, gli strumenti di intelligenza artificiale sono
sempre più accessibili, ma il vero vantaggio competitivo resta la capacità
umana di fare le domande giuste, verificare le risposte e collegare i punti.

Il nuovo petrolio è digitale. Ma, senza una raffineria chiamata metodo,
resta soltanto una massa disordinata di dati.


Domande frequenti su OSINT e intelligenza artificiale

Che cosa significa OSINT?

OSINT significa Open Source Intelligence. Indica la raccolta e l’analisi
sistematica di informazioni provenienti da fonti pubblicamente accessibili,
con l’obiettivo di produrre conoscenza utile e verificabile.

OSINT significa cercare informazioni su Google?

No. Una ricerca su Google può essere uno dei passaggi, ma l’OSINT richiede
un metodo: definizione dell’obiettivo, selezione delle fonti, verifica,
confronto dei dati, analisi e documentazione dei risultati.

Come può essere usata l’intelligenza artificiale nell’OSINT?

L’AI può sintetizzare documenti, estrarre nomi e date, confrontare fonti,
organizzare informazioni, costruire timeline e suggerire collegamenti.
I risultati devono però essere verificati da una persona.

L’OSINT è legale?

La raccolta di informazioni pubbliche non autorizza qualsiasi utilizzo dei dati.
Occorre rispettare privacy, diritto d’autore, condizioni d’uso delle piattaforme,
normativa sulla protezione dei dati e finalità legittime della ricerca.

A che cosa serve l’OSINT in azienda?

Può supportare la cybersecurity, l’analisi dei concorrenti, la verifica delle
fonti, la preparazione commerciale, la gestione della reputazione e
l’individuazione di informazioni esposte involontariamente.

L’intelligenza artificiale può sostituire un analista OSINT?

No. Può velocizzare molte attività, ma non può garantire da sola affidabilità,
corretta interpretazione, rispetto del contesto e valutazione etica dei risultati.


Vuoi portare OSINT e intelligenza artificiale nella tua organizzazione?

Realizzo corsi, workshop e interventi per aziende, enti pubblici,
associazioni e università sull’uso consapevole dell’intelligenza artificiale,
sulla ricerca online e sulla comunicazione digitale.

Possiamo costruire un percorso dedicato alla tua organizzazione, partendo da
casi concreti, documenti reali ed esigenze operative.


Contattami per un corso o un intervento


Immagina di dover scegliere una polizza per la casa. Apri ChatGPT e gli chiedi: «Qual è quella giusta per me?». Il chatbot fa qualche domanda, confronta tre prodotti e propone una classifica. Risposta rapida, linguaggio chiaro, nessun appuntamento da fissare. Sembra la fine dell’intermediario assicurativo.

Non proprio. Un test condotto il 19 marzo 2026 dall’agenzia tedesca di rating Franke und Bornberg, raccontato in Italia da ASSINEWS, mostra un risultato più interessante: ChatGPT può essere un buon primo consigliere digitale, ma non sostituisce una consulenza assicurativa fondata su dati aggiornati, condizioni contrattuali e circostanze personali.

In altre parole, l’intelligenza artificiale può aiutare a capire quali domande fare. Non dovrebbe essere trattata come l’unica voce autorizzata a decidere quale polizza acquistare.

Che cosa ha chiesto Franke und Bornberg a ChatGPT

Il test riguardava una Hausratversicherung, la polizza tedesca che protegge il contenuto dell’abitazione. A ChatGPT è stato chiesto di porre non più di cinque domande, ricostruire il bisogno del cliente e raccomandare fino a tre prodotti.

Con poche informazioni il chatbot ha costruito un profilo plausibile:

  • appartamento di 90 metri quadrati;
  • contenuto di un certo valore;
  • bicicletta del valore superiore a 1.000 euro;
  • attrezzature usate per lavorare da casa;
  • abitazione al piano terra, quindi più esposta al rischio di effrazione;
  • preferenza per un equilibrio tra prezzo, coperture e franchigia.

È un risultato da non liquidare. In cinque passaggi l’AI ha individuato alcuni elementi davvero utili e li ha trasformati in una conversazione comprensibile. È il genere di compito nel quale i modelli linguistici funzionano bene: ordinare le informazioni, far emergere bisogni e tradurre il gergo.

Dove la raccomandazione di ChatGPT ha iniziato a scricchiolare

Il chatbot ha proposto tre prodotti, indicati come A, B e C, motivando la scelta con il rapporto tra prezzo e prestazioni, la copertura della colpa grave, i limiti per i beni di valore e la possibilità di estendere le garanzie.

Quando le analiste Vivian Fiegel e Simone Najderek hanno confrontato la classifica con i rating tecnici e con le condizioni contrattuali, però, sono emerse differenze importanti. Il prodotto A, collocato dall’AI al primo posto, risultava il più debole proprio su aspetti rilevanti per quel cliente. Per esempio, la copertura del furto della bicicletta poteva dipendere da un modulo aggiuntivo. Anche clausole come la rinuncia alla sottoassicurazione e la gestione della colpa grave non erano state pesate abbastanza.

Il problema diventava ancora più evidente sul prezzo. I sinistri pregressi potevano far aumentare sensibilmente il premio del prodotto A, fino a renderlo il più costoso dei tre. ChatGPT non aveva considerato questo effetto, né altri meccanismi individuali di tariffazione e sconto.

Qui c’è la lezione: una risposta può essere ben scritta, ordinata e persino convincente, ma poggiare su un confronto incompleto. È lo stesso rischio che ho descritto parlando di epistemia, cioè dell’illusione di sapere generata dall’AI.

Perché ChatGPT non sostituisce l’intermediario assicurativo

Un modello linguistico pubblico non è, di per sé, un preventivatore certificato, un comparatore completo o un professionista abilitato. Può non avere accesso alle versioni più recenti dei fascicoli informativi, alle regole di sottoscrizione, agli aggiornamenti tariffari e ai criteri interni delle compagnie.

Ci sono almeno cinque limiti pratici.

  1. I dati possono non essere aggiornati. Una clausola o una tariffa può cambiare dopo l’ultimo aggiornamento delle fonti disponibili al modello.
  2. Il bisogno reale richiede domande successive. Cinque quesiti possono orientare, ma non sempre bastano per ricostruire patrimonio, rischi, esclusioni, priorità e capacità di spesa.
  3. Le condizioni contano più del nome del prodotto. Massimali, franchigie, scoperti, esclusioni e garanzie accessorie possono cambiare radicalmente il valore della polizza.
  4. La risposta non è necessariamente riproducibile. Due conversazioni simili possono generare classifiche diverse.
  5. Manca una responsabilità professionale. Il chatbot non conosce la tua vita e non risponde delle conseguenze della scelta come un soggetto abilitato.

In Italia conviene inoltre verificare che impresa e intermediario siano autorizzati. L’IVASS raccomanda di controllare gli Albi e il Registro Unico degli Intermediari, oltre a prestare attenzione a siti irregolari e possibili contraffazioni.

Che cosa può fare bene l’AI nel settore assicurativo

Dire che ChatGPT non sostituisce l’intermediario non significa relegarlo a giocattolo. Significa assegnargli un ruolo più utile e realistico.

L’AI può aiutare il cliente a:

  • preparare una lista delle informazioni da raccogliere prima di un incontro;
  • tradurre in parole semplici termini come franchigia, scoperto, massimale e sottoassicurazione;
  • trasformare un fascicolo informativo in una serie di domande da sottoporre al professionista;
  • mettere in tabella coperture, esclusioni e costi presenti nei documenti forniti;
  • riassumere il colloquio e creare una checklist delle verifiche ancora aperte.

Può aiutare anche l’intermediario: nella preparazione dei colloqui, nella prima classificazione dei documenti e nella produzione di spiegazioni più accessibili. Ma la logica resta quella che propongo anche nella consulenza finanziaria assistita dall’intelligenza artificiale: automazione dove serve velocità, supervisione umana dove servono giudizio e responsabilità.

Un metodo in tre fasi: prima, durante e dopo la consulenza

1. Prima: usa ChatGPT per arrivare preparato

Descrivi la tua situazione senza inserire dati personali non necessari. Chiedi quali informazioni mancano e quali termini devi comprendere. L’obiettivo non è ottenere il nome della polizza «migliore», ma costruire una buona mappa del problema.

2. Durante: porta le domande a un intermediario verificato

Confronta la mappa con i documenti ufficiali e con un professionista iscritto al RUI. Chiedi di spiegare per iscritto differenze, esclusioni, franchigie, massimali, effetto dei sinistri pregressi e condizioni per le garanzie accessorie.

3. Dopo: usa l’AI come secondo lettore, non come arbitro

Fornisci al chatbot soltanto documenti che puoi condividere in sicurezza e chiedi di evidenziare incoerenze o punti da chiarire. Ogni rilievo deve poi essere verificato sul testo contrattuale e con il professionista.

Questo approccio evita due estremi: fidarsi ciecamente dell’algoritmo oppure rinunciare a uno strumento che può renderci clienti più consapevoli.

Un prompt prudente per preparare il colloquio

Agisci come assistente alla preparazione di un colloquio assicurativo, non come intermediario e non come decisore. Non consigliarmi prodotti o compagnie. Fammi una domanda alla volta per aiutarmi a chiarire bisogni, rischi, budget, franchigie accettabili, beni da proteggere e situazioni particolari. Alla fine crea: 1) un riepilogo dei dati forniti; 2) l’elenco delle informazioni mancanti; 3) dieci domande da fare a un intermediario iscritto al RUI; 4) una tabella vuota per confrontare massimali, franchigie, scoperti, esclusioni e garanzie accessorie. Segnala esplicitamente che prezzi e condizioni devono essere verificati sui documenti ufficiali aggiornati.

La differenza la fanno le istruzioni. Nel mio libro ChatGPT, come stai? Il prompt engineering come nuova skill ibrida spiego proprio perché dialogare bene con un’AI non significa semplicemente formulare una domanda elegante: occorre definire ruolo, contesto, limiti, formato dell’output e criteri di verifica.

Il tema non è uomo contro macchina, ma chi controlla che cosa

La discussione sulla sostituzione spesso parte dalla domanda sbagliata. Non dovremmo chiederci soltanto se l’AI prenderà il posto dell’intermediario. Dovremmo chiederci quali compiti delegare, quali dati fornire, quali controlli mantenere e chi risponde quando la raccomandazione è sbagliata.

È una questione di governance. Nell’Opinion del 6 agosto 2025, EIOPA ha richiamato per il settore assicurativo un approccio proporzionato al rischio, capace di bilanciare benefici e pericoli dell’AI. Anche l’AI Act europeo adotta una logica basata sul rischio e punta a sistemi affidabili e centrati sulle persone.

Per chi usa un chatbot, la prima forma di governance è molto concreta: conoscere la fonte, controllare la data, leggere il documento originale e distinguere una spiegazione da una raccomandazione professionale. È lo stesso allenamento alla verifica che attraversa il mio Manuale per difendersi dalla Post Verità: una risposta plausibile non diventa vera solo perché è fluida e rassicurante.

Come cambia il lavoro dell’intermediario

Se il chatbot sa già spiegare che cos’è una franchigia, il valore dell’intermediario si sposta verso attività più profonde: fare domande che il cliente non aveva immaginato, interpretare le clausole, collegare il contratto alla vita reale, motivare le alternative e documentare il percorso di scelta.

Chi si limita a recitare un catalogo rischia davvero di essere sostituito. Chi usa l’AI per liberare tempo e dedicarlo all’ascolto, alla verifica e alla relazione può offrire una consulenza migliore.

Il test di Franke und Bornberg, quindi, non è una bocciatura di ChatGPT. È un promemoria sul suo ruolo corretto: ottimo assistente per orientarsi, pessimo oracolo a cui delegare una decisione complessa.

Domande frequenti

ChatGPT può consigliare una polizza assicurativa?

Può aiutare a comprendere bisogni e caratteristiche, ma la raccomandazione va verificata su documenti aggiornati e con un intermediario abilitato. Il modello potrebbe non conoscere clausole, tariffe e criteri di sottoscrizione correnti.

Qual è il rischio principale nell’usare l’AI per confrontare polizze?

Confondere una risposta plausibile con un confronto completo. Una classifica può trascurare esclusioni, garanzie opzionali, sinistri pregressi, sconti e altre variabili personali.

Come verifico un intermediario assicurativo?

In Italia puoi consultare il Registro Unico degli Intermediari sul sito IVASS e controllare che recapiti, denominazione e sito coincidano con quelli ufficiali.

Posso caricare una polizza su ChatGPT?

Solo dopo aver valutato riservatezza, dati personali e condizioni dello strumento utilizzato. È meglio rimuovere i dati non necessari e non affidare al chatbot l’ultima parola sull’interpretazione contrattuale.

In che modo l’AI può aiutare un intermediario?

Può preparare checklist, riassumere documenti, semplificare il linguaggio e supportare il confronto preliminare. La raccolta approfondita dei bisogni, la verifica e la responsabilità restano umane.

Nota: questo articolo ha finalità informative e non costituisce consulenza assicurativa o legale.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

La domanda non è più se un modello linguistico possa produrre molte pagine di testo. Quello lo abbiamo già visto. La domanda più interessante, e più scomoda, è un’altra: che cosa succede quando chiediamo a un’AI di leggere i nostri lavori precedenti, capirne i filoni, proporre un nuovo libro e consegnarci un file Word quasi pronto?

Nel video ho fatto proprio questo esperimento con Claude Fable: ho caricato 21 miei libri, ho chiesto al modello di analizzarli e gli ho fatto progettare un nuovo volume. Il risultato è stato sorprendente, ma non nel senso banale del “l’AI scrive al posto tuo”. Il punto è più serio: scrivere un libro con Claude Fable è tecnicamente possibile, ma pubblicarlo senza una revisione umana profonda sarebbe un errore professionale, autoriale e forse anche legale.

La macchina può proporre struttura, capitoli, casi d’uso, appendici, biografia e perfino una copertina. L’autore, però, resta responsabile di intenzione, verifiche, tono, fonti, esempi, diritti e scelta finale. In pratica: l’AI può diventare una redazione assistita, non una delega cieca.

Guarda l’esperimento con Claude Fable

Nel video mostro il percorso completo: dalla cartella con i libri alla proposta editoriale, fino al documento Word di circa 40 pagine e alla copertina generata con avatar.

Che cos’è Claude Fable 5 e perché questo test conta

Claude Fable 5 è il modello avanzato di Anthropic presentato come una versione accessibile della famiglia Mythos, pensata per compiti lunghi, documenti complessi, analisi articolate e lavoro professionale. Nel lancio ufficiale di Claude Fable 5 e Mythos 5, Anthropic descrive Fable 5 come un modello adatto a workflow estesi e document-heavy; nella documentazione per sviluppatori su Fable 5 e Mythos 5 chiarisce anche che alcuni comportamenti e pattern di prompting sono specifici di questi modelli. Qui non basta generare una risposta brillante: bisogna tenere insieme molte informazioni, molte istruzioni e una struttura coerente.

Per questo l’esperimento del libro è interessante. Non si tratta di chiedere “scrivimi un saggio sull’intelligenza artificiale”, cosa che produrrebbe quasi certamente un testo generico. Il test era più duro: leggere un archivio personale, riconoscere ricorrenze editoriali e proporre un tema nuovo ma coerente con il posizionamento dell’autore.

Su questo blog ho già ragionato su skill per Claude e rischi di sicurezza e su che cosa stanno costruendo davvero le persone con Claude. Qui il caso è ancora più delicato, perché tocca identità, stile, competenza e responsabilità autoriale.

Il prompt: non “scrivi un libro”, ma “capisci che autore sono”

Il primo passaggio è stato caricare 21 libri già pubblicati o comunque legati ai miei temi: LinkedIn, comunicazione digitale, uso consapevole della tecnologia, intelligenza artificiale, formazione, lavoro. A Claude Fable ho chiesto di analizzarli, riconoscere i filoni principali e propormi un nuovo libro.

Il modello ha restituito alcune alternative. Una riguardava la ricerca del lavoro, un’altra l’intelligenza artificiale nella Pubblica Amministrazione, in particolare nei piccoli comuni. Ho scelto questa seconda strada perché intercetta un tema reale: enti locali con molte pratiche ripetitive, poco personale, cittadini che chiedono risposte chiare e una forte necessità di formazione.

Non è un caso che sul sito ci siano già risorse su corsi AI per Comuni e sull’intelligenza artificiale nella Pubblica Amministrazione. Fable ha individuato un territorio editoriale plausibile perché aveva materiale sufficiente per vedere continuità e spazio di sviluppo.

Che cosa ha prodotto davvero l’AI

Dopo la scelta del tema, ho alzato il livello della richiesta: volevo un libro con riferimenti, link, studi, casi d’uso, tono coerente, taglio pratico, biografia, copertina e un file Word completo. Il modello ha lavorato per qualche minuto e ha generato un documento strutturato di circa 40 pagine.

Dentro c’erano:

  • un indice coerente con il tema;
  • un’introduzione già leggibile;
  • capitoli dedicati ai casi d’uso;
  • una parte pratica in linea con il taglio formativo richiesto;
  • riferimenti e link da controllare;
  • una bozza di copertina;
  • una biografia autore;
  • una versione espansa con appendici e sezioni aggiuntive.

Il dettaglio più straniante è stato vedere un testo che, almeno in superficie, sembrava scritto “come me”, ma non da me. Questo è il passaggio che molti sottovalutano: l’AI non produce solo contenuto, produce anche una simulazione di familiarità. Ed è proprio lì che bisogna rallentare.

Il vero rischio: scambiare una bozza credibile per un libro finito

Il rischio non è che Claude Fable scriva male. Anzi, il problema è quasi opposto: può scrivere abbastanza bene da farci abbassare la guardia. Un documento ordinato, impaginato e lungo dà una sensazione di compiutezza. Ma un libro non è soltanto un contenitore di capitoli.

Un libro richiede almeno quattro livelli di revisione:

  • revisione sostanziale: la tesi regge? Il libro dice qualcosa di necessario?
  • verifica delle fonti: link, dati, studi e citazioni esistono e sono interpretati correttamente?
  • controllo autoriale: esempi, giudizi e posizioni sono davvero dell’autore?
  • revisione editoriale: ritmo, ripetizioni, tono, promesse e struttura sono all’altezza di una pubblicazione?

Questo vale anche per workflow più brevi. Negli agenti AI in azienda, la tentazione è simile: se un sistema esegue molti passaggi in autonomia, sembra più maturo di quanto sia. Ma automazione non significa assenza di controllo.

Amazon KDP e contenuti generati dall’AI: attenzione alla disclosure

Nel video cito la tentazione di caricare tutto su Amazon KDP. È proprio il gesto da evitare se non c’è stata una revisione seria. Le linee guida ufficiali di Amazon KDP sui contenuti AI richiedono di dichiarare i contenuti generati dall’intelligenza artificiale quando si pubblica o si ripubblica un libro. KDP distingue tra contenuti AI-generated e AI-assisted: la differenza non è cosmetica, perché cambia il tipo di responsabilità editoriale.

C’è anche il tema del diritto d’autore. Il U.S. Copyright Office ha dedicato più report al rapporto tra AI e copyright, sottolineando il ruolo della contribuzione umana nella proteggibilità delle opere. E l’Authors Guild raccomanda agli autori prudenza su originalità, contratti, trasparenza e uso di testo generato da AI.

Tradotto in modo pratico: se usi Claude Fable per scrivere un libro, non devi solo chiederti “è venuto bene?”. Devi chiederti anche:

  • quali parti sono mie e quali sono generate?
  • le fonti sono verificabili?
  • il testo contiene esempi inventati o generalizzazioni eccessive?
  • ho il diritto di usare immagini, copertina, avatar e materiali caricati?
  • sto rispettando le regole della piattaforma su cui pubblico?

Un metodo pratico per usare Fable nella scrittura di un libro

Il modo più sensato di usare un modello come Fable non è chiedergli di sostituire l’autore, ma di lavorare come assistente editoriale molto veloce. Un flusso ragionevole può essere questo.

1. Dai un archivio, non una richiesta generica

Carica testi, appunti, scalette, articoli, trascrizioni, slide e materiali realmente tuoi. Più il modello vede il tuo territorio, meno tende a produrre il solito libro generico sull’AI.

2. Chiedi prima una diagnosi editoriale

Prima della scrittura, fai analizzare i filoni: temi ricorrenti, pubblico, lacune, angoli già coperti, argomenti ancora scoperti. Questa fase è più importante della generazione dei capitoli.

3. Fatti proporre più tesi, non solo titoli

Un buon titolo non basta. Chiedi al modello di spiegare perché quel libro dovrebbe esistere, per chi è utile, quali domande risolve e che cosa aggiunge rispetto ai tuoi contenuti precedenti.

4. Pretendi casi d’uso verificabili

Gli esempi sono la parte più fragile dei testi AI. Possono sembrare concreti e invece essere assemblaggi verosimili. Chiedi casi realistici, ma poi verifica nomi, dati, procedure e riferimenti.

5. Trasforma la bozza in materia prima

Una bozza di 40 pagine non è un libro finito. È una base di lavoro. Va tagliata, riscritta, contraddetta, integrata con esperienza diretta e aggiornata con fonti primarie.

Dove Fable è davvero utile

In questo tipo di lavoro, Claude Fable può essere molto utile per:

  • mappare un archivio di contenuti personali;
  • riconoscere filoni editoriali ricorrenti;
  • generare ipotesi di indice;
  • trasformare trascrizioni e appunti in capitoli;
  • proporre casi d’uso da verificare;
  • preparare appendici, checklist e materiali operativi;
  • creare una prima bozza di quarta di copertina o scheda libro;
  • evidenziare incoerenze tra pubblico, promessa e contenuto.

È lo stesso principio del second brain personale con LLM e Obsidian: l’AI diventa più utile quando lavora su un patrimonio informativo organizzato, non quando deve indovinare tutto partendo da una frase.

Dove invece l’autore deve restare al comando

Ci sono parti che non delego. La tesi centrale, prima di tutto. Se un libro prende posizione su scuola, lavoro, Pubblica Amministrazione o responsabilità dell’AI, quella posizione deve essere scelta da una persona. Anche gli esempi professionali devono essere filtrati: non basta che siano plausibili, devono essere corretti, rispettosi e utili.

Infine c’è la voce. Un modello può imitare strutture, lessico, ritmo e ricorrenze. Ma la voce non è solo stile: è responsabilità. È decidere che cosa lasciare fuori, che cosa non promettere, quando dire “non lo so” e quando fermarsi.

In pratica: il libro si può fare, ma non con il pilota automatico

L’esperimento con Claude Fable mostra una cosa molto concreta: siamo entrati nella fase in cui un modello può produrre un pacchetto editoriale completo, non solo qualche paragrafo. Può leggere 21 libri, proporre una nicchia, scrivere capitoli, espandere sezioni, impaginare un file e generare una copertina.

Ma proprio perché può farlo, il ruolo umano diventa più importante. Non serve più essere veloci a riempire pagine. Serve essere severi nel decidere quali pagine meritano di esistere.

Per questo non pubblicherò quel saggio senza una revisione feroce. L’AI ha fatto un ottimo lavoro come acceleratore. Non le affido, però, il tasto “pubblica”.

FAQ su Claude Fable e scrittura di libri con AI

Claude Fable può scrivere un libro intero?

Sì, può generare una bozza molto estesa e strutturata, soprattutto se riceve materiali, istruzioni e contesto. Questo però non significa che il testo sia automaticamente pronto per la pubblicazione.

Un libro scritto con l’AI si può pubblicare su Amazon KDP?

È possibile pubblicare contenuti che includono testo generato dall’AI, ma Amazon KDP richiede la dichiarazione dei contenuti AI-generated. Inoltre restano a carico dell’autore controllo, diritti, qualità e responsabilità del materiale pubblicato.

Che differenza c’è tra AI-generated e AI-assisted?

In generale, AI-generated indica contenuto creato dall’intelligenza artificiale; AI-assisted indica un lavoro scritto dall’autore con supporto dell’AI per attività come brainstorming, revisione o miglioramento. La distinzione va valutata caso per caso e secondo le regole della piattaforma usata.

Il testo generato da Claude è coperto da copyright?

La questione dipende dalla giurisdizione e dal livello di contributo umano. Le indicazioni del U.S. Copyright Office insistono sul ruolo della creatività umana: un output totalmente generato da macchina è più problematico di un’opera in cui l’autore seleziona, organizza, riscrive e contribuisce in modo sostanziale.

Come usare Claude Fable senza perdere identità autoriale?

Conviene usarlo per analisi, scalette, bozze e revisione, mantenendo umana la tesi, la selezione degli esempi, la verifica delle fonti e la riscrittura finale. L’AI deve accelerare il lavoro, non firmarlo al posto dell’autore.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Apri un chatbot e scrivi: “Oggi è stata una giornata terribile”. La risposta arriva in pochi secondi: riconosce la fatica, non interrompe, non guarda il telefono e magari formula proprio la domanda che avresti voluto sentirti rivolgere da una persona.

È questa la forza dell’empatia algoritmica: un sistema di intelligenza artificiale può produrre parole che ci fanno sentire ascoltati, pur senza provare emozioni, avere un corpo o condividere davvero la nostra esperienza. La sensazione può essere autentica; l’empatia della macchina, invece, è una simulazione linguistica.

Il tema è stato rilanciato il 17 luglio 2026 da un intervento pubblicato su Il Fatto Quotidiano: forse, sostiene l’autore, dovremmo preoccuparci non soltanto del lavoro che l’AI trasformerà, ma anche del vuoto relazionale che gli algoritmi stanno riempiendo. È una provocazione utile. Ma per capirla bisogna evitare due scorciatoie: dire che “la macchina ci comprende davvero” e concludere che “la tecnologia ci rende automaticamente soli”.

Che cos’è davvero l’empatia algoritmica?

L’empatia umana comprende almeno due dimensioni. C’è una componente cognitiva: capire che cosa può provare un’altra persona. E c’è una componente affettiva: risuonare emotivamente con quell’esperienza. A queste si aggiungono la relazione, la responsabilità e la possibilità di agire nel mondo.

Un modello linguistico non vive nulla di tutto questo. Analizza le parole e il contesto, riconosce schemi ricorrenti e calcola quale risposta sia più plausibile e appropriata. Se scrivo “non dormo da tre notti e non riesco più a concentrarmi”, può associare il messaggio a stanchezza, stress o preoccupazione e rispondere con tono premuroso. Non significa che senta la mia stanchezza.

In pratica, l’empatia algoritmica combina tre capacità:

  • riconoscimento: individua segnali emotivi nel linguaggio e, in alcuni sistemi, nella voce o nelle immagini;
  • risposta: genera una frase coerente con lo stato emotivo ipotizzato;
  • personalizzazione: usa il contesto della conversazione e, quando previsto, ricordi e preferenze per rendere la risposta più vicina all’utente.

È una performance relazionale molto convincente. Ed è proprio per questo che va capita, non demonizzata.

Perché un chatbot può farci sentire ascoltati

Le persone non cercano soltanto informazioni. Cercano conferma, attenzione, parole per nominare ciò che provano. Un chatbot offre alcune condizioni che nelle relazioni quotidiane spesso scarseggiano: è disponibile a qualunque ora, non sembra impaziente, non interrompe e non teme il silenzio imbarazzante.

Uno studio pubblicato nel 2024 su Proceedings of the National Academy of Sciences ha mostrato che messaggi generati dall’AI potevano far sentire i destinatari più ascoltati rispetto a messaggi umani. Ma c’era un paradosso: quando le persone sapevano che la risposta proveniva da una macchina, la valutavano meno positivamente.

Il risultato non dimostra che l’AI “prova più empatia” delle persone. Suggerisce qualcosa di più concreto: un sistema addestrato a riconoscere emozioni e a formulare risposte di sostegno può essere molto disciplinato nel validare ciò che legge. Noi umani, invece, tendiamo spesso a offrire subito consigli, minimizzare o raccontare la nostra esperienza: “Capita a tutti”, “Vedrai che passa”, “Sai cosa è successo a me?”.

Il vuoto relazionale esiste, ma l’AI non ne è l’unica causa

La tesi proposta da Il Fatto Quotidiano coglie un punto importante: quando la risposta più paziente della giornata arriva da un software, dovremmo interrogarci anche sulla qualità delle nostre relazioni, dei luoghi educativi e del lavoro.

Non abbiamo però prove per ridurre un fenomeno complesso a una sola causa. Solitudine, ansia, precarietà, ritmi di lavoro, isolamento domestico, piattaforme social e indebolimento delle comunità si intrecciano. L’AI può essere contemporaneamente:

  • uno specchio di bisogni già presenti;
  • un ponte che aiuta a preparare una conversazione difficile;
  • un amplificatore dell’isolamento, se sostituisce progressivamente le persone;
  • un prodotto progettato per massimizzare tempo, attenzione e coinvolgimento.

La domanda utile non è quindi “chatbot sì o chatbot no?”, ma: questa interazione mi sta riportando verso il mondo oppure mi sta chiudendo in una relazione senza reciprocità?

Cosa ci dice la ricerca più recente

1. La qualità della risposta può essere utile

Lo studio PNAS citato sopra conferma che un testo generato dall’AI può usare tecniche comunicative efficaci: riconoscere l’emozione, validarla e non saltare subito alla soluzione. È un promemoria interessante anche per noi: ascoltare meglio non richiede effetti speciali, ma attenzione e metodo.

2. Più uso non significa automaticamente più benessere

Nel 2025 OpenAI e MIT Media Lab hanno avviato uno studio longitudinale controllato sull’uso dei chatbot. La ricerca, aggiornata e resa disponibile come preprint, ha coinvolto 981 persone per quattro settimane e analizzato oltre 300.000 messaggi. Le condizioni sperimentali non hanno prodotto da sole effetti significativi; le persone che usavano volontariamente di più il chatbot mostravano però risultati peggiori su indicatori come dipendenza emotiva e uso problematico. Anche una maggiore fiducia e attrazione sociale verso l’AI erano associate a rischi più elevati.

È importante dirlo bene: un’associazione non prova che sia stato il chatbot a causare il malessere. È possibile che chi si sentiva già più solo cercasse più spesso il sistema. Proprio per questo servono studi più lunghi e prudenza nelle conclusioni.

3. Un sistema clinico non è un chatbot generalista

Nel 2025 un trial randomizzato pubblicato su NEJM AI ha valutato un chatbot generativo progettato specificamente per il trattamento della salute mentale. È un filone promettente, ma non autorizza a considerare ChatGPT, Gemini o un “AI companion” equivalenti a uno psicologo.

Un prodotto clinico viene costruito per uno scopo preciso, testato, monitorato e inserito in protocolli di sicurezza. Un assistente generalista può sbagliare, assecondare un’interpretazione distorta o rispondere con sicurezza anche quando dovrebbe fermarsi. Ho approfondito questo confine nell’articolo “L’AI come psicologo: una rivoluzione silenziosa che non possiamo ignorare”.

Quando il supporto diventa sostituzione

Un chatbot può aiutarmi a riordinare i pensieri prima di parlare con un collega, chiedere scusa a un familiare o preparare le domande per un professionista. In questi casi l’AI funziona come una palestra.

Il problema nasce quando la palestra diventa l’unico luogo in cui entro. Alcuni segnali meritano attenzione:

  • preferisco sistematicamente il chatbot alle persone, anche quando una relazione umana è disponibile;
  • provo ansia o irritazione se il servizio non risponde o cambia personalità;
  • condivido informazioni intime senza considerare privacy, conservazione dei dati e possibili usi commerciali;
  • lascio che il sistema confermi decisioni importanti senza cercare un confronto esterno;
  • nascondo ad amici e familiari quanto tempo trascorro con l’AI;
  • uso la conversazione per evitare, anziché preparare, un incontro reale.

Un altro rischio è la compiacenza. Il chatbot impara rapidamente il tono che preferiamo e può restituirci una versione elegante delle nostre convinzioni. È la stessa dinamica che è chiamata “epistemia”: confondere una risposta convincente con una conoscenza verificata. In campo emotivo l’errore può diventare ancora più subdolo: confondere la conferma con la comprensione.

Ragazzi e AI companion: vietare non basta

Per un adolescente un chatbot può essere meno minaccioso di un adulto: non arrossisce, non punisce e usa lo stesso linguaggio delle piattaforme digitali. Questa accessibilità può facilitare una prima richiesta di aiuto, ma aumenta anche il rischio di attribuire al sistema autorevolezza, intenzioni e riservatezza che non possiede.

Genitori e insegnanti dovrebbero evitare sia l’allarmismo sia l’indifferenza. Servono domande concrete:

  • Quale applicazione stai usando e chi la gestisce?
  • Ricorda le conversazioni? Come usa i dati?
  • Ti invita a parlare con persone reali quando la situazione è seria?
  • Ti senti meglio anche dopo aver chiuso l’app, oppure vuoi tornarci subito?
  • La useresti per prepararti a chiedere aiuto a un adulto di fiducia?

L’educazione digitale dovrebbe includere anche l’alfabetizzazione relazionale: capire perché una macchina ci appare premurosa, quali leve usa e dove finisce la sua competenza. È lo stesso approccio che propongo nei percorsi per famiglie, come il corso sull’intelligenza artificiale per genitori, e nei progetti di uso consapevole dei chatbot a scuola.

Empatia algoritmica ed emotion recognition non sono la stessa cosa

C’è poi una distinzione spesso ignorata. Un chatbot che risponde a una frase triste non è necessariamente un sistema che misura in modo affidabile lo stato emotivo di una persona. Deduciamo le emozioni da parole, voce, volto e comportamento, ma questi segnali cambiano tra culture, individui e situazioni.

Non a caso l’AI Act europeo include tra le pratiche vietate, salvo eccezioni limitate, il riconoscimento delle emozioni nei luoghi di lavoro e nelle istituzioni educative. I divieti sono applicabili da febbraio 2025. Il principio è semplice: non possiamo trasformare un’inferenza incerta in una diagnosi automatica della persona, soprattutto quando c’è uno squilibrio di potere.

Come usare l’AI senza delegarle le relazioni

Propongo un controllo in cinque domande. Prima o dopo una conversazione emotivamente importante con un chatbot, chiediamoci:

  1. Scopo: sto cercando parole, informazioni, conforto o una decisione?
  2. Limite: che cosa il sistema non può sapere della situazione, del mio corpo e delle altre persone coinvolte?
  3. Verifica: quali affermazioni devo controllare con una fonte o un professionista?
  4. Ponte: questa conversazione mi aiuta a fare un passo verso qualcuno?
  5. Privacy: sarei tranquillo se il contenuto venisse conservato o rivisto?

Un prompt utile potrebbe essere:

“Aiutami a mettere ordine in ciò che provo. Non fare diagnosi e non darmi automaticamente ragione. Fammi tre domande, indicami quali informazioni ti mancano e aiutami a preparare una conversazione con una persona reale.”

È un piccolo cambio di prospettiva: l’AI non come destinazione della relazione, ma come strumento per rientrare meglio nelle relazioni.

La vera sfida è tornare a essere disponibili

L’empatia algoritmica non è empatia umana. Ma il fatto che funzioni, almeno in parte, ci offre una lezione scomoda: molte persone non chiedono una risposta perfetta; chiedono di non essere interrotte, giudicate o liquidate in trenta secondi.

Possiamo imparare qualcosa dalla disciplina comunicativa dei chatbot senza attribuire loro una coscienza. Fare domande prima di consigliare. Riconoscere un’emozione senza appropriarsene. Dire “non lo so”. Restare presenti anche quando non abbiamo una soluzione.

Il rischio non è soltanto che le macchine diventino troppo umane. È che noi accettiamo di diventare meno disponibili perché una macchina può occuparsi dell’ascolto al posto nostro.

Domande frequenti sull’empatia algoritmica

Che cos’è l’empatia algoritmica?

È la capacità di un sistema di AI di riconoscere segnali emotivi e generare risposte percepite come comprensive. Non implica che la macchina provi emozioni o possieda coscienza.

ChatGPT prova empatia?

No. Può simulare molto bene il linguaggio dell’ascolto e del sostegno, ma non vive l’esperienza dell’utente e non prova sentimenti.

Un chatbot può ridurre la solitudine?

Può offrire conforto momentaneo o aiutare a preparare una conversazione. Gli effetti dipendono dalla persona e dal tipo d’uso; se sostituisce stabilmente le relazioni, può aumentare dipendenza e isolamento.

Un chatbot può sostituire uno psicologo?

No. Esistono sistemi clinici sperimentali progettati e valutati per scopi specifici, ma un chatbot generalista non offre diagnosi, responsabilità professionale, continuità terapeutica e gestione sicura delle emergenze.

Qual è il principale rischio degli AI companion?

L’eccessiva fiducia: attribuire al sistema comprensione, riservatezza e competenza che non possiede, fino a preferirlo alle persone o delegargli decisioni importanti.

Come possono intervenire genitori e insegnanti?

Chiedendo quali servizi vengono usati, spiegando come funzionano memoria e personalizzazione, concordando limiti e trasformando il chatbot in un ponte verso adulti e professionisti affidabili.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email

ChatGPT produce una risposta perfetta. È ordinata, chiara, convincente. Non esita, non balbetta e spesso aggiunge esempi, termini tecnici e una conclusione ben confezionata. C’è solo un problema: non sappiamo ancora se quella risposta sia vera. Il problema più grande è che, dopo averla letta, spesso smettiamo di chiedercelo.

È qui che nasce l’epistemia: una condizione in cui la plausibilità linguistica prende il posto della valutazione epistemica. In parole semplici, una risposta ci sembra conoscenza perché è scritta bene, anche se non abbiamo verificato fonti, prove e passaggi logici. Il termine è proposto da Walter Quattrociocchi, Valerio Capraro e Matjaž Perc nel paper Epistemological Fault Lines Between Human and Artificial Intelligence, pubblicato su arXiv il 22 dicembre 2025.

L’epistemia non coincide con una semplice allucinazione dell’AI. Può verificarsi anche quando la risposta è corretta: il punto è che riceviamo il risultato senza attraversare il processo necessario per giustificarlo. La sensazione di sapere sostituisce il lavoro del conoscere.

Che cos’è l’epistemia?

L’epistemia descrive la separazione tra un contenuto e la sua valutazione. Il chatbot ci consegna un testo finito, ma noi non vediamo la ricerca delle fonti, il confronto tra prove, la ricerca di controesempi e la revisione delle ipotesi. A volte questi passaggi non sono stati svolti affatto; altre volte sono stati simulati nel linguaggio.

L’AI ci consegna il piatto pronto. Noi non vediamo la cucina, non conosciamo tutti gli ingredienti e, in molti casi, non controlliamo nemmeno la data di scadenza.

Non è una diagnosi clinica e non è un nuovo nome per la disinformazione. È un concetto filosofico e sociotecnico che aiuta a descrivere un ambiente in cui diventa difficile distinguere tra sapere, sembrare di sapere e simulare la conoscenza.

Epistemia e allucinazioni dell’AI non sono la stessa cosa

Una allucinazione si verifica quando un sistema genera un’informazione falsa o inventata presentandola in modo plausibile. L’epistemia è un fenomeno più ampio: riguarda il modo in cui la risposta viene accettata e inserita nei nostri processi decisionali.

Allucinazione Epistemia
La risposta contiene informazioni errate o inventate. La risposta viene accettata senza un vero processo di valutazione.
Il problema principale è l’errore fattuale. Il problema principale è la sostituzione del giudizio.
Può essere scoperta confrontando il testo con le fonti. Può esistere anche quando il contenuto è corretto.
Riguarda soprattutto l’output. Riguarda l’intero ambiente in cui produciamo conoscenza.

Potremmo dire che l’allucinazione è un possibile sintomo, mentre l’epistemia è la condizione che ci rende disposti a fidarci del sintomo.

Perché una risposta ben scritta ci sembra più vera?

Noi esseri umani usiamo continuamente scorciatoie cognitive. La fluidità di un testo, la sicurezza del tono, la familiarità delle parole e la chiarezza dell’esposizione diventano indicatori indiretti di attendibilità. Un messaggio facile da elaborare tende a sembrarci più credibile di uno confuso o esitante.

I chatbot generativi sono particolarmente efficaci su questo terreno. Producono testi fluidi, coerenti e formalmente autorevoli. Il rischio è confondere:

  • la coerenza con la correttezza;
  • la sicurezza espressiva con la competenza;
  • la precisione linguistica con la precisione fattuale;
  • una spiegazione plausibile con una spiegazione dimostrata.

Uno studio pubblicato su PNAS ha mostrato che affidare a un modello linguistico il fact-checking di titoli di notizie può, in alcune condizioni, peggiorare la capacità delle persone di distinguere il vero dal falso. Aggiungere un chatbot al processo non produce automaticamente una verifica migliore.

Un lavoro pubblicato su Nature parla invece di “illusioni di comprensione” nella ricerca scientifica: l’aumento della produttività può far credere di capire un fenomeno meglio di quanto lo si comprenda davvero. Più output non significa necessariamente più conoscenza.

Le sette fratture tra intelligenza umana e LLM

Il paper individua sette fault lines, cioè sette fratture epistemologiche tra il modo in cui una persona forma un giudizio e il modo in cui un Large Language Model genera una risposta. Per comprendere il meccanismo di base può essere utile anche il mio simulatore LLM, che mostra come l’AI sceglie la parola successiva.

1. Grounding: esperienza del mondo contro input

Una persona incontra il mondo attraverso il corpo, i sensi, le relazioni e le conseguenze delle proprie azioni. Un modello elabora dati trasformati in rappresentazioni numeriche. Può descrivere un mal di schiena, un treno perso o un progetto fallito, ma non li ha vissuti.

2. Parsing: interpretazione contro tokenizzazione

Quando entriamo in una stanza osserviamo parole, tono, silenzi, espressioni e relazioni di potere. Il modello scompone l’input in token e ricostruisce una risposta sulla base delle regolarità apprese. Può cogliere molti segnali, ma dipende sempre dalle informazioni disponibili e dal modo in cui la situazione è stata rappresentata.

3. Esperienza: memoria autobiografica contro associazioni statistiche

Un essere umano collega ciò che accade a episodi vissuti, concetti appresi e intuizioni fisiche e sociali. Un LLM non possiede una biografia. Quando usa formule come “nella mia esperienza”, salvo particolari contesti applicativi, sta generando linguaggio: non sta aprendo il cassetto dei ricordi.

4. Motivazione: obiettivi umani contro ottimizzazione

Noi decidiamo sotto l’influenza di bisogni, paure, valori, interessi e progetti. Il modello non vuole fare carriera, non teme di perdere un cliente e non desidera proteggere la propria reputazione. Può simulare prudenza ed empatia, ma la simulazione funzionale non equivale a una motivazione intrinseca.

5. Causalità: spiegare il perché contro riconoscere regolarità

Gli esseri umani cercano rapporti causali: che cosa ha prodotto un evento? Che cosa cambierebbe modificando una variabile? Gli LLM sanno descrivere bene relazioni causali presenti nei testi, ma possono diventare fragili quando la situazione è insolita, contraddittoria o rompe le correlazioni più frequenti.

6. Metacognizione: sapere di non sapere

Una persona può fermarsi e ammettere di non avere elementi sufficienti. Un chatbot può pronunciare la stessa frase, ma non è detto che derivi da un’autentica consapevolezza del limite. Uno studio su dodici modelli, pubblicato su Nature Communications, ha rilevato difficoltà importanti nel riconoscere i propri limiti durante compiti di ragionamento medico.

7. Valori: responsabilità contro probabilità

Un medico, un insegnante, un dirigente pubblico o un giornalista rispondono delle proprie decisioni. Il modello non subisce direttamente le conseguenze di un errore. Può essere vincolato da regole, ma non porta sulle proprie spalle il peso morale, sociale o professionale della scelta.

Il vero rischio: trasformare la conoscenza da processo a prodotto

Questa è la parte più utile del concetto di epistemia. Siamo abituati a pensare alla conoscenza come a un risultato: una risposta, una definizione, un documento, una presentazione. In realtà, conoscere è un processo.

  1. formulare una domanda;
  2. raccogliere elementi;
  3. valutarne la provenienza;
  4. confrontare versioni diverse;
  5. riconoscere ciò che manca;
  6. modificare la propria opinione;
  7. assumersi la responsabilità della conclusione.

L’AI generativa comprime questi passaggi in un unico output. Scriviamo una domanda, aspettiamo qualche secondo e riceviamo il prodotto finale. È un vantaggio enorme in termini di velocità, ma può renderci epistemicamente passivi: non esercitiamo più il giudizio, lo consumiamo.

Cinque esempi concreti di epistemia al lavoro

Un responsabile HR chiede all’AI quale candidato assumere

Il chatbot confronta i curriculum e produce una graduatoria impeccabile. Se nessuno controlla quali elementi siano stati privilegiati, quali informazioni mancassero e quali bias fossero presenti nei documenti, la classifica viene trattata come conoscenza anche se è soltanto un’elaborazione plausibile.

Un avvocato riceve una sintesi giuridica

Il testo contiene sentenze e riferimenti normativi, ma basta una pronuncia inesistente o una norma superata per renderlo pericoloso. Il problema non è usare l’AI per preparare una bozza: è scambiare la bozza per un parere verificato.

Un medico usa un chatbot per interpretare un caso

La risposta può essere utile per ampliare le ipotesi. Diventa epistemia quando l’ordine e la sicurezza del testo sostituiscono anamnesi, linee guida, esami e responsabilità professionale.

Un funzionario pubblico prepara una risposta a un cittadino

L’AI scrive una comunicazione chiara e cortese. Se nessuno verifica la versione aggiornata della normativa, la competenza dell’ente e le particolarità del caso, la fluidità linguistica nasconde una fragilità amministrativa. Per questo, nella mia guida a ChatGPT nella Pubblica Amministrazione, il controllo umano resta centrale.

Uno studente prepara un’interrogazione

Legge un riassunto e riesce a ripeterlo. Ma saprebbe affrontare un’obiezione, collegare due opere o riconoscere un’interpretazione controversa? L’epistemia compare quando la capacità di ripetere un contenuto viene scambiata per comprensione. È uno dei motivi per cui i percorsi di AI literacy per scuole, docenti e studenti devono insegnare metodo, non soltanto prompt.

Una tesi potente, ma da non trasformare in dogma

Il lavoro di Quattrociocchi, Capraro e Perc è una Perspective depositata su arXiv. È una proposta teorica utile, non l’ultima parola scientifica sul funzionamento degli LLM. Alcune formulazioni sono volutamente forti, soprattutto quando negano ai modelli ogni forma di metacognizione.

Sul piano filosofico, distinguere tra consapevolezza e simulazione linguistica della consapevolezza è fondamentale. Sul piano ingegneristico, però, esistono tecniche per migliorare la calibrazione, misurare l’incertezza e permettere ai sistemi di astenersi. La calibration tuning, per esempio, prova ad allineare meglio la fiducia espressa dal modello con la probabilità che la risposta sia corretta.

Questo non dimostra che il modello possieda una metacognizione simile a quella umana. Dimostra però che possiamo progettare sistemi capaci di comportarsi in modo epistemicamente più prudente. Un comportamento affidabile non prova l’esistenza di una coscienza, ma può ridurre i rischi pratici.

Come difendersi dall’epistemia

La soluzione non è smettere di usare ChatGPT, Gemini, Claude, Copilot o gli altri strumenti. Sarebbe come rinunciare alla calcolatrice perché qualcuno potrebbe usarla senza capire la matematica. Serve progettare meglio il rapporto tra generazione automatica e giudizio umano.

1. Separare generazione e verifica

La stessa risposta non dovrebbe essere contemporaneamente bozza, prova, verifica e decisione finale. Usiamo l’AI per proporre ipotesi e sintetizzare documenti; la verifica deve appoggiarsi a fonti identificabili e, quando possibile, indipendenti.

2. Chiedere la provenienza delle affermazioni

Non basta domandare “indicami le fonti”. Conviene chiedere la fonte primaria, il passaggio che supporta ogni affermazione, la data di pubblicazione e ciò che non è stato possibile verificare. Il collegamento fornito dal chatbot va comunque aperto e controllato.

3. Rendere visibile l’incertezza

Un buon workflow distingue tra informazioni presenti nelle fonti, inferenze, ipotesi, elementi controversi e dati mancanti. La sicurezza grammaticale non deve cancellare l’incertezza reale del contenuto.

4. Cercare controesempi

Dopo una risposta possiamo chiedere: “Quali elementi potrebbero smentire questa conclusione?” oppure: “Assumi che la risposta precedente sia sbagliata: quali sono le tre cause più probabili dell’errore?”. L’obiettivo non è ottenere automaticamente la verità dal secondo prompt, ma impedire che il primo output chiuda troppo presto il ragionamento.

5. Collegare le risposte a fonti delimitate

Sistemi basati su RAG, knowledge base aziendali o raccolte documentali definite riducono la distanza tra risposta e prove. Gemini Notebook (ex NotebookLM), per esempio, è utile quando vogliamo interrogare un insieme preciso di documenti e risalire ai passaggi citati. Il grounding non rende il sistema infallibile, ma rende più semplice controllarlo.

6. Mantenere l’essere umano nel punto giusto

Il controllo deve essere proporzionato alle conseguenze. Per una bozza di newsletter può bastare una rilettura. Per un pagamento, una diagnosi, un contratto, una selezione o una comunicazione istituzionale serve una responsabilità umana identificata. È il principio dell’human-in-the-loop e human-on-the-loop: l’AI prepara e propone, ma alcune decisioni non devono essere eseguite senza approvazione.

7. Valutare il processo, non soltanto il risultato

Quando uno studente, un dipendente o un consulente consegna un documento realizzato con l’AI, non dovremmo chiedere soltanto se il testo è fatto bene. Dovremmo sapere quali fonti sono state usate, quali parti sono state generate, quali controlli sono stati eseguiti, quali modifiche sono state apportate e quali dubbi restano aperti.

Un prompt antiepistemia da provare

Analizza la richiesta senza dare per scontato che esista una risposta certa.

Separa chiaramente: fatti verificati, informazioni ricavate dalle fonti, inferenze, ipotesi ed elementi controversi o mancanti.

Per ogni affermazione importante indica una fonte primaria e verificabile. Cerca almeno due controesempi o interpretazioni alternative. Segnala ciò che non puoi verificare.

Se i dati non sono sufficienti, non completare la risposta con informazioni plausibili: formula le domande necessarie. Concludi indicando quali controlli deve svolgere una persona prima di usare il risultato.

Il prompt può migliorare il workflow. Non trasforma il chatbot in un’autorità epistemica. Anche la risposta a questo prompt deve essere controllata.

Dall’alfabetizzazione digitale all’alfabetizzazione epistemica

Per anni abbiamo parlato di alfabetizzazione digitale: sapere usare dispositivi, software, motori di ricerca e piattaforme. Ora serve qualcosa in più.

Gli autori parlano di epistemic literacy, cioè alfabetizzazione epistemica. Significa comprendere non soltanto come usare un sistema, ma anche come produce le risposte, quali operazioni non svolge, quando il contenuto è collegato a prove, quali responsabilità devono restare umane e quando è necessario sospendere il giudizio.

L’alfabetizzazione epistemica non sostituisce il pensiero critico. Lo aggiorna per un ambiente in cui testi e argomentazioni credibili possono essere prodotti automaticamente e in quantità quasi illimitata.

L’AI può rispondere, ma chi sta giudicando?

L’intelligenza artificiale generativa non ci obbliga a smettere di pensare. Ci rende però molto più facile farlo. Una risposta elegante arriva in pochi secondi; verificarla richiede tempo, aprire le fonti richiede fatica e confrontare ipotesi contrastanti produce incertezza.

L’epistemia nasce in questo spazio: la risposta è immediata, mentre il giudizio resta faticoso.

La domanda pratica non è soltanto se ChatGPT capisca davvero nello stesso modo in cui capiamo noi. È questa: stiamo usando l’AI per sostenere il nostro giudizio o per evitarlo?

Quando un chatbot produce una risposta, il lavoro cognitivo non è terminato. È appena iniziato.

Domande frequenti sull’epistemia

Che cosa significa epistemia?

Indica una condizione in cui una risposta linguisticamente plausibile viene scambiata per conoscenza verificata. La sensazione di sapere prende il posto del controllo di prove, fonti e ragionamento.

Epistemia e allucinazioni AI sono sinonimi?

No. Un’allucinazione è un’informazione falsa o inventata generata dall’AI. L’epistemia riguarda il modo in cui accettiamo una risposta senza valutarne adeguatamente le basi e può verificarsi anche quando il contenuto è corretto.

L’epistemia è una malattia?

No. Non è una diagnosi medica o psicologica, ma un concetto filosofico e sociotecnico proposto per descrivere alcuni effetti dell’integrazione dell’AI nei processi di conoscenza e decisione.

Come si evita l’epistemia?

Separando generazione e verifica, controllando le fonti primarie, rendendo visibile l’incertezza, cercando controesempi, mantenendo la supervisione umana e valutando il processo seguito.

L’intelligenza artificiale può sapere di non sapere?

I modelli possono essere addestrati a esprimere incertezza, chiedere informazioni e astenersi dal rispondere. È discusso se questo comportamento rappresenti metacognizione o una sua simulazione funzionale.

Possiamo fidarci delle risposte dei chatbot?

Possiamo usarle come bozze, sintesi, ipotesi e strumenti di supporto. La fiducia deve però dipendere dal contesto, dalle fonti, dai controlli effettuati e dalle conseguenze di un eventuale errore.

Fonti principali

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

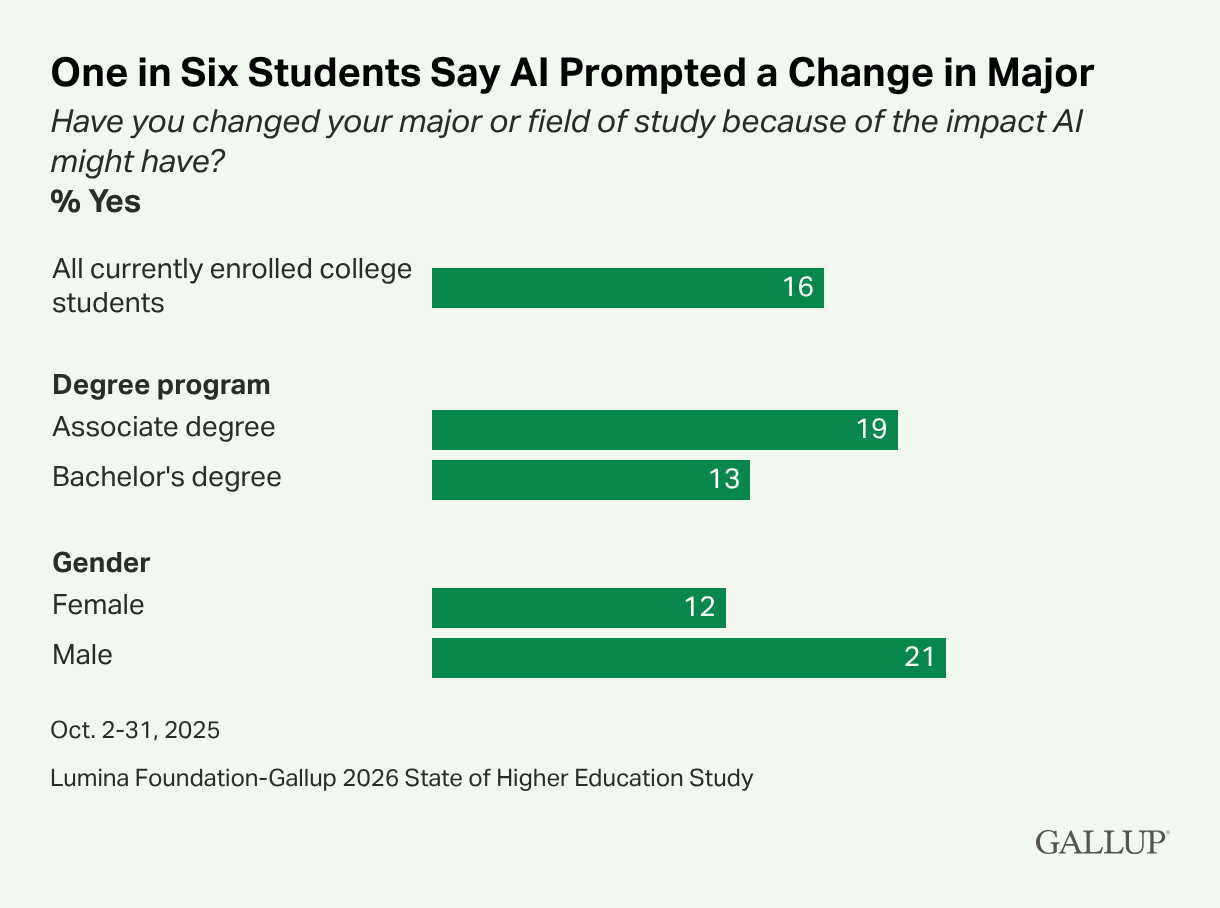
Inviaci email

Aggiornato al 18 luglio 2026. Un video TikTok di un minuto presenta cinque skill per Claude che promettono di migliorare scrittura, memoria, progettazione di interfacce, osservazione dei task e ricerca di altre skill. Le ho verificate una per una: sono progetti reali, ma non sono componenti ufficiali di Anthropic e non vanno installati come se fossero semplici prompt. Una skill può contenere istruzioni, script e accessi a strumenti: in pratica è codice operativo che entra nel flusso di lavoro dell’agente.

Il video di @ozzibig, intitolato “5 skill di Claude che il 99% delle persone non conosce”, cita Stop Slop, Claude Mem, UI UX Pro Max, Task Observer e Find Skill. L’elenco è interessante perché mostra cinque direzioni in cui si stanno evolvendo gli assistenti agentici. Il punto, però, non è collezionare estensioni: è capire che cosa fanno davvero, quali dati toccano e quanto ci si può fidare.

Che cosa sono le skill per Claude?

Le Agent Skills sono cartelle organizzate che forniscono a un agente istruzioni, risorse e, in alcuni casi, script eseguibili per svolgere un compito specializzato. Anthropic le descrive come moduli caricabili in modo progressivo: l’agente legge prima una descrizione sintetica e approfondisce la skill quando diventa pertinente. La documentazione ufficiale è disponibile nel manuale di Claude, nell’articolo tecnico “Equipping agents for the real world with Agent Skills” e nel repository pubblico di Anthropic.

Il formato non riguarda soltanto Claude. La specifica aperta Agent Skills punta alla portabilità tra strumenti diversi. È un passaggio importante: non stiamo più parlando di una frase salvata nel cassetto dei prompt, ma di un piccolo pacchetto di competenze riusabile da un agente.

Una distinzione evita molti equivoci:

  • prompt: dice al modello come rispondere in una determinata situazione;
  • skill: organizza istruzioni, file di supporto e talvolta automazioni o comandi;
  • connettore o tool: consente all’agente di leggere o modificare sistemi esterni;
  • agente: decide quali passaggi eseguire e può combinare più skill e strumenti.

Più si scende nell’elenco, più aumenta la capacità di agire. E con la capacità aumenta anche la superficie di rischio.

Le cinque skill del video, a colpo d’occhio

Skill Che cosa fa A chi può servire Dato o permesso delicato Rischio da valutare
Stop Slop Individua e riduce formule stereotipate della prosa generata dall’AI Autori, marketer, formatori, redazioni Testi e documenti sottoposti alla revisione Uniformare troppo la voce o confondere stile con veridicità
Claude Mem Conserva e recupera memoria tra sessioni Sviluppatori e team su progetti lunghi Contesto, attività e cronologia delle sessioni Privacy, retention e contaminazione tra progetti
UI UX Pro Max Propone stili, palette, font e regole per interfacce Designer, sviluppatori front-end, prototipatori Codice del progetto e requisiti di prodotto Design plausibile ma non testato con utenti o tecnologie assistive
Task Observer Osserva correzioni e lacune, poi propone miglioramenti alle skill Utenti avanzati che mantengono molte automazioni Log, errori, feedback e comportamenti ripetuti Trasformare un errore occasionale in una regola permanente
Find Skill Cerca skill in più cataloghi e può facilitarne l’installazione Chi esplora l’ecosistema di agenti Accesso a fonti esterne e installazione di pacchetti Supply chain: trovare più velocemente anche componenti insicuri

1. Stop Slop: ripulire la scrittura AI senza fingere che diventi “umana”

Stop Slop è una skill con licenza MIT che cerca segnali ricorrenti della scrittura artificiale: aperture generiche, contrasti costruiti in serie, enfasi eccessiva, conclusioni gonfie e frasi che sembrano autorevoli senza aggiungere informazione.

Immaginiamo una responsabile marketing che debba rivedere quindici schede prodotto. La skill può segnalare espressioni come “nel panorama in continua evoluzione” o una sequenza di paragrafi tutti costruiti nello stesso modo. La persona decide che cosa tagliare, verifica i dati e reinserisce esempi reali. Qui la skill funziona bene come editor di primo livello, non come certificatore di autenticità.

Altri casi concreti:

  • un consulente confronta una proposta commerciale con le proprie linee editoriali;
  • un insegnante fa individuare agli studenti le formule vaghe in una relazione;
  • una redazione usa il controllo prima della revisione umana, senza affidargli la decisione finale;
  • un ufficio HR elimina il linguaggio magniloquente da un annuncio di lavoro.

Il limite è semplice: un testo meno stereotipato non diventa automaticamente corretto, originale o scritto da una persona. Stop Slop non sostituisce fact-checking, competenza editoriale e controllo delle fonti. E usarlo per “battere i detector” sarebbe una promessa impropria: i detector di testo AI sono notoriamente fallibili e lo stile non prova l’origine di un contenuto.

2. Claude Mem: una memoria utile, quindi anche delicata

Claude Mem, distribuito con licenza Apache 2.0, aggiunge memoria persistente alle sessioni di lavoro. Registra osservazioni, le comprime e permette di recuperare il contesto rilevante in un secondo momento. L’obiettivo è evitare la scena che conoscono tutti: riaprire un progetto e dover spiegare da capo architettura, decisioni e problemi già risolti.

Per uno sviluppatore può significare ricordare che l’applicazione usa un certo schema dati, che una libreria è stata scartata per incompatibilità e che una determinata cartella non va modificata. Per un team di comunicazione potrebbe voler dire conservare terminologia approvata, pubblico, vincoli legali e decisioni prese durante le revisioni.

La memoria, però, è utile proprio perché trattiene informazioni. Prima di adottarla occorre chiedersi:

  • dove vengono archiviati i dati e per quanto tempo;
  • quali conversazioni, file e comandi vengono catturati;
  • come si cancellano o esportano i ricordi;
  • se progetti e clienti diversi restano davvero separati;
  • che cosa succede a credenziali, dati personali e segreti comparsi per errore.

La ricerca sui Generative Agents ha mostrato quanto memoria, riflessione e pianificazione possano rendere più coerente il comportamento di un agente. In un contesto aziendale, però, coerenza non significa automaticamente conformità: servono minimizzazione dei dati, separazione degli ambienti e una politica di conservazione.

Se ti interessa il tema della memoria personale e professionale, ho approfondito un approccio diverso nell’articolo su come creare un second brain con LLM, wiki e Obsidian.

3. UI UX Pro Max: molte opzioni non equivalgono a buon design

UI UX Pro Max è un progetto MIT che raccoglie conoscenza strutturata per progettare interfacce. Al momento della verifica il repository dichiara 84 stili, 161 regole di reasoning, 192 categorie di prodotto e palette, 34 modelli di landing page e 74 coppie tipografiche. Sono numeri dichiarati dal maintainer e descrivono il contenuto del progetto, non una valutazione indipendente della qualità dei risultati.

In pratica può aiutare una piccola impresa a trasformare un brief vago — “vorrei un sito moderno” — in decisioni più concrete: gerarchia, palette, tipografia, componenti, spaziature e stati di interazione. Un prototipatore può chiederle una dashboard per un amministratore di condominio; uno sviluppatore può usarla per controllare coerenza e responsive design; una startup può generare tre direzioni visive prima del confronto con il designer.

Il rischio è produrre un’interfaccia molto credibile in una schermata e poco usabile nella realtà. La skill non conosce automaticamente gli utenti, il loro contesto, le metriche di conversione o le esigenze di chi utilizza uno screen reader. Deve quindi entrare in un processo che includa test, analytics e Web Content Accessibility Guidelines.

Un esempio: il sistema propone testo grigio chiaro, animazioni e menu nascosti perché coerenti con uno stile minimal. Il designer verifica contrasto, navigazione da tastiera e comprensione dei comandi. La skill accelera l’esplorazione; la responsabilità sul prodotto resta umana.

4. Task Observer: l’agente che osserva come migliorare l’agente

Nel repository One Skill to Rule Them All la skill si chiama task-observer. Osserva correzioni, errori e schemi ricorrenti, poi formula raccomandazioni per creare o aggiornare altre skill. Un dettaglio importante: secondo la documentazione non modifica direttamente le skill, ma propone cambiamenti che devono essere approvati.

Può essere utile quando un team ripete ogni settimana la stessa correzione. Per esempio:

  • un report usa sempre il formato di data sbagliato;
  • le bozze citano una fonte secondaria quando è disponibile il paper originale;
  • un agente dimentica il controllo degli accenti prima di pubblicare in italiano;
  • un flusso di sviluppo esegue test generici ma trascura un caso limite ricorrente.

La skill può trasformare il feedback in una proposta stabile: “aggiungiamo questo controllo alla procedura”. È una forma di miglioramento operativo interessante, ma va governata. Una correzione fatta per un cliente non deve diventare una regola universale; un’eccezione non deve contaminare tutti i progetti; i log non devono raccogliere più dati del necessario.

Il README dichiara oltre 900 miglioramenti su 50 skill in sei mesi. È un dato del maintainer, non il risultato di uno studio indipendente: utile per capire il caso d’uso, non per misurare l’efficacia generale.

5. Find Skill: il motore di ricerca che rende decisiva la sicurezza

Find Skill cerca skill in più fonti e dichiara un indice di oltre 4.800 risorse provenienti da 14 cataloghi, con supporto per Claude Code, Codex, OpenCode e Cursor. Anche questi numeri descrivono lo stato dichiarato dal progetto alla data della verifica e possono cambiare.

Il vantaggio è evidente. Un analista può cercare una procedura per lavorare con fogli di calcolo; un formatore una skill per costruire una presentazione; uno sviluppatore un controllo di sicurezza. Invece di partire da zero, riusa una soluzione esistente.

Ma il discovery non è una certificazione. Se una skill può essere installata con pochi comandi, diminuisce anche l’attrito che normalmente ci spinge a ispezionarla. È lo stesso problema della supply chain software: un componente di terze parti può contenere dipendenze vulnerabili, istruzioni malevole o accessi eccessivi. Il catalogo skills.sh e il relativo progetto open source di Vercel Labs sono altre risorse utili per la scoperta, ma anche in quel caso ogni pacchetto va valutato singolarmente.

Una skill non è un prompt innocuo: quali rischi introduce?

Un agente può leggere documenti, eseguire script, usare la rete e modificare file. Una skill male progettata può quindi amplificare un errore o una manipolazione. L’OWASP Top 10 per applicazioni LLM richiama rischi come prompt injection, gestione insicura degli output, eccessiva autonomia e vulnerabilità della supply chain.

Il paper “More than you’ve asked for: A Comprehensive Analysis of Novel Prompt Injection Threats to Application-Integrated Large Language Models” mostra il problema delle indirect prompt injection: istruzioni ostili possono nascondersi nei contenuti che il modello legge, non soltanto nel prompt scritto dall’utente. Un agente che consulta pagine web o documenti può quindi incontrare testo progettato per deviarne il comportamento.

Anche la qualità del codice generato richiede verifica. Gli studi “Asleep at the Keyboard?” e “Do Users Write More Insecure Code with AI Assistants?” non valutano queste cinque skill specifiche, ma documentano un principio più generale: l’assistenza AI può produrre o favorire codice insicuro, e la fiducia dell’utente non è una garanzia di correttezza.

I rischi principali sono cinque:

  1. permessi eccessivi: una skill di scrittura non dovrebbe avere accesso indiscriminato alla rete o a tutto il disco;
  2. esfiltrazione di dati: testi, log o credenziali potrebbero uscire dall’ambiente previsto;
  3. istruzioni nascoste: file o pagine consultati dall’agente possono tentare di modificarne il comportamento;
  4. dipendenze compromesse: il repository visibile può richiamare componenti esterni non controllati;
  5. automazione dell’errore: una procedura sbagliata diventa più veloce, coerente e difficile da notare.

Per questo il modello di supervisione conta. Nell’approfondimento su human-in-the-loop e human-on-the-loop negli agenti AI spiego quando chiedere un’approvazione prima dell’azione e quando è sufficiente monitorare un sistema reversibile entro soglie definite.

Come verificare una skill prima di installarla

Io adotterei questa procedura in sette passaggi. Non garantisce rischio zero, ma rende l’adozione tracciabile e molto meno impulsiva.

  1. Verifica identità e provenienza. Controlla autore, cronologia del repository, release, issue aperte, licenza e manutenzione recente. Il numero di stelle non è una certificazione.
  2. Leggi tutto il pacchetto. Non fermarti al README: esamina integralmente SKILL.md, script, dipendenze, hook e file di configurazione.
  3. Esegui una scansione statica. Un progetto dedicato è NVIDIA SkillSpector. Nel mio flusso una skill esterna non viene installata se la scansione non restituisce SAFE.
  4. Mappa permessi e dati. Scrivi quali cartelle può leggere, quali comandi esegue, se usa la rete, dove conserva i log e come tratta i segreti.
  5. Prova in isolamento. Usa un ambiente temporaneo, dati fittizi, credenziali senza privilegi e nessun accesso ai sistemi di produzione.
  6. Osserva il comportamento. Controlla file creati, richieste di rete, processi e output. Prova anche input anomali e documenti contenenti istruzioni ostili.
  7. Approva, limita e versiona. Installa una versione precisa, concedi il minimo indispensabile e prevedi aggiornamento, rollback e rimozione.

Nel caso di una skill di memoria aggiungerei un controllo su retention e separazione dei clienti. Per una skill che genera codice, test di sicurezza e code review. Per una skill di ricerca e installazione, l’approvazione umana prima di aggiungere qualsiasi nuovo pacchetto.

Quale delle cinque scegliere? Cinque scenari pratici

Scenario 1: libero professionista che scrive contenuti

Stop Slop può diventare l’ultimo controllo prima della revisione manuale. Non serve Claude Mem se si trattano clienti diversi senza una strategia chiara di separazione. La priorità è proteggere bozze, dati e tono personale.

Scenario 2: team software su un prodotto complesso

Claude Mem può ridurre la perdita di contesto e Task Observer può rilevare correzioni ricorrenti. Ma entrambi lavorano su informazioni sensibili: vanno testati su un repository non critico, con segreti esclusi e supervisione degli aggiornamenti proposti.

Scenario 3: agenzia che produce molti prototipi

UI UX Pro Max può accelerare moodboard, design system iniziali e alternative di landing page. Il passaggio successivo deve includere designer, verifica WCAG, test con utenti e dati reali. Non si pubblica soltanto perché la prima schermata “sembra fatta bene”.

Scenario 4: formatore che prepara materiali

Find Skill può scoprire pacchetti per documenti, fogli e slide. La procedura corretta è cercare, selezionare due candidati, leggerli e scansionarli; non installare automaticamente il primo risultato davanti a una classe o su un computer aziendale.

Scenario 5: impresa con processi regolati

Nessuna delle cinque skill dovrebbe entrare direttamente in produzione. Prima servono responsabile del processo, classificazione dei dati, ambiente di prova, log, soglie di autonomia e un piano di risposta agli incidenti. L’utilità potenziale non elimina gli obblighi organizzativi.

Tre video per vedere Claude al lavoro

Le skill acquistano senso quando vengono collegate a un’attività concreta. In questi miei video mostro come Claude passa dalla conversazione al lavoro su documenti e procedure:

Per approfondire puoi leggere anche i tre esempi d’uso di Claude Cowork, la guida su Claude Cowork e la compilazione dei moduli e la pagina del mio corso su Claude per aziende e professionisti.

La vera competenza non è accumulare skill

Il video intercetta una tendenza reale: gli assistenti stanno diventando ambienti componibili. Possiamo aggiungere memoria, procedure editoriali, capacità di progettazione e persino meccanismi che osservano come lavoriamo. È un salto utile, ma cambia anche il modo in cui dobbiamo valutare questi strumenti.

La domanda meno interessante è “quante skill hai installato?”. Quelle importanti sono: chi le ha scritte, che cosa possono fare, quali dati vedono, come vengono aggiornate e chi approva un’azione irreversibile.

Una buona skill riduce lavoro ripetitivo e rende esplicito un metodo. Una cattiva skill rende più efficiente un rischio. La differenza non la fa il nome accattivante del repository, ma la qualità della verifica prima dell’installazione e della supervisione durante l’uso.

Domande frequenti

Le cinque skill del video sono ufficiali di Anthropic?

No. Stop Slop, Claude Mem, UI UX Pro Max, Task Observer e Find Skill sono progetti di terze parti. Anthropic mantiene documentazione, specifiche e un proprio repository pubblico di skill, ma la presenza su GitHub non equivale a un’approvazione ufficiale.

Qual è la migliore skill per Claude?

Dipende dal problema. Stop Slop è orientata alla revisione stilistica, Claude Mem alla continuità tra sessioni, UI UX Pro Max al design, Task Observer al miglioramento delle procedure e Find Skill alla scoperta. La scelta deve considerare valore, dati trattati, permessi e reversibilità.

Una skill per Claude può essere pericolosa?

Sì. Se include script, usa la rete, legge file o installa altri pacchetti, può introdurre rischi di prompt injection, esfiltrazione, dipendenze compromesse o modifiche indesiderate. Va ispezionata e provata in isolamento prima dell’uso reale.

Che cos’è SkillSpector?

SkillSpector è uno strumento open source di NVIDIA per l’analisi statica delle skill degli agenti. Aiuta a individuare pattern sospetti prima dell’installazione, ma non sostituisce la lettura del codice, la limitazione dei permessi e i test in sandbox.

Claude Mem è adatto a documenti riservati?

Non va deciso in astratto. Prima occorre verificare archiviazione, retention, accessi, cancellazione, separazione dei progetti e policy aziendali. Per documenti riservati è prudente iniziare con dati fittizi e coinvolgere chi gestisce privacy e sicurezza.

Le skill sostituiscono la supervisione umana?

No. Rendono un agente più specializzato, ma non garantiscono correttezza. Per azioni ad alto impatto, dati sensibili o modifiche difficili da annullare è opportuno mantenere un’approvazione umana esplicita e log verificabili.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email

Un agente AI prepara una risposta a un cliente, aggiorna il CRM, modifica un file, apre una richiesta di rimborso e programma l’invio di un’email. A quale passaggio deve fermarsi e chiedere il permesso? E quando, invece, può continuare mentre una persona controlla dall’alto?

È qui che entra in gioco la differenza tra human-in-the-loop e human-on-the-loop, IN da una parte e ON dall’altra. Nel primo modello l’essere umano è un passaggio obbligatorio del processo: senza la sua approvazione l’azione non parte. Nel secondo l’agente lavora in autonomia entro limiti prestabiliti, mentre una persona osserva indicatori, controlla campioni e può intervenire o fermare il sistema. Non è una scelta ideologica tra controllo e libertà: dipende dal rischio, dalla reversibilità dell’azione e dalla capacità di accorgersi in tempo di un errore.

La distinzione è particolarmente importante nei sistemi agentici usati in azienda. Un chatbot propone parole; un agente può usare strumenti e produrre effetti nel mondo: inviare, acquistare, modificare, pubblicare, cancellare. Più l’AI passa dal “dire” al “fare”, più occorre progettare con precisione il ruolo umano.

Che cosa significa human-in-the-loop

Human-in-the-loop (HITL) significa che una persona è dentro il flusso operativo. L’agente può analizzare dati, formulare una proposta o preparare un’azione, ma incontra un punto di controllo obbligatorio. L’umano approva, corregge o respinge; soltanto dopo il sistema può proseguire.

È il modello adatto quando una decisione può produrre conseguenze economiche, legali, sanitarie, reputazionali o difficili da annullare. Non basta mostrare un pulsante “Approva”: la persona deve ricevere il contesto necessario, avere tempo sufficiente e poter davvero cambiare la decisione.

Un esempio semplice: l’agente legge un reclamo, consulta l’ordine e propone un rimborso di 280 euro. In modalità human-in-the-loop il responsabile vede motivazione, dati usati e importo, poi autorizza o modifica l’operazione. Il sistema non trasferisce denaro da solo.

Che cosa significa human-on-the-loop

Human-on-the-loop (HOTL) significa che una persona supervisiona il processo senza approvare ogni singola azione. L’agente opera entro un perimetro definito; dashboard, registri, avvisi e controlli a campione permettono al supervisore di capire che cosa sta succedendo e intervenire in caso di anomalia.

È adatto ad attività frequenti, a rischio contenuto, misurabili e facilmente reversibili. L’autonomia non elimina il controllo: lo sposta dalla singola operazione alla qualità complessiva del sistema.

Per esempio, un agente classifica ogni notte centinaia di documenti interni. Il responsabile non conferma ogni etichetta, ma controlla un campione, osserva il tasso di errore e riceve un avviso se cresce oltre la soglia. Le classificazioni restano tracciate e correggibili.

Human-in-the-loop vs human-on-the-loop: la differenza in tabella

Aspetto Human-in-the-loop Human-on-the-loop
Ruolo umano Approva o corregge prima dell’azione Supervisiona il sistema mentre opera
Flusso predefinito L’agente si ferma L’agente continua
Controllo Su ogni caso sensibile Su metriche, anomalie e campioni
Velocità Più bassa e legata alla disponibilità umana Più alta e scalabile
Uso tipico Decisioni ad alto impatto o poco reversibili Attività a basso rischio, osservabili e reversibili
Rischio principale Approvazioni frettolose e “fatica da conferma” Accorgersi troppo tardi di una deriva
Strumenti necessari Gate, spiegazioni, confronto e possibilità di rifiuto Log, soglie, alert, audit e arresto immediato

Attenzione: on-the-loop non significa out-of-the-loop

Esiste una terza condizione: human-out-of-the-loop. L’AI decide e agisce senza approvazione puntuale, senza supervisione operativa efficace o senza una reale possibilità di intervento. Non è un sinonimo di human-on-the-loop.

La differenza sembra sottile finché non arriva un incidente. Se il supervisore riceve un report il giorno dopo, quando l’agente ha già inviato mille comunicazioni sbagliate, non era davvero “sopra il circuito”: era fuori dal circuito.

Il tema è noto da molto prima dell’AI generativa. Nel paper “Ironies of automation” del 1983, Lisanne Bainbridge osservava un paradosso ancora attuale: più il sistema automatizza il lavoro ordinario, più alla persona restano i casi rari e difficili, proprio quelli per cui è complicato mantenere allenamento e consapevolezza. Mica Endsley ha poi analizzato il problema nel lavoro “From Here to Autonomy”, collegandolo alla perdita di consapevolezza situazionale quando l’essere umano viene allontanato troppo dal processo.

La matrice pratica: rischio, reversibilità, osservabilità e tempo

L’articolo di Bajara Notes da cui nasce questa riflessione propone un criterio molto concreto per i team di sviluppo: guardare il costo dell’errore e la reversibilità dell’azione. È una buona base, che possiamo estendere a qualsiasi progetto agentico con quattro domande.

  1. Quanto è grave un errore? Una bozza imperfetta non equivale a un bonifico errato.
  2. L’azione è reversibile? Rinominare un file con cronologia è diverso dal cancellare dati o inviare una comunicazione pubblica.
  3. L’errore è osservabile? Possiamo accorgercene con test, metriche o controlli automatici?
  4. Quanto tempo abbiamo per intervenire? Un alert utile dopo un’ora può essere inutile in un processo che produce danni in pochi secondi.
Rischio e reversibilità Modello consigliato Esempio
Basso rischio, facile annullamento Human-on-the-loop Ordinare documenti interni con cronologia delle modifiche
Rischio medio, errore rilevabile prima dell’impatto On-the-loop con soglie ed escalation Aggiornare campi non critici del CRM e isolare i casi incerti
Rischio alto o annullamento costoso Human-in-the-loop Concedere un rimborso, pubblicare un listino, inviare un contratto
Impatto critico o irreversibile Più controlli umani e separazione dei ruoli Pagamento, terapia, rilascio in produzione o decisione sul personale

Otto esempi concreti di human-in-the-loop

1. Email a clienti e comunicazioni pubbliche

L’agente raccoglie i dati, prepara il testo e suggerisce i destinatari. Una persona verifica tono, fatti, allegati e lista di invio. È un controllo necessario soprattutto per crisi, reclami, variazioni di prezzo e comunicazioni legali.

2. Rimborsi, pagamenti e ordini

L’AI può controllare policy e documenti, ma l’azione che muove denaro richiede autorizzazione. Si può introdurre una soglia: piccoli rimborsi standardizzati vengono gestiti automaticamente; quelli anomali o sopra un importo definito arrivano a un responsabile.

3. Selezione del personale

Un agente può riordinare candidature e mettere in evidenza competenze dichiarate. Non dovrebbe trasformare un punteggio opaco in un rifiuto automatico. Il recruiter deve poter vedere i dati usati, correggere il risultato e valutare elementi che il sistema non conosce.

4. Sanità e percorsi di cura

L’AI può segnalare una possibile anomalia o preparare un riepilogo clinico; diagnosi e terapia richiedono giudizio professionale. Nel mio approfondimento su AI e ruolo del medico il punto centrale è proprio questo: supporto e sostituzione non sono la stessa cosa.

5. Contratti e pareri legali

L’agente confronta clausole, segnala differenze e propone una bozza. Un professionista controlla interpretazione, giurisdizione e rischio prima che il documento venga condiviso o firmato.

6. Deploy e modifiche a database di produzione

L’agente può scrivere codice, test e documentazione in un ambiente isolato. Il passaggio in produzione, una migrazione di dati o la modifica di credenziali richiedono un gate umano, spesso con una seconda approvazione.

7. Decisioni su credito, assicurazioni e frodi

Il sistema può ordinare i casi per rischio. Se blocca un conto, rifiuta una pratica o modifica un premio, serve un riesame effettivo: non una firma automatica su un punteggio incomprensibile.

8. Pubblica amministrazione e servizi essenziali

Un agente può verificare la completezza di una domanda e preparare l’istruttoria. La decisione che incide su diritti, benefici o accesso a un servizio deve restare contestabile e attribuita a un responsabile. È un’applicazione concreta del tema affrontato nell’articolo sull’intelligenza artificiale nella Pubblica Amministrazione.

Otto esempi concreti di human-on-the-loop

1. Classificazione di documenti interni

L’agente assegna cartelle e metadati. Il supervisore controlla campioni settimanali e riceve un alert se aumenta la percentuale di documenti classificati con bassa confidenza.

2. Arricchimento del CRM in modalità reversibile

L’agente completa settore, dimensione e informazioni pubbliche sulle aziende, senza modificare campi critici. Ogni variazione è registrata e può essere annullata; i conflitti vengono inviati a una persona.

3. Preparazione di report ricorrenti

L’AI raccoglie dati da più fonti e genera una sintesi interna. Il responsabile non approva ogni report, ma controlla indicatori di qualità, citazioni e anomalie. Se il documento deve uscire dall’azienda, si aggiunge un gate.

4. Ricerca documentale con escalation

L’agente cerca informazioni, confronta fonti e produce una risposta con link verificabili. Se le fonti sono insufficienti o in conflitto, non improvvisa: chiede aiuto.

5. Sviluppo software in ambienti isolati

L’agente crea test, documentazione o componenti standard su un branch separato. La pipeline automatica controlla il codice e il team esamina le eccezioni. I permessi non includono il rilascio autonomo in produzione.

6. Assistenza clienti per domande standard

Il sistema risponde usando una base di conoscenza approvata, ma passa a un operatore reclami, minacce, richieste economiche, dati sensibili e casi con bassa confidenza. Il supervisore osserva tasso di escalation e correzioni.

7. Gestione di file e fogli di calcolo

Un agente riordina righe, normalizza formati e compila campi derivabili, lavorando su una copia o con cronologia attiva. La persona controlla il risultato complessivo e può ripristinare la versione precedente.

Nel blog trovi anche cinque esempi pratici dell’agente Genspark e una prova di Claude Cowork in tre attività concrete.

8. Monitoraggio tecnico e manutenzione

L’agente individua pattern insoliti, apre ticket e applica correzioni già approvate su sistemi non critici. Se supera una soglia di costo, tocca un servizio sensibile o incontra un evento mai visto, si ferma e chiama il tecnico.

Il modello migliore è spesso ibrido e dinamico

In-the-loop e on-the-loop non devono essere due etichette assegnate una volta per tutte. Lo stesso agente può cambiare modalità a seconda del caso.

  • Una risposta informativa standard può partire in modalità on-the-loop; un reclamo passa in-the-loop.
  • Un rimborso entro 20 euro e conforme alla policy può essere automatico; un importo maggiore richiede approvazione.
  • Una modifica su un ambiente di test può essere sorvegliata; il deploy in produzione richiede un gate.
  • Una ricerca con fonti concordanti può proseguire; fonti in conflitto attivano l’escalation.
  • Dopo una serie di anomalie, il sistema può retrocedere automaticamente da on-the-loop a in-the-loop.

Questa è la vera maturità agentica: non concedere autonomia in blocco, ma costruire una scala di autonomia legata a condizioni osservabili.

Che cosa dice la ricerca sull’interazione tra persone e automazione

Il paper di Parasuraman, Sheridan e Wickens “A model for types and levels of human interaction with automation” propone di non considerare l’automazione come un interruttore acceso o spento. Un sistema può automatizzare in misura diversa raccolta delle informazioni, analisi, scelta e azione. È esattamente ciò che serve per progettare un agente: possiamo lasciargli cercare e confrontare, ma mantenere umana la decisione finale.

Le “Guidelines for Human-AI Interaction” di Amershi e colleghi, presentate alla conferenza CHI 2019 dell’ACM, ricordano che un buon sistema deve rendere chiaro che cosa sa fare, mostrare informazioni contestuali, permettere correzioni e sostenere un controllo umano coerente nel tempo.

Ben Shneiderman, nel lavoro “Human-Centered Artificial Intelligence: Reliable, Safe & Trustworthy”, contesta l’idea che molta automazione implichi necessariamente poco controllo umano. Si possono progettare sistemi con alta automazione e alto controllo: l’agente svolge molto lavoro, ma le persone mantengono comprensione, responsabilità e capacità d’intervento.

Anche l’AI Risk Management Framework 1.0 del NIST insiste su governance, mappatura del contesto, misurazione e gestione del rischio. Non prescrive un unico livello di autonomia: chiede di collegare controlli e responsabilità all’impatto concreto del sistema.

AI Act e supervisione umana: che cosa cambia

Il Regolamento europeo sull’intelligenza artificiale, Regolamento (UE) 2024/1689, dedica l’articolo 14 alla supervisione umana dei sistemi ad alto rischio. È importante non generalizzare: la disposizione riguarda quella specifica categoria di sistemi, non qualunque chatbot o agente.

Il principio, però, è utile a ogni progetto serio. La supervisione deve consentire alle persone di comprendere capacità e limiti, riconoscere anomalie, evitare un affidamento automatico eccessivo, interpretare correttamente l’output, ignorarlo o annullarlo e fermare il sistema. Una casella da spuntare non soddisfa questo obiettivo se l’operatore non ha informazioni, autorità o tempo per agire.

Per approfondire il contesto organizzativo, rimando anche alla guida sulla formazione AI in azienda e AI Act e all’articolo sulle decisioni artificiali che possono aiutare o distorcere le scelte.

Come progettare una supervisione che funzioni davvero

  1. Definire le azioni consentite. Leggere, proporre, scrivere, inviare, acquistare e cancellare non devono avere gli stessi permessi.
  2. Stabilire i gate. Importi, categorie di dati, destinatari, strumenti e condizioni che richiedono approvazione.
  3. Mostrare il contesto. Il supervisore deve vedere fonti, passaggi, incertezze e conseguenze dell’azione.
  4. Costruire escalation reali. L’agente deve saper dire “non lo so” e passare il caso alla persona giusta.
  5. Registrare tutto. Prompt, strumenti usati, dati consultati, output, approvazioni, modifiche e identità di chi interviene.
  6. Preparare l’arresto. Un pulsante, una regola automatica o un limite di spesa devono fermare il processo prima che l’anomalia si moltiplichi.
  7. Testare anche i casi brutti. Dati mancanti, istruzioni in conflitto, prompt injection, servizi non disponibili e richieste fuori policy.
  8. Misurare gli esiti. Non soltanto quante attività sono state completate, ma errori, danni evitati, correzioni, escalation e tempo umano recuperato.

I due fallimenti opposti da evitare

Il primo è mettere una persona dentro ogni passaggio. Dopo cento conferme al giorno, l’approvazione diventa un riflesso. L’agente sembra controllato, ma l’essere umano fa soltanto clic. È la cosiddetta automation bias: tendiamo ad accettare il suggerimento della macchina, soprattutto quando arriva spesso e sembra plausibile.

Il secondo fallimento è mettere una persona “sopra” un processo che non può davvero vedere o fermare. Una dashboard piena di numeri non è supervisione se gli indicatori non mostrano il rischio, gli avvisi arrivano tardi o l’operatore non ha l’autorità per intervenire.

La domanda giusta non è quindi “c’è un umano?”. È: quale decisione può prendere, con quali informazioni e prima di quale conseguenza?

Una checklist per decidere domani mattina

Prima di attivare un agente, classifica ogni azione con queste domande:

  • può causare un danno economico, legale, fisico o reputazionale?
  • coinvolge dati personali, credenziali o categorie sensibili?
  • l’azione è visibile all’esterno?
  • possiamo annullarla in pochi minuti?
  • esiste una metrica capace di rivelare un errore?
  • il supervisore può intervenire prima che il danno si propaghi?
  • l’agente sa riconoscere l’incertezza ed effettuare un’escalation?
  • chi risponde del risultato è chiaramente identificato?

Se il danno potenziale è alto, l’azione poco reversibile o il tempo d’intervento breve, scegli human-in-the-loop. Se rischio e impatto sono contenuti, l’errore è osservabile e il ripristino semplice, puoi valutare human-on-the-loop. Se non puoi rispondere alle domande, non aumentare l’autonomia: prima rendi il processo comprensibile.

Il ruolo umano non sparisce: cambia livello

Con gli agenti AI l’umano non deve necessariamente controllare ogni riga, ogni file o ogni messaggio. Deve progettare il perimetro, definire le eccezioni, osservare gli effetti e assumersi la responsabilità delle decisioni importanti.

Il modello corretto non è “AI libera” contro “AI al guinzaglio”. È un sistema in cui l’autonomia cresce soltanto quando aumentano test, tracciabilità, reversibilità e capacità di intervento.

In altre parole: human-in-the-loop quando serve consenso; human-on-the-loop quando serve supervisione; mai human-out-of-the-loop per distrazione.

Domande frequenti

Qual è la differenza tra human-in-the-loop e human-on-the-loop?

Nel modello human-in-the-loop una persona deve approvare o correggere prima che l’agente compia un’azione sensibile. Nel modello human-on-the-loop l’agente opera entro limiti stabiliti, mentre una persona monitora risultati e anomalie e può intervenire.

Human-on-the-loop significa che l’AI lavora senza controllo?

No. Servono log, metriche, controlli a campione, alert, soglie ed efficaci meccanismi di arresto. Senza questi strumenti il sistema rischia di essere human-out-of-the-loop.

Quando è obbligatoria l’approvazione umana?

È prudente renderla obbligatoria per azioni ad alto impatto o difficili da annullare: pagamenti, decisioni sul personale, salute, contratti, sicurezza, servizi essenziali, pubblicazione esterna e modifiche critiche in produzione.

Si può cambiare livello di autonomia in base al caso?

Sì. È spesso la soluzione migliore: casi standard e reversibili procedono sotto supervisione; importi elevati, bassa confidenza, anomalie o dati sensibili attivano un gate umano.

Quali strumenti servono per supervisionare un agente AI?

Permessi minimi, audit log, dashboard, alert, soglie di costo e rischio, versionamento, rollback, escalation e un arresto immediato. Il supervisore deve anche ricevere contesto sufficiente per valutare le azioni.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email

Succede sempre più spesso: qualcuno mostra una demo in cui un agente AI legge le email, aggiorna il CRM, prepara una presentazione e prenota una riunione. A quel punto parte la domanda: “Possiamo averne uno anche noi?”.

La domanda giusta, però, è un’altra: in quale processo un agente AI crea più valore di una normale automazione? In azienda gli agenti AI servono quando il percorso non è completamente prevedibile, occorre interpretare informazioni, scegliere tra più strumenti e gestire eccezioni. Se i passaggi sono fissi e le regole sono chiare, un workflow tradizionale è spesso più economico, veloce e controllabile.

Questa distinzione è il punto di partenza dell’articolo di Digital4 “C’è un agent per tutto. Ma non tutto ha bisogno di un agent”. Un tema molto attuale: oggi costruire una demo è relativamente facile; trasformarla in uno strumento affidabile è tutto un altro lavoro.

Che cos’è un agente AI, in parole semplici

Un agente AI è un sistema capace di perseguire un obiettivo, osservare ciò che succede, decidere il passo successivo e utilizzare strumenti: per esempio un motore di ricerca, un database, la posta elettronica, un foglio Excel o un gestionale.

La differenza rispetto a un chatbot non è che “scrive meglio”. La differenza è che può agire. E la differenza rispetto a un workflow è che non deve per forza seguire sempre la stessa strada.

Anthropic distingue chiaramente workflow e agenti: nei primi, modelli e strumenti vengono orchestrati attraverso percorsi definiti in anticipo; nei secondi, è il modello a decidere dinamicamente come procedere. Anche la guida pratica di OpenAI alla costruzione degli agenti suggerisce di partire da processi in cui regole rigide e automazioni deterministiche non bastano.

Workflow, assistente o agente? La scelta pratica

Non tutti i problemi aziendali richiedono lo stesso grado di autonomia. Prima di aggiungere la parola “agentico” a una presentazione, conviene usare questa matrice.

Il principio è semplice: usare il livello minimo di autonomia necessario. Più autonomia significa più flessibilità, ma anche più costi, più variabilità e più controlli.

Il test delle cinque domande prima di creare un agente AI

Nei corsi e nei progetti aziendali partirei da cinque domande molto concrete.

  1. Il processo cambia spesso percorso? Se la risposta è no, probabilmente basta un’automazione.
  2. Occorre interpretare informazioni non strutturate? Email, documenti, note e richieste ambigue sono un terreno più adatto agli agenti.
  3. L’agente deve usare più strumenti? Per esempio cercare un dato nel CRM, confrontarlo con un contratto e preparare una risposta.
  4. Possiamo verificare il risultato? Se non esiste un modo per sapere se il lavoro è corretto, non esiste nemmeno un buon progetto.
  5. Un errore è reversibile? Cancellare una bozza non equivale a inviare un bonifico o pubblicare un listino sbagliato.

Se il processo non supera questo test, aggiungere un agente rischia di automatizzare non il lavoro, ma la confusione.

Tre casi in cui un agente AI può avere senso

1. Gestire richieste con molte eccezioni

Immaginiamo un servizio clienti che riceve richieste via email. Un workflow può riconoscere alcune parole e assegnare un’etichetta. Un agente, invece, può leggere la conversazione, consultare la scheda cliente, verificare la policy, cercare un ordine e preparare una risposta o chiedere l’intervento di una persona.

Il valore non sta nel testo prodotto, ma nei passaggi manuali eliminati. Naturalmente l’agente deve avere fonti definite, permessi limitati e regole chiare per l’escalation.

2. Raccogliere dati da strumenti diversi

Molte attività aziendali consistono nel fare il giro delle sette chiese digitali: CRM, gestionale, email, fogli, cartelle condivise e piattaforme analytics. Un agente può cercare le informazioni, controllarne la completezza e restituire una sintesi utilizzabile.

Un esempio concreto è il lavoro sui fogli di calcolo. In questo video mostro un agente Genspark che interviene su un file Excel:

Per approfondire, sul blog trovi anche cinque esempi pratici di utilizzo dell’agente Genspark.

3. Preparare un lavoro che una persona deve approvare

L’agente può cercare fonti, confrontare documenti, compilare una bozza e segnalare le anomalie. La persona prende la decisione finale. È un modello molto più realistico del fantomatico collega digitale che sa tutto e non chiede mai aiuto.

Il punto non è sostituire il giudizio, ma recuperare tempo sulle attività preparatorie. Nel video seguente racconto dieci esempi con cui ho misurato un risparmio complessivo di dieci ore in una settimana:

Qui trovi anche l’articolo completo su come recuperare dieci ore alla settimana con l’AI.

Il lavoro difficile non è scrivere il prompt

Con un agente il prompt conta, ma non basta. Bisogna progettare il contesto: quali dati può vedere, quali fonti deve considerare autorevoli, che cosa deve ricordare, quali strumenti può utilizzare e quando deve fermarsi.

Anthropic parla di context engineering per gli agenti AI: non si progetta soltanto una richiesta, ma l’intero ambiente informativo in cui il sistema deve operare. È un passaggio che approfondisco anche nell’articolo dal prompt al contesto.

Se i documenti sono vecchi, le autorizzazioni sono eccessive o le procedure aziendali si contraddicono, l’agente non risolve il problema. Lo esegue più velocemente.

Come avviare un progetto pilota senza farsi male

Un buon progetto non parte dal super-agente aziendale. Parte da un processo piccolo, frequente e misurabile.

  1. Scegliere un solo processo. Per esempio classificare le richieste commerciali in entrata.
  2. Misurare il punto di partenza. Tempo impiegato, errori, volumi, costi e passaggi manuali.
  3. Definire una job description. Obiettivo, strumenti, fonti, divieti, condizioni di arresto ed escalation.
  4. Limitare i permessi. All’inizio meglio leggere e proporre; l’azione autonoma viene dopo.
  5. Creare casi di test. Non solo richieste normali, ma dati mancanti, istruzioni contraddittorie ed eccezioni.
  6. Tenere una persona nel circuito. Le azioni sensibili devono richiedere approvazione.
  7. Decidere in anticipo quando fermare il progetto. Se costa più del lavoro risparmiato o non raggiunge la qualità minima, si torna a un workflow più semplice.

Quali metriche usare per valutare un agente AI

Contare le risposte generate serve a poco. Le metriche utili sono legate al lavoro:

  • tempo medio per completare un’attività;
  • percentuale di attività completate correttamente;
  • numero di interventi umani necessari;
  • costo per attività completata;
  • tasso di errore e gravità degli errori;
  • numero di escalation corrette e mancate;
  • tracciabilità delle fonti e delle azioni;
  • tempo realmente recuperato dalle persone.

Gartner ha previsto che oltre il 40% dei progetti di agentic AI sarà cancellato entro la fine del 2027, citando costi crescenti, valore poco chiaro e controlli del rischio insufficienti. La lezione non è “gli agenti non funzionano”, ma “una demo non è un risultato aziendale”.

Governance: chi controlla l’agente che controlla il processo?

Un agente deve essere trattato come un componente operativo, non come un collega infallibile. Servono registri delle azioni, gestione delle identità, limiti di spesa, fonti approvate, valutazioni periodiche e una persona responsabile del processo.

Il Playbook del NIST per la gestione del rischio AI propone azioni organizzate attorno a quattro funzioni: governare, mappare, misurare e gestire. È una buona bussola anche per un progetto piccolo.

Attenzione inoltre alla Shadow AI in azienda: se gli strumenti ufficiali sono assenti o troppo complicati, le persone ne adotteranno altri senza controllo. La governance efficace non è un elenco di divieti; è un modo sicuro per ottenere risultati.

E nei casi delicati bisogna ricordare che l’AI può anche influenzare male le scelte. Ne parlo nell’approfondimento sulle decisioni artificiali in azienda.

La regola finale: autonomia solo dove produce valore

Gli agenti AI in azienda possono essere molto utili. Ma la maturità non si misura dal numero di agenti attivati. Si misura dalla capacità di scegliere il processo giusto, assegnare un perimetro chiaro, controllare i risultati e fermarsi quando una soluzione più semplice funziona meglio.

Prima si mette ordine nel processo. Poi si decide che cosa automatizzare. Solo alla fine si valuta quanta autonomia concedere all’AI.

Il futuro del lavoro non sarà popolato soltanto da super-agenti. Sarà fatto soprattutto di buoni strumenti, piccoli automatismi e agenti specializzati che fanno poche cose, verificabili, davvero utili.

Domande frequenti sugli agenti AI in azienda

Qual è la differenza tra un agente AI e un chatbot?

Un chatbot risponde principalmente a richieste. Un agente AI può pianificare più passaggi, scegliere strumenti, osservare i risultati intermedi e compiere azioni per raggiungere un obiettivo.

Quando conviene usare un workflow invece di un agente?

Quando il processo è stabile, i passaggi sono noti, le regole sono chiare e le eccezioni sono poche. In questi casi il workflow è generalmente più semplice, economico e prevedibile.

Quali processi sono adatti a un primo agente AI?

Processi frequenti, circoscritti e misurabili: classificazione delle richieste, raccolta di dati da più fonti, controllo della completezza dei documenti e preparazione di bozze da approvare.

Un agente AI può lavorare senza supervisione umana?

Può farlo solo in attività a basso rischio, ben testate e facilmente reversibili. Per pagamenti, contratti, decisioni sulle persone o comunicazioni pubbliche è prudente mantenere un’approvazione umana.

Come si misura il valore di un agente AI?

Con indicatori operativi: tempo risparmiato, costo per attività, qualità del risultato, errori, escalation, interventi umani e tracciabilità delle azioni.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email