Tag Archivio per: agenti AI

Il carrello sembra quello della settimana scorsa. Il conto, invece, ha deciso di fare carriera. Quando aumentano bollette, carburanti e alimenti, il problema arriva presto sul tavolo della cucina: che cosa possiamo cambiare nella spesa, senza trasformare ogni acquisto in una tesi di economia?

La cronaca offre un punto di partenza preciso. Il 30 settembre 2026 ANSA ha raccontato l’allargamento del caro prezzi, tra energia e alimentari freschi. Nelle stime preliminari dell’Istituto nazionale di statistica per settembre, l’inflazione italiana sale al 4,2% su base annua. I beni energetici aumentano del 22,3%, gli alimentari non lavorati del 5,5%. Il cosiddetto carrello della spesa, che comprende alimentari e prodotti per la casa e la persona, cresce dell’1,7%.

Dietro l’energia ci sono anche le tensioni internazionali. Nelle proiezioni di settembre 2026 della Banca centrale europea, il conflitto in Medio Oriente e lo shock energetico occupano un posto centrale. La BCE descrive una trasmissione graduale dei rincari energetici alle altre componenti dei prezzi. È un quadro complesso: attribuire ogni aumento al supermercato a una singola guerra sarebbe una scorciatoia.

Spendere di più e comprare di meno: attenzione alla differenza

Quando si parla di “calo della spesa”, bisogna capire che cosa cala. Secondo i dati Istat sul commercio al dettaglio di luglio 2026, rispetto a luglio 2025 le vendite alimentari aumentano dello 0,3% in valore e diminuiscono dell’1% in volume. La fotografia è questa: più euro incassati, meno quantità vendute. Il dato aggregato non racconta le scelte di ogni famiglia e, da solo, non dimostra quale fattore abbia causato ciascuna rinuncia.

ChatGPT non può abbassare l’inflazione. Possiamo però usarlo per organizzare acquisti, confrontare informazioni e individuare sprechi nel nostro budget. Qui propongo quindici esperimenti da fare con lo smartphone, con istruzioni da copiare e risultati da controllare.

Per orientarsi nella lettura degli indicatori: il video Istatalk sull’inflazione, collegato dalla pagina ufficiale Istat. È un approfondimento sulla lettura dei dati, non una dimostrazione di ChatGPT.

Prima di cominciare: una foto e una richiesta precisa

Nella documentazione ufficiale sugli input visivi, OpenAI spiega che un’immagine va accompagnata dalla richiesta: che cosa deve osservare l’AI e quale risultato vogliamo? Uno scontrino caricato senza istruzioni è solo uno scontrino caricato.

Uso la logica del mio metodo G.O.L.: guidare, obiettivo, limiti. Per esempio: “Aiutami a organizzare la spesa; estrai questi prodotti; non inventare le righe illeggibili”. Fotografa il documento su un piano, con luce uniforme, controlla il risultato e oscura i dati personali non necessari. Per prezzi attuali e coupon serve una ricerca web, quando disponibile, oppure una fonte che fornisci tu.

Le quindici immagini seguenti sono illustrazioni originali: le interfacce e gli importi rappresentati sono esempi visivi, non schermate reali di ChatGPT, offerte disponibili o risultati di un test di risparmio.

1. Dallo scontrino alla lista della spesa per reparto

Gianluigi Bonanomi mostra uno scontrino e una lista della spesa divisa per reparto sullo smartphone
Fotografa lo scontrino e ricava una lista ordinata per reparto.

Uno scontrino precedente può diventare la base per la prossima lista. Chiedi a ChatGPT di estrarre i prodotti, tradurre le abbreviazioni comprensibili e dividerli tra ortofrutta, latticini, dispensa e cura della casa. Poi togli ciò che hai già e aggiungi ciò che manca.

Il passaggio decisivo è l’ultimo: un acquisto passato non è automaticamente un bisogno futuro. La lista serve a rendere esplicite le scelte, non a ricomprare ogni settimana gli stessi prodotti. Se una riga è indecifrabile, deve restare da verificare.

Leggi questo scontrino. Estrai i prodotti e organizza una lista per reparto. Segnala le righe dubbie. Poi chiedimi che cosa ho già a casa prima di creare la lista definitiva.

2. Confrontare gli scontrini senza farsi ingannare dal totale

L’avatar fotografa scontrini sul tavolo per confrontare gli acquisti
Per trovare un risparmio confronta prodotti, quantità e prezzi, non soltanto i totali.

Raccogli alcuni scontrini di settimane diverse. Chiedi una tabella con negozio, data, prodotto, quantità, prezzo e sconto. Quando il formato non compare sullo scontrino, aggiungi la foto della confezione. Il confronto deve riguardare prodotti uguali o equivalenti, con differenze dichiarate.

Un conto di 39 euro non è più conveniente di uno di 42 se contiene meno prodotti. Puoi invece individuare acquisti ricorrenti e confrontare il prezzo al chilo o al litro. Un singolo scontrino dà un punto di partenza, non dimostra un risparmio.

Confronta questi scontrini. Abbina solo prodotti confrontabili. Calcola il prezzo unitario quando quantità e formato sono noti. Distingui promozioni e prezzi ordinari. Non dedurre la convenienza dal totale.

3. Cercare coupon che servono davvero

L’avatar mostra coupon digitali sul telefono mentre sceglie un prodotto al supermercato
Parti dai prodotti necessari, poi verifica i coupon e le condizioni.

La ricerca dei coupon dovrebbe partire dalla lista, non dalla curiosità per uno sconto. Chiedi a ChatGPT di cercare promozioni sui prodotti che hai deciso di comprare e di riportare il link originale. Controlla nell’app dell’insegna o sul sito indicato scadenza, formato, negozi aderenti, carta fedeltà e spesa minima.

Un codice trovato online non è automaticamente valido alla cassa. E uno sconto che ti spinge a spendere dieci euro in più per risparmiarne due merita almeno un secondo pensiero. Se ChatGPT non può verificare una condizione, deve scriverlo.

Cerca coupon per questi prodotti nella mia zona. Riporta fonte, validità, formato, spesa minima e condizioni. Se non riesci a verificarli, segnala “non verificato”. Non aggiungere prodotti per raggiungere una soglia.

4. Abbinare cibo e vino entro il budget

L’avatar confronta una bottiglia di vino con un suggerimento di abbinamento sullo smartphone
Fissa prima la spesa massima e chiedi un abbinamento per il piatto previsto.

Se hai già previsto una bottiglia per una cena, puoi chiedere un orientamento partendo dal menu. Specifica ingredienti, condimenti, preferenze e tetto di spesa. Per una bottiglia precisa, fornisci le etichette e i prezzi che trovi sullo scaffale, oppure chiedi una ricerca con disponibilità verificata.

L’utilità è scegliere tra alternative dentro il budget. Non serve trasformare un abbinamento in un acquisto aggiuntivo. Anche usare una bottiglia che possiedi già è una possibilità da mettere sul tavolo.

Per questo menu confronta queste bottiglie, con i prezzi allegati. Budget massimo 12 euro. Spiega l’abbinamento e valuta prima i vini che ho già. Non inventare prezzi o disponibilità.

5. Fare la spesa partendo dal frigorifero

L’avatar usa lo smartphone davanti a frigorifero e dispensa aperti
Fotografa ciò che hai già e chiedi ricette con pochi ingredienti mancanti.

Prima del supermercato, apri frigo e dispensa. Scatta foto nelle quali gli alimenti siano riconoscibili e aggiungi quantità, scadenze e contenuto dei contenitori chiusi. ChatGPT può proporti un menu e una lista limitata ai veri ingredienti mancanti.

La foto non rivela quanto riso resta in un barattolo opaco né quando hai aperto una confezione. Conferma l’inventario prima di usare le ricette. Prova una sfida: cinque cene, con non più di cinque prodotti nuovi da acquistare.

Questi sono frigo e dispensa. Elenca ciò che riconosci e chiedimi conferma dei dubbi. Poi proponi cinque cene usando le scorte, con al massimo cinque ingredienti nuovi da comprare.

6. Pianificare il menu con un tetto di spesa

L’avatar mostra un menu settimanale e un budget sul telefono
Trasforma il budget in quantità e ingredienti verificabili.

“Fammi risparmiare” è una richiesta vaga. “Pianifica sette cene per quattro persone entro il budget che ti indico” è già più utile. Aggiungi gusti, tempi di preparazione e scorte. Chiedi di riutilizzare gli stessi ingredienti in ricette diverse e di consolidare le quantità nella lista.

Il totale dipende da prezzi reali: una tabella ordinata con numeri inventati rimane una tabella con numeri inventati. Usa volantini, etichette o il carrello del negozio. Se mancano dati, chiedi un preventivo provvisorio e una lista dei prezzi da controllare.

Pianifica sette cene per quattro persone. Budget: 90 euro. Usa queste scorte e questi prezzi. Somma quantità e costi, lascia un margine per imprevisti e segnala le stime da verificare.

7. Organizzare i pasti in base alle scadenze

L’avatar mostra confezioni alimentari e un piano dei pasti ordinato per priorità
Trascrivi le indicazioni delle confezioni e programma gli alimenti da usare prima.

Puoi fotografare le etichette e chiedere un calendario dei pasti. Aggiungi quando hai aperto le confezioni e come le hai conservate: sono informazioni che l’immagine, da sola, non contiene.

La spiegazione dell’Autorità europea per la sicurezza alimentare distingue le due indicazioni: “da consumarsi entro” riguarda la sicurezza, “da consumarsi preferibilmente entro” la qualità. Per la prima, aspetto e odore gradevoli non autorizzano il consumo dopo la data. ChatGPT può aiutare con il calendario; una fotografia non certifica che un alimento sia sicuro.

Trascrivi le date e le indicazioni di queste etichette, facendomele confermare. Organizza i pasti dando priorità agli alimenti da usare prima. Non inventare scadenze o giudizi di sicurezza dalla foto.

8. Rendere una ricetta meno costosa

L’avatar cucina e confronta ingredienti alternativi per una ricetta economica
Chiedi alternative indicando che cosa vuoi preservare del piatto.

Allega la ricetta e il costo degli ingredienti. Chiedi tre versioni: una con sostituzioni minime, una più economica e una basata soprattutto sulle scorte. Specifica se vuoi preservare sapore, consistenza, velocità o un ingrediente particolare.

Le sostituzioni vanno motivate. Cambiare un ingrediente caratterizzante può dare un buon piatto diverso, ma non una copia perfetta dell’originale. Fai confrontare il costo per porzione e considera la quantità che utilizzi, distinguendola dal prezzo dell’intera confezione.

Proponi tre versioni meno costose di questa ricetta. Usa i prezzi allegati, calcola il costo per porzione e spiega come cambiano gusto e consistenza. Rispetta queste preferenze e questi ingredienti da escludere.

9. Leggere i volantini con una domanda precisa

L’avatar fotografa un volantino e confronta le offerte con la lista della spesa
Seleziona le offerte che corrispondono alla lista e controlla le condizioni.

Su DoveConviene puoi consultare volantini e promozioni dei negozi della tua zona. È un complemento utile: il servizio presenta le offerte, ChatGPT può aiutarti a leggerle rispetto alla tua lista. Allega le pagine pertinenti e indica punto vendita e periodo di validità.

Chiedi di includere eventuali limiti di quantità e tessere richieste. Se confronti più negozi, fai considerare anche spostamento e tempo. Attraversare la città per uno sconto molto piccolo non è automaticamente una buona operazione.

Confronta questi volantini con la mia lista. Seleziona solo gli acquisti necessari e mostra prezzo unitario, validità e condizioni. Calcola il risparmio solo sui prodotti confrontabili e sottrai questi costi di spostamento.

10. Scegliere la confezione usando il prezzo unitario

L’avatar confronta confezioni di pasta di dimensioni diverse e il prezzo al chilo
Confronta €/kg, €/litro o costo per utilizzo, secondo il prodotto.

Fotografa prezzo e quantità di due confezioni. Chiedi il calcolo del costo unitario e controllalo. Per un detersivo, oltre ai litri, considera dosaggio e numero di lavaggi dichiarati: due prodotti con concentrazioni diverse non sono confrontabili soltanto dal volume.

Esempio puramente aritmetico: 500 grammi a 1,40 euro equivalgono a 2,80 euro al chilo; 750 grammi a 1,95 euro equivalgono a 2,60 euro al chilo. Il secondo formato costa meno per unità, ma la scelta dipende anche da quanto utilizzerai davvero.

Calcola il costo unitario di queste confezioni. Mostra formula e risultato. Poi chiedimi il consumo abituale e valuta se il formato maggiore è utile o rischia di lasciarmi prodotto inutilizzato.

11. Dare un secondo menu agli avanzi

L’avatar fotografa avanzi mentre un tablet mostra idee per riutilizzarli
Parti dalle quantità rimaste e limita gli ingredienti da aggiungere.

Dopo cena puoi descrivere ciò che resta e chiedere tre proposte per il giorno seguente. Comunica quantità, ingredienti e conservazione. L’obiettivo è trovare una preparazione realistica con poche aggiunte, non una ricetta che richiede una seconda spesa.

Come complemento puoi valutare Too Good To Go: la sua app permette di prenotare eccedenze alimentari, come le Surprise Bag, e ritirarle negli orari indicati. Dopo il ritiro, puoi fornire a ChatGPT il contenuto effettivo per organizzare i pasti. Controlla prima quantità utilizzabili, esigenze alimentari e costo del tragitto.

Questi sono gli avanzi, le quantità e le informazioni sulla conservazione. Se mancano dati rilevanti chiedimeli. Proponi tre preparazioni con al massimo due ingredienti nuovi. Non dichiarare sicuro un alimento dalla foto.

Per vedere un esempio concreto del servizio: il video della TGR Lombardia su Too Good To Go, pubblicato nell’aprile 2025. È un servizio sull’app, non un tutorial di ChatGPT.

12. Confrontare il piatto pronto con la preparazione in casa

L’avatar confronta un piatto pronto con una preparazione casalinga e valuta costi e tempi
Metti a confronto porzioni, costo degli ingredienti e tempo necessario.

“Fatto in casa costa meno” non deve diventare una risposta automatica. Per il tuo caso chiedi un confronto con porzioni equivalenti, costo degli ingredienti utilizzati, energia stimata e tempo. Distingui il costo della ricetta dall’esborso per comprare tutte le confezioni.

Per l’energia servono consumo in kWh e tariffa. Se non li conosci, ChatGPT può mostrare scenari con ipotesi dichiarate. Anche il tempo ha un peso nella scelta: una soluzione economica che non riesci a preparare durante la settimana resta sulla carta.

Confronta questo piatto pronto con la ricetta casalinga per porzioni equivalenti. Usa i prezzi forniti. Se mancano consumi energetici, mostra ipotesi esplicite. Separa costo consumato, spesa iniziale e tempo.

13. Recuperare budget dagli abbonamenti poco utilizzati

L’avatar controlla gli abbonamenti ricorrenti sul telefono e sul computer
Allarga l’analisi al budget familiare e valuta le spese ricorrenti.

Qui usciamo dal supermercato, ma restiamo nel portafoglio. Elenca gli abbonamenti con costo effettivo, rinnovo e frequenza d’uso. Chiedi un riepilogo annuale e il costo per utilizzo, poi decidi quali mantenere. Aggiungi impegni contrattuali e servizi che consideri essenziali.

Non lasciare che l’AI cancelli qualcosa soltanto perché lo usi poco: potrebbe avere un valore che i numeri non descrivono. Il confronto serve a rendere consapevole la decisione e a capire se esistono spese da ridurre prima di tagliare il budget dei pasti.

Analizza questi abbonamenti e il loro utilizzo. Calcola costo annuale e costo per utilizzo. Evidenzia quelli da valutare, rispettando le mie priorità. Segnala vincoli mancanti e non procedere a disdette.

14. Fermare l’acquisto impulsivo prima della cassa

L’avatar riflette sull’acquisto di cuffie mentre consulta domande sullo smartphone
Chiedi domande critiche prima di cercare una giustificazione all’acquisto.

Quando un prodotto ti tenta, prova a usare ChatGPT come interlocutore critico. Deve chiederti quale problema risolve, se possiedi già un’alternativa e quali costi aggiuntivi comporta. È un esercizio, non un metodo con risparmi garantiti.

Se decidi comunque di comprare, un comparatore come Trovaprezzi.it può integrare la ricerca delle offerte online. Confronta il modello esatto e il costo complessivo con spedizione. Un prezzo più basso per un prodotto che non ti serve rimane una spesa.

Vorrei comprare questo prodotto. Non darmi subito ragione. Fammi cinque domande su necessità, alternative già disponibili, utilizzo e costi aggiuntivi. Poi confrontiamo comprare, aspettare e rinunciare.

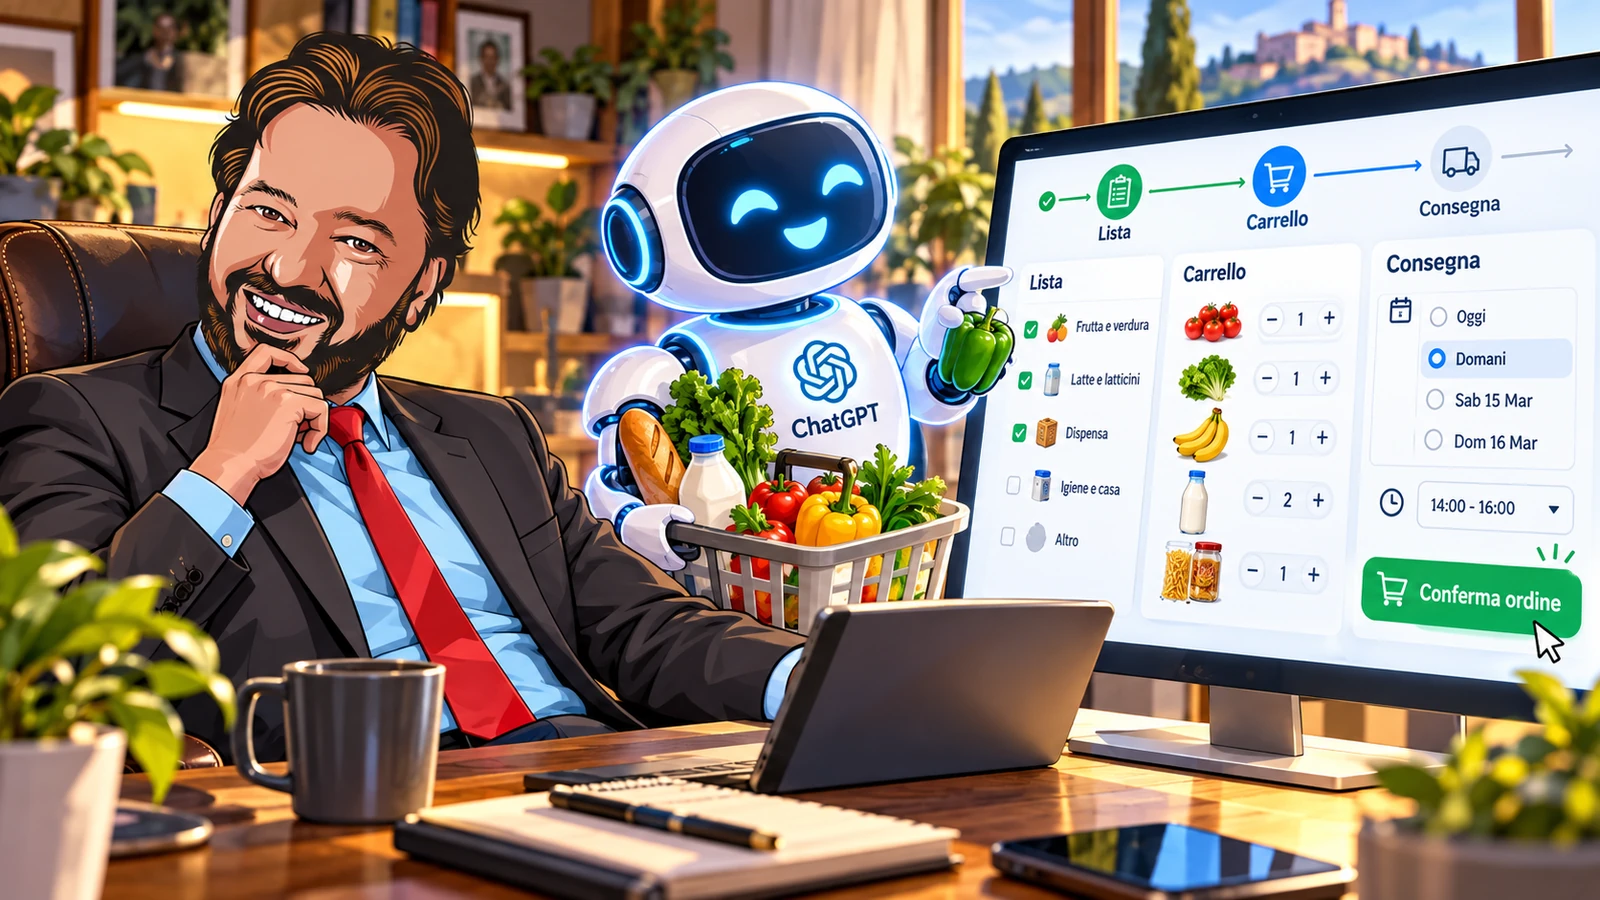
15. Far preparare la spesa online a un agente ChatGPT

L’avatar supervisiona un agente ChatGPT che organizza un carrello della spesa online
L’agente prepara il carrello; tu controlli prodotti, consegna e totale prima dell’acquisto.

Fin qui abbiamo chiesto consigli e confronti. Un agente con accesso al browser può anche provare a lavorare sul sito del negozio: cercare i prodotti, scegliere i formati e predisporre il carrello. La documentazione ufficiale sul browser di ChatGPT Work descrive la possibilità di operare sui siti, ma precisa che disponibilità e accesso dipendono dalla configurazione e che alcuni siti possono bloccare l’automazione. Non è una promessa di compatibilità con ogni supermercato.

La delega va circoscritta: negozio, lista, budget, sostituzioni consentite, quantità e consegna. L’autonomia riguarda la preparazione; la documentazione prevede la tua conferma prima del pagamento. Se l’accesso non riesce, puoi comunque usare l’elenco preparato per completare manualmente il carrello.

Se la funzione è disponibile, prepara un carrello su questo sito con la lista allegata. Budget massimo 80 euro, consegna inclusa. Chiedimi prima di sostituire prodotti. Mostra articoli, quantità, condizioni e totale. Fermati prima del pagamento.

Come capire se stai risparmiando davvero

Per una settimana prova soltanto due attività: inventario prima della spesa e confronto dei prodotti ricorrenti. Annota prezzo, quantità, acquisti non previsti e alimenti rimasti inutilizzati. Poi ripeti il controllo. Se cambia il menu o il numero di persone, segnalo: non avrebbe senso attribuire all’AI un risparmio ottenuto comprando meno cibo per altri motivi.

Per ogni scelta confrontabile puoi usare questo schema: costo dell’alternativa che avresti realmente acquistato, meno costo della scelta effettuata, meno spese aggiuntive. Tieni separati gli acquisti evitati e non conteggiare due volte lo stesso sconto. Se usi servizi a pagamento, considera anche quel costo.

Il consiglio che darei a chi vuole iniziare è molto concreto: fotografa la dispensa, carica due scontrini e chiedi una lista migliore per la prossima spesa. Puoi misurare il risultato al supermercato e a casa. Per una volta, l’AI può essere utile anche senza scrivere una poesia sulle zucchine.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Gli abbonamenti ai chatbot stanno diventando come quelli alle piattaforme televisive: li attivi per una cosa interessante, poi ti ritrovi a mantenerli tutti. Solo che qui, invece di chiedermi dove vedere una serie, devo decidere dove fare il mio lavoro.

Oggi, 1 ottobre 2026, se dovessi scegliere un solo abbonamento per la mia attività di formatore, consulente e autore, sceglierei ChatGPT. E a chi lavora in modo simile al mio suggerisco di valutare la disdetta di Claude a favore di ChatGPT.

Il titolo è provocatorio, la motivazione molto terra terra: creo tante immagini, voglio gestire il lavoro dentro un ambiente coerente e mi interessa sempre di più la possibilità di delegare attività concrete. Claude resta un prodotto da conoscere e provare. Ma la mia carta di credito non deve finanziare un museo dei chatbot.

Claude o ChatGPT: io parto dal lavoro che devo finire

Nei corsi mi chiedono spesso quale sia l’AI migliore. La risposta sensata richiede una seconda domanda: per fare cosa?

Io preparo materiali didattici, scrivo articoli, progetto esercizi, creo copertine, declino il mio avatar in scene diverse e organizzo informazioni da trasformare in contenuti. La qualità del testo conta moltissimo. Conta anche ciò che succede dopo il testo.

Quando preparo un articolo, voglio poter ragionare sulla tesi, cercare le fonti, riscrivere un passaggio, creare l’immagine e preparare i materiali collegati. Ogni cambio di strumento mi chiede di trasportare pezzi di contesto. E spesso il fattorino sono io.

La mia preferenza per ChatGPT nasce da questo uso quotidiano. Sto scegliendo un ambiente di lavoro sulla base delle mie attività, senza pretendere di incoronare il miglior modello linguistico del pianeta.

Creo molte immagini: per me è un requisito, non un extra

Se fate soltanto analisi testuale, potete assegnare alla generazione di immagini un peso vicino allo zero. Nel mio caso pesa parecchio: un’immagine può aprire una lezione, rendere comprensibile un concetto o diventare la copertina di questo blog.

ChatGPT permette di generare e modificare immagini nella conversazione, anche lavorando con riferimenti visivi. Posso partire dal mio avatar, chiedere una scena, valutarla e correggerla nello stesso flusso.

Per il confronto serve una distinzione: capire un’immagine e generarla sono capacità diverse. Anthropic precisa nella sua documentazione ufficiale che Claude non produce immagini o video fotorealistici. Questo non significa che non possa aiutare con grafici, codice o altri lavori visuali. Significa che, per il tipo di illustrazioni e copertine che mi serve, la generazione integrata in ChatGPT è un vantaggio concreto.

Non voglio produrre un prompt in un chatbot, portarlo altrove, scaricare l’immagine e rientrare per ricominciare. Voglio dire: “Usa il mio avatar, fagli spiegare questo concetto, mantieni lo stile, cambia l’espressione”. Poi controllare il risultato. La comodità, quando la usi ogni giorno, smette di essere un dettaglio.

Nel mio video sulle infografiche con ChatGPT mostro due esperimenti: un menu e un curriculum trasformati in materiali visuali. Sono esempi di ciò che intendo quando parlo di un’AI utile alla comunicazione.

Nel mio lavoro ChatGPT ha soppiantato Canva

Lo dico in modo netto: nel mio flusso di lavoro ChatGPT ha soppiantato Canva. Per le immagini e le copertine che mi servono, oggi preferisco partire dalla conversazione e arrivare al risultato senza aprire un altro ambiente.

Questa è una testimonianza personale. Non dimostra che Canva sia superfluo per chiunque. Se lavorate con impaginazioni complesse, elementi da modificare singolarmente, modelli condivisi o esigenze grafiche molto precise, dovete verificare che il vostro lavoro sia davvero coperto.

Io ho scoperto che, per ciò che produco, mi conviene descrivere un’intenzione visiva e rifinirla parlando. Mi interessa meno spostare un elemento di quattro pixel e molto di più trovare una metafora che funzioni in aula. Poi guardo il file: testi, proporzioni, coerenza dell’avatar. Le immagini AI vanno controllate, anche quando sembrano già pronte.

La parte agentica: meno suggerimenti, più lavoro svolto

La seconda ragione è la direzione che sta prendendo ChatGPT come ambiente operativo. La parte agentica mi interessa perché porta la conversazione dentro processi che hanno più passaggi e un risultato da consegnare.

Per il mio lavoro immagino attività molto concrete: recuperare materiali per un corso, organizzarli, preparare una proposta, confrontare documenti, creare una bozza di follow-up. Ogni attività richiede strumenti disponibili, accessi appropriati e controlli. La promessa diventa utile quando il risultato è verificabile.

Nella guida ufficiale all’uso di ChatGPT, i plugin collegano la conversazione a informazioni e azioni di altri servizi. Il vantaggio che cerco è poter orchestrare questi passaggi da un solo ambiente. I servizi esterni possono esserci: voglio ridurre la necessità di aprirli e gestirli manualmente uno per uno.

Ne ho scritto anche parlando di quando servono davvero gli agenti AI in azienda. Un’automazione semplice può essere sufficiente per un compito stabile. La flessibilità dell’agente ha senso quando il percorso cambia e servono decisioni intermedie.

Skill e plugin: voglio conservare il mio metodo

Una delle cose che mi entusiasma di più è smettere di rispiegare ogni volta come lavoro. Il mio tono, la struttura di una proposta formativa, i controlli sulle fonti, il formato degli esercizi: sono procedure ricorrenti.

La documentazione di OpenAI sulle skill descrive pacchetti di istruzioni, risorse ed eventuali script per svolgere compiti specifici. I plugin possono distribuire queste procedure insieme ai collegamenti agli strumenti. In pratica, posso cercare di rendere riutilizzabile un modo di lavorare, invece di conservare soltanto il prompt dell’ultima volta.

Ho raccontato il tema in “Skill AI: il kung fu dei chatbot” e nella guida su skill e plugin di ChatGPT. Per un formatore è interessante: una procedura per progettare laboratori può diventare una risorsa da migliorare nel tempo.

Per correttezza, le skill non sono un’esclusiva di ChatGPT. Anche Claude le supporta, come spiega Anthropic nella documentazione sulle Agent Skills. La mia preferenza dipende dalla combinazione che trovo utile: procedure riutilizzabili, collegamenti ai servizi e immagini dentro il mio ambiente principale.

I Dots mi intrigano: un agente che continua tra una conversazione e l’altra

Tra le novità che mi fanno guardare con interesse a ChatGPT ci sono i Dots, presentati nell’aggiornamento DevDay del 29 settembre 2026.

Secondo la guida ufficiale ai Dots, si tratta di agenti che lavorano tra una conversazione e l’altra, usando un proprio computer nel cloud e le applicazioni collegate. Possono riportare risultati e coinvolgere l’utente quando una decisione richiede il suo giudizio. Il rilascio è graduale agli account idonei: non va dato per scontato che siano già disponibili per tutti.

Per me la prospettiva è interessante. Penso a un’attività di ricerca per un corso che continua mentre faccio altro, oppure alla preparazione di materiali che torna sul mio tavolo quando c’è qualcosa da valutare. Sono possibili usi da testare, non risultati che dichiaro di avere già ottenuto con i Dots.

Prima di delegare, dovrò definire obiettivo, limiti e momenti di revisione. La novità mi incuriosisce proprio perché potrebbe rendere più continua la collaborazione. Il collaudo, però, si fa con il lavoro reale.

In questo mio video racconto come ho recuperato tempo con l’AI. È un’esperienza precedente ai Dots, utile per capire il criterio con cui valuto anche questa novità: quanto lavoro utile riesco davvero a completare?

Il costo: sui token devo correggere la mia impressione

La mia impressione iniziale era che ChatGPT costasse meno anche in termini di token. Detto così è troppo generico. ChatGPT è un prodotto; le tariffe API riguardano modelli e modalità di utilizzo specifici. Inoltre non corrispondono automaticamente al prezzo o ai limiti di un abbonamento.

Le tariffe API pubblicate da OpenAI e quelle nella presentazione ufficiale di Claude Sonnet 5.5 danno questi esempi al 1 ottobre 2026:

Modello Input per 1 milione di token Output per 1 milione di token
OpenAI GPT-6.1 Sol 2 dollari 10 dollari
Anthropic Claude Sonnet 5.5 2 dollari 10 dollari
OpenAI GPT-6 Luna 0,10 dollari 0,50 dollari

Per OpenAI sono le tariffe Standard per contesto breve, senza cache; per Anthropic sono le tariffe base di input e output. La tabella non comprende strumenti, immagini e altre voci di costo. E non è una classifica di qualità: Luna e Sonnet 5.5 non diventano equivalenti solo perché stanno nella stessa tabella.

Sol e Sonnet, in questo confronto, hanno lo stesso prezzo unitario di input e output. OpenAI offre anche un modello molto più economico, ma va verificato se sia adeguato al compito. Contano pure i token effettivamente consumati per arrivare a un risultato corretto.

Per l’abbonamento, la documentazione sui prezzi di ChatGPT Work e Codex distingue espressamente le tariffe API dall’utilizzo incluso nei piani. Chi vuole approfondire trova sul blog la mia guida ai token AI e al risparmio.

La convenienza che mi interessa è quindi questa: quanto mi costa finire il lavoro? Devo includere gli altri abbonamenti che mi servono, i passaggi manuali e il tempo di verifica. Nel mio caso la possibilità di creare anche le immagini nello stesso ambiente rende ChatGPT più interessante. Per dichiarare un risparmio numerico preciso servirebbe misurarlo.

ChatGPT mi sembra meno fighetto. È un giudizio, non un benchmark

Qualche giorno fa mi sono chiesto sul blog se Claude fosse un’intelligenza artificiale fighetta. Riprendo l’espressione con lo stesso intento ironico.

Claude mi dà l’impressione di un interlocutore elegante, colto, molto attento al modo in cui presenta il lavoro. ChatGPT, nel mio uso, somiglia di più a un banco da lavoro su cui appoggiare una bozza, una foto, un foglio di calcolo e una richiesta ancora confusa.

È una percezione personale del prodotto. Non dimostra che Claude sia meno capace o meno operativo. E certamente non rende ChatGPT affidabile per decreto. Anche lui può sbagliare o darmi ragione troppo facilmente: ho dedicato un articolo alla tendenza dei chatbot ad assecondarci.

In questa scelta lascio fuori considerazioni politiche e geopolitiche. Sto valutando il rapporto tra un prodotto e le mie necessità professionali. Mi trovo meglio con l’ambiente che mi invita a provare, correggere e arrivare al file finito. Il chatbot può anche avere il cardigan di cashmere, ma io devo consegnare una copertina.

A chi suggerisco davvero di disdire Claude

Il mio consiglio riguarda soprattutto chi mi assomiglia nel modo di lavorare: produce molti contenuti visuali, vuole gestire testo e immagini nello stesso ambiente, è interessato a procedure riutilizzabili e sta sperimentando attività agentiche.

Per chi lavora prevalentemente su testi, codice o documenti e ottiene risultati migliori con Claude, la scelta può essere diversa. Anche Anthropic continua a sviluppare capacità operative: basta leggere la presentazione di Sonnet 5.5. Sarebbe poco serio raccontare una gara già chiusa.

Prima di disdire, farei una prova semplice: prendete tre vostri lavori recenti e completateli in entrambi gli ambienti. Misurate risultato, tempo totale, correzioni e strumenti aggiuntivi necessari. Poi controllate i limiti del piano che intendete pagare. Se ChatGPT copre bene quei lavori, la disdetta diventa una scelta ragionata.

Oggi, nell’ottobre 2026, per il mio lavoro sceglierei ChatGPT. Le immagini integrate sono la ragione più concreta; skill, plugin e attività agentiche rafforzano la scelta; i Dots aggiungono una prospettiva che voglio esplorare.

Tra qualche mese potrei cambiare idea. Un abbonamento si rinnova ogni mese. Il pensiero dovrebbe farlo almeno altrettanto spesso.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
Inviaci email

Un agente AI può leggere una richiesta, consultare documenti, preparare una risposta e avviare attività successive. Nella Pubblica Amministrazione (PA), il valore sta nel ridurre tempi e passaggi ripetitivi. Il limite è altrettanto chiaro: più il sistema agisce o incide sui diritti, più servono responsabilità, tracciabilità e controllo umano.

Un chatbot risponde a una domanda. Un agente può coordinare più passaggi, usare strumenti e proporre o compiere azioni entro regole definite. La differenza pratica non dipende dal nome commerciale, ma da quali dati il sistema tratta, quali permessi possiede e quali conseguenze produce.

12 esempi concreti di agenti AI nella PA

  1. Smistamento delle email: classifica le richieste in entrata, suggerisce l’ufficio competente e prepara una bozza di inoltro. Un dipendente controlla destinatario e contenuto prima dell’invio.
  2. Sportello informativo: risponde su orari, modulistica, requisiti e scadenze usando fonti ufficiali aggiornate. I casi individuali o incerti passano a un operatore.
  3. Controllo formale delle pratiche: verifica la presenza degli allegati e segnala campi mancanti. Non dichiara da solo una domanda ammissibile o inammissibile.
  4. Assistente per bandi e contributi: estrae requisiti, date e documenti da un bando e crea una checklist. L’ufficio verifica ogni riferimento sul testo ufficiale.
  5. Bozze di atti e comunicazioni: organizza premesse e riferimenti per una determina, delibera o lettera. Il responsabile verifica fatti, motivazione, competenza e norme applicabili.
  6. Ricerca in regolamenti e delibere: trova passaggi pertinenti e restituisce citazioni con collegamento al documento originale, compresa la data e la versione.
  7. Monitoraggio scadenze: individua date in documenti e calendari, prepara promemoria e segnala ritardi. Le scadenze vanno confermate alla fonte.
  8. Supporto ai servizi sociali: riassume la documentazione e indica quali informazioni mancano, lasciando valutazioni e decisioni all’operatore.
  9. Segnalazioni sul territorio: raggruppa richieste su buche, illuminazione e rifiuti, proponendo una priorità con criteri espliciti. L’ufficio conferma l’assegnazione.
  10. Semplificazione e accessibilità: riscrive avvisi in linguaggio chiaro e prepara traduzioni, da verificare per accuratezza e accessibilità.
  11. Supporto agli obblighi di trasparenza: individua possibili omissioni e prepara documenti per la pubblicazione; il responsabile controlla dati personali, oscuramenti e base giuridica.
  12. Acquisti e contratti: sintetizza capitolati, confronta requisiti documentali e monitora scadenze esecutive. Non seleziona autonomamente fornitori o attribuisce punteggi decisivi.

Gli esempi sono proposte operative da valutare nel contesto dell’ente. L’OCSE, nel rapporto Governing with Artificial Intelligence, analizza 200 casi d’uso in 11 funzioni pubbliche e rileva opportunità di automazione, supporto decisionale e rilevazione di anomalie, insieme a rischi di opacità, dati distorti, sicurezza e divario digitale. Il Joint Research Centre della Commissione europea mappa casi europei per processi interni, servizi ai cittadini e supporto alle politiche pubbliche.

Limiti: quando l’agente non deve diventare il funzionario

Un agente può sbagliare con sicurezza. Può usare una norma superata, confondere una bozza con un atto vigente, omettere un’eccezione o essere tratto in errore da un documento manipolato. Una risposta fluente non è una prova di correttezza.

La supervisione umana deve essere effettiva: il dipendente deve avere tempo, competenza e potere per controllare, correggere e fermare il sistema. Un’approvazione automatica o frettolosa rende il controllo solo formale. Occorrono permessi minimi, registri delle operazioni, fonti verificabili e modalità di annullamento per le azioni reversibili.

Il Consiglio d’Europa, nel lavoro su AI e diritto amministrativo, richiama garanzie di trasparenza e responsabilità per prevenire o rimediare a possibili lesioni dei diritti. La PA deve anche considerare accessibilità, sicurezza, qualità dei dati, dipendenza dal fornitore e impatto sui gruppi più vulnerabili.

Quali obblighi di legge riguardano gli agenti AI nella PA

AI Act: regole e calendario aggiornati

Il riferimento europeo è il Regolamento (UE) 2024/1689, AI Act, come modificato dal Regolamento (UE) 2026/1744. Quest’ultimo ha rinviato al 2 dicembre 2027 l’applicazione di determinate regole per i sistemi ad alto rischio autonomi e al 2 agosto 2028 per quelli integrati in prodotti. Il rinvio riguarda quelle specifiche regole, non abroga GDPR, procedimento amministrativo o gli obblighi AI Act già applicabili. La classificazione dipende dallo scopo e dall’uso effettivo, non dal fatto che un software sia chiamato “agente”.

Quando un sistema rientra nelle categorie ad alto rischio, l’amministrazione deve verificare gli obblighi applicabili al proprio ruolo di deployer, seguire le istruzioni del fornitore e predisporre la supervisione e la documentazione previste. Per determinati sistemi ad alto rischio impiegati da organismi pubblici, l’articolo 27 prevede una valutazione d’impatto sui diritti fondamentali prima dell’uso; questa integra, quando necessaria, la valutazione d’impatto privacy prevista dal GDPR.

Legge italiana n. 132/2025

La Legge 23 settembre 2025, n. 132 definisce principi nazionali per l’uso responsabile dell’intelligenza artificiale. L’articolo 14 tratta l’uso dell’AI nelle pubbliche amministrazioni, orientandolo a efficienza e qualità dei servizi e richiamando conoscibilità del funzionamento e tracciabilità dell’utilizzo.

GDPR, legge 241/1990 e Codice dell’Amministrazione Digitale

Se vengono trattati dati personali, valgono i principi GDPR: base giuridica, minimizzazione, trasparenza, sicurezza, conservazione limitata e gestione dei diritti. L’articolo 22 è rilevante quando una persona è sottoposta a una decisione basata unicamente su trattamento automatizzato con effetti giuridici o analogamente significativi. La pagina del Garante Privacy sulle decisioni automatizzate raccoglie riferimenti e linee guida.

Restano inoltre centrali la Legge 241/1990, con l’obbligo di motivazione dei provvedimenti, e il Codice dell’Amministrazione Digitale. Usare un agente non trasferisce la responsabilità pubblica al software o al fornitore.

AgID e gli atti di indirizzo

Il Piano Triennale per l’informatica nella PA 2024-2026, aggiornamento 2026, fornisce indirizzi strategici e operativi. Al 26 settembre 2026, AgID indica che l’iter per le linee guida sull’adozione è in corso e che i commenti sulle bozze relative a sviluppo e procurement sono in analisi. Le bozze sono autorevoli documenti di indirizzo, ma non vanno presentate come linee guida definitive già vigenti. Tra i riferimenti utili ci sono anche la ricerca OCSE, i casi AI in the European public sector del portale Interoperable Europe e il manuale del Consiglio d’Europa The Administration and You.

La mia esperienza con AI e agenti nella PA

Mi occupo di formazione e consulenza sull’intelligenza artificiale generativa e ho lavorato con enti e personale della PA su casi d’uso, competenze e progettazione di esercitazioni. Nel percorso rivolto ai segretari comunali ho affrontato, tra gli altri, agenti per bandi, analisi documentale, monitoraggio delle comunicazioni e automazioni di Outlook. Sul mio sito sono consultabili i percorsi formativi, anche per la Pubblica Amministrazione, e un intervento documentato per PA Social sul digitale nella PA.

Il mio approccio è partire dai compiti quotidiani e chiedere: quali fonti consulta l’agente? Quali azioni può compiere? Chi controlla il risultato? Come si ricostruisce un errore? Ho portato queste domande in aula e nei laboratori dedicati agli agenti. La tecnologia è la parte visibile; il lavoro vero è chiarire il processo e i confini della delega.

Come partire in modo sensato

Conviene iniziare da attività interne e reversibili: ricerca nei documenti approvati, bozze, promemoria e classificazione delle richieste. Si misurano accuratezza, tempo risparmiato, errori e qualità percepita. Poi si valutano accessi ai gestionali e azioni operative, con permessi minimi e approvazione umana prima di inviare comunicazioni o modificare dati rilevanti.

Un agente ben progettato non è quello che agisce sempre. È quello che sa quando fermarsi, mostra da dove trae le informazioni e lascia all’amministrazione la responsabilità delle decisioni.

Un approfondimento autorevole sugli agenti AI nella PA

Il webinar OCSE che presenta il rapporto Governing with Artificial Intelligence raccoglie esempi e discussioni su opportunità, rischi e condizioni per un uso affidabile dell’AI nel governo.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
Inviaci email

Da Bauman all’identità e all’intelligenza
liquida

Il concetto di intelligenza liquida nasce da una trasformazione che Zygmunt Bauman seppe osservare con largo anticipo. Il sociologo usò la metafora della liquidità per raccontare una
società nella quale le forme non restano stabili abbastanza a lungo da
diventare punti di riferimento. Nella modernità “solida” il lavoro,
l’identità, le istituzioni, le appartenenze e perfino le relazioni
sembravano possedere una struttura durevole. Nella modernità liquida,
invece, tutto deve adattarsi, cambiare forma, scorrere.

In Modernità
liquida
, pubblicato nel 2000, Bauman descrive il passaggio da
una modernità pesante, legata all’hardware, a una modernità leggera,
mobile e sempre più fondata sul software.

Copertina del libro Modernità liquida di Zygmunt Bauman
Modernità liquida di Zygmunt Bauman, Editori Laterza.

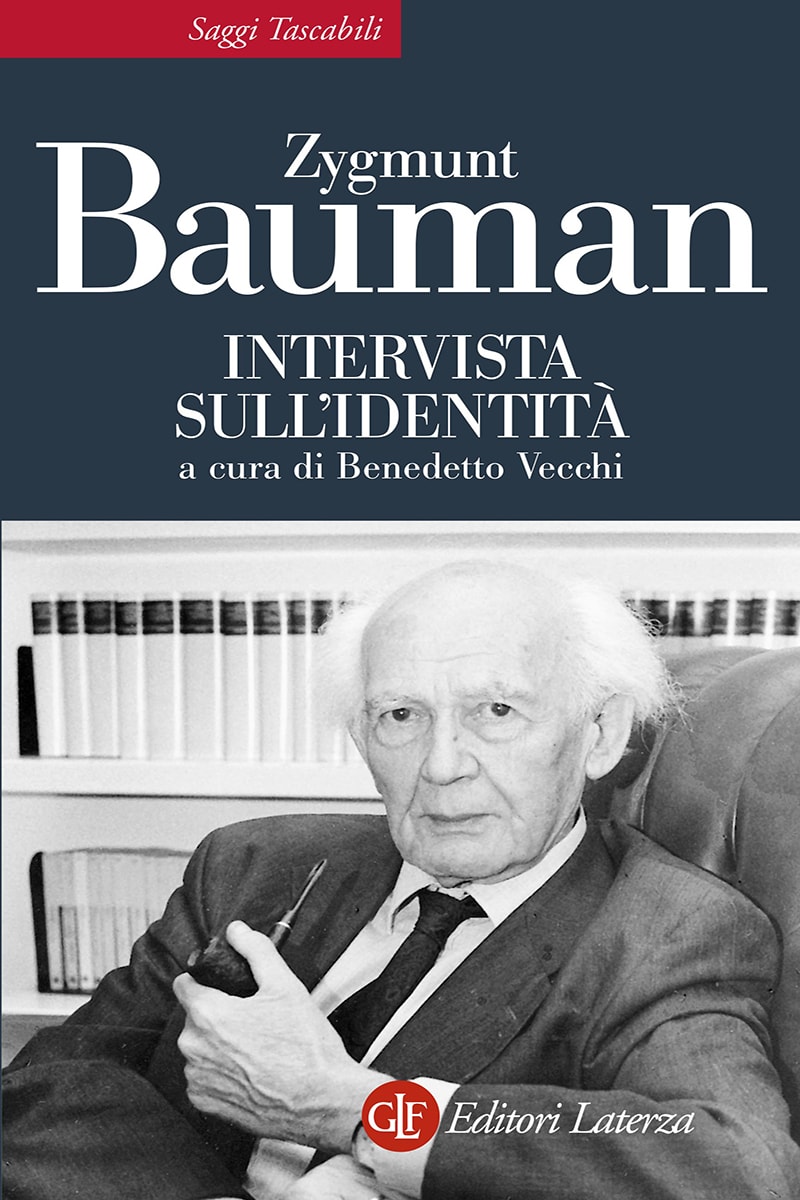
In Intervista
sull’identità
, l’identità stessa diventa precaria, simile a un
vestito che si usa finché serve. Non è più soltanto qualcosa che siamo:
è qualcosa che costruiamo, modifichiamo e rimettiamo continuamente in
discussione.

Copertina del libro Intervista sull'identità di Zygmunt Bauman
Intervista sull’identità di Zygmunt Bauman, Editori Laterza.

È importante partire da qui perché la liquidità non significa
semplicemente digitalizzazione. Indica qualcosa di più profondo: la
separazione tra una funzione e il contenitore che per secoli l’ha resa
possibile.

Il lavoro si separa dall’ufficio. La relazione si separa dalla
vicinanza fisica. L’identità si separa da un’unica appartenenza stabile.
La musica si separa dal disco.

Ora l’intelligenza si sta separando dalla mente che la produce.

Prima la musica, poi
l’intelligenza

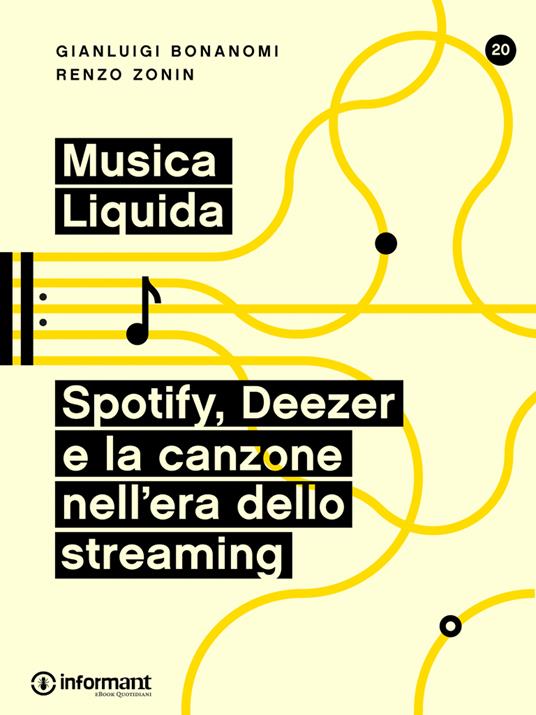
Nel 2014, insieme a Renzo Zonin, pubblicai Musica
liquida. Spotify, Deezer e la canzone nell’era dello streaming
.
Il cuore di quel cambiamento non era l’MP3 e nemmeno Spotify in sé. Era
il passaggio dal possesso all’accesso.

Copertina del libro Musica liquida di Gianluigi Bonanomi e Renzo Zonin
Musica liquida di Gianluigi Bonanomi e Renzo Zonin, Informant,
2014.

Per ascoltare una canzone non serviva più acquistare e conservare un
oggetto. Non occorreva sapere in quale scaffale fosse il CD, né
trasferire fisicamente un supporto da una persona all’altra. La musica
diventava un flusso: disponibile su richiesta, potenzialmente
sterminato, accessibile da dispositivi diversi, organizzato da algoritmi
e pagato attraverso un abbonamento.

La musica non era diventata meno importante. Era cambiata la sua
condizione materiale e, insieme a quella, erano cambiati i nostri
comportamenti. Abbiamo iniziato ad ascoltare più brani, a saltarli
prima, a delegare la scoperta alle piattaforme, a costruire playlist
invece di collezioni. L’abbondanza ha ampliato le possibilità, ma ha
anche modificato l’attenzione e trasferito una parte del potere dagli
artisti e dagli ascoltatori agli intermediari digitali.

Oggi sta accadendo qualcosa di simile con l’intelligenza: la capacità cognitiva diventa accessibile, modulare e sempre più liquida.

Per ottenere una traduzione, un’analisi, una sintesi, una bozza, un
confronto tra documenti o una prima ipotesi strategica non dobbiamo
necessariamente possedere in anticipo tutte le competenze necessarie.
Possiamo accedere, per pochi secondi o per alcune ore, a una capacità
cognitiva esterna. La interroghiamo, la indirizziamo, la combiniamo con
dati e strumenti. Poi la spegniamo.

Come una canzone in streaming, anche una porzione di lavoro cognitivo
arriva quando serve.

Che cosa intendo per
“intelligenza liquida”

Uso questa espressione come metafora sociale e tecnologica, non come
nuova categoria psicologica. In psicometria esiste già il concetto di intelligenza
fluida
nella teoria di Cattell e Horn
: è la capacità di
affrontare problemi nuovi senza affidarsi soprattutto a conoscenze già
acquisite. Qui parlo di altro.

Chiamo intelligenza liquida la capacità cognitiva
che:

  • è disponibile a richiesta;
  • non è legata stabilmente a una singola persona;
  • può scorrere tra applicazioni, documenti, database e
    dispositivi;
  • può essere combinata con altre intelligenze, umane o
    artificiali;
  • si misura e si acquista a consumo, attraverso token, crediti o
    abbonamenti;
  • può aumentare o diminuire in pochi istanti, secondo il problema da
    affrontare.

La formula, provvisoria, potrebbe essere questa:

L’intelligenza liquida è capacità cognitiva separata dal suo
portatore, resa accessibile come flusso, componibile come software e
consumabile come servizio.

Non vive necessariamente in un robot umanoide. Più spesso abita una
casella di posta, un CRM, un browser, un foglio elettronico o un agente
che legge una richiesta, consulta più fonti, esegue una procedura e
propone un risultato.

Il chatbot è stato soltanto il rubinetto. Dietro quel rubinetto sta
crescendo un acquedotto cognitivo.

L’esplosione non
riguarda soltanto la potenza

Quando si parla di intelligenza artificiale, si osservano soprattutto
i modelli più potenti. Ma la trasformazione decisiva nasce dall’incontro
di almeno tre curve.

La prima è l’aumento delle capacità. Lo Stanford
AI Index 2026
segnala progressi rapidi nei benchmark più
difficili, insieme a prestazioni sempre più rilevanti in ambiti
professionali come fiscalità, finanza, diritto e gestione dei mutui.
Avverte però anche che l’intelligenza delle macchine resta
“frastagliata”: un sistema può risolvere problemi matematici avanzati e
fallire in compiti apparentemente banali.

La seconda curva è la riduzione del prezzo. Secondo lo Stanford
AI Index 2025
, tra novembre 2022 e ottobre 2024 il costo per
interrogare un modello con prestazioni paragonabili a GPT-3.5 sul
benchmark MMLU è sceso da 20 dollari a 7 centesimi per milione di token,
una riduzione superiore a 280 volte. Il dato non significa che ogni
forma di AI diventerà quasi gratuita: i modelli di frontiera,
l’infrastruttura, l’energia e le applicazioni complesse restano costosi.
Mostra però una direzione precisa: una stessa unità di capacità tende a
diventare più accessibile.

La terza curva è la diffusione. Il capitolo economico dello Stanford
AI Index 2026
stima che l’AI generativa abbia raggiunto il 53%
di adozione in tre anni e che nel 2025 il 70% delle organizzazioni
intervistate la utilizzasse in almeno una funzione aziendale. Non tutte
la usano bene e l’impiego degli agenti è ancora iniziale, ma il
passaggio dalla curiosità all’infrastruttura è già cominciato.

Questa è l’esplosione dell’intelligenza liquida che ci attende: non un’unica superintelligenza
che compare improvvisamente, ma miliardi di piccoli atti cognitivi
prodotti, acquistati, delegati e incorporati in ogni processo.

Dall’automazione
delle braccia alla disponibilità di cognizione

Le rivoluzioni industriali precedenti hanno moltiplicato soprattutto
la forza, la velocità, l’energia e la capacità di coordinare la
produzione. Macchine a vapore, elettricità, catene di montaggio,
computer e reti hanno progressivamente esteso ciò che un essere umano
poteva fare.

L’AI generativa introduce qualcosa di diverso: rende scalabili
attività che consideravamo cognitive. Scrivere, classificare,
riassumere, tradurre, programmare, progettare una sequenza operativa,
cercare analogie, simulare un interlocutore, preparare alternative.

Non tutto questo equivale a “pensare” nel senso umano del termine. Un
modello non possiede automaticamente esperienza, responsabilità,
intenzione o coscienza. Ma può fornire una prestazione cognitiva utile.
Per chi lavora, la differenza filosofica resta enorme; sul piano
operativo, invece, il confine inizia a spostarsi.

Studi come quelli di METR
sugli orizzonti temporali dei compiti
cercano di misurare per quanto
tempo un agente riesca a lavorare autonomamente su attività software
prima che la probabilità di successo crolli. I risultati mostrano una
crescita rapida, ma vanno letti senza estrapolazioni automatiche:
riguardano famiglie specifiche di compiti e non dimostrano che gli
agenti siano già affidabili in ogni lavoro reale.

La capacità disponibile aumenta, ma la responsabilità non può essere
messa in streaming.

È davvero la quinta
rivoluzione industriale?

L’espressione “quinta rivoluzione industriale” è affascinante, ma va
usata con cautela. Non esiste un confine storico universalmente
riconosciuto che separi una quarta e una quinta rivoluzione.

La Commissione
europea
parla di Industry 5.0 come di un
completamento, non di una sostituzione, del paradigma 4.0. Al centro
mette tre principi: sostenibilità, resilienza e centralità della
persona. È una precisazione importante: una fabbrica più automatizzata
non diventa automaticamente più umana, più equa o più sostenibile.

Se vogliamo chiamare “quinta rivoluzione industriale” la fase che si
apre, allora non dovrebbe essere definita soltanto da robot e agenti. La
sua vera materia prima sarà la cognizione distribuita. La sua unità di
misura non sarà solo il pezzo prodotto, ma la decisione assistita. Il
suo conflitto fondamentale riguarderà chi controlla i flussi di
intelligenza, con quali dati, secondo quali obiettivi e sotto quale
responsabilità.

In altre parole, la quinta rivoluzione industriale non sarà
automaticamente umanocentrica. Dovremo renderla tale.

Che
cosa succede quando l’intelligenza diventa abbondante

Quando una risorsa diventa abbondante, il valore si sposta
altrove.

Con l’abbondanza di contenuti, il valore si è spostato verso
l’attenzione. Con l’abbondanza di informazioni, verso l’affidabilità.
Con l’abbondanza di capacità cognitiva, il valore si sposterà verso la
scelta dei problemi, la qualità dei criteri e l’assunzione di
responsabilità.

Produrre una bozza costerà sempre meno. Capire se quella bozza è
vera, opportuna, originale e coerente con un obiettivo resterà
difficile.

Generare cento strategie sarà facile. Rinunciare alle novantanove
sbagliate richiederà giudizio.

Creare un agente sarà sempre più semplice. Decidere che cosa non
delegargli diventerà una competenza manageriale.

Per questo il prompt engineering, da solo, non basta. Non serve
soltanto imparare a “fare domande all’AI”. Occorre imparare a progettare
sistemi di lavoro nei quali esseri umani, modelli, fonti e strumenti
abbiano ruoli espliciti. Servono obiettivi, limiti, verifiche,
tracciabilità e punti nei quali una persona possa interrompere il
processo.

L’intelligenza liquida dovrà essere incanalata. Altrimenti non sarà
un acquedotto: sarà un’alluvione.

Il rischio del debito
cognitivo

La metafora della liquidità contiene anche un avvertimento. Ciò che
scorre facilmente può sfuggire al controllo.

Se deleghiamo continuamente la scrittura, potremmo smettere di usare
la scrittura per pensare. Se accettiamo sintesi senza tornare alle
fonti, potremmo confondere velocità e comprensione. Se ogni decisione
arriva accompagnata da una raccomandazione algoritmica, potremmo perdere
l’abitudine al dubbio.

I benefici, inoltre, non sono uniformi. Lo Stanford AI Index rileva
guadagni di produttività significativi in diversi lavori strutturati, ma
segnala risultati più limitati nei compiti che richiedono ragionamento
profondo e possibili effetti negativi sull’apprendimento quando la
dipendenza dallo strumento diventa eccessiva. Esistono persino contesti
nei quali l’AI può rallentare professionisti esperti: in un esperimento
randomizzato di METR
, sviluppatori open source esperti hanno
impiegato più tempo usando strumenti AI, non meno.

Anche l’affidabilità resta discontinua. Il capitolo sulla
responsabilità dello Stanford
AI Index 2026
documenta la distanza tra l’avanzamento delle
capacità e quello delle misure di sicurezza e trasparenza.

Potremmo quindi accumulare un nuovo tipo di debito: il debito
cognitivo
. È ciò che accade quando risparmiamo tempo oggi
delegando senza capire e paghiamo domani con perdita di competenze,
errori invisibili e dipendenza da sistemi che non sappiamo più
valutare.

La nuova
competenza umana: dare forma al flusso

Nell’epoca della musica liquida non abbiamo smesso di avere bisogno
di musicisti. Abbiamo avuto bisogno di nuovi modi per scoprire,
selezionare, remunerare e dare senso alla musica.

Nell’epoca dell’intelligenza liquida non smetteremo di avere bisogno
dell’intelligenza umana. Ne avremo bisogno in forma diversa.

Serviranno persone capaci di formulare problemi, non soltanto di
eseguire compiti. Di riconoscere una risposta plausibile ma falsa. Di
collegare discipline lontane. Di comprendere le conseguenze sociali di
una decisione efficiente. Di assumersi la responsabilità che un modello
non può assumersi.

L’AI potrà moltiplicare le risposte. Non potrà decidere, da sola,
quali domande meritino di guidare un’azienda, una scuola, una pubblica
amministrazione o una vita.

La grande trasformazione non consiste nell’arrivo di una macchina
onnisciente. Consiste nella progressiva disponibilità di una quantità
enorme di capacità cognitiva, imperfetta ma economica, veloce e sempre
più integrata nei processi quotidiani.

La musica liquida ci ha insegnato che, quando qualcosa diventa
accessibile ovunque, non cambia soltanto il modo in cui lo consumiamo.
Cambiano il mercato, le abitudini, gli intermediari e perfino il nostro
rapporto con quel bene.

Per approfondire i dati sull’evoluzione delle capacità, dei costi e
dell’adozione dell’intelligenza artificiale, questo intervento dello
Stanford Institute for Human-Centered Artificial Intelligence presenta i
principali risultati dell’AI Index 2026:

Ora tocca all’intelligenza.

La domanda, quindi, non è più se useremo questa intelligenza liquida.
La domanda è se sapremo darle una forma prima che sia lei a dare una
forma a noi.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
Inviaci email

La risposta breve

Le skill sono workflow riutilizzabili che spiegano a ChatGPT come
svolgere una determinata attività in modo più coerente. In questo
articolo ho selezionato dieci skill open source, scaricabili dal
repository dkyazzentwatwa/chatgpt-skills
e consultabili anche nel catalogo Skills.sh:
OCR, conversione di documenti, analisi dati, calcoli finanziari,
immagini, SVG, QR code, contenuti multimediali, bibliografie e creazione
di nuove skill.

Una precisazione importante: “scaricabile per ChatGPT” non significa
sempre “installabile con un clic in qualsiasi account”. La disponibilità
delle skill native dipende dal prodotto, dal piano e dalle impostazioni
del workspace. OpenAI descrive le skill come workflow condivisibili che
possono contenere istruzioni, esempi, codice e risorse di supporto. Per
gli account o gli ambienti che non espongono ancora l’installazione
diretta, il metodo più semplice consiste nel caricare il file
SKILL.md in un GPT personalizzato o in un progetto, oppure
nell’adattarlo alle istruzioni del proprio ambiente AI.

Skill,
GPT personalizzati e agenti: non sono la stessa cosa

Una skill è soprattutto una procedura. Dice all’AI quali passaggi
seguire, quali file usare, quali controlli fare e quale formato
restituire.

Un GPT personalizzato è un assistente configurato per uno scopo più
ampio, con istruzioni, conoscenze e, quando disponibili, strumenti.

Un agente aggiunge la possibilità di usare strumenti esterni e
compiere azioni: per esempio leggere un archivio, elaborare un file,
interrogare un servizio o aggiornare un sistema.

La differenza pratica è questa: una skill può insegnare a ChatGPT
come analizzare uno scontrino; un agente può anche recuperare gli
allegati, elaborare più ricevute, creare un Excel e preparare una bozza
di email.

Per approfondire il tema del metodo con cui costruire istruzioni più
solide, puoi leggere anche la mia guida sul prompt
engineering e il metodo G.O.L.
.

Le 10 skill ChatGPT da
scaricare

La classifica non è una graduatoria scientifica. Ho privilegiato
skill utili fuori dal solo ambito dello sviluppo software, con una
struttura leggibile, uno scopo chiaro, script verificabili e una
documentazione sufficiente per iniziare. I dati sugli install relativi
al catalogo sono indicativi e possono cambiare.

1. OCR Document Processor

Ideale per: fotografie, scansioni, PDF acquisiti da
scanner, ricevute, biglietti da visita e tabelle.

La skill estrae testo da immagini e PDF scansionati, può produrre
testo strutturato, Markdown, JSON o HTML e include indicazioni per
gestire immagini inclinate, sfocate, multilingue o con bassa qualità. È
probabilmente la più utile per chi lavora con documenti cartacei
digitalizzati.

Esempio di richiesta: “Analizza queste ricevute,
segnala i dati illeggibili, individua i duplicati e restituisci una
tabella pronta per Excel”.

2. Document Converter Suite

Ideale per: conversioni tra PDF, DOCX, PPTX, XLSX,
TXT, CSV, Markdown e HTML.

È una skill generalista per estrarre contenuti, trasformare
documenti, recuperare tabelle e svolgere operazioni di base sui PDF,
come unione, separazione, rotazione, filigrana ed estrazione di pagine.
Il progetto dichiara esplicitamente che la ricostruzione è “best
effort”: il contenuto può essere preservato bene, ma non è garantita la
fedeltà grafica pixel per pixel.

Esempio di richiesta: “Estrai le tabelle da questo
PDF e consegnale in un file XLSX, mantenendo intestazioni e note a piè
di pagina”.

3. Data Storyteller

Ideale per: CSV, Excel, report direzionali e
presentazione narrativa dei dati.

Questa skill trasforma un dataset in un racconto leggibile: controlli
preliminari, confronti, indicatori, visualizzazioni e sintesi finale. È
utile quando non basta calcolare una media, ma bisogna capire quali
evidenze meritano di essere raccontate a un cliente, a un consiglio di
amministrazione o a una classe.

Esempio di richiesta: “Analizza questo Excel,
verifica la qualità dei dati, trova i tre cambiamenti più rilevanti e
prepara un report con grafici e raccomandazioni”.

Per lavori quantitativi, la skill va comunque affiancata a un
controllo umano: una visualizzazione elegante non corregge un dataset
sbagliato.

4. Financial Calculator

Ideale per: mutui, prestiti, interessi composti,
investimenti, obiettivi di risparmio, NPV, IRR e scenari
pensionistici.

Il punto di forza è l’invito a esplicitare prima le ipotesi: tasso,
capitalizzazione, durata, tasse, inflazione e unità di misura. La skill
usa uno script deterministico come fonte del calcolo, invece di
affidarsi soltanto all’aritmetica improvvisata nella conversazione.

Esempio di richiesta: “Confronta tre scenari di
investimento indicando capitale iniziale, versamenti, inflazione,
rendimento ipotizzato e intervallo di incertezza”.

Non è un consulente finanziario e non elimina il bisogno di
verificare formule, fiscalità e dati di mercato.

5. Image Enhancement Suite

Ideale per: ridimensionare, ritagliare, comprimere,
convertire e confrontare immagini.

La skill raccoglie diversi strumenti: rimozione dello sfondo,
controllo dei metadati, confronto tra immagini, filtri, estrazione della
palette, generazione di icone, collage e sprite sheet. È interessante
perché riunisce in un unico pacchetto funzioni che spesso vengono
richieste separatamente.

Esempio di richiesta: “Ridimensiona queste
fotografie per il blog, comprimi i file, mantieni la qualità e prepara
anche una versione quadrata per LinkedIn”.

6. SVG Precision Skill

Ideale per: icone, schemi, diagrammi, mappe
concettuali, illustrazioni tecniche e grafiche web.

Questa skill prova a rendere più affidabile la produzione di SVG:
prima definisce una specifica con dimensioni e coordinate, poi
costruisce il file, lo valida e può generare un’anteprima PNG. È una
buona scelta quando la geometria conta più dell’effetto creativo.

Esempio di richiesta: “Crea un diagramma SVG
1600×900 con tre blocchi, frecce ortogonali, colori accessibili e testo
modificabile”.

Per testi lunghi o molto precisi è comunque consigliabile controllare
l’output in un browser o in un editor vettoriale.

7. QR Code Generator

Ideale per: eventi, brochure, biglietti da visita,
materiali didattici, campagne con UTM e pagine di atterraggio.

La skill invita a validare l’URL prima di generare il codice,
preferisce HTTPS e suggerisce SVG e livelli di correzione più elevati
quando il QR code deve essere stampato. Un dettaglio prezioso: chiede di
restituire sempre anche l’URL effettivamente codificato.

Esempio di richiesta: “Crea un QR code in SVG per
questa pagina, aggiungi UTM solo se servono e restituisci URL, formato e
livello di correzione”.

8. Media Toolkit

Ideale per: audio e video, clip, conversioni,
analisi, sottotitoli, miniature e GIF.

È una skill più tecnica, ma utile per chi produce contenuti. La
descrizione del progetto la presenta come un toolkit per clipping,
conversione, analisi, caption, estrazione di thumbnail, creazione di GIF
e operazioni batch.

Esempio di richiesta: “Estrai tre clip da questo
video, crea una miniatura 16:9 e prepara una versione breve con
sottotitoli”.

Prima dell’uso bisogna controllare le dipendenze richieste e la
disponibilità degli strumenti necessari per l’elaborazione
multimediale.

9. Skill Creator

Ideale per: trasformare una procedura ricorrente in
una skill riutilizzabile.

Questa è la skill più meta dell’elenco: serve a creare altre skill.
Suggerisce di definire con precisione le richieste che devono attivare
il workflow, mantenere breve il file principale, spostare i dettagli
nelle cartelle references/, aggiungere soltanto script e
risorse davvero utili e validare il pacchetto prima di distribuirlo.

Esempio di richiesta: “Trasforma questa procedura
per la gestione dei rimborsi spese in una skill con input obbligatori,
controlli OCR, output Excel e bozza email”.

È il punto di partenza più interessante per chi vuole costruire il
proprio sistema di lavoro dentro ChatGPT.

10. Citation & Bibliography
Generator

Ideale per: paper, tesi, report, articoli e
bibliografie in più stili.

La skill genera citazioni e bibliografie in formati accademici e
professionali, partendo da dati inseriti manualmente, file strutturati e
metadati DOI o ISBN. Può essere utile, ma va usata con una regola
ferrea: una citazione generata non è automaticamente una citazione
verificata.

Esempio di richiesta: “Formatta queste fonti in APA
7, verifica DOI e ISBN, segnala i record incompleti e non inventare i
metadati mancanti”.

Come scaricare una skill

Il modo più semplice è scaricare l’intero repository in formato
ZIP:

Dopo aver estratto l’archivio:

  1. Apri la cartella della skill che ti interessa.
  2. Leggi il file SKILL.md dall’inizio alla fine.
  3. Controlla le cartelle scripts/,
    references/, assets/ e il file
    requirements.txt, se presenti.
  4. Se il tuo account ChatGPT supporta le skill, usa il flusso di
    importazione o caricamento previsto dal workspace.
  5. In alternativa, carica SKILL.md in un GPT
    personalizzato o in un progetto e indica esplicitamente a ChatGPT di
    seguire quella procedura.
  6. Prova la skill con un file non sensibile e verifica il risultato
    prima di usarla su documenti reali.

Per ambienti compatibili con l’installer Skills, il comando indicato
dal catalogo è questo:

npx skills add https://github.com/dkyazzentwatwa/chatgpt-skills --skill ocr-document-processor

Sostituisci ocr-document-processor con il nome della
skill che vuoi installare. Questo comando è utile soprattutto in Codex e
in altri ambienti compatibili con lo standard SKILL.md; non
va confuso con l’importazione nativa dentro ogni versione di
ChatGPT.

Attenzione alla sicurezza

Una skill non è soltanto testo. Alcune includono script Python,
dipendenze e operazioni sui file. Prima di installarla:

  • controlla il repository e l’autore;
  • leggi SKILL.md e gli script eseguibili;
  • verifica le dipendenze;
  • evita di fornire credenziali, token o dati aziendali durante i
    test;
  • prova prima tutto in una cartella isolata;
  • controlla manualmente i risultati, soprattutto per finanza, OCR e
    bibliografie.

Il repository dichiara di avere audit strutturali e documentali, ma
questo non equivale a una certificazione indipendente di sicurezza per
ogni uso possibile. Il principio resta quello dell’open source: leggere
prima di eseguire.

Il video ufficiale
sulle skill in ChatGPT

Qui sotto trovi il video ufficiale di OpenAI che introduce le skill
in ChatGPT Business ed Enterprise:

Quale skill scegliere per
prima?

Se lavori con documenti, ricevute o fotografie, partirei da
OCR Document Processor. Se produci report, sceglierei
Data Storyteller. Se vuoi standardizzare le tue
procedure, la scelta più strategica è Skill Creator. Se
invece ti occupi di contenuti digitali, combinerei Image
Enhancement Suite
, SVG Precision Skill e
Media Toolkit.

Il vero vantaggio non sta nel collezionare cento skill, ma nel
costruire una piccola cassetta degli attrezzi coerente con il proprio
lavoro. Una skill ben scelta riduce il copia e incolla, rende più facile
il controllo di qualità e trasforma una buona procedura in un
comportamento ripetibile.

Per questo, nel mio corso
di ChatGPT per aziende e professionisti
il tema non è soltanto
“quale prompt scrivere”, ma come progettare workflow ripetibili,
verificabili e adattati al ruolo di chi li usa.

Domande frequenti

Le skill sono gratuite?

I repository indicati sono open source e scaricabili gratuitamente.
Alcuni strumenti, dipendenze, modelli o servizi esterni necessari al
funzionamento possono però avere costi propri.

Posso usare una skill
su ChatGPT gratuito?

Non è possibile garantire la stessa modalità per tutti gli account.
La disponibilità delle skill native dipende dal piano, dal prodotto e
dalle impostazioni del workspace. In assenza dell’installazione diretta,
puoi usare il contenuto di SKILL.md in un progetto o in un
GPT personalizzato, quando queste funzioni sono disponibili.

Una skill rende ChatGPT
infallibile?

No. Una skill può rendere il processo più coerente e aggiungere
controlli, ma non sostituisce la verifica umana. Questo vale soprattutto
per dati finanziari, citazioni accademiche, OCR e documenti legali o
amministrativi.

Posso modificare una skill
scaricata?

Sì. È proprio uno dei vantaggi del formato Markdown: puoi adattare
lingua, tono, formato degli output, criteri di controllo e strumenti.
Prima di modificarla, conserva una copia dell’originale.

Articolo aggiornato al 24 settembre 2026. I link ai repository e
i dati sugli install possono cambiare: prima di pubblicare, conviene
verificare nuovamente disponibilità, versione e dipendenze.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
Inviaci email

Gli agenti di intelligenza artificiale rappresentano il passaggio dall’AI che risponde all’AI che agisce. Non si limitano a generare un testo: ricevono un obiettivo, pianificano una sequenza di passi, scelgono gli strumenti disponibili, eseguono azioni e controllano il risultato.

Articolo aggiornato al 24 settembre 2026.

Questo cambiamento riguarda già aziende, professionisti, pubbliche amministrazioni e formazione. Ma intorno alla parola “agente” c’è ancora molta confusione: a volte viene usata per indicare una semplice automazione, altre volte un chatbot con qualche funzione in più. Vediamo quindi le dieci cose davvero importanti da sapere, con esempi concreti e senza trasformare gli agenti AI nell’ennesima parola magica.

Agenti di intelligenza artificiale: che cosa sono davvero?

Un agente AI è un sistema capace di perseguire un obiettivo con un certo grado di autonomia. Secondo la documentazione di OpenAI sugli agenti, queste applicazioni possono pianificare, usare strumenti, collaborare con componenti specializzati e mantenere lo stato necessario per completare attività articolate.

La formula più semplice è questa:

obiettivo + ragionamento + strumenti + memoria + controllo = agente AI

Un chatbot risponde alla domanda. Un workflow esegue passaggi stabiliti in anticipo. Un agente, invece, interpreta la situazione e decide come muoversi entro i limiti che gli abbiamo assegnato.

1. Un agente non è soltanto un chatbot

Il chatbot tradizionale attende una richiesta e produce una risposta. L’agente può invece scomporre un compito in sotto-attività, cercare informazioni, consultare documenti, usare software e ritentare quando un passaggio non funziona.

Esempio: chiedere “scrivimi una mail di follow-up” produce un testo. Chiedere a un agente di gestire il follow-up può significare: leggere gli appunti dell’incontro, controllare il CRM, preparare una bozza personalizzata, proporre una scadenza e creare un promemoria. La differenza non è solo quantitativa. È il passaggio dalla generazione di contenuti all’esecuzione di un processo.

Per capire le basi dei modelli linguistici e dell’AI generativa, può essere utile il mio glossario essenziale dell’intelligenza artificiale generativa.

2. Gli agenti lavorano per obiettivi, non per singoli comandi

Un buon agente parte da un risultato atteso. “Analizza le richieste dei clienti dell’ultimo mese e individua i cinque problemi ricorrenti” è un obiettivo. “Leggi questo file” è soltanto un’azione.

L’obiettivo deve chiarire almeno quattro elementi:

  • che cosa deve ottenere l’agente;
  • quali fonti può usare;
  • quali vincoli deve rispettare;
  • come si verifica che il lavoro sia concluso correttamente.

Qui il prompt engineering non scompare, anzi diventa più importante. Un agente mal istruito può commettere errori su una scala maggiore rispetto a una singola risposta. Nel mio corso di prompt engineering insisto proprio su obiettivi, contesto, limiti e criteri di qualità.

3. Pianificano, agiscono, osservano e correggono

Il funzionamento tipico è ciclico: l’agente interpreta l’obiettivo, prepara un piano, compie un’azione, osserva il risultato e decide il passo successivo. Se necessario, corregge la strategia.

Non tutti gli agenti hanno però lo stesso livello di autonomia. Alcuni propongono soltanto le azioni. Altri possono eseguirle, ma chiedono l’approvazione prima dei passaggi delicati. Altri ancora operano autonomamente entro confini molto precisi.

Anthropic, nella guida Building Effective Agents, distingue utilmente tra workflow, nei quali i passaggi sono orchestrati in modo predefinito, e agenti, nei quali il modello decide dinamicamente come procedere. Non sempre l’opzione più autonoma è la migliore.

4. Il vero salto avviene quando usano strumenti reali

Un agente diventa operativo quando può utilizzare strumenti esterni: posta elettronica, calendario, fogli di calcolo, browser, database, CRM, gestionali, archivi aziendali e sistemi di ticketing.

Gli strumenti trasformano il linguaggio in azioni. L’agente può, per esempio:

  • recuperare dati da più fonti;
  • aggiornare una scheda cliente;
  • preparare una bozza di risposta;
  • confrontare preventivi;
  • generare un report periodico;
  • segnalare un’anomalia;
  • avviare un processo dopo un’approvazione umana.

Questo è anche il punto in cui aumentano responsabilità e rischi. Ogni strumento dovrebbe concedere soltanto i permessi necessari. Un agente incaricato di leggere un calendario non dovrebbe poter cancellare appuntamenti senza un’autorizzazione esplicita.

5. La memoria è utile, ma deve essere progettata

La memoria consente all’agente di mantenere informazioni tra un passaggio e l’altro o tra sessioni diverse. Può ricordare lo stato di un progetto, le preferenze dell’utente, le decisioni prese e le attività ancora aperte.

Ma “ricordare tutto” non è automaticamente un vantaggio. Una memoria efficace deve essere selettiva, aggiornata e governabile. Informazioni vecchie o sbagliate possono diventare una fonte di errori persistenti.

Occorre distinguere almeno tra:

  • memoria di lavoro, necessaria per completare il compito corrente;
  • memoria di progetto, relativa a documenti, scelte e avanzamento;
  • memoria personale o organizzativa, che richiede regole chiare su privacy, accesso e conservazione.

La qualità del contesto conta più della quantità. Anthropic approfondisce questo tema nella guida all’effective context engineering per agenti AI.

6. Un solo agente spesso è meglio di una squadra di agenti

L’immagine più affascinante è quella di un’intera squadra digitale: un agente ricercatore, uno scrittore, uno revisore e uno coordinatore. In alcuni casi funziona. In molti altri aggiunge costi, lentezza e nuovi punti di errore.

La regola pratica è partire dal sistema più semplice che possa risolvere il problema. Prima un workflow deterministico. Poi, se serve, un singolo agente con strumenti ben definiti. Solo quando il compito richiede competenze realmente separate ha senso introdurre un sistema multi-agente.

Google Cloud descrive diversi pattern di progettazione per sistemi agentici, mostrando che la scelta dell’architettura deve dipendere dal processo e non dal fascino della tecnologia.

7. L’autonomia deve essere proporzionata al rischio

Non delegheremmo la stessa libertà a un agente che riordina documenti e a uno che invia offerte commerciali, modifica dati o autorizza una spesa. L’autonomia va calibrata in base all’impatto dell’errore.

Una scala utile può essere questa:

  1. l’agente suggerisce;
  2. l’agente prepara una bozza;
  3. l’agente esegue dopo approvazione;
  4. l’agente esegue autonomamente azioni reversibili;
  5. l’agente opera in autonomia entro soglie, registri e controlli definiti.

OpenAI raccomanda di combinare controlli automatici e revisione umana: i guardrail e il controllo human-in-the-loop permettono di fermare o approvare le operazioni sensibili. Non è un freno all’innovazione. È ciò che rende possibile usare gli agenti in processi reali.

8. Sicurezza e dati non possono essere aggiunti alla fine

Un agente può ricevere testi ostili, interpretare male un’istruzione, usare lo strumento sbagliato o esporre dati non necessari. Tra i rischi principali ci sono prompt injection, permessi eccessivi, perdita di controllo sul flusso, allucinazioni e uso improprio delle informazioni aziendali.

Le difese essenziali includono:

  • privilegio minimo per strumenti e dati;
  • approvazione umana per azioni ad alto impatto;
  • separazione tra istruzioni affidabili e contenuti esterni;
  • registrazione delle azioni eseguite;
  • limiti di spesa, tempo e numero di operazioni;
  • test con casi normali, eccezioni e tentativi di manipolazione;
  • possibilità di interrompere e annullare il processo.

La guida di OpenAI sulla sicurezza nella costruzione degli agenti sottolinea che i dati non attendibili non dovrebbero controllare direttamente il comportamento del sistema. Microsoft ricorda inoltre che gli agenti operano con autorità delegata e possono influire su più sistemi aziendali: per questo servono politiche comuni di governance e sicurezza degli agenti AI.

9. Il valore si misura sul processo, non sulla spettacolarità della demo

Un agente che impressiona durante una presentazione può non essere utile in produzione. Il test serio riguarda affidabilità, qualità, tempo risparmiato, costo, numero di errori e capacità di gestire le eccezioni.

Prima di introdurre un agente in azienda conviene scegliere un processo:

  • ripetitivo ma non completamente rigido;
  • basato su informazioni accessibili e autorizzate;
  • con un risultato verificabile;
  • abbastanza frequente da produrre un beneficio misurabile;
  • con conseguenze limitate se qualcosa va storto.

Buoni casi iniziali sono la preparazione di report, la classificazione di richieste, la ricerca documentale, la creazione di bozze, l’aggiornamento assistito del CRM e il monitoraggio di fonti. Per un percorso più ampio puoi consultare il mio corso ChatGPT per aziende e professionisti.

10. Il vero valore non è sostituire le persone, ma ridisegnare il lavoro

La domanda meno utile è: “Quali lavori elimineranno gli agenti?”. Quella più produttiva è: “Quali passaggi del nostro lavoro possono essere delegati, quali devono restare umani e quali vanno riprogettati?”.

Gli agenti possono ridurre il lavoro amministrativo, collegare strumenti che oggi non comunicano, accelerare l’analisi e rendere operative informazioni disperse. Ma il valore nasce soltanto quando obiettivi, responsabilità e processi vengono ripensati.

Il professionista non sparisce. Cambia ruolo: definisce gli obiettivi, fornisce il contesto, imposta i limiti, controlla le eccezioni e valuta il risultato. In altre parole, passa dall’esecuzione di ogni singolo passaggio al governo del sistema.

Come introdurre un agente AI in azienda

Un percorso ragionevole può partire da cinque mosse:

  1. scegliere un processo circoscritto, evitando di voler automatizzare subito un intero reparto;
  2. mappare dati, strumenti e autorizzazioni necessari;
  3. definire metriche di successo, come tempo, qualità, costo ed errori;
  4. inserire approvazioni umane nei punti delicati;
  5. testare, documentare e migliorare prima di aumentare l’autonomia.

Il principio guida è semplice: prima affidabilità, poi autonomia. Un agente poco spettacolare ma controllabile crea più valore di una demo brillante e imprevedibile.

Domande frequenti sugli agenti AI

Qual è la differenza tra chatbot e agente AI?

Il chatbot genera una risposta a una richiesta. L’agente persegue un obiettivo, decide una sequenza di azioni e può usare strumenti esterni per completare il compito.

Gli agenti AI lavorano completamente da soli?

Non necessariamente. Possono avere livelli di autonomia differenti. Nei processi sensibili è preferibile che preparino il lavoro e chiedano un’approvazione prima dell’azione finale.

Serve saper programmare per usare un agente?

Non sempre. Esistono piattaforme visuali e strumenti integrati nei software aziendali. Tuttavia, progettare processi affidabili richiede competenze su obiettivi, dati, permessi, controlli e valutazione dei risultati.

Quali attività conviene affidare per prime a un agente AI?

Attività frequenti, verificabili e a rischio contenuto: ricerca e sintesi, classificazione, preparazione di bozze, report periodici, monitoraggio e aggiornamento assistito di archivi o CRM.

Qual è il rischio più sottovalutato?

Concedere troppi permessi a un sistema non ancora abbastanza testato. La qualità del modello non sostituisce la progettazione dei limiti e delle approvazioni.

In conclusione

Gli agenti di intelligenza artificiale non sono semplicemente chatbot più potenti. Sono sistemi che collegano ragionamento e azione. Proprio per questo possono creare molto valore, ma anche amplificare errori, permessi sbagliati e processi mal progettati.

La domanda decisiva non è quanto un agente sia autonomo. È quanto sia utile, controllabile e coerente con gli obiettivi dell’organizzazione.

Vuoi progettare un laboratorio o un percorso aziendale sugli agenti AI? Scopri i miei corsi su ChatGPT, AI generativa e prompt engineering oppure contattami per costruire un intervento su casi d’uso reali della tua organizzazione.


Fonti principali: OpenAI Agents; Anthropic, Building Effective Agents; Google Cloud, agentic design patterns; Microsoft Cloud Adoption Framework for AI Agents; OpenAI, Safety in building agents.

Customer experience e AI funzionano insieme quando l’intelligenza artificiale aiuta a capire i clienti, preparare decisioni e lavorare meglio sulle relazioni. Servono dati leggibili, un obiettivo preciso, contesto e persone capaci di valutare il risultato. È il filo conduttore del mio intervento al webinar Customer Experience e Business Development ai tempi dell’AI, che si è svolto il 21 settembre 2026.

L’incontro è stato organizzato da Surwiz, in collaborazione con Crono e con Merakyn come media partner. Ho partecipato alla tavola rotonda insieme ad Alessandro Di Maio, cofondatore di Surwiz, e Alex Roggero, cofondatore di Crono. A moderare il confronto c’era Lorenzo D’Amelio di Merakyn.

Il mio contributo era quello di un formatore che incontra ogni giorno aziende e professionisti alle prese con questi strumenti: portare esempi, mettere in discussione qualche abitudine e mostrare come passare dall’esperimento occasionale a un uso consapevole dell’AI.

La registrazione del webinar

Qui trovi la registrazione completa. Nell’articolo riprendo i miei interventi e aggiungo un esercizio applicativo per tradurli nel lavoro quotidiano.

Customer experience e AI: avere tanti dati non basta

Lorenzo mi ha chiesto perché continuiamo ad associare l’abbondanza di dati alla qualità delle decisioni. Ho risposto partendo da una situazione che incontro spesso nei corsi: qualcuno mi descrive un problema e mi chiede come risolverlo con l’intelligenza artificiale. Poi scopro che gli serve soprattutto mettere ordine in quattro file e costruire una dashboard.

In quel caso può bastare un buon lavoro di business intelligence. La scelta dello strumento deve seguire il problema. Prima occorre capire quali informazioni abbiamo, quanto sono aggiornate e quale decisione vogliamo prendere. Altrimenti aggiungiamo un’interfaccia brillante sopra dati disordinati.

Nel webinar ho raccontato anche la distanza tra le realtà strutturate e quelle più piccole che incontro nella formazione. Alcune lavorano con sistemi integrati; altre si reggono ancora su fogli Excel e informazioni sparse. Il punto di partenza cambia parecchio.

L’AI può aiutare a interpretare quei materiali e a individuare piste di lavoro, soprattutto se conosce il contesto dell’azienda. Ma collegare un archivio non significa averne automaticamente risolto incoerenze, duplicati e lacune. Una risposta plausibile va sempre confrontata con le fonti.

Il metodo Socrate: fai fare le domande all’AI

Uno dei suggerimenti più pratici che ho dato è molto semplice: fatti intervistare dall’intelligenza artificiale. Passiamo tanto tempo a cercare la domanda perfetta, mentre spesso non abbiamo ancora chiarito abbastanza il problema.

Io chiamo questo approccio “Socrate”, con un po’ di ironia. Dai all’assistente un obiettivo e chiedigli di raccogliere da te le informazioni mancanti. L’accorgimento decisivo è aggiungere: fammi una domanda alla volta e aspetta la mia risposta. Altrimenti arriva un questionario infinito, non un dialogo.

Ecco una traccia operativa, rielaborata per questo articolo a partire dall’esempio del webinar:

Voglio capire perché alcuni clienti non rinnovano il nostro servizio. Aiutami a definire un’analisi utile. Prima di proporre soluzioni, intervistami: fammi una domanda alla volta e aspetta la mia risposta. Chiarisci obiettivo, tipo di clienti, dati disponibili, periodo osservato e vincoli. Distingui ciò che sappiamo dalle ipotesi. Alla fine proponi un piccolo piano di verifica, indicando quali informazioni mancano.

È un esercizio utile anche senza caricare subito documenti. Posso spiegare il problema, farmi aiutare a delimitarlo e decidere solo dopo quali dati siano necessari e utilizzabili. Le domande dell’assistente possono già farmi vedere un limite della mia impostazione.

Dal prompt al contesto: costruire un secondo cervello

Durante il confronto è tornata più volte l’idea del second brain, il secondo cervello. Nel mio intervento l’ho collegata a un assistente configurato sul nostro lavoro: sa chi siamo, quali obiettivi abbiamo e quali materiali può consultare.

Una richiesta isolata costringe il modello a riempire molti vuoti. Un contesto pertinente gli permette di lavorare su informazioni più utili. Questo richiede selezione: documenti corretti, istruzioni chiare e accessi coerenti con il compito. Riempire la conversazione di materiale a caso non è una strategia.

La distinzione è approfondita anche da Anthropic nella guida al context engineering per gli agenti AI: oltre al testo del prompt, conta l’insieme delle informazioni disponibili al sistema, compresi strumenti, documenti e cronologia.

Ho raccontato anche alcune mie sperimentazioni, dalla creazione di un videogioco didattico sui prompt a un prototipo di CRM costruito con l’aiuto dell’AI. Il valore di questi esempi sta nella possibilità di esplorare un’idea e verificarne l’utilità. Un prototipo, prima di diventare un sistema aziendale, richiede controlli su dati, accessi, affidabilità e manutenzione.

L’AI rende impersonale il rapporto con i clienti?

La domanda di Lorenzo toccava un’obiezione frequente: se usiamo tutti gli stessi strumenti, finiremo per comunicare tutti allo stesso modo? Nel webinar sono stato piuttosto provocatorio su questo punto. Se produciamo email intercambiabili, dobbiamo interrogarci su come stiamo usando lo strumento.

Ho indicato due ingredienti che possono cambiare il risultato: il nostro stile di scrittura e la conoscenza della relazione con il cliente. Da una parte esempi selezionati di come comunichiamo; dall’altra lo storico pertinente, il problema aperto, le richieste già fatte e gli impegni presi.

La personalizzazione utile consiste, per esempio, nel ricordare che un cliente ha già segnalato un disservizio e sta aspettando una risposta concreta. Mettere il suo nome in apertura non basta. Né serve una mail elegante che ignori tutto quello che è successo prima.

Su un piano più generale, lo studio Generative AI at Work di Erik Brynjolfsson, Danielle Li e Lindsey Raymond, disponibile anche su Microsoft Research, ha osservato benefici dall’assistenza generativa nel customer support, con risultati diversi a seconda dell’esperienza degli operatori. È un caso di ricerca specifico, non una promessa di produttività valida per qualsiasi azienda.

Il mio criterio resta molto concreto: il cliente riceve una risposta corretta, pertinente e capace di aiutarlo? Se abbiamo risparmiato cinque minuti ma gli abbiamo fatto perdere mezz’ora, abbiamo ottimizzato la cosa sbagliata.

Persone e agenti AI: come dividersi il lavoro

Alex Roggero ha portato nel confronto il tema del lavoro commerciale e della collaborazione tra persone e agenti. Mi sono agganciato a questo ragionamento insistendo sulla configurazione degli strumenti e sulla qualità del contributo umano.

Per chiarire cosa intendo, ho raccontato un episodio familiare: mia moglie, insegnante, doveva preparare un progetto per un bando scolastico. Abbiamo impostato un assistente sui materiali del bando, ottenuto una proposta e poi rivisto il testo. Lei ha modificato anche un’attività che non la convinceva. Il progetto è stato finanziato e, quando sono arrivati i complimenti, si è sentita a disagio per l’aiuto ricevuto dall’AI.

Per me quell’episodio mostra bene il lavoro che rischiamo di rendere invisibile: riconoscere l’opportunità, scegliere lo strumento, fornirgli i materiali, dare istruzioni, valutare la proposta e correggerla. L’approvazione finale richiede competenza e responsabilità. Questo vale anche per una risposta a un cliente o una proposta commerciale.

La guida di Anthropic Building effective agents distingue i flussi predefiniti dai sistemi in cui il modello sceglie dinamicamente passaggi e strumenti. Raccomanda di partire da soluzioni semplici e aggiungere complessità quando serve. È un criterio utile anche in azienda: prima definiamo il compito e come valutarlo, poi decidiamo quanta autonomia concedere.

Dati aziendali e AI: regole chiare prima degli automatismi

Un altro mio intervento ha riguardato l’uso non governato dell’AI, spesso chiamato shadow AI: le persone adottano strumenti per lavorare, ma l’organizzazione non sa quali informazioni vi inseriscono e con quali garanzie.

Ho suggerito di partire da strumenti scelti consapevolmente, un vademecum operativo e formazione. Nel ragionamento ho distinto materiali già pubblici, come una brochure, da procedure interne, contratti, informazioni sui clienti e dati particolarmente delicati. Metterli tutti nello stesso contenitore è un errore.

Le indicazioni pratiche che ricavo da quel passaggio sono queste:

  1. Stabilire quali strumenti e account usare. Valutare condizioni del servizio, trattamento dei dati, accessi e configurazioni con chi ne ha la competenza in azienda. Un abbonamento a pagamento, da solo, non certifica la conformità di qualsiasi utilizzo.
  2. Caricare il minimo necessario. Se basta un campione depurato dei dati personali, partire da quello. Anche anonimizzazione e soluzioni locali richiedono verifiche: non sono scorciatoie che eliminano ogni rischio.
  3. Separare l’uso professionale da quello personale. Durante il webinar ho evocato la serie Severance proprio per rendere memorabile questa separazione. Materiali di lavoro e account personali non devono mescolarsi senza controllo.
  4. Formare le persone sui casi reali. Quali documenti posso usare? Quali output devo controllare? Quando devo chiedere aiuto? Un vademecum funziona se permette di rispondere a queste domande.

Per approfondire, le FAQ della Commissione europea sull’alfabetizzazione AI collegano le competenze al contesto d’uso e ai rischi. È un riferimento utile per impostare la formazione, da affiancare alla valutazione delle regole applicabili alla propria organizzazione.

Decidere più velocemente significa decidere meglio?

La domanda conclusiva di Lorenzo era volutamente scomoda: l’AI ci aiuta a capire meglio i clienti oppure accelera le decisioni sbagliate?

Ho risposto distinguendo velocità di esecuzione e qualità del lavoro. Un report pronto in mezz’ora invece che in dieci ore può essere un progresso enorme. Bisogna però verificare che mantenga profondità, accuratezza e comprensione del problema.

Nel caso dei clienti, l’AI può aiutare a sintetizzare recensioni, analizzare ticket, individuare ricorrenze e suggerire azioni. Se il campione è incompleto, vecchio o rappresenta soltanto una parte della clientela, rischiamo di accelerare un’analisi già distorta in partenza. A questo si aggiungono gli errori del modello e le informazioni inventate.

Il profilo sui rischi dell’AI generativa del National Institute of Standards and Technology (NIST) offre un quadro per affrontare, tra gli altri, i rischi legati a confabulazioni e privacy. Tradotto nel lavoro quotidiano: chiedere riscontri, verificare i risultati e definire responsabilità deve far parte del processo.

Ho chiuso con una battuta che sintetizza bene il mio intervento: prima dell’AI potevamo capire male il cliente lentamente; oggi possiamo capirlo male in tempo reale.

Un esercizio per portare questi spunti in azienda

Per applicare il rapporto tra customer experience e AI, propongo di iniziare da un problema circoscritto. Per esempio: capire perché un gruppo di clienti ha chiesto più volte assistenza sullo stesso passaggio. Questo esercizio è un’elaborazione pratica dei temi discussi, non un caso aziendale raccontato nel webinar.

  1. Definisci la decisione. Vuoi riscrivere una procedura, correggere una comunicazione o approfondire un problema del servizio?
  2. Seleziona i materiali utilizzabili. Scegli un periodo, chiarisci cosa manca e prepara i dati secondo le regole aziendali.
  3. Fatti intervistare. Usa il metodo Socrate per far emergere obiettivi, vincoli e ipotesi implicite.
  4. Chiedi un’analisi verificabile. Per ogni tema emerso, fatti indicare i riscontri nei materiali e le informazioni mancanti. Tieni separate evidenze e interpretazioni.
  5. Controlla e prova un’azione. Confronta l’analisi con chi gestisce quei clienti, scegli un intervento limitato e stabilisci come capire se ha funzionato.

È così che vedo il valore dell’intelligenza artificiale nella relazione con i clienti: un aiuto a fare domande più precise, comprendere meglio le informazioni e preparare azioni che qualcuno sappia valutare. Sono temi su cui lavoro anche nel mio corso ChatGPT per aziende e professionisti, adattando esempi ed esercizi ai processi reali dei partecipanti.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
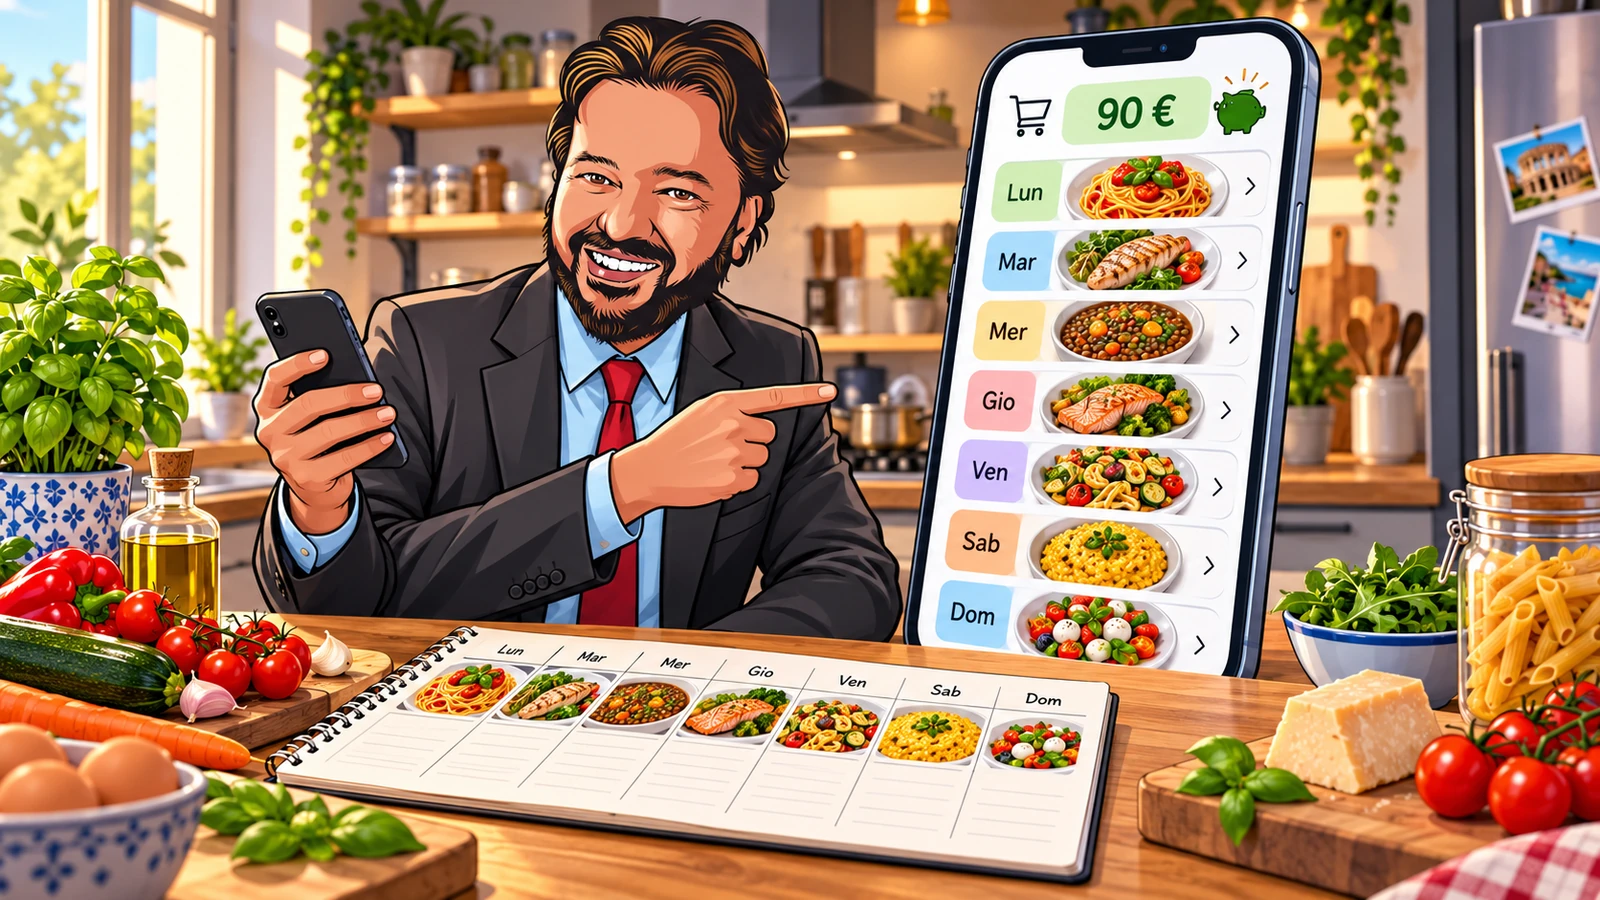
Inviaci email

Agenti AI e second brain possono lavorare insieme per trasformare informazioni sparse in un risultato concreto. Il secondo cervello conserva e rende ritrovabili documenti, appunti e decisioni; l’agente usa il contesto pertinente e gli strumenti disponibili per svolgere un compito. Un mio preventivo da aggiornare rende questa distinzione molto più comprensibile di una slide piena di sigle.

Nella schermata che commento in questo articolo ho allegato un documento Word e scritto una richiesta di una riga:

«Aggiorna questo preventivo sulla base della discussione del 18 settembre».

Niente riepilogo degli accordi. Niente copia e incolla delle email. Ho indicato un documento e un riferimento temporale. Il lavoro interessante comincia proprio nello spazio tra queste poche parole e le informazioni necessarie per eseguirle.

ChatGPT Work cerca gli accordi precedenti per aggiornare un preventivo con Contesto personale e Gmail
La richiesta di aggiornamento del preventivo e le attività dichiarate dal sistema. Il lavoro è ancora in corso; l’importo è oscurato. Clicca sull’immagine per ingrandirla.

Che cosa mostra davvero la schermata

Nel pannello delle fonti compare “Contesto personale”. Nell’area di lavoro il sistema dichiara di aver usato Personal Context, Gmail e comandi. Spiega che leggerà il preventivo, cercherà la discussione precedente e userà le skill per i documenti.

Poi riporta di aver trovato una conferma: un incontro unico, una data, un orario, circa quaranta partecipanti senza PC. Annuncia l’aggiornamento del programma e dell’importo, mantenendo la carta intestata. L’importo nella schermata è oscurato e resta tale anche qui.

Questo dettaglio dei partecipanti senza PC merita attenzione. Per chi progetta formazione, può cambiare la struttura dell’intervento: le esercitazioni individuali al computer vanno ripensate. Recuperare un’informazione serve quando la si collega alle conseguenze sul lavoro da fare.

La schermata documenta però un’elaborazione ancora in corso. Non mostra il file finale né permette di verificare la corrispondenza con l’email originale. “Ho trovato la conferma” è un’affermazione dell’assistente da controllare, non una certificazione. E “in elaborazione da 1 minuto e 48 secondi” non è una misura del tempo complessivo risparmiato.

Agenti AI e second brain: chi ricorda e chi lavora

Uso l’espressione second brain, o secondo cervello, per indicare un sistema esterno con cui raccogliere, organizzare e riutilizzare conoscenza personale e professionale. Il metodo Building a Second Brain di Tiago Forte propone proprio di rendere le informazioni disponibili al nostro sé futuro. Un archivio così può esistere anche senza intelligenza artificiale.

Un agente AI aggiunge la possibilità di perseguire un obiettivo attraverso più passaggi e strumenti. La documentazione ufficiale OpenAI sugli agenti descrive sistemi capaci di pianificare ed eseguire attività usando strumenti e mantenendo il contesto tra i passaggi.

Nel caso del preventivo, immagino questa divisione del lavoro:

Componente Funzione Esempio nel preventivo
Archivio e fonti Conservano le informazioni originali Documento Word ed email degli accordi
Recupero del contesto Seleziona ciò che serve al compito La conferma pertinente del 18 settembre
Agente e strumenti Organizzano ed eseguono le operazioni Confrontare gli accordi con il preventivo e modificarlo
Skill Forniscono istruzioni riutilizzabili Indicazioni per trattare un documento e verificarne il layout
Persona Valida contenuto e decisioni Controllare programma, importo e versione da inviare

Questa tabella è una lettura funzionale dell’esempio, non una descrizione dell’architettura interna del prodotto. Dalla sola immagine non possiamo ricostruire come siano implementati memoria e recupero delle fonti.

“Contesto personale” non significa che l’AI sappia tutto di me

La scritta evidenziata dal mio avatar può suggerire un assistente che ricorda ogni cosa. È una scorciatoia pericolosa. Nella schermata vediamo che il contesto personale è tra le fonti disponibili e che il sistema segnala l’uso di Gmail. Non vediamo l’estensione degli accessi, la completezza del recupero o tutte le informazioni consultate.

Per lavorare bene distinguerei tre livelli: le preferenze relativamente stabili, come il tono e il formato dei miei documenti; gli accordi specifici di un progetto, come durata e compenso; le istruzioni del compito attuale. Un’abitudine non dovrebbe prevalere su un accordo esplicito appena confermato.

Se normalmente propongo corsi di sei ore, ma per questo cliente abbiamo concordato tre ore, il riferimento è l’accordo di quel progetto. Un assistente che mi conosce deve anche riconoscere quando sto facendo un’eccezione.

Recuperare le informazioni: il legame con la RAG

Una base scientifica utile è il lavoro di Patrick Lewis e colleghi, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, accettato a NeurIPS 2020. La RAG combina la generazione del modello con il recupero di informazioni da una memoria esterna.

Per un lettore non tecnico, l’idea è questa: prima di formulare una risposta, il sistema può consultare materiale pertinente. Nel mio esempio, l’informazione decisiva dovrebbe arrivare dall’accordo con il cliente, non da una risposta plausibile su come si organizza normalmente un corso.

Non sto dicendo che il pulsante “Contesto personale” usi esattamente l’architettura di quel paper. Il collegamento è concettuale: la qualità del risultato dipende anche da quali informazioni vengono recuperate. Se il sistema trova la prima proposta e ignora la rettifica successiva, può produrre un documento impeccabile e sbagliato.

Dalla risposta all’azione: perché qui parlo di agenti

Il passaggio interessante è la sequenza: leggere, cercare, confrontare, modificare, controllare. È un flusso di lavoro che richiede di interagire con fonti e documenti, osservare i risultati e decidere il passo successivo.

Il paper di Shunyu Yao e colleghi ReAct: Synergizing Reasoning and Acting in Language Models, nella versione presentata a ICLR 2023, studia l’alternanza tra ragionamento e azioni che permettono di interagire con l’ambiente e raccogliere informazioni. È un riferimento per capire la logica dei sistemi agentici, non una prova del funzionamento interno della sessione mostrata.

Nel preventivo, una sequenza ben progettata dovrebbe produrre anche un elenco delle modifiche: quali condizioni sono cambiate, da quale fonte derivano e quali punti restano incerti. La frase “fatto” è comoda. Una modifica tracciabile è più utile.

Un second brain utile deve saper distinguere le versioni

Il rischio che mi interessa di più è l’accordo superato che torna a vivere. La prima email prevedeva due incontri; la seconda li riduceva a uno; una telefonata introduceva una nuova esigenza, poi confermata per iscritto. Se tutto finisce nello stesso mucchio, anche un archivio molto ricco può diventare una fonte di confusione.

Lo studio di Nelson F. Liu e colleghi Lost in the Middle: How Language Models Use Long Contexts ha osservato, nei modelli e nei compiti esaminati, che la posizione di un’informazione nel contesto lungo può influenzare la capacità di utilizzarla. Non è un test del modello della schermata. È un buon motivo per evitare l’equazione “più materiale carico, migliore sarà automaticamente il risultato”.

La mia regola pratica sarebbe questa: ogni decisione importante dovrebbe avere una fonte, una data e uno stato. Proposta, confermata, superata, da chiarire. “Forse facciamo tre ore” e “confermiamo tre ore” meritano etichette diverse, anche se contengono quasi le stesse parole.

Tre applicazioni concrete oltre il preventivo

Quelli che seguono sono esempi di flussi da progettare con strumenti e accessi appropriati. Non sono risultati dimostrati dalla schermata.

Preparare una riunione con un cliente

L’agente recupera gli scambi pertinenti, l’ultima proposta e le questioni rimaste aperte. Produce una pagina con accordi confermati, dubbi e domande da fare. Il secondo cervello fornisce continuità; il documento finale deve distinguere i fatti dalle interpretazioni.

Aggiornare il programma di un corso

Un cliente comunica che i partecipanti saranno principianti e non avranno il computer. L’assistente confronta queste condizioni con la scaletta e propone dimostrazioni guidate, discussioni e attività a gruppi. Il formatore controlla che il programma resti realistico e coerente con gli obiettivi.

Preparare un follow-up commerciale

Dopo una riunione, l’agente può trasformare appunti e accordi verificati in una bozza di email e in un elenco di attività. Per partire, sceglierei un perimetro semplice: preparazione dei materiali, controllo umano e invio separato. Sapere scrivere una buona email non equivale a poter prendere impegni al mio posto.

Il prompt che userei per rendere il lavoro verificabile

La richiesta originale è breve perché presuppone che il sistema riesca a recuperare il contesto. Quando sono in gioco condizioni economiche o impegni con un cliente, aggiungerei istruzioni esplicite:

«Aggiorna il preventivo allegato sulla base degli accordi confermati con [cliente] nella discussione del [data]. Cerca nelle fonti collegate autorizzate e indica quali hai usato. Distingui proposte, conferme e rettifiche successive. Se trovi contraddizioni su prezzo, durata o data, segnalale senza scegliere arbitrariamente. Mantieni carta intestata e impaginazione. Crea una nuova versione del Word e una tabella con modifica, valore precedente, nuovo valore e fonte. Non inviare il documento al cliente».

Questo prompt rende più preciso l’incarico, ma funziona solo se l’ambiente dispone davvero delle fonti e degli strumenti necessari. Una formula ben scritta non crea da sola un collegamento alla posta o un accesso ai documenti.

Come valutare se il secondo cervello sta aiutando davvero

Per una prova in azienda partirei da un documento e da una conversazione circoscritta, usando materiali adatti alla sperimentazione. Poi controllerei cinque cose:

  1. Fonte: l’accordo recuperato riguarda il cliente e il progetto giusti?
  2. Versione: ci sono rettifiche successive che cambiano le condizioni?
  3. Coerenza: titolo, programma, durata e importo sono stati aggiornati insieme?
  4. Documento: carta intestata, tabelle e impaginazione restano leggibili?
  5. Tempo netto: quanto lavoro resta, includendo verifica e correzioni?

Quest’ultima misura è decisiva. Non attribuisco a questa schermata percentuali di produttività: non le abbiamo misurate. Cronometrare anche la revisione è un modo molto concreto per capire quando conviene delegare.

La competenza da allenare: costruire continuità

Questa schermata mi interessa perché racconta un bisogno professionale normale: riprendere un lavoro senza ricostruirne ogni volta tutta la storia. Per arrivarci servono fonti accessibili, decisioni riconoscibili, istruzioni chiare e controlli proporzionati al risultato.

La mia idea di second brain operativo è questa: un patrimonio di informazioni che può alimentare azioni verificabili. Un assistente utile deve aiutarmi a ritrovare il filo, lasciandomi vedere da dove l’ha preso.

È un tema che si presta bene a un laboratorio: scegliere un processo reale, definire cosa delegare e confrontare il risultato con le fonti. Nel mio percorso di formazione sull’intelligenza artificiale generativa trovi anche il lavoro su documenti, personalizzazione e passaggio dai chatbot agli agenti.

Domande frequenti su agenti AI e second brain

Un second brain è un agente AI?

Sono concetti diversi. Il second brain organizza conoscenza riutilizzabile. Un agente può consultarla ed eseguire operazioni tramite strumenti. Possono essere integrati nello stesso ambiente.

La schermata dimostra che il preventivo è corretto?

No. Mostra la richiesta, le attività dichiarate dall’assistente e un’elaborazione in corso. La correttezza richiede il confronto tra documento finale e accordi originali.

Basta attivare la memoria per avere un assistente operativo?

Per un compito come questo servono anche fonti pertinenti, strumenti per leggere e modificare i file, autorizzazioni adeguate e criteri di verifica. La memoria, da sola, non descrive l’intero processo.

Fonti e nota sul caso

I riferimenti sono collegati nei rispettivi paragrafi: il metodo Building a Second Brain di Tiago Forte, la documentazione OpenAI sugli agenti e i paper di Lewis, Yao e Liu con i rispettivi coautori. La schermata fornita è la fonte del caso commentato; i paper aiutano a interpretarne i concetti, ma non validano quella specifica esecuzione. Copertina illustrativa generata con AI.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
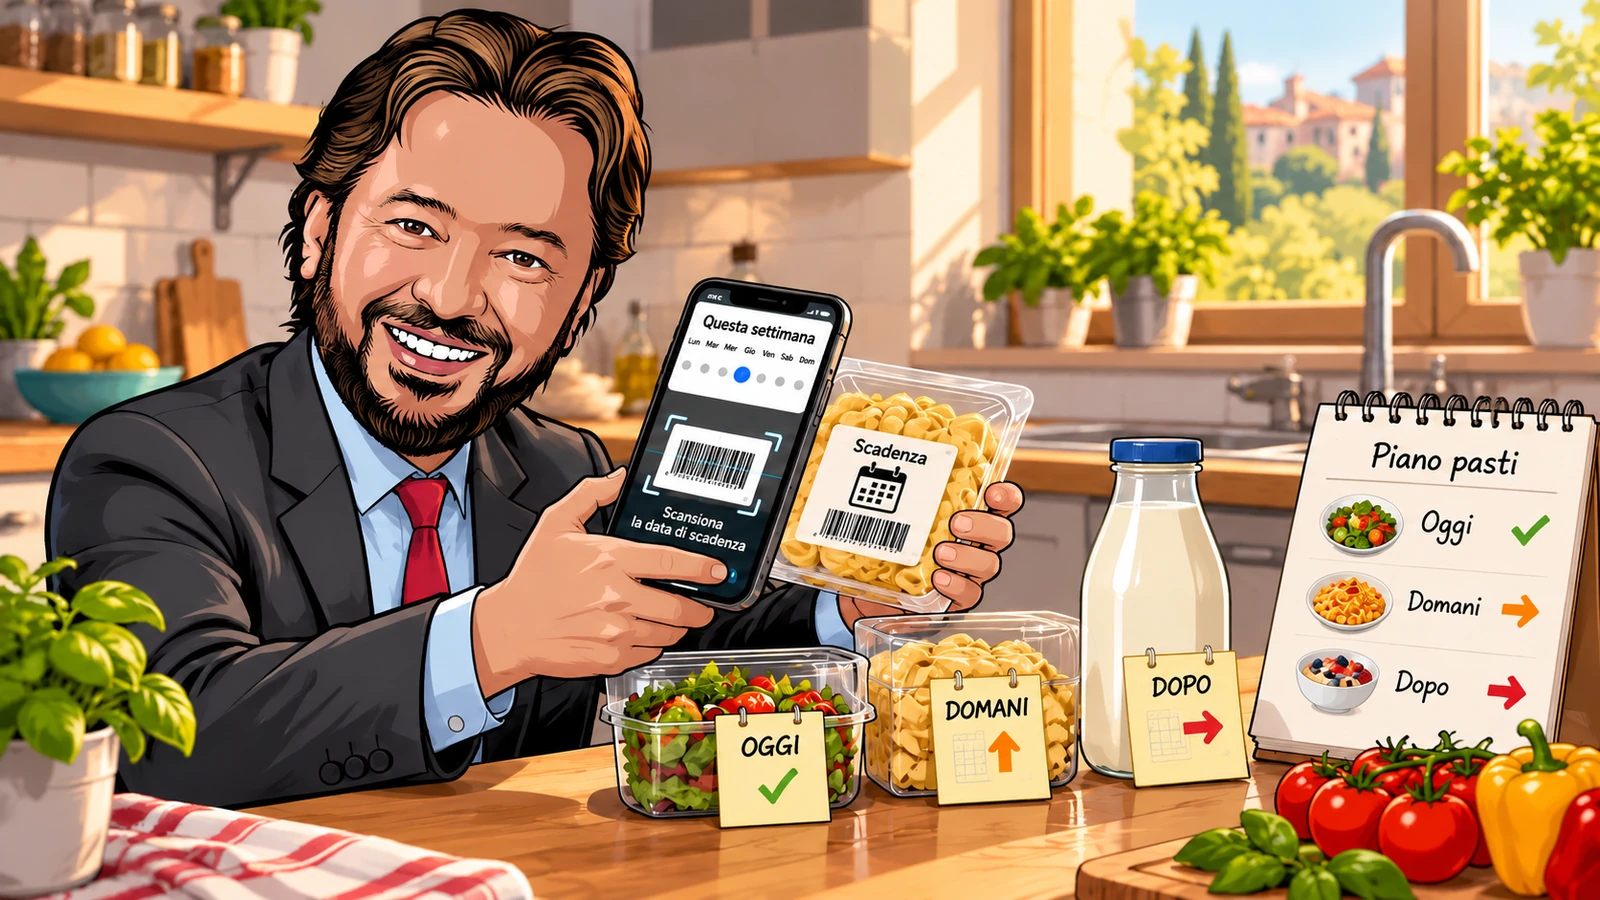
Inviaci email

I token AI sono le unità in cui un modello di intelligenza artificiale suddivide ed elabora i contenuti. Nel testo possono corrispondere a una parola, a un suo frammento o a un segno di punteggiatura. Servono a misurare quanto materiale entra nel modello, quanto ne viene generato e, in molti servizi a consumo, quanto si paga. La documentazione sui concetti fondamentali delle API di OpenAI parte proprio da questa distinzione: contare le parole e contare i token sono due operazioni diverse.

Per capire perché ci riguardano, immaginate un contatore accanto alla finestra del chatbot. Ogni documento da leggere, ogni risposta da produrre e ogni passaggio di un agente contribuisce al lavoro richiesto al sistema. Il contatore non coincide necessariamente con la fattura del vostro abbonamento, ma aiuta a capire che cosa state chiedendo alla macchina.

In questa guida spiego come leggere quel contatore, come stimare i costi e come evitare gli sprechi. Vedremo anche il Markdown, i documenti PDF, le conversazioni interminabili e gli agenti che continuano a lavorare mentre noi facciamo altro.

Affronterò poi una domanda più provocatoria: i token diventeranno il nuovo denaro? La mia lettura è che possano diventare una misura sempre più importante dell’accesso ai servizi AI. La sostituzione di euro e dollari, invece, è uno scenario speculativo: non è una conseguenza dimostrata della diffusione dell’intelligenza artificiale. È una differenza piccola nella formulazione, enorme nelle implicazioni.

1. Che cosa sono i token AI, spiegato senza gergo

Pensate al testo come a una costruzione fatta di mattoncini. Noi vediamo frasi, periodi e paragrafi. Il modello riceve una sequenza di unità più piccole, ciascuna associata a un identificativo numerico. Il programma che prepara questa sequenza si chiama tokenizer; l’operazione è la tokenizzazione.

Il mattoncino non ha sempre le dimensioni di una parola. Una parola frequente può essere rappresentata da un solo token; un’altra può essere spezzata. Anche gli spazi influiscono sulla suddivisione. Non basta quindi prendere il conteggio di Word e rinominarlo «token»: sarebbe come contare le scatole in magazzino e pretendere di averne misurato il peso.

La tokenizzazione riguarda la rappresentazione dei contenuti, non è di per sé una prova di comprensione. Sapere che una frase occupa nove token non dice se la risposta che ne verrà ricavata sarà corretta, originale o utile.

Una frase italiana contata davvero

Ho verificato questo esempio con la libreria tiktoken, versione 0.14.0, usando la codifica o200k_base:

Il preventivo include assistenza e formazione.

Sono sei parole, ma nove token con quella specifica codifica. La suddivisione è questa; gli spazi iniziali sono intenzionali:

"Il" | " prevent" | "ivo" | " include" | " assist" | "enza" | " e" | " formazione" | "."

«Preventivo» viene diviso in due pezzi. Anche «assistenza» viene divisa. «Formazione», preceduta da uno spazio, in questo esempio è un solo token. Il punto finale conta separatamente.

Questo piccolo esperimento è più utile di una conversione universale inventata. Mostra che i confini linguistici intuitivi e quelli del tokenizer possono essere diversi. Il risultato vale per il testo esatto e la codifica indicata, non per qualsiasi chatbot. Il metodo è riproducibile seguendo il tutorial ufficiale OpenAI sul conteggio con tiktoken.

Token, parametri e crediti: tre cose diverse

Un’altra confusione frequente riguarda parole che compaiono vicine nelle presentazioni sull’AI. I token descrivono le unità elaborate o generate. I parametri riguardano il modello e ciò che ha appreso durante l’addestramento. I crediti sono una modalità commerciale con cui un servizio può vendere l’accesso alle proprie funzioni.

Per chi compra un servizio, la conseguenza pratica è semplice: un credito non equivale automaticamente a un token. Se un’applicazione promette «mille crediti», chiedete che cosa permettono di fare, con quali modelli e con quali scadenze. Il numero, isolato, non è ancora un’offerta confrontabile.

2. Come si calcola il numero di token

Ci sono tre livelli: la stima a occhio, il conteggio del testo con un tokenizer e la misura della richiesta completa. Conviene sapere quale si sta usando, perché rispondono a domande differenti.

La regola orientativa riportata da OpenAI è circa quattro caratteri per token, oppure circa 0,75 parole per token, per il testo inglese. Se ho mille parole inglesi, una stima grossolana è mille diviso 0,75, cioè circa 1.333 token. È un ordine di grandezza, non una misurazione.

Non applicherei quel rapporto automaticamente all’italiano, ai listini, ai codici prodotto o a un testo pieno di URL. La guida di Google al conteggio dei token propone anch’essa indicazioni orientative per l’inglese e strumenti per effettuare il conteggio. Lingua, contenuto e modello contano: la scorciatoia non deve diventare una formula esatta per comodità.

Per chi usa un chatbot senza programmare

Per farsi un’idea, si può copiare un testo pubblico o inventato nel tokenizer indicato dalla documentazione del fornitore. Occorre verificare quale modello o codifica rappresenti. Il risultato serve a confrontare versioni dello stesso testo, purché si mantengano costanti le condizioni.

Non chiederei invece al chatbot «quanti token hai usato?» aspettandomi un rendiconto contabile. Se non sta leggendo un dato di utilizzo effettivo, può soltanto stimare. Il pannello dei consumi, quando disponibile, ha un ruolo diverso dalla risposta generata nella conversazione.

Un buon primo esercizio è prendere una richiesta abituale, contarla, eliminare le ripetizioni e ricontarla. Poi bisogna verificare che la nuova versione produca ancora una risposta adeguata. Accorciare senza questa seconda verifica è come alleggerire una valigia buttando via anche il passaporto.

Per chi sviluppa automazioni

Il testo scritto dall’utente può essere soltanto una parte della richiesta. Ci sono istruzioni del sistema, ruoli dei messaggi, descrizioni degli strumenti, schemi di risposta e allegati. Un conteggio locale della sola domanda può quindi sottostimare il lavoro effettivo.

OpenAI mette a disposizione un endpoint per contare i token dell’input completo. Anthropic offre un servizio di token counting per Claude, precisando che il conteggio preventivo è una stima che può differire leggermente dal consumo finale. Per un’applicazione, il riferimento operativo è il contatore del fornitore associato alla richiesta reale.

La sequenza che consiglio è: identificare il modello, preparare la richiesta completa, contarne l’input, definire un limite ragionevole all’output, eseguire e confrontare previsione e consuntivo. Dopo un numero sufficiente di casi rappresentativi, le stime diventano utili per pianificare il budget.

3. Token in ingresso, in uscita, di ragionamento e in cache

Dire «ho consumato diecimila token» non basta per conoscere il costo. Occorre capire di quali token si tratta e come vengono tariffati. Per orientarsi, questa tabella distingue le voci che è utile cercare nella documentazione e nel rendiconto del servizio.

Voce Che cosa descrive Che cosa controllare
Input Contenuti che il modello riceve Tariffa e quantità, inclusi gli elementi aggiunti dall’applicazione
Output Contenuti generati Tariffa specifica e limite di generazione
Ragionamento Elaborazione interna conteggiata dai modelli che la prevedono Se è già inclusa nel totale di output
Input in cache Parte riutilizzata attraverso un meccanismo di cache Sconto, condizioni, durata ed eventuali costi di scrittura
Contenuti multimodali Immagini, audio, video o rappresentazioni ricavate dai file Regole proprie del modello e del servizio

La risposta visibile può essere soltanto una parte

Per i modelli di ragionamento descritti da OpenAI, i token usati nel ragionamento possono essere conteggiati e fatturati come output pur non comparendo nel testo finale. Inoltre, un limite di output può comprendere anche questa elaborazione. Lo spiega la documentazione ufficiale sui reasoning models.

La conseguenza è concreta: una risposta breve non garantisce una chiamata economica. E un limite troppo basso può interrompere il lavoro prima che arrivi una risposta utilizzabile. Nel calcolo della spesa, soprattutto, non bisogna sommare due volte il ragionamento se il contatore lo include già nell’output.

Le immagini non si contano come le parole

La stessa prudenza serve per audio, immagini e video. Google documenta la tokenizzazione anche degli input multimodali; OpenAI descrive regole specifiche per immagini e visione. Non esiste un rapporto universale tra megabyte e token.

Ridurre il peso di una fotografia può rendere più rapido il caricamento, ma non implica una riduzione proporzionale dei token. Potrebbero contare risoluzione, dettaglio o altre modalità di elaborazione. Un file leggero e una richiesta leggera sono due caratteristiche che vanno misurate separatamente.

4. La finestra di contesto: perché una chat non è un pozzo senza fondo

La finestra di contesto è la capacità massima di contenuti che il modello può gestire in una richiesta, secondo le regole della sua architettura e del servizio. Pensatela come il tavolo di lavoro: deve esserci spazio per i documenti da consultare e per il lavoro da produrre.

La documentazione OpenAI sulla gestione delle conversazioni distingue il limite di contesto dal limite di output. Una finestra ampia non significa che il modello possa generare una risposta lunga quanto tutta la finestra. Non significa neppure che ogni informazione inserita riceverà sempre la stessa attenzione.

Un esempio puramente didattico: se il tavolo contiene al massimo 100.000 unità e ne occupiamo 95.000 con i materiali, non possiamo presumere di avere ancora spazio per una risposta da 20.000. Nella pratica vanno controllati i limiti effettivi e l’eventuale spazio necessario al ragionamento.

Perché «continua» può costare più di quanto sembra

In una conversazione, il sistema può includere anche messaggi precedenti. Se dopo una lunga analisi scrivo soltanto «continua», il mio nuovo testo è brevissimo, ma il contesto utilizzato può essere molto più grande.

OpenAI precisa che, anche collegando le risposte tramite previous_response_id, i precedenti token di input nella catena sono fatturati come input. La cache può incidere sul prezzo secondo le condizioni applicabili; il collegamento alla conversazione non rende automaticamente gratuita la storia precedente.

Nelle interfacce per utenti finali possono intervenire selezione, sintesi e gestione automatica del contesto. Non bisogna quindi immaginare un comportamento identico in tutti i prodotti. Il consiglio operativo è mantenere una conversazione per progetto o obiettivo, evitando di trasformarla nell’archivio indistinto di tutta l’azienda.

Quando la chat diventa molto lunga, preparate un passaggio di consegne: obiettivo, decisioni già prese, dati indispensabili, fonti e questioni aperte. Rileggetelo prima di avviare una nuova conversazione. Risparmiare spazio perdendo una condizione decisiva è un pessimo affare.

5. Quanto costano i token AI: formula ed esempio completo

Per una chiamata testuale semplice, senza voci aggiuntive, il costo si calcola così:

Costo = (token input / 1.000.000 × prezzo input)
      + (token output / 1.000.000 × prezzo output)

I prezzi devono essere espressi nella stessa valuta e riferirsi allo stesso modello e alla stessa modalità di servizio. Se il listino usa una base diversa da un milione, va adattato il divisore. Se sono presenti input in cache o altre voci, occorre separarli senza conteggiarli due volte.

Un esempio con prezzi ipotetici

Immaginiamo un servizio che costi 2 euro per milione di token in ingresso e 8 euro per milione in uscita. Sono cifre inventate per spiegare il calcolo, non il listino di un prodotto.

Una richiesta usa 12.000 token di input e produce 2.000 token di output:

Componente Calcolo Costo ipotetico
Input 12.000 / 1.000.000 × 2 euro 0,024 euro
Output 2.000 / 1.000.000 × 8 euro 0,016 euro
Totale della chiamata 0,024 + 0,016 0,040 euro

Quattro centesimi sembrano pochi. Se però il processo viene eseguito 10.000 volte, il costo di quelle sole chiamate diventa 400 euro. Il passaggio dalla prova individuale al processo aziendale cambia la scala del problema.

Supponiamo di selezionare meglio i documenti, scendendo a 6.000 token di input, e di chiedere un output utile da 1.000 token. Alle stesse tariffe, il costo diventa 0,012 più 0,008, cioè 0,020 euro: 200 euro per 10.000 chiamate. In questo esempio il risparmio è del 50%, ma solo se la qualità resta sufficiente e non servono nuove chiamate correttive.

Dal costo della chiamata al costo del lavoro

La fattura può includere ricerche, archiviazione, strumenti, elaborazioni dei file o altre componenti previste dal servizio. Nell’organizzazione esistono poi costi di integrazione, controllo e manutenzione. La formula precedente misura una parte, non l’intero progetto.

Io aggiungerei una seconda formula, manageriale:

Costo per risultato accettato = costo complessivo del processo
                              / risultati che superano il controllo

Una soluzione che genera cento risposte economiche ma ne lascia inutilizzabili quaranta va confrontata su questa base. Anche il tempo delle persone che correggono ha un valore. Il modello meno caro per milione di token non è necessariamente quello meno caro per pratica conclusa bene.

Abbonamento e API non sono la stessa fattura

Se usate un abbonamento a un chatbot, non convertite automaticamente ogni messaggio nella tariffa API del modello. State acquistando un prodotto con le proprie condizioni, funzioni e limiti. Nell’API acquistate accesso programmatico con una specifica struttura di prezzi. Possono esserci consumi misurati in entrambi i casi, ma non una corrispondenza commerciale universale.

Per un ufficio acquisti la domanda giusta è: che cosa comprende il contratto, che cosa fa scattare un extra e dove posso leggere il consumo reale? Il nome del modello, da solo, non risponde.

6. Perché si parla di una nuova economia dei token

La parte interessante comincia quando smettiamo di considerare il chatbot un passatempo e lo inseriamo nei processi. Se un assistente prepara bozze, consulta documenti o gestisce passaggi di un’attività, il consumo diventa una voce da progettare e misurare.

Non significa che il token sia una misura perfetta del lavoro. Significa che può diventare un’unità contrattuale comoda per vendere una parte di quel lavoro. È un po’ quello che succede con il traffico dati: un gigabyte non misura il valore della telefonata con un cliente, ma aiuta a costruire un’offerta commerciale.

Un segnale concreto arriva da NVIDIA. Nell’articolo tecnico del 21 maggio 2026 dedicato ai servizi AI delle telecomunicazioni misurati in token, l’azienda descrive infrastrutture e modelli di vendita nei quali si controllano token per cliente, input e output, velocità e costo unitario. È una proposta industriale di un fornitore interessato a questo mercato, non una legge economica neutrale.

La mia interpretazione è che stia emergendo una contabilità dell’AI più simile a quella delle infrastrutture: quanta capacità acquistiamo, come la distribuiamo, quali servizi produciamo e con quali margini. Per una PMI, questa trasformazione può arrivare dentro un gestionale o un servizio commerciale, senza che nessuno pronunci «token» durante la giornata.

Dalle licenze per persona al budget per attività

Un possibile sviluppo è affiancare al costo della licenza un budget per i compiti svolti. Una persona potrebbe avere a disposizione diversi strumenti, un livello di accesso e una capacità di elaborazione assegnata. Alcune attività sarebbero autorizzate automaticamente, altre richiederebbero una soglia di spesa superiore.

Questo è uno scenario organizzativo, non la previsione che tutti i contratti di lavoro cambieranno nello stesso modo. Ma pone una domanda utile già oggi: se due dipendenti hanno compiti simili e accessi molto diversi all’AI, come confrontiamo davvero tempi e risultati?

Il punto non è premiare chi brucia più token. Potrebbe aver prodotto più valore, oppure aver lasciato un agente girare a vuoto. Un cruscotto che mostra soltanto i consumi rischia di celebrare il rubinetto aperto.

Se il prezzo scende, la spesa può comunque salire

Lo Stanford AI Index 2025 riporta che il costo di inferenza per prestazioni al livello di GPT-3.5 è diminuito di oltre 280 volte tra novembre 2022 e ottobre 2024. È un dato storico riferito a quel confronto, non la promessa che ogni servizio AI continuerà a calare allo stesso ritmo.

Possiamo però usarlo per ragionare. Se un’attività diventa molto più economica, potremmo svolgerla più spesso o applicarla a nuovi problemi. Un’impresa che prima analizzava un documento al mese potrebbe analizzarne centinaia al giorno. La spesa unitaria scende, il numero di operazioni cresce.

Esempio ipotetico: passiamo da cento attività a un euro ciascuna a mille attività a cinquanta centesimi ciascuna. Il costo unitario si è dimezzato, ma la spesa totale passa da cento a cinquecento euro. Nessuna contraddizione: sono cambiati i volumi.

Per questo non basta chiedere «quanto costa un milione di token?». Bisogna chiedere quante volte il processo verrà eseguito, quante chiamate comprende e che cosa ne determina la conclusione.

7. I token sostituiranno davvero il denaro?

La formula «i token sono la nuova moneta» funziona bene in una conferenza. Per usarla seriamente bisogna però distinguere almeno tre significati: unità tecnica del modello, credito per comprare un servizio e strumento monetario. Non diventano la stessa cosa solo perché condividono una parola.

La Banca centrale europea, nella spiegazione di che cosa sia la moneta, richiama tre funzioni: mezzo di scambio, unità di conto e riserva di valore. Applicare queste categorie ai token degli LLM rende visibili i limiti della metafora.

Un token generato durante una risposta non è, per questo, un bene che posso trasferire al supermercato per pagare la spesa. Un credito prepagato per un servizio AI può avere un valore d’uso, ma trasferibilità, scadenza e rimborso dipendono dalle condizioni commerciali. La tokenizzazione del linguaggio, inoltre, non coincide con la rappresentazione di attività finanziarie su una blockchain.

Perché non sono tutti intercambiabili

La stessa frase può avere conteggi diversi con tokenizer diversi. Anche a parità di quantità, modelli differenti possono avere prezzi, capacità e velocità differenti. Dire «possiedo un milione di token» senza specificare il servizio è incompleto: un milione di che cosa, utilizzabile dove e per ottenere quali prestazioni?

Un’unità di consumo non è neppure una misura universale dell’energia necessaria. Il costo di elaborazione dipende anche dal modello, dall’hardware e dal modo in cui viene eseguito. La metafora del contatore aiuta a capire la fatturazione, ma non trasforma il token in un kilowattora standard.

La mia conclusione è quindi più prudente: i token possono diventare una misura diffusa dell’accesso a capacità AI, mentre il loro prezzo continuerà a essere espresso in denaro nei servizi che li vendono. L’eventuale nascita di mercati trasferibili per diritti di calcolo sarebbe un ulteriore sviluppo, da dimostrare e descrivere con le sue regole.

La domanda politica nascosta dentro quella economica

Lo scenario che trovo più interessante riguarda l’accesso. Immaginiamo due piccoli studi professionali: uno può permettersi strumenti ben configurati, documenti ordinati e verifiche; l’altro usa servizi limitati e materiali disorganizzati. Il divario non dipende soltanto dalla competenza individuale.

È ragionevole domandarsi se scuole, biblioteche o organizzazioni possano offrire capacità AI condivisa, insieme alla formazione per usarla. Sarebbe una scelta di politica dell’accesso, non la prova che il denaro sia scomparso. Qualcuno dovrebbe comunque pagare infrastrutture, manutenzione e assistenza.

Ecco perché preferisco parlare di alfabetizzazione economica sull’AI. Sapere che cosa si consuma aiuta a discutere come distribuire una risorsa. Convincersi che il token sia già una moneta universale rischia soltanto di aggiungere confusione al preventivo.

8. Markdown e token: che cosa cambia davvero

Il Markdown è un modo per organizzare testo semplice con pochi simboli: cancelletti per i titoli, trattini per gli elenchi, asterischi per l’enfasi. La guida di riferimento CommonMark mostra questa sintassi con esempi essenziali.

Per chi prepara materiali da usare con l’AI, il vantaggio è la possibilità di mantenere una struttura leggibile senza dipendere dall’aspetto grafico di una pagina. Si vedono subito sezioni, vincoli e informazioni principali. Ma Markdown non è un algoritmo magico di compressione.

Un testo già pulito può occupare meno token della sua versione Markdown. Una pagina HTML può invece contenere tag e attributi che non servono al compito. Il confronto sensato riguarda la rappresentazione effettivamente inviata al modello, non il nome dell’estensione del file.

Un confronto misurato, non una percentuale pubblicitaria

Ho preparato una piccola scheda commerciale inventata in tre formati e l’ho contata con tiktoken 0.14.0 e o200k_base. I testi sono quelli riportati qui sotto, senza una riga vuota aggiunta alla fine.

Testo semplice:

Offerta
Prodotto: Stampante A3
Prezzo: 1200 euro
Assistenza: inclusa

Markdown:

# Offerta
- Prodotto: Stampante A3
- Prezzo: 1200 euro
- Assistenza: inclusa

HTML:

<h1>Offerta</h1>
<ul>
<li>Prodotto: Stampante A3</li>
<li>Prezzo: 1200 euro</li>
<li>Assistenza: inclusa</li>
</ul>
Rappresentazione della stessa scheda Token nel test
Testo semplice 24
Markdown 29
HTML 48

In questo esempio il Markdown usa circa il 39,6% di token in meno rispetto all’HTML: 19 token risparmiati su 48. Ma usa circa il 20,8% in più rispetto al testo semplice: cinque token aggiuntivi su 24. Cambiando testo o codifica, cambiano i risultati.

La tabella non dimostra che caricare un documento Markdown costi sempre meno che caricare un PDF o una pagina web. Un’applicazione potrebbe estrarre già il solo testo dall’HTML; un’altra potrebbe usare rappresentazioni diverse del file. Qui misuriamo tre stringhe, non tre interi processi di caricamento.

Come scegliere tra testo, Markdown, CSV e JSON

Io partirei dal compito. Per un testo breve, la forma semplice può bastare. Per istruzioni e documenti con sezioni, Markdown offre una gerarchia facile da leggere. Per molte righe con le stesse colonne, un formato tabellare come CSV può essere appropriato. Se un programma deve interpretare campi e oggetti, può servire JSON.

Non eliminerei una struttura necessaria solo per ridurre il conteggio. Se la risposta deve alimentare un gestionale, un oggetto JSON valido può valere più di una prosa leggermente più corta ma impossibile da acquisire automaticamente.

Una tabella Markdown, inoltre, può contenere molte barre verticali e separatori. Su piccoli esempi sono innocui; su grandi insiemi di dati conviene confrontare formati alternativi. Un’intestazione chiara seguita da righe coerenti può essere più utile di una griglia molto elaborata.

Attenzione anche alle unità: «1200» da solo è più corto di «1200 euro, IVA esclusa», ma comunica meno. Per un preventivo la differenza può essere decisiva. I simboli superflui si possono eliminare; le condizioni commerciali no.

Un prompt in Markdown da usare come modello

# Obiettivo
Confronta le due offerte per scegliere il fornitore.

## Criteri
- Costo totale su 36 mesi
- Assistenza inclusa
- Tempi di intervento
- Esclusioni dichiarate

## Regole
Usa solo i dati nei documenti.
Segnala le informazioni mancanti senza inventarle.
Distingui dati espliciti e tue valutazioni.

## Risposta
Una tabella comparativa e una raccomandazione motivata.
Massimo 300 parole, escluse le citazioni dei documenti.

Il vantaggio principale di questo esempio è che rende visibile il lavoro richiesto. Un prompt vago da cinque parole potrebbe costare meno al primo invio, ma richiedere cinque correzioni. La buona struttura si valuta sull’intero scambio.

9. PDF, Word ed Excel: allegare tutto non è una strategia

«Ti carico tutto, così hai il contesto». È un’intenzione comprensibile. Se però il materiale contiene versioni vecchie, intestazioni ripetute e tabelle fuori tema, il compito diventa più difficile da delimitare.

Prima di allegare un documento, chiedetevi quali informazioni servano per la decisione. Un confronto tra due condizioni di assistenza richiede le clausole pertinenti e i rimandi necessari. Non richiede automaticamente ogni catalogo commerciale dell’azienda. Se invece il compito è trovare tutte le eccezioni distribuite in un contratto, selezionare pochi paragrafi può essere insufficiente.

Convertire un file non significa conservarne tutto il significato

Un PDF può contenere testo selezionabile, scansioni o una combinazione di elementi. La conversione in testo o Markdown va controllata: colonne mescolate, note staccate e celle perse possono modificare il senso. Per i file gestiti dalle API, i metodi di conteggio dei fornitori distinguono infatti il testo isolato dagli input completi con allegati.

Nel caso di un foglio di calcolo, una copia testuale dei valori può perdere formule, relazioni tra fogli e informazioni utili sulla struttura. Prima di scegliere il formato, bisogna decidere se interessa leggere i risultati, controllare i calcoli oppure ricostruire il modello.

La procedura che suggerisco è: conservare l’originale, preparare una versione adatta al compito, confrontare le parti delicate e mantenere riferimenti a pagina, sezione o cella. Solo dopo ha senso misurare il risparmio.

Recuperare i passaggi necessari al momento giusto

Per archivi ampi, si può progettare un sistema che cerchi i documenti pertinenti e porti al modello i passaggi utili quando servono. La riflessione di Anthropic sul context engineering tratta proprio la selezione e la gestione del contesto come parte del lavoro dell’agente.

La selezione deve però essere verificata. Una ricerca che recupera cinque pagine sbagliate è economica soltanto sulla carta. Per domande trasversali, eccezioni o confronti completi possono servire più passaggi e controlli. Il criterio non è «inviare sempre meno», ma inviare abbastanza informazioni pertinenti da rendere il risultato affidabile.

10. Dieci modi per risparmiare token senza peggiorare il lavoro

La guida OpenAI all’ottimizzazione dei costi individua tre leve generali: ridurre le richieste, contenere input e output, scegliere un modello adeguato. Nella pratica, però, serve tradurre queste indicazioni in abitudini verificabili. Ecco quelle che suggerisco.

1. Definire il risultato prima di scrivere il prompt

«Analizza questo documento» lascia aperte troppe possibilità. «Individua le differenze tra le due versioni nelle condizioni di rinnovo e recesso» delimita un lavoro. Prima di chiedere, decidete che cosa dovrete fare con la risposta. Un obiettivo chiaro può evitare approfondimenti che nessuno leggerà e successive richieste di correzione.

2. Dare un limite utile alla risposta

Indicate il formato e la lunghezza necessari: cinque punti, una tabella con determinate colonne, una sintesi esecutiva di duecento parole. Il limite linguistico nel prompt guida la risposta; un limite tecnico API pone invece un tetto alla generazione. Non sono equivalenti. Un tetto troppo stretto può tagliare proprio il passaggio conclusivo che vi serve.

3. Eliminare duplicati e versioni superate

Un documento approvato, con data e versione chiare, è spesso più utile di cinque bozze quasi identiche. Conservate le versioni precedenti quando il compito è confrontarle; negli altri casi, evitate di far scegliere al modello quale sia quella valida. La pulizia documentale riduce ambiguità prima ancora di ridurre token.

4. Chiedere soltanto le modifiche necessarie

Se una proposta è corretta e va cambiata una sezione, chiedete quella sezione. Riscrivere ogni volta tutto il documento genera testo che avete già. Per una revisione editoriale, potete richiedere un elenco delle modifiche o i soli paragrafi sostitutivi. Alla fine fate comunque un controllo dell’insieme, perché le parti devono restare coerenti.

5. Separare le istruzioni stabili dai dati variabili

Definite un modello di lavoro con scopo, criteri e formato. Aggiungete poi i materiali del caso specifico. È una scelta che rende più facile confrontare i risultati e, nelle integrazioni che lo supportano, organizzare il riuso del contesto. Evitate di cambiare casualmente le stesse istruzioni a ogni esecuzione: rende più difficile capire da dove arrivino differenze di qualità e costo.

6. Valutare la cache quando il contesto si ripete

Il prompt caching permette di riutilizzare elaborazioni di contenuti ripetuti secondo regole precise. Nella documentazione Anthropic sulla cache sono distinti costi di scrittura, lettura e durata, con differenze tra modelli. Non è sufficiente immaginare che il chatbot «si ricordi» il manuale.

Se cento richieste condividono le stesse istruzioni, la cache può essere interessante. Se i materiali cambiano continuamente o il riuso è raro, il vantaggio va ricalcolato. Può diminuire il costo senza diminuire nella stessa proporzione il numero di token rappresentati nel contesto. Non è neppure una finestra di contesto più grande. Misurate quanto viene realmente riutilizzato e a quale tariffa.

7. Provare un modello più economico su casi rappresentativi

Per classificare un messaggio o estrarre campi semplici, un modello meno costoso potrebbe bastare. Per analisi ambigue potrebbe servire qualcosa di diverso. Il condizionale è necessario: non sceglierei il modello con un’intuizione o con una sola prova riuscita. Preparerei esempi normali, casi difficili e casi con dati mancanti, poi confronterei costo e accuratezza.

8. Usare elaborazioni differite quando non serve l’immediatezza

Se dovete classificare molte schede entro il giorno successivo, potreste non aver bisogno di una risposta istantanea per ciascuna. La Batch API di OpenAI documenta uno sconto del 50% rispetto alle API sincrone per gli usi supportati, con una finestra di completamento entro 24 ore. Verificate disponibilità e condizioni del modello scelto.

È un esempio di risparmio sul prezzo, non necessariamente sulla quantità di token. Per un operatore al telefono con il cliente, l’attesa può essere inaccettabile; per una lavorazione notturna può essere perfettamente ragionevole.

9. Non usare un LLM per ogni operazione

Un filtro, una formula o una regola deterministica possono risolvere una parte del compito senza una generazione linguistica. Se devo sommare una colonna, il primo candidato resta un foglio di calcolo. Se devo capire descrizioni disomogenee, l’AI può aiutare a trasformarle in dati strutturati da verificare. Combinare strumenti diversi è spesso più sensato che chiedere alla stessa macchina di fare tutto.

10. Misurare anche le correzioni

Annotate quante risposte vanno rifatte e perché. Un prompt più lungo che evita tre tentativi può consumare meno sull’intera attività. Un output più dettagliato può risparmiare tempo di verifica; uno prolisso può sprecarlo. L’obiettivo è trovare il livello di dettaglio adatto, mantenendo costanti i criteri con cui considerate un risultato accettabile.

11. Gli agenti AI: quando il consumo diventa meno visibile

Con un chatbot tradizionale, vediamo una domanda e una risposta. Un agente può scomporre il lavoro, consultare strumenti, leggere risultati, fare tentativi e continuare. Il consumo va quindi osservato sull’intero percorso, non soltanto sul messaggio finale.

Nel mio approfondimento su quando servono davvero gli agenti AI in azienda distinguo i casi in cui l’autonomia ha senso da quelli gestibili con un’automazione più semplice. Anche per i token questa distinzione è utile: ogni passaggio deve avere una ragione.

Immaginiamo un agente incaricato di confrontare fornitori. Potrebbe cercare, aprire pagine, leggere PDF, estrarre dati, accorgersi di una mancanza e ricominciare. Se la richiesta è «trova la soluzione migliore in assoluto», quando può considerarsi soddisfatto? L’assenza di un criterio di conclusione è anche un problema di budget.

Un incarico con confini chiari

Per un esperimento pilota, formulerei un mandato di questo tipo:

Confronta tre fornitori usando i cinque criteri indicati. Interrompi la ricerca quando hai raccolto i dati necessari oppure quando hai raggiunto il limite di attività configurato. Segnala ciò che manca e chiedi una decisione prima di ampliare il lavoro.

Il testo, da solo, non garantisce il rispetto di un tetto economico. Nell’applicazione servono contatori e limiti effettivi: spesa massima, numero di chiamate, durata e gestione degli errori. La guida tecnica OpenAI a un controllore di spesa per singola esecuzione illustra proprio l’esigenza di conteggiare correttamente le componenti e controllare il budget durante il processo.

Occorre decidere anche chi interviene quando il limite viene raggiunto. Un agente che si ferma lasciando un rendiconto chiaro è più gestibile di uno che continua a tentare senza spiegare perché. Il tema si collega alla distinzione tra human-in-the-loop e human-on-the-loop: la supervisione deve essere progettata.

Non affiderei al solo prompt «non spendere troppo» il controllo del portafoglio. Sarebbe come dare la carta aziendale a qualcuno aggiungendo soltanto: «Mi raccomando, giudizio».

12. Tre esempi aziendali per mettere insieme i pezzi

I casi seguenti sono scenari didattici, non risultati misurati presso clienti. Servono a mostrare come cambiano le decisioni quando si considerano insieme contesto, formato, qualità e consumo.

Caso A: un commerciale confronta due offerte

Il commerciale deve capire quale proposta soddisfi meglio le esigenze del cliente. Nella prima impostazione carica due cataloghi interi e chiede una valutazione generica. Riceve una lunga descrizione dei prodotti, ma mancano costo totale e condizioni dell’assistenza.

Nella seconda impostazione prepara le schede dei prodotti pertinenti, le condizioni economiche e gli allegati richiamati. Usa un prompt con criteri espliciti: durata, volumi previsti, costo totale, assistenza, esclusioni. Chiede una tabella e l’elenco dei dati mancanti.

Il risparmio potenziale arriva dalla selezione dei materiali e dalla riduzione delle riscritture. Il controllo finale riguarda proprio le informazioni che sarebbe pericoloso eliminare: unità, IVA, durata, limiti e condizioni. La versione corta va scartata se nasconde una voce di costo.

Caso B: un ufficio prepara risposte alle richieste ricorrenti

L’ufficio ha un documento approvato con procedure e risposte frequenti. Per ogni richiesta, il sistema individua la sezione pertinente e prepara una bozza. Le istruzioni stabili possono essere riutilizzate; i messaggi dei singoli utenti sono la parte variabile.

Prima di andare a regime, farei una prova con domande semplici, richieste ambigue e casi non coperti dal documento. Misurerei risposte corrette, rinvii necessari a una persona e tempo di revisione. Un sistema che inventa una procedura pur di rispondere in fretta non supera il test, anche se consuma pochissimo.

Qui il formato utile potrebbe essere Markdown per la base documentale e un output strutturato per classificare la richiesta. La scelta dipende da come il servizio sarà integrato, non da una presunta superiorità universale di un formato.

Caso C: un consulente analizza un archivio di verbali

Il consulente vuole individuare decisioni e responsabilità distribuite in molti verbali. Riassumere tutto in un unico passaggio può perdere rimandi. Preparerei invece una prima estrazione strutturata: data, decisione, responsabile, scadenza e fonte.

Poi confronterei i dati, tornando ai verbali originali per contraddizioni e punti dubbi. Una parte dell’analisi può essere svolta con filtri e tabelle; l’AI serve dove occorre interpretare il linguaggio. La lavorazione iniziale potrebbe essere differita se non esiste urgenza.

La valutazione deve includere il costo di preparazione dell’archivio. Se verrà interrogato una volta soltanto, una procedura complessa potrebbe non convenire. Se servirà ogni settimana, investire in una struttura verificata può avere senso. Il numero dei token non sostituisce il ragionamento sul processo.

13. Come controllare i consumi in azienda senza creare un’altra burocrazia

Per iniziare non serve un sistema enorme. Serve un piccolo registro che colleghi la spesa al lavoro svolto. Per ciascun processo, raccoglierei almeno queste informazioni:

Informazione Domanda a cui risponde
Attività e responsabile Perché stiamo usando l’AI e chi valuta il risultato?
Modello e modalità di servizio Quali prestazioni e tariffe stiamo confrontando?
Numero di esecuzioni e chiamate Quanto cresce il processo quando aumenta il lavoro?
Input, output e cache Quali componenti determinano la spesa?
Costo totale e tempo di revisione Quanto costa davvero ottenere il risultato?
Esiti accettati, errori e ripetizioni Il risparmio sta peggiorando la qualità?

Fare una prima rilevazione per un periodo limitato consente di scoprire dove intervenire. Magari il prompt principale è già ragionevole, mentre uno strumento restituisce pagine di dati inutili. Oppure ogni operatore ripete la stessa richiesta perché il formato non è stato concordato.

Confronterei i risultati per attività omogenee. Il consumo di chi prepara un’analisi complessa non è direttamente confrontabile con quello di chi classifica brevi messaggi. Un indicatore unico per tutte le persone rischia di premiare l’uso più banale e penalizzare il lavoro che richiede attenzione.

Infine, definirei soglie comprensibili: quando parte un avviso, chi lo riceve e che cosa succede al raggiungimento del limite. Un avviso di budget non va scambiato per un blocco automatico della spesa: bisogna verificare che cosa faccia davvero il sistema configurato.

14. Domande frequenti sui token AI

Mille token equivalgono a mille parole?

No. Nell’inglese, la regola orientativa citata prima porta a circa 750 parole per mille token. Per l’italiano e per contenuti particolari bisogna misurare. Anche punteggiatura, spazi e codici contribuiscono al risultato: non esiste un cambio fisso tra parole e token.

Se scrivo «per favore» spreco soldi?

Le parole aggiunte fanno parte del testo da elaborare, ma concentrarsi soltanto sulla cortesia è una priorità discutibile. Prima controllerei allegati inutili, output troppo lunghi, tentativi ripetuti e chiamate automatiche. Scrivete in modo naturale e chiaro: trasformare ogni richiesta in un telegramma può introdurre ambiguità molto più costose da correggere.

Conviene scrivere sempre in inglese?

Non lo stabilirei senza una prova sul modello e sul lavoro specifici. La tokenizzazione può cambiare, ma tradurre ha a sua volta un costo e può alterare termini importanti. Per un processo italiano, valutate prima precisione e facilità di controllo. Un vantaggio sul conteggio non basta se aumenta il rischio di interpretazione sbagliata.

Comprimere un PDF o salvarlo come ZIP riduce i token?

Non automaticamente. La compressione del file e la rappresentazione usata dal modello sono aspetti diversi. Se l’applicazione estrae lo stesso testo, il numero di byte del contenitore non determina da solo il conteggio. Prima serve capire come il servizio legge quel file e quali informazioni passa effettivamente al modello.

Una nuova chat azzera tutti i costi precedenti?

No: le elaborazioni già eseguite restano eseguite. Una nuova conversazione può aiutare a delimitare il contesto successivo, ma non cancella consumi precedenti. Inoltre il prodotto può includere istruzioni, memorie o materiali di progetto. Per sapere che cosa viene conteggiato occorre osservare il comportamento documentato del servizio utilizzato.

Il modello locale elimina il problema?

Può cambiare il modo in cui sostenete i costi, ma non rende l’elaborazione priva di risorse. Al posto di una fattura a token potete avere hardware, energia, manutenzione e tempo di gestione. La scelta va confrontata sul carico di lavoro e sulle esigenze reali, non sulla sola assenza di un prezzo per chiamata.

Un prompt più lungo è sempre peggiore?

No. Una condizione, un esempio o una definizione possono evitare errori e nuovi tentativi. Il prompt migliore contiene le informazioni necessarie per il risultato richiesto. La misura utile resta il costo dell’attività completata correttamente, non il record di brevità del primo messaggio.

15. La competenza da imparare: dare valore a ciò che chiediamo

La mia proposta è trattare i token come una lente per osservare il lavoro. Quando prepariamo un documento per l’AI, siamo costretti a chiarire che cosa conta. Quando fissiamo un limite alla risposta, decidiamo che cosa leggeremo. Quando definiamo la conclusione di un’attività, rendiamo esplicito che cosa consideriamo un risultato.

Queste scelte hanno un’utilità anche fuori dai chatbot. Una procedura comprensibile, un archivio ordinato e una richiesta precisa aiutano pure il collega che deve rispondere al telefono. L’AI aggiunge un contatore a problemi organizzativi che spesso esistevano già.

I token potrebbero occupare uno spazio crescente nei budget e nelle discussioni sull’accesso alla tecnologia. Ma il valore continuerà a dipendere da ciò che riusciamo a fare con quella capacità: risolvere un problema, prendere una decisione documentata, produrre qualcosa che serva a qualcuno.

Non vorrei un’azienda bravissima a contare i token e incapace di riconoscere una risposta sbagliata. Preferisco un’azienda che sappia formulare una richiesta, misurarne il costo e assumersi la responsabilità di usarne il risultato.

Se vuoi lavorare su questi aspetti con il tuo team, puoi contattarmi per un corso o una consulenza sull’AI generativa. Possiamo partire dai vostri documenti e dalle vostre attività, individuando quali prove fare e con quali criteri valutarle.

Fonti e metodo

Le fonti primarie sono collegate nei paragrafi pertinenti: documentazione OpenAI, Anthropic e Google, CommonMark, NVIDIA, Stanford HAI e Banca centrale europea. Consultazione: 6 settembre 2026. Le caratteristiche dei servizi possono cambiare; prima di pianificare una spesa vanno ricontrollate le condizioni applicabili.

I conteggi della frase italiana e del confronto tra formati sono misurazioni sul testo esatto con tiktoken 0.14.0 e o200k_base; non rappresentano la fatturazione di una richiesta completa. I prezzi in euro e i casi aziendali sono esempi didattici dichiarati. Le riflessioni sul futuro dell’economia dei token sono interpretazioni e scenari, distinti dai fatti documentati.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
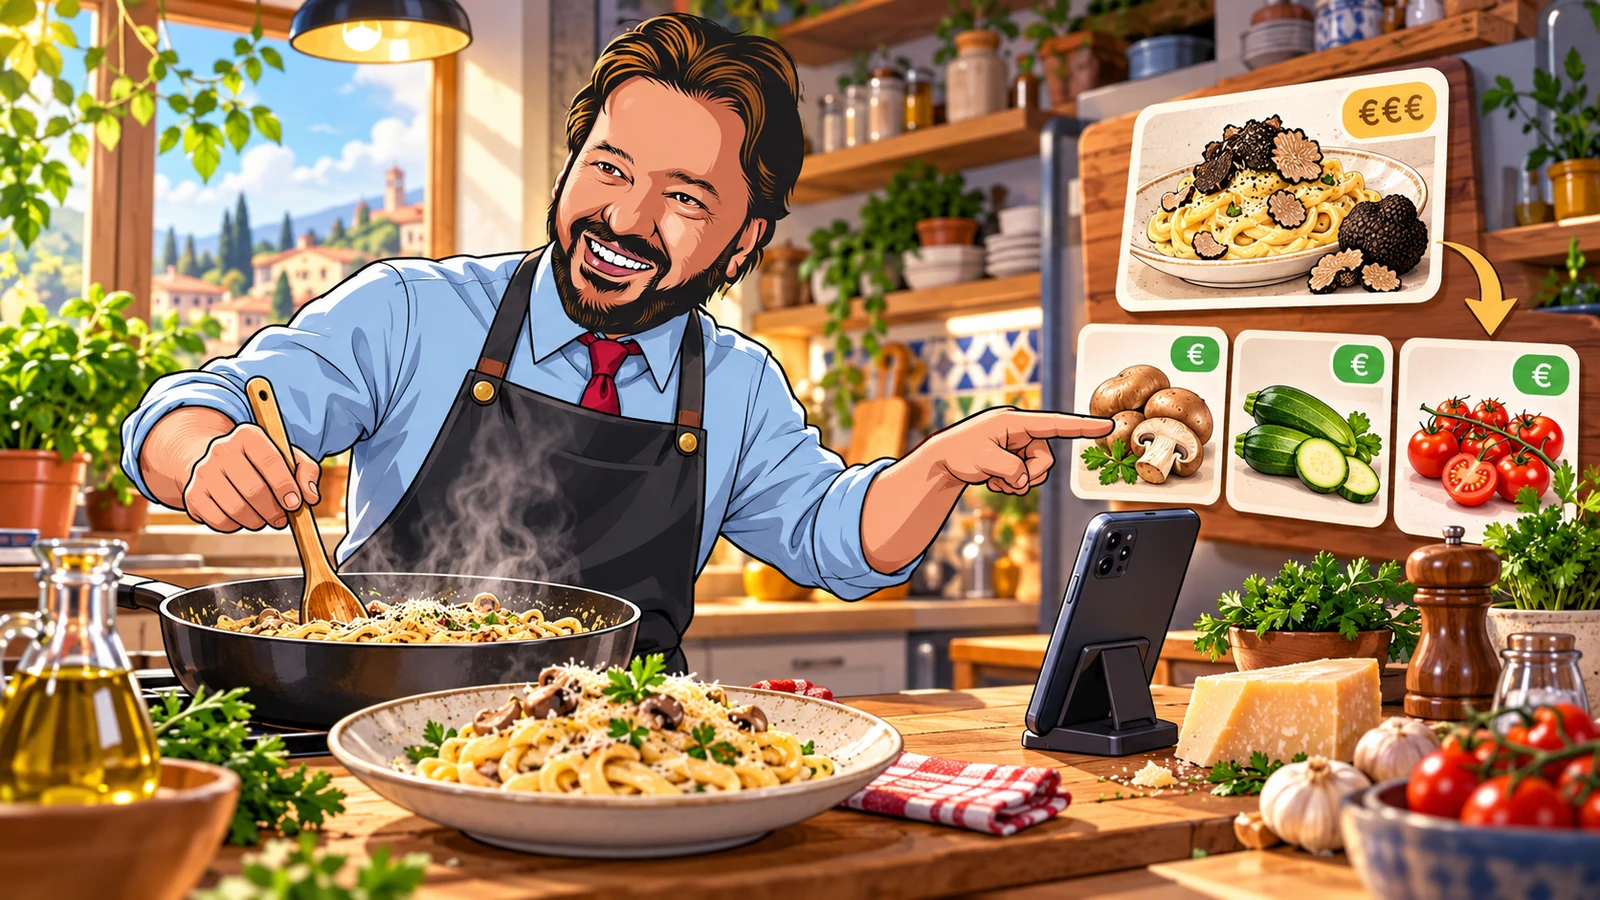
Inviaci email

Ogni mattina, in migliaia di caselle di posta, arriva la stessa email: tre risultati di Google Alerts, due dei quali duplicati e uno completamente fuori tema. Nel frattempo un agente AI potrebbe aver già letto centinaia di fonti, scartato il rumore e preparato una sintesi leggibile in trenta secondi. È la domanda che mi sento fare sempre più spesso da chi si occupa di comunicazione, SEO o brand reputation: ha ancora senso usare Google Alerts quando esistono motori di ricerca basati sull’intelligenza artificiale e veri agenti autonomi capaci di monitorare il web al posto nostro?

La risposta breve è: dipende da cosa dobbiamo monitorare, da quanto in fretta ci serve saperlo e da quanto siamo disposti a delegare. La risposta lunga richiede di capire come funziona oggi Google Alerts, dove si ferma, e che cosa cambia davvero con i motori AI e con gli agenti.

Che cos’è rimasto di Google Alerts nel 2026

Google Alerts nasce come strumento semplice: si imposta una query, si sceglie la frequenza (in tempo reale, una volta al giorno, una volta alla settimana) e si ricevono email quando compaiono nuovi risultati pertinenti su Ricerca Google. Il funzionamento, spiegato nella guida ufficiale di Google, non è cambiato di molto rispetto a quando lo strumento fu lanciato: resta gratuito, immediato da configurare, ma anche piuttosto rigido.

Negli anni Google ha investito pochissimo su questo prodotto. Non si integra con AI Overviews o con AI Mode, non distingue una menzione positiva da una negativa, non raggruppa le notizie per argomento, non impara dalle correzioni. È rimasto, di fatto, fermo a un’epoca precedente ai motori di ricerca conversazionali.

I limiti reali di Google Alerts oggi

  • Copertura parziale delle fonti. Fatica a coprire bene social network, forum verticali, gruppi Telegram o Facebook, marketplace: proprio i luoghi dove nascono molte crisi reputazionali.
  • Ritardo variabile. Anche in modalità “in tempo reale” possono passare ore o giorni prima che un contenuto già indicizzato generi una notifica.
  • Duplicati e rumore. La stessa notizia ripresa da decine di aggregatori riempie la casella di posta di link quasi identici.
  • Nessuna sintesi né priorità. Lo strumento non dice se una menzione è rilevante, virale o pericolosa: il lavoro di lettura e selezione resta interamente umano.
  • Nessuna azione. Si limita a notificare: non propone una risposta, non avvisa un collega, non aggiorna un foglio di lavoro, non apre un ticket.

Un esempio concreto: un’agenzia che monitora le menzioni di un brand riceve anche quaranta email al giorno, di cui solo tre davvero rilevanti, e nonostante questo si accorge in ritardo di una discussione nata su Reddit, perché quel tipo di fonte non viene intercettato con la stessa rapidità di una testata giornalistica.

Che cosa cambia con i motori di ricerca basati sull’AI

Con AI Overviews e AI Mode, Google non si limita più a restituire dieci link blu: costruisce una sintesi che cita le fonti. Strumenti come Perplexity vanno nella stessa direzione, ma capovolgono l’approccio di Alerts: invece di aspettare una notifica, si fa una domanda diretta e si ottiene una risposta aggiornata con le fonti citate. Nel mio articolo su come ho usato Perplexity per una ricerca mirata il principio è lo stesso applicato a un altro obiettivo: interrogare, non aspettare.

Questo cambiamento non riguarda solo come cerchiamo le informazioni, ma anche come veniamo trovati. Se le risposte AI sintetizzano il web al posto dell’utente, capire come il proprio brand o i propri contenuti vengono citati in quelle risposte diventa una nuova forma di monitoraggio, quella che nel mio approfondimento su SEO, GEO e AEO descrivo come necessità di ottimizzare non solo per l’algoritmo di ranking, ma per il modo in cui un modello linguistico riassume e cita le fonti.

Che cosa cambia davvero con gli agenti AI

I motori di ricerca AI rispondono a una domanda quando la facciamo. Un agente va oltre: lavora su un programma, consulta più fonti in autonomia, incrocia i dati, scarta il rumore, scrive una sintesi e, se lo abilitiamo, compie un’azione, come inviare un’email o aggiornare una tabella. È qui che la faccenda si fa interessante, e anche più delicata.

Più un agente passa dal “dire” al “fare”, più serve decidere quanto controllo umano mantenere. Nel mio articolo su human-in-the-loop e human-on-the-loop entro nel dettaglio di questa distinzione: per una sintesi giornaliera delle menzioni può bastare un supervisore che controlla a campione (on-the-loop), ma se l’agente deve rispondere pubblicamente a una recensione negativa, quel passaggio dovrebbe restare sotto approvazione umana (in-the-loop).

Quattro esempi pratici di monitoraggio con agenti AI

  • Rassegna stampa quotidiana automatica. L’agente legge decine di fonti ogni mattina, produce una sintesi con priorità e sentiment, e segnala alla persona solo le anomalie reali, invece di scaricare tutto il lavoro di lettura sull’utente.
  • Monitoraggio prezzi e attività dei concorrenti. L’agente controlla ogni giorno pagine e listini, e avvisa solo quando c’è una variazione significativa, non a ogni minima modifica del codice HTML.
  • Social listening esteso. L’agente copre Reddit, forum di settore, gruppi pubblici e community verticali che Google Alerts intercetta con difficoltà o in ritardo.
  • Monitoraggio della propria presenza nelle risposte AI. L’agente interroga periodicamente ChatGPT, Perplexity e AI Overviews con le domande tipiche del proprio settore, per verificare se e come il brand viene citato: un controllo che nessun Alert tradizionale può fare, perché non guarda “dentro” la risposta generata dal modello.

Per chi deve poi mettere in relazione documenti diversi raccolti durante il monitoraggio, come rassegne stampa, PDF e screenshot, uno strumento come Gemini Notebook può aiutare a incrociare fonti eterogenee invece di leggerle una per una.

Google Alerts, motori AI e agenti a confronto

Aspetto Google Alerts Motori di ricerca AI Agenti AI di monitoraggio
Copertura fonti Limitata, soprattutto su social e forum Ampia, ma legata al momento della domanda Ampia e programmabile su misura
Tempestività Da ore a giorni Immediata, ma solo su richiesta Continua, secondo la frequenza impostata
Sintesi e priorità Assente Buona sulla singola risposta Costruita su misura, con soglie e priorità
Azioni automatiche Nessuna Nessuna, resta conversazionale Possibili, da presidiare con attenzione
Costo Gratuito Gratuito o abbonamento Tempo di configurazione o costo del servizio
Controllo richiesto Minimo Minimo Da progettare (in-the-loop o on-the-loop)

Quando ha ancora senso usare Google Alerts

Non tutto merita un agente. Per un uso personale, per un tema poco competitivo, per un primo filtro gratuito su un argomento che non è ancora una priorità, Google Alerts resta uno strumento onesto: costa zero, si imposta in due minuti e, come rete a maglie larghe, qualcosa la intercetta comunque. Il problema nasce quando lo si usa come unico strumento per la reputazione di un brand, per la sicurezza di un’azienda o per capire in tempo reale una crisi in corso: lì il divario con motori AI e agenti diventa evidente, come racconto anche nella guida su come gestire la reputazione online, dove il monitoraggio è solo il primo passo di un processo più ampio.

Come costruire oggi un sistema di monitoraggio ibrido

  • Definire cosa conta davvero. Nome del brand, prodotti, dirigenti, hashtag, concorrenti diretti: non tutto merita lo stesso livello di attenzione.
  • Tenere Google Alerts come rete di base gratuita. Non va abbandonato, va ridimensionato al ruolo che può davvero sostenere.
  • Affiancare un motore AI per le domande puntuali. Utile quando serve una risposta rapida su un tema specifico, non una sorveglianza continua.
  • Costruire o adottare un agente per le fonti scoperte. Social, forum e community restano il punto debole di Alerts e il punto di forza di un agente ben configurato.
  • Scegliere il livello di supervisione giusto. Sintesi giornaliera in modalità on-the-loop, approvazione umana obbligatoria per ogni azione pubblica o sensibile.
  • Misurare che cosa si sarebbe perso. Confrontare periodicamente i risultati di Alerts con quelli dell’agente aiuta a capire quanto valore reale aggiunge il cambio di strumento.

Domande frequenti

Google Alerts è ormai inutile?

No, ma da solo non basta più per chi ha bisogno di rapidità, copertura ampia o sintesi. Resta valido come rete gratuita di base per temi a bassa priorità.

Gli agenti AI sostituiscono completamente Google Alerts?

Possono coprire molti dei suoi limiti, ma vanno progettati con attenzione: senza soglie, log e supervisione rischiano di generare falsi allarmi o azioni indesiderate.

Serve saper programmare per costruire un agente di monitoraggio?

Non sempre: esistono strumenti e piattaforme che permettono di collegare fonti, regole di sintesi e notifiche senza scrivere codice, anche se una configurazione più su misura richiede competenze tecniche.

Google Alerts copre bene i social network?

No, è uno dei suoi limiti più noti: social, forum e gruppi privati vengono intercettati in modo parziale e spesso in ritardo rispetto a siti di informazione indicizzati.

Qual è il rischio principale nel delegare il monitoraggio a un agente?

Perdere il controllo su ciò che l’agente fa in autonomia. Per questo conviene distinguere sempre tra un ruolo di supervisione (on-the-loop) e uno di approvazione obbligatoria (in-the-loop) per le azioni più delicate.

La domanda giusta non è più “Alerts sì o no”

Google Alerts non è morto, ma nel 2026 ha smesso di essere sufficiente da solo. Ha ancora senso quando serve un primo filtro gratuito su un tema semplice; ne ha molto meno quando in gioco ci sono la reputazione di un brand, la velocità di reazione o la comprensione di come l’intelligenza artificiale parla di noi. La domanda giusta non è più se usare Alerts, ma quale combinazione di motori AI, agenti e supervisione umana meriti la nostra attenzione, che resta la risorsa più limitata di tutte.