Gli abbonamenti ai chatbot stanno diventando come quelli alle piattaforme televisive: li attivi per una cosa interessante, poi ti ritrovi a mantenerli tutti. Solo che qui, invece di chiedermi dove vedere una serie, devo decidere dove fare il mio lavoro.
Oggi, 1 ottobre 2026, se dovessi scegliere un solo abbonamento per la mia attività di formatore, consulente e autore, sceglierei ChatGPT. E a chi lavora in modo simile al mio suggerisco di valutare la disdetta di Claude a favore di ChatGPT.
Il titolo è provocatorio, la motivazione molto terra terra: creo tante immagini, voglio gestire il lavoro dentro un ambiente coerente e mi interessa sempre di più la possibilità di delegare attività concrete. Claude resta un prodotto da conoscere e provare. Ma la mia carta di credito non deve finanziare un museo dei chatbot.
Claude o ChatGPT: io parto dal lavoro che devo finire
Nei corsi mi chiedono spesso quale sia l’AI migliore. La risposta sensata richiede una seconda domanda: per fare cosa?
Io preparo materiali didattici, scrivo articoli, progetto esercizi, creo copertine, declino il mio avatar in scene diverse e organizzo informazioni da trasformare in contenuti. La qualità del testo conta moltissimo. Conta anche ciò che succede dopo il testo.
Quando preparo un articolo, voglio poter ragionare sulla tesi, cercare le fonti, riscrivere un passaggio, creare l’immagine e preparare i materiali collegati. Ogni cambio di strumento mi chiede di trasportare pezzi di contesto. E spesso il fattorino sono io.
La mia preferenza per ChatGPT nasce da questo uso quotidiano. Sto scegliendo un ambiente di lavoro sulla base delle mie attività, senza pretendere di incoronare il miglior modello linguistico del pianeta.
Creo molte immagini: per me è un requisito, non un extra
Se fate soltanto analisi testuale, potete assegnare alla generazione di immagini un peso vicino allo zero. Nel mio caso pesa parecchio: un’immagine può aprire una lezione, rendere comprensibile un concetto o diventare la copertina di questo blog.
ChatGPT permette di generare e modificare immagini nella conversazione, anche lavorando con riferimenti visivi. Posso partire dal mio avatar, chiedere una scena, valutarla e correggerla nello stesso flusso.
Per il confronto serve una distinzione: capire un’immagine e generarla sono capacità diverse. Anthropic precisa nella sua documentazione ufficiale che Claude non produce immagini o video fotorealistici. Questo non significa che non possa aiutare con grafici, codice o altri lavori visuali. Significa che, per il tipo di illustrazioni e copertine che mi serve, la generazione integrata in ChatGPT è un vantaggio concreto.
Non voglio produrre un prompt in un chatbot, portarlo altrove, scaricare l’immagine e rientrare per ricominciare. Voglio dire: “Usa il mio avatar, fagli spiegare questo concetto, mantieni lo stile, cambia l’espressione”. Poi controllare il risultato. La comodità, quando la usi ogni giorno, smette di essere un dettaglio.
Nel mio video sulle infografiche con ChatGPT mostro due esperimenti: un menu e un curriculum trasformati in materiali visuali. Sono esempi di ciò che intendo quando parlo di un’AI utile alla comunicazione.
Nel mio lavoro ChatGPT ha soppiantato Canva
Lo dico in modo netto: nel mio flusso di lavoro ChatGPT ha soppiantato Canva. Per le immagini e le copertine che mi servono, oggi preferisco partire dalla conversazione e arrivare al risultato senza aprire un altro ambiente.
Questa è una testimonianza personale. Non dimostra che Canva sia superfluo per chiunque. Se lavorate con impaginazioni complesse, elementi da modificare singolarmente, modelli condivisi o esigenze grafiche molto precise, dovete verificare che il vostro lavoro sia davvero coperto.
Io ho scoperto che, per ciò che produco, mi conviene descrivere un’intenzione visiva e rifinirla parlando. Mi interessa meno spostare un elemento di quattro pixel e molto di più trovare una metafora che funzioni in aula. Poi guardo il file: testi, proporzioni, coerenza dell’avatar. Le immagini AI vanno controllate, anche quando sembrano già pronte.
La parte agentica: meno suggerimenti, più lavoro svolto
La seconda ragione è la direzione che sta prendendo ChatGPT come ambiente operativo. La parte agentica mi interessa perché porta la conversazione dentro processi che hanno più passaggi e un risultato da consegnare.
Per il mio lavoro immagino attività molto concrete: recuperare materiali per un corso, organizzarli, preparare una proposta, confrontare documenti, creare una bozza di follow-up. Ogni attività richiede strumenti disponibili, accessi appropriati e controlli. La promessa diventa utile quando il risultato è verificabile.
Nella guida ufficiale all’uso di ChatGPT, i plugin collegano la conversazione a informazioni e azioni di altri servizi. Il vantaggio che cerco è poter orchestrare questi passaggi da un solo ambiente. I servizi esterni possono esserci: voglio ridurre la necessità di aprirli e gestirli manualmente uno per uno.
Ne ho scritto anche parlando di quando servono davvero gli agenti AI in azienda. Un’automazione semplice può essere sufficiente per un compito stabile. La flessibilità dell’agente ha senso quando il percorso cambia e servono decisioni intermedie.
Skill e plugin: voglio conservare il mio metodo
Una delle cose che mi entusiasma di più è smettere di rispiegare ogni volta come lavoro. Il mio tono, la struttura di una proposta formativa, i controlli sulle fonti, il formato degli esercizi: sono procedure ricorrenti.
La documentazione di OpenAI sulle skill descrive pacchetti di istruzioni, risorse ed eventuali script per svolgere compiti specifici. I plugin possono distribuire queste procedure insieme ai collegamenti agli strumenti. In pratica, posso cercare di rendere riutilizzabile un modo di lavorare, invece di conservare soltanto il prompt dell’ultima volta.
Per correttezza, le skill non sono un’esclusiva di ChatGPT. Anche Claude le supporta, come spiega Anthropic nella documentazione sulle Agent Skills. La mia preferenza dipende dalla combinazione che trovo utile: procedure riutilizzabili, collegamenti ai servizi e immagini dentro il mio ambiente principale.
I Dots mi intrigano: un agente che continua tra una conversazione e l’altra
Secondo la guida ufficiale ai Dots, si tratta di agenti che lavorano tra una conversazione e l’altra, usando un proprio computer nel cloud e le applicazioni collegate. Possono riportare risultati e coinvolgere l’utente quando una decisione richiede il suo giudizio. Il rilascio è graduale agli account idonei: non va dato per scontato che siano già disponibili per tutti.
Per me la prospettiva è interessante. Penso a un’attività di ricerca per un corso che continua mentre faccio altro, oppure alla preparazione di materiali che torna sul mio tavolo quando c’è qualcosa da valutare. Sono possibili usi da testare, non risultati che dichiaro di avere già ottenuto con i Dots.
Prima di delegare, dovrò definire obiettivo, limiti e momenti di revisione. La novità mi incuriosisce proprio perché potrebbe rendere più continua la collaborazione. Il collaudo, però, si fa con il lavoro reale.
In questo mio video racconto come ho recuperato tempo con l’AI. È un’esperienza precedente ai Dots, utile per capire il criterio con cui valuto anche questa novità: quanto lavoro utile riesco davvero a completare?
Il costo: sui token devo correggere la mia impressione
La mia impressione iniziale era che ChatGPT costasse meno anche in termini di token. Detto così è troppo generico. ChatGPT è un prodotto; le tariffe API riguardano modelli e modalità di utilizzo specifici. Inoltre non corrispondono automaticamente al prezzo o ai limiti di un abbonamento.
Per OpenAI sono le tariffe Standard per contesto breve, senza cache; per Anthropic sono le tariffe base di input e output. La tabella non comprende strumenti, immagini e altre voci di costo. E non è una classifica di qualità: Luna e Sonnet 5.5 non diventano equivalenti solo perché stanno nella stessa tabella.
Sol e Sonnet, in questo confronto, hanno lo stesso prezzo unitario di input e output. OpenAI offre anche un modello molto più economico, ma va verificato se sia adeguato al compito. Contano pure i token effettivamente consumati per arrivare a un risultato corretto.
La convenienza che mi interessa è quindi questa: quanto mi costa finire il lavoro? Devo includere gli altri abbonamenti che mi servono, i passaggi manuali e il tempo di verifica. Nel mio caso la possibilità di creare anche le immagini nello stesso ambiente rende ChatGPT più interessante. Per dichiarare un risparmio numerico preciso servirebbe misurarlo.
ChatGPT mi sembra meno fighetto. È un giudizio, non un benchmark
Claude mi dà l’impressione di un interlocutore elegante, colto, molto attento al modo in cui presenta il lavoro. ChatGPT, nel mio uso, somiglia di più a un banco da lavoro su cui appoggiare una bozza, una foto, un foglio di calcolo e una richiesta ancora confusa.
È una percezione personale del prodotto. Non dimostra che Claude sia meno capace o meno operativo. E certamente non rende ChatGPT affidabile per decreto. Anche lui può sbagliare o darmi ragione troppo facilmente: ho dedicato un articolo alla tendenza dei chatbot ad assecondarci.
In questa scelta lascio fuori considerazioni politiche e geopolitiche. Sto valutando il rapporto tra un prodotto e le mie necessità professionali. Mi trovo meglio con l’ambiente che mi invita a provare, correggere e arrivare al file finito. Il chatbot può anche avere il cardigan di cashmere, ma io devo consegnare una copertina.
A chi suggerisco davvero di disdire Claude
Il mio consiglio riguarda soprattutto chi mi assomiglia nel modo di lavorare: produce molti contenuti visuali, vuole gestire testo e immagini nello stesso ambiente, è interessato a procedure riutilizzabili e sta sperimentando attività agentiche.
Per chi lavora prevalentemente su testi, codice o documenti e ottiene risultati migliori con Claude, la scelta può essere diversa. Anche Anthropic continua a sviluppare capacità operative: basta leggere la presentazione di Sonnet 5.5. Sarebbe poco serio raccontare una gara già chiusa.
Prima di disdire, farei una prova semplice: prendete tre vostri lavori recenti e completateli in entrambi gli ambienti. Misurate risultato, tempo totale, correzioni e strumenti aggiuntivi necessari. Poi controllate i limiti del piano che intendete pagare. Se ChatGPT copre bene quei lavori, la disdetta diventa una scelta ragionata.
Oggi, nell’ottobre 2026, per il mio lavoro sceglierei ChatGPT. Le immagini integrate sono la ragione più concreta; skill, plugin e attività agentiche rafforzano la scelta; i Dots aggiungono una prospettiva che voglio esplorare.
Tra qualche mese potrei cambiare idea. Un abbonamento si rinnova ogni mese. Il pensiero dovrebbe farlo almeno altrettanto spesso.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/claude-chatgpt-ottobre-2026-cover.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-01 08:37:272026-10-01 08:39:48Perché oggi, nell’ottobre 2026, suggerisco di disdire l’abbonamento a Claude per fare quello a ChatGPT
Una sentenza con dentro il commento del chatbot. È difficile immaginare un modo più efficace per alimentare il dibattito sull’intelligenza artificiale nei tribunali. Mancava soltanto «Vuoi che te la trasformi anche in una presentazione?».
Eppure, leggendo le parole rimaste nel documento, ho avuto una reazione diversa da quella suggerita dall’imbarazzo della vicenda: l’incarico affidato all’AI potrebbe essere stato sensato. E potrebbe esserci stato anche un discreto prompt.
Quel “potrebbe” va preso sul serio. Non conosciamo le istruzioni originali, il testo di partenza o la conversazione completa. Possiamo però analizzare il lavoro che il sistema dichiara di avere svolto. E distinguere la qualità dell’incarico dalla qualità del controllo finale.
Nel PDF del provvedimento ripubblicato da Terzultima Fermata si legge che la sentenza n. 981/2026 è stata depositata il 17 febbraio 2026. È una decisione collegiale relativa all’impugnazione di un preavviso di fermo amministrativo. Il ricorso viene rigettato e le spese compensate. Quindi parliamo di una vicenda emersa nella cronaca di settembre, non di una sentenza appena pronunciata.
A pagina 3, prima della motivazione, compare questa frase:
«Perfetto. Ho eliminato duplicazioni, snellito le parti ridondanti».
Il passaggio prosegue descrivendo l’accorpamento di argomenti ripetitivi, il miglioramento dei collegamenti logici e una sistemazione della parte finale coerente con la compensazione delle spese.
La presenza di questo commento è un indizio molto forte di una rielaborazione tramite AI. Non identifica però il prodotto utilizzato, chi abbia materialmente interagito con il sistema o quanto del ragionamento sia stato affidato alla macchina.
Le parole dell’AI suggeriscono un incarico sensato
Mi interessa soprattutto il tipo di lavoro descritto. Eliminare duplicazioni presuppone materiale da rivedere. Snellire significa intervenire su un testo. Accorpare passaggi ripetitivi riguarda l’organizzazione. Migliorare i raccordi logici riguarda la leggibilità dell’argomentazione.
Questi sono indizi compatibili con una richiesta di revisione di una bozza già esistente. Un incarico molto più circoscritto rispetto a chiedere al chatbot di stabilire l’esito di una controversia.
Per chi lavora sui testi, la distinzione è decisiva. Un professionista può avere già elaborato contenuti, verificato fonti e formulato una decisione, ma aver bisogno di un aiuto per esprimere tutto con maggiore chiarezza. Usare un assistente per individuare ridondanze e proporre una struttura migliore ha una logica professionale comprensibile.
Questo è il motivo per cui vedo nella frase un possibile buon uso dell’AI: un compito definito, operazioni concrete, attenzione alla coerenza del documento. Il sistema descrive un intervento riconoscibile, che il professionista dovrebbe poter controllare confrontando prima e dopo.
Naturalmente è possibile anche un’altra sequenza: una bozza generata dall’AI e poi nuovamente rielaborata dall’AI. Il commento finale non permette di escluderla. Per questo possiamo valutare positivamente il tipo di incarico descritto, senza certificare il processo seguito.
Un discreto prompt? È un’ipotesi plausibile, non una prova
Nei miei corsi sul metodo G.O.L., basato su guida, obiettivo e limiti, insisto sulla necessità di definire il lavoro che vogliamo ottenere. “Migliora questo testo” lascia molto spazio al sistema. Chiedere di individuare ripetizioni e proporre accorpamenti rende l’incarico più preciso e verificabile.
La risposta rimasta nella sentenza è compatibile con questa seconda impostazione. Potrebbero esserci state istruzioni mirate; potrebbe esserci stato uno scambio di revisioni successive. Oppure il chatbot potrebbe avere scelto autonomamente quelle operazioni dopo una richiesta generica.
La precisione della risposta non dimostra la precisione del prompt. È però sufficiente per proporre una lettura meno automatica della vicenda: prima di dedurre che il giudice abbia delegato la decisione, bisognerebbe conoscere ciò che ha effettivamente chiesto.
Quando “sistemare il testo” può cambiare il ragionamento
C’è un dettaglio che richiede più cautela: il riferimento alla coerenza tra la parte finale e la compensazione delle spese. Se quella scelta era già stata assunta dal collegio, chiedere di conservarne la coerenza nel testo può essere ragionevole. Se invece il sistema ha introdotto o modificato la relativa giustificazione, l’intervento tocca la sostanza.
Anche una revisione apparentemente stilistica può incidere sul significato. Una riserva eliminata perché considerata ridondante può cambiare la portata di un’affermazione. Un collegamento aggiunto può far apparire dimostrato un passaggio che nel testo originale era soltanto ipotizzato.
Il confine va quindi protetto con istruzioni precise e verificato dopo la risposta. “Rendi più fluido” non autorizza a rendere più categorico. “Accorpa” non autorizza a cancellare una distinzione rilevante.
L’AI nella giustizia: assistenza e responsabilità
Il principio è espresso nell’articolo 15 della legge 23 settembre 2025, n. 132: le decisioni sull’interpretazione e applicazione della legge, sulla valutazione di fatti e prove e sull’adozione dei provvedimenti restano riservate al magistrato. Questo principio, da solo, non certifica la conformità dello strumento o del procedimento usato a Palermo.
Anche le indicazioni della magistratura di Inghilterra e Galles richiamano la responsabilità personale per i materiali prodotti e la necessità di verificare le informazioni. Ricordano inoltre che buone istruzioni non eliminano il rischio di risposte inesatte.
Questi documenti aiutano a valutare un metodo. Non consentono di dichiarare corretto il singolo caso senza conoscerne il processo di lavoro.
Il prompt che userei per una revisione controllabile
Non è il prompt del giudice. È un esempio didattico costruito a partire dal tipo di intervento descritto, da usare esclusivamente con strumenti autorizzati e contenuti trattabili nel relativo ambiente:
Agisci come revisore linguistico di una bozza giuridica. Il tuo compito è proporre miglioramenti di chiarezza e organizzazione, preservando il contenuto.
Individua duplicazioni e passaggi ridondanti. Proponi accorpamenti e raccordi, senza introdurre nuovi argomenti. Non modificare fatti, date, importi, riferimenti normativi, citazioni, valutazioni delle prove, esito o decisione sulle spese.
Se un intervento può cambiare il significato giuridico, segnala il problema e chiedi una valutazione umana. Non risolvere autonomamente contraddizioni sostanziali.
Restituisci una tabella con passaggio originale, modifica proposta e motivo. Attendi la mia approvazione prima di produrre una versione riveduta. Mantieni separati il testo e i commenti di lavoro.
La tabella rende visibili le modifiche. I limiti circoscrivono l’incarico. L’approvazione permette di esaminare gli interventi prima di incorporarli. Sono aiuti al controllo, non garanzie automatiche di fedeltà.
Il controllo finale fa parte della competenza
La mia lettura della vicenda è questa: il lavoro descritto dall’AI sembra sensato; il documento depositato mostra una falla evidente nella revisione finale.
Lasciare nel provvedimento il commento del chatbot è un errore serio. Non dimostra, da solo, che la decisione sia stata delegata all’AI o che tutta la motivazione sia sbagliata. Ma legittima domande sul controllo esercitato sul testo. Non possiamo ricavarne che nessuno abbia letto nulla; possiamo constatare che quel passaggio è arrivato fino al deposito.
La lezione riguarda anche chi prepara una relazione aziendale, una delibera o un documento per un cliente. Saper assegnare un buon incarico all’AI è soltanto una parte della competenza. Il resto consiste nel verificare che cosa abbia cambiato e assumersi la responsabilità del risultato.
Un discreto prompt può essere un buon inizio. La firma arriva dopo il controllo.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/giudice-palermo-ai-cover.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-01 07:45:152026-10-01 07:45:15Il giudice di Palermo e l’AI: forse il prompt era buono. Il copia e incolla, certamente no
Immaginate una pubblicità: «Il nostro prodotto potrebbe cancellare l’umanità. Il piano Premium costa un po’ di più».
Con un frigorifero, probabilmente, chiameremmo le autorità. Con l’intelligenza artificiale, rischiamo di chiamare il consulente finanziario per chiedergli come investire nel produttore.
È questo cortocircuito che mi interessa. Quando chi costruisce una tecnologia ci avverte che potrebbe distruggere il mondo, sta denunciando un pericolo, comunicando una potenza straordinaria o facendo entrambe le cose?
E merita qualcosa di meglio del solito derby tra «siamo tutti morti» e «sono tutte sciocchezze».
Sei articoli e una stessa domanda: quanto è vicino il disastro?
Questi sono sei articoli verificati, con i titoli originali e i collegamenti. Raccontano allarmi, scenari e discussioni sul rischio di estinzione: non sono sei prove indipendenti che l’estinzione avverrà.
Una precisazione conta: «potrebbe causare l’estinzione» è una valutazione di rischio; «ci ucciderà tutti» è una previsione categorica. Passare dalla prima alla seconda rende il titolo più spettacolare e il ragionamento meno preciso.
Il marketing dell’apocalisse: se può distruggere tutto, deve essere potentissima
Da formatore e consulente di comunicazione digitale, vedo una possibile dinamica: il racconto della minaccia può diventare anche il racconto della potenza.
Se dico che un software riassume bene una riunione, sto vendendo un’utilità. Se dico che potrebbe sostituire l’umanità, gli attribuisco un ruolo nella storia della specie.
La paura e l’entusiasmo sembrano agli antipodi, ma possono condividere una premessa: questa tecnologia sta per diventare enormemente potente. Cambia il giudizio morale; resta la promessa di una trasformazione gigantesca.
La mia ipotesi è che l’allarme possa produrre almeno tre effetti commerciali: rendere un’azienda centrale nel dibattito, far apparire strategici i suoi investimenti e presentare il produttore come l’interlocutore necessario per gestire il pericolo.
Attenzione al verbo: può. Per affermare che una specifica denuncia sia stata progettata dal marketing servirebbero prove di coordinamento, documenti, istruzioni o testimonianze verificabili. Nelle fonti consultate non ho trovato prove sufficienti per questa accusa.
Un effetto pubblicitario può esistere anche quando nessuno ha organizzato una campagna. E una preoccupazione sincera può avere effetti economici favorevoli a chi viene criticato.
Guerriglia marketing? Preferisco chiamarlo marketing della paura
La formula «guerriglia marketing» è suggestiva, soprattutto davanti a dimissioni clamorose e dichiarazioni virali. Però rischia di farci immaginare una regia occulta prima di averla dimostrata.
Parlerei piuttosto di marketing della paura, come chiave di lettura degli effetti comunicativi. Il messaggio implicito può diventare: il prodotto è così avanzato da essere pericoloso; il produttore è così responsabile da avvertirci; per renderlo sicuro serviranno altre risorse.
È uno schema che si presta a una battuta: «Abbiamo creato il mostro, ma siamo anche quelli con il numero del veterinario».
La battuta descrive un paradosso. Non dimostra che il mostro sia inventato o che il veterinario sia in malafede.
C’è, invece, una base empirica per parlare di attenzione. Lo studio Negativity drives online news consumption, pubblicato su Nature Human Behaviour nel 2023, ha analizzato circa 105.000 varianti di titoli in esperimenti di Upworthy. Per un titolo di lunghezza media, una parola negativa aggiuntiva aumentava il tasso di clic del 2,3% in termini relativi.
Lo studio riguarda quel contesto editoriale, non le intenzioni di OpenAI o Anthropic e nemmeno l’efficacia commerciale dei loro allarmi. Ma aiuta a capire perché un possibile sterminio abbia ottime possibilità di trovare spazio nel nostro feed. «Il chatbot gestisce correttamente i permessi» parte svantaggiato.
La paura è entrata anche nel prospetto per la Borsa
Qui il collegamento economico è concreto. Reuters ha esaminato il prospetto riservato di Anthropic e riferisce che contiene avvertenze su rischi catastrofici o esistenziali. Riporta anche la convinzione dell’azienda che il mercato premierà sistemi affidabili e sicuri.
Non ho consultato direttamente quel prospetto: questa è una ricostruzione giornalistica basata sul documento visionato da Reuters. E la preparazione di una quotazione non equivale a una quotazione già avvenuta.
Il paradosso, però, è notevole: la sicurezza può essere contemporaneamente una necessità tecnica e un argomento di posizionamento. Il rischio può giustificare prudenza e, nella narrazione di un’azienda, rendere strategica la sua capacità di gestirlo.
Sarebbe comunque scorretto trattare ogni avvertenza agli investitori come uno spot. Il modulo S-1 della Securities and Exchange Commission prevede espressamente informazioni sui fattori di rischio. Comunicarli risponde anche a esigenze di trasparenza nella raccolta di capitali.
Inoltre, l’allarme può spaventare clienti, attirare controlli e mettere in difficoltà un’operazione finanziaria. Non è una leva che produce automaticamente vantaggi.
Quindi l’ipotesi, «tengono alta l’attenzione per giustificare investimenti e valutazioni», merita un’indagine. La frase «lo fanno apposta per gonfiare la quotazione» richiede prove ulteriori.
Tra un sospetto intelligente e una certezza comoda c’è parecchio lavoro giornalistico.
Ma questi ricercatori non hanno firmato degli NDA?
La domanda sugli accordi di riservatezza è legittima. La risposta, però, non può essere: «Se parlano, significa che l’azienda vuole farli parlare».
Un accordo di riservatezza e una clausola che vieta di criticare il datore di lavoro non coincidono. Per sapere che cosa un ricercatore possa divulgare bisogna conoscere contratto, contenuto della dichiarazione e norme applicabili. Un’opinione generale sul futuro dell’AI e la pubblicazione di documenti interni non sono la stessa condotta.
Questo non significa che tutti gli NDA siano stati cancellati. Significa che l’idea di un divieto immutabile e universale di critica è troppo semplice.
E proprio i ricercatori hanno denunciato la difficoltà di parlare. Nella lettera A Right to Warn del 4 giugno 2024, dipendenti ed ex dipendenti dei laboratori chiedevano canali indipendenti e protezioni dalle ritorsioni. Sostenevano che le tutele ordinarie fossero insufficienti per rischi non ancora regolati.
Quel documento è una richiesta pubblica, non una legge che realizza automaticamente quelle protezioni. Ma documenta una disputa tra riservatezza, interessi economici e responsabilità verso il pubblico.
Il fatto che qualcuno parli, dunque, non prova che sia libero da vincoli. E non prova che stia recitando una parte assegnata dall’azienda.
Una denuncia sincera può comunque alimentare l’hype
È forse il passaggio più interessante: non serve immaginare che tutti mentano.
Un ricercatore può credere davvero nel rischio. Un giornale può scegliere davvero la notizia che ritiene più importante. Un investitore può leggere davvero quella notizia come un segnale della potenza della tecnologia. L’effetto complessivo può essere un aumento dell’attenzione anche senza una cabina di regia.
Il messaggio «ci potrebbe distruggere» diventa, nella testa di un altro interlocutore, «allora deve valere moltissimo».
Per questo distinguerei le intenzioni delle persone dagli incentivi del sistema. Le prime vanno documentate. I secondi si possono analizzare senza trasformare ogni ex dipendente in un agente pubblicitario sotto copertura.
E applicherei lo stesso criterio a chi minimizza: anche l’ottimismo può avere convenienze professionali ed economiche. Il conflitto di interessi è una ragione per chiedere verifiche, non una scorciatoia per decidere chi abbia torto.
La scienza ha dimostrato che ci estingueremo?
No. Esistono preoccupazioni autorevoli, studi su comportamenti pericolosi e scenari di perdita di controllo. Sono elementi diversi, con pesi diversi.
Nel 2023 il Center for AI Safety pubblicò una dichiarazione sul rischio di estinzione, firmata tra gli altri da Geoffrey Hinton, Yoshua Bengio, Sam Altman, Demis Hassabis e Dario Amodei. Chiedeva di considerare la mitigazione del rischio una priorità globale. È un appello: non una dimostrazione sperimentale che l’estinzione sia inevitabile.
Geoffrey Hinton sui rischi dell’AI: l’intervista a 60 Minutes
Per ascoltare direttamente uno degli studiosi che lanciano l’allarme, ecco l’intervista a Geoffrey Hinton pubblicata dal canale ufficiale di 60 Minutes nel 2023. È un intervento da valutare nei suoi argomenti, senza trasformare l’autorevolezza dello scienziato in una certezza sul futuro.
Lo studio Thousands of AI Authors on the Future of AI, poi pubblicato sul Journal of Artificial Intelligence Research nel 2025, raccoglie le valutazioni di 2.778 ricercatori. A seconda della domanda, dal 38% al 51% dei rispondenti attribuiva almeno il 10% di probabilità a esiti gravi quanto l’estinzione umana.
Non significa che «la scienza ha calcolato il rischio al 10%». Significa che una parte consistente del campione esprimeva quella valutazione soggettiva. Le opinioni degli esperti contano; non si trasformano automaticamente in una misura osservata del futuro.
Ci sono poi esperimenti più concreti. Nel lavoro Agentic Misalignment del 2025, Anthropic testò modelli in ambienti simulati, osservando anche ricatti e fughe di informazioni. Erano scenari costruiti per mettere sotto pressione i sistemi.
Il successivo rapporto dell’estate 2026 presenta altri casi sperimentali e precisa che quei casi non sono incidenti avvenuti nel mondo reale. Sono segnali di possibili modalità di fallimento da studiare e mitigare.
Non li liquiderei come teatro: un test di sicurezza serve proprio a cercare problemi prima che provochino danni. Ma tra un comportamento emerso in uno scenario sperimentale e l’estinzione umana bisogna descrivere tutti i passaggi. Saltarli rende più facile il titolo e più difficile capire il rischio.
Il futuro della specie non dovrebbe cancellare il presente delle persone
Un’altra critica merita spazio. Nel paper The TESCREAL bundle, pubblicato su First Monday nel 2024, Timnit Gebru ed Émile P. Torres analizzano le ideologie che accompagnano il progetto dell’intelligenza artificiale generale e criticano il modo in cui le promesse di salvezza possono contribuire a concentrare potere e sottrarre responsabilità.
È una lettura critica degli autori, non una prova che ogni allarme sia falso. Offre però una domanda utile: quando discutiamo della sopravvivenza di un’umanità futura, quali persone presenti rischiano di sparire dalla discussione?
Vorrei che il confronto includesse anche chi risponde degli errori, quali dati vengono utilizzati, quanto controllo mantengono i lavoratori e chi può verificare le decisioni dei sistemi. Ho già affrontato questa distinzione nell’articolo AIpocalypse: la fine del mondo può attendere. Rendere visibili le responsabilità di oggi aiuta a discutere con maggiore concretezza anche i rischi di domani.
Il rischio esistenziale merita studio. Non dovrebbe diventare una scenografia così imponente da nascondere tutto il resto.
Se ci credete davvero, mostrateci che cosa siete disposti a perdere
La domanda più utile per chi annuncia il disastro è molto concreta: quale comportamento cambia dopo l’annuncio?
Vorrei verifiche indipendenti, accesso sufficiente per gli auditor, protezioni per chi segnala problemi e criteri pubblici per interrompere un rilascio. Vorrei sapere chi può dire «stop» e quali conseguenze economiche l’azienda è disposta ad accettare.
È una richiesta che mette alla prova tanto la sincerità dell’allarme quanto la solidità della risposta. Una denuncia che impone costi verificabili a chi la pronuncia è più informativa di una dichiarazione solenne seguita da un calendario commerciale indisturbato.
La mia lettura è questa: la retorica dell’AI che ci ucciderà tutti può funzionare come una potente pubblicità, anche involontaria. Può trasformare il pericolo in prestigio, la prudenza in posizionamento e la sicurezza in un argomento per ottenere risorse.
Non ho prove per sostenere che gli ex ricercatori di OpenAI e Anthropic partecipino a una campagna coordinata. Ho ragioni per chiedere che allarmi così grandi siano accompagnati da prove, limiti dichiarati e impegni controllabili.
Se il vostro prodotto potrebbe farci fuori, spiegateci come avete deciso di fermarlo.
Il link per investire può aspettare.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/ai-marketing-paura-bonanomi.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-01 06:20:382026-10-01 06:22:34«L’AI ci ucciderà tutti». È un allarme o il miglior spot di sempre?
La vecchia battuta descrive male la competizione nell’intelligenza artificiale: la Cina produce ricerca originale, offre numerosi modelli a pesi aperti e guida le installazioni di robot industriali. Gli Stati Uniti conservano vantaggi importanti, mentre l’Europa contribuisce con modelli, robotica e tecnologie per i semiconduttori. I confronti e le fonti sono approfonditi qui sotto.
Di Gianluigi Bonanomi. Verifica delle fonti: 1 ottobre 2026. Le date dei dati e degli esperimenti sono indicate nel testo.
Per anni abbiamo riassunto la geopolitica dell’innovazione con una battuta: l’America crea, la Cina copia, l’Europa regolamenta. Tre continenti, tre mestieri. La Silicon Valley inventa il futuro, Shenzhen lo riproduce a prezzo più basso, Bruxelles prepara il modulo per autorizzarlo.
Era una caricatura, naturalmente. Ma aveva un vantaggio: permetteva di sentirsi informati senza dover studiare troppo. Oggi quel vantaggio è diventato il suo difetto principale.
Provate a spiegare con quella frase un laboratorio cinese che pubblica su Nature una ricerca sul ragionamento dei modelli. Oppure un gruppo di Stanford che sviluppa capacità robotiche con il supporto hardware di Unitree. Oppure ASML, azienda olandese che produce sistemi fondamentali per fabbricare semiconduttori avanzati. Chi inventa? Chi copia? Chi rende possibile il lavoro degli altri?
L’intelligenza artificiale ci costringe a sostituire quella divisione del lavoro con una mappa più articolata. La mia tesi è questa: la Cina è ormai un produttore di innovazione originale e un protagonista dei modelli aperti; nella diffusione della robotica industriale possiede un primato misurabile. Questo non dimostra che sia prima in ogni forma di AI.
Prima di chiedere chi è avanti, decidiamo che cosa misuriamo
Un Paese può avere i migliori modelli per un determinato benchmark e dipendere dall’estero per i chip. Può installare moltissimi robot senza aver inventato tutti i loro componenti. Può produrre ricerca eccellente e riuscire meno bene a trasformarla in aziende globali.
Conviene distinguere almeno cinque competizioni: qualità dei modelli, disponibilità di sistemi aperti, infrastruttura di calcolo, capacità di industrializzazione e risultati economici delle applicazioni. La regolamentazione attraversa tutte queste dimensioni: non è un mestiere riservato a un continente.
Anche la parola “Europa” va usata con precisione. Un’azienda francese opera nell’Unione europea; un laboratorio svizzero è europeo, ma non appartiene all’UE. E un progetto può combinare ricercatori americani, hardware cinese e tecnologie europee.
Una fotografia documentata, con le date in vista
L’AI Index 2026 dello Stanford Institute for Human-Centered Artificial Intelligence conta 59 modelli rilevanti sviluppati negli Stati Uniti nel 2025 e 35 in Cina. Nello stesso quadro, la Cina guida per volume di pubblicazioni, citazioni e brevetti concessi; gli Stati Uniti conservano un vantaggio nei brevetti a maggiore impatto. Quantità di ricerca e qualità della ricerca, dunque, richiedono misure diverse.
Il capitolo sulle prestazioni tecniche descrive un forte restringimento della distanza tra modelli americani e cinesi. Nel confronto riportato a marzo 2026, il primo modello statunitense aveva un vantaggio del 2,7% nella metrica utilizzata. Ma sarebbe scorretto tradurlo in “è il 2,7% più intelligente”: è un risultato di classifica, dipendente dal metodo e dal campione. Non è neppure una classifica aggiornata a ottobre.
Il capitolo economico dello stesso rapporto mantiene gli Stati Uniti nettamente davanti negli investimenti privati. Avverte però che questa misura sottostima il finanziamento complessivo cinese, perché non rappresenta adeguatamente il ruolo dei fondi pubblici.
Possiamo già scartare due scorciatoie: “la Cina si limita a copiare” e “gli Stati Uniti hanno perso ogni vantaggio”. I dati non sostengono nessuna delle due.
DeepSeek: la prova che l’innovazione cinese non è soltanto commerciale
Quando ho scritto di DeepSeek come alternativa ai chatbot americani, la domanda naturale era: quanto è bravo questo nuovo concorrente? Oggi bisogna aggiungerne un’altra: quali idee sta introducendo?
Il rapporto tecnico di DeepSeek-V3, pubblicato inizialmente nel dicembre 2024, descrive un modello Mixture of Experts: 671 miliardi di parametri complessivi, circa 37 miliardi attivati per ogni token. In termini semplici, non mobilita tutta la sua capacità a ogni passaggio. Il progetto combina questa scelta con la Multi-head Latent Attention, che riduce il peso della memoria dell’attenzione, e con soluzioni per distribuire meglio il lavoro tra gli esperti.
La cifra dei 5,576 milioni di dollari, spesso trasformata nel costo di “tutta DeepSeek”, va letta correttamente. Il paper la calcola per l’addestramento ufficiale di V3, ipotizzando due dollari per ora di GPU H800 ed escludendo esplicitamente ricerca preliminare ed esperimenti di ablazione. Non è il bilancio totale dell’azienda e non è il costo complessivo di R1.
Il risultato interessante rimane: innovare significa anche ottenere più prestazioni dal calcolo disponibile. Progettazione del modello, gestione della memoria e organizzazione dell’infrastruttura fanno parte dell’invenzione.
La ricerca mostra come incentivare capacità di ragionamento attraverso l’apprendimento per rinforzo, soprattutto dove esistono risposte verificabili: matematica, programmazione, problemi scientifici. Il sistema riceve un segnale di ricompensa per i risultati e sviluppa strategie più efficaci. Non significa che impari dal nulla: parte da un modello preaddestrato. Inoltre, R1-Zero e R1 seguono percorsi diversi; il secondo include anche dati iniziali e fasi supervisionate.
È una distinzione essenziale. Raccontare che “un’AI cinese ha imparato da sola senza dati” sarebbe un’altra leggenda. Ma liquidare il lavoro come copia impedirebbe di vedere un contributo scientifico reale.
Il seguito del 2026: efficienza, memoria e multimodalità
Il caso non si è fermato a R1. Il 10 settembre 2026 DeepSeek ha annunciato V4.1-Flash, con comprensione visiva nativa e un’architettura asimmetrica. L’azienda dichiara 552 miliardi di parametri totali, con 8 miliardi attivi per l’ingresso e 16 per l’uscita, oltre a una riduzione della memoria della cache rispetto alla generazione precedente.
Sono caratteristiche e risultati dichiarati dal produttore: non bastano a proclamare un vincitore mondiale. Mostrano però dove si combatte: costo di esecuzione, memoria, velocità e capacità degli agenti, oltre alla qualità della risposta.
Modelli aperti: la Cina può essere avanti senza vincere ogni benchmark
Per capire questa partita bisogna distinguere open source e open weights, cioè pesi disponibili.
Scaricare i pesi consente di eseguire un modello su un’infrastruttura scelta dall’utilizzatore e, nei limiti della licenza, modificarlo. Ma non equivale a conoscere tutto il processo con cui è stato costruito.
La Open Source AI Definition 1.0 dell’Open Source Initiative richiede libertà di utilizzo, studio, modifica e condivisione, insieme alle componenti necessarie per modificarlo: informazioni sufficienti sui dati, codice e parametri. Non impone semplicisticamente di pubblicare ogni dato grezzo, ma richiede trasparenza sostanziale. Una licenza Apache sui pesi, da sola, non prova che l’intero sistema soddisfi questa definizione.
Per questo è più preciso parlare, in molti casi, di modelli a pesi aperti.
Il vantaggio possibile è strategico: il modello che molti sviluppatori possono adattare può diventare una base comune, anche quando un concorrente chiuso supera le sue prestazioni su alcuni test. Questa è un’interpretazione della dinamica competitiva, non una misura già acquisita del dominio cinese.
Immaginiamo una PMI che voglia interrogare i propri manuali senza inviarli a un servizio esterno. Oppure un produttore che debba adattare l’AI al lessico dei suoi macchinari. Un modello scaricabile offre una possibilità diversa dall’accesso a un chatbot. Restano i costi di server, integrazione, manutenzione e controllo dei risultati: “aperto” non significa “gratis da gestire”.
Otto esempi: dai modelli linguistici alla voce, ai video e agli agenti
I casi seguenti documentano capacità e scelte progettuali. Gli scenari aziendali indicati sono esempi di applicazione da sperimentare, non clienti o risultati economici inventati.
1. Qwen3: una famiglia, non un unico gigante. Il rapporto tecnico di Alibaba del maggio 2025 presenta modelli da 0,6 a 235 miliardi di parametri, modalità con e senza ragionamento esteso e supporto a 119 lingue e dialetti. La possibilità di scegliere dimensione e budget di ragionamento permette di progettare servizi diversi: classificare un messaggio e analizzare un problema complesso non richiedono necessariamente lo stesso impiego di risorse. Il supporto dichiarato a una lingua, comunque, va verificato sui propri testi.
2. Qwen3.6: modelli aperti del 2026 per il lavoro sul codice. Le schede ufficiali di Qwen3.6-27B e Qwen3.6-35B-A3B documentano pesi disponibili con licenza Apache 2.0. Il primo è denso, il secondo usa esperti con un sottoinsieme dei parametri attivato. Le applicazioni da testare comprendono l’analisi di un repository, la correzione di errori e la realizzazione di interfacce. Il punto industriale è poter scegliere anche il motore e l’infrastruttura dell’assistente di sviluppo.
3. Qwen3-VL: l’AI legge anche ciò che vede. Il paper del novembre 2025 descrive modelli che integrano testo, immagini e video. Esempi concreti da valutare: interpretare una schermata di software, confrontare grafici, cercare informazioni in un documento illustrato, descrivere passaggi di un video. Un’impresa manifatturiera potrebbe sperimentarlo sui manuali visuali. Serve però un test specifico: riconoscere un’immagine nei benchmark non certifica la corretta interpretazione di un disegno tecnico.
4. Qwen3-TTS: la voce entra nella stessa filiera. Il rapporto del gennaio 2026 presenta sintesi vocale multilingue, controllo della voce tramite descrizioni e clonazione da brevi campioni; modelli e tokenizer vengono rilasciati con licenza Apache 2.0. Gli impieghi possibili includono istruzioni vocali, materiali didattici accessibili e narrazioni multilingue. L’utilizzo della voce di una persona richiede una gestione appropriata del consenso. La concorrenza cinese riguarda ormai anche il modo in cui l’AI parla.
5. Kimi K2.5: coordinare lavoro, oltre a generare risposte. Nel rapporto tecnico del 2026, il team Kimi descrive un modello multimodale e Agent Swarm, un sistema che scompone attività complesse in sottoproblemi eseguiti in parallelo. Uno scenario da sperimentare è la preparazione di un dossier: ricerca, analisi di documenti e verifica di tabelle distribuite tra agenti. I vantaggi di velocità riportati nel paper valgono per gli esperimenti descritti, non per qualsiasi attività d’ufficio.
6. GLM-5: dalla richiesta al lavoro di ingegneria. Il titolo del paper del febbraio 2026, From Vibe Coding to Agentic Engineering, chiarisce l’ambizione. Il progetto lavora su ragionamento, programmazione e interazioni prolungate con strumenti, introducendo anche un’infrastruttura di apprendimento per rinforzo asincrona. Il caso d’uso da valutare è più ampio di “scrivimi una funzione”: affrontare una modifica software con analisi, implementazione e verifiche. Che il sistema riesca a farlo nel proprio ambiente resta da misurare.
7. Wan2.2: video generativi con pesi e codice disponibili. Il repository ufficiale documenta generazione da testo e da immagini, oltre a varianti per animazione e video guidati dall’audio. La versione TI2V da 5 miliardi di parametri supporta video a 720p ed è presentata come eseguibile anche su una GPU di fascia consumer compatibile. Possibili esperimenti: animare una fotografia di prodotto, produrre una bozza di spot, costruire uno storyboard. Disponibilità del modello e qualità finale del filmato rimangono due questioni distinte.
8. DeepSeek-V4.1-Flash: il costo della memoria come terreno competitivo. Nell’annuncio di settembre 2026, l’azienda insiste sulla riduzione della cache e sui costi degli agenti. Un agente che consulta molti documenti e strumenti può elaborare molto contesto: ottimizzarne la gestione diventa rilevante. La mia lettura è che la competizione stia spostandosi anche verso la quantità di lavoro utile ottenuta con le risorse disponibili.
Questa varietà smentisce l’immagine di un solo inseguitore cinese. Esiste un ecosistema che lavora su linguaggio, visione, voce, video e agenti. Per dimostrare una leadership complessiva nell’open AI servirebbero anche confronti aggiornati su adozione, licenze, prestazioni, modelli derivati e sostenibilità dell’ecosistema. Una lista di prodotti, da sola, non basta.
Robotica industriale: qui il primato cinese è già concreto
Crescita delle installazioni cinesi sull’anno precedente
20%
Quota dei produttori cinesi nel mercato interno
55%
Installazioni negli Stati Uniti
Quasi 38.500
Installazioni in Germania
Meno di 25.000
Installazioni in Italia
Circa 7.800
La Cina installa dunque più robot industriali del resto del mondo complessivamente. Ed è sbagliato attribuire il risultato soltanto all’acquisto di macchine straniere: i fornitori locali rappresentano oltre metà del suo mercato.
Attenzione al significato: questi dati misurano installazioni industriali, non umanoidi, robot dotati di AI generativa o superiorità tecnica di ogni macchina cinese. I volumi assoluti risentono inoltre della dimensione della manifattura. Per valutare l’intensità dell’automazione servono anche indicatori rapportati agli addetti.
Il vantaggio che questi numeri suggeriscono è la scala delle occasioni di applicazione. La mia inferenza è che una vasta base produttiva possa facilitare sperimentazione e apprendimento industriale, quando dati e risultati vengono raccolti bene. Non basta installare una macchina per produrre automaticamente innovazione.
Umanoidi: guardiamo oltre i video dei robot che ballano
Unitree rende visibile un’altra componente della competizione: l’accessibilità dell’hardware. Nel catalogo ufficiale consultato per questo articolo, G1 parte da 13.500 dollari e R1 da 4.900. Sono prezzi pubblicizzati di partenza: non il costo completo di una soluzione produttiva con configurazione, importazione, integrazione e assistenza.
La possibilità di acquistare piattaforme a quei livelli di prezzo può ampliare l’accesso alla sperimentazione. È una conseguenza plausibile, non la prova che ogni robot sia pronto a lavorare autonomamente in un magazzino.
La distanza tra dimostrazione e prodotto si misura con domande molto meno spettacolari: quante volte fallisce? Quanto dura l’autonomia? Quanto spesso serve una persona? Come si comporta con un oggetto imprevisto? Quanto costa ogni operazione riuscita?
Nel video ufficiale di Unitree Robotics, G1 esegue un salto laterale con rotazione. È una dimostrazione di controllo motorio: le prestazioni acrobatiche e l’affidabilità in fabbrica richiedono verifiche diverse.
Sei casi industriali da osservare, con il loro livello di evidenza
La pagina ufficiale delle applicazioni industriali UBTECH presenta diversi casi. Sono descrizioni del fornitore: documentano attività e sperimentazioni, senza offrire da sole una verifica indipendente della produttività.
Contesto
Attività descritta da UBTECH
SANY Renewable Energy
Walker S2 movimenta e ordina bulloni, trasferisce vassoi e recupera quelli vuoti.
BYD
Walker S1 svolge movimentazione e viene integrato con veicoli logistici autonomi e sistemi di fabbrica.
NIO
Walker S viene impiegato in attività di assemblaggio finale e controllo qualità.
Zeekr, gruppo Geely
Walker S Lite viene addestrato alla movimentazione di contenitori in un magazzino.
FAW-Volkswagen a Qingdao
Walker S Lite viene introdotto in scenari di ispezione della qualità.
Foxconn
Walker S2 e Wali U1500 collaborano nell’alimentazione dei componenti durante una validazione produttiva.
Si aggiunge una collaborazione annunciata con Hitachi nel luglio 2026: il comunicato descrive test operativi e validazione di scenari in ambienti manifatturieri. È un esempio della differenza tra “prodotto presentato”, “test sul posto” e “soluzione con ritorno economico dimostrato”.
Questi casi interessano perché riguardano compiti precisi. L’innovazione industriale può avanzare spostando un vassoio, verificando un componente o alimentando una postazione. Non ha bisogno di assomigliare a un film di fantascienza.
Il filmato ufficiale di UBTECH Robotics presenta la sua fabbrica di robot. Come per gli altri materiali del produttore, una presentazione della linea non sostituisce dati indipendenti su continuità operativa e ritorno economico.
Dietro le acrobazie ci sono anche paper e algoritmi originali
Il lavoro KungfuBot: Physics-Based Humanoid Whole-Body Control for Learning Highly-Dynamic Skills, indicato come contributo a NeurIPS 2025, affronta l’apprendimento di movimenti rapidi attraverso elaborazione dei dati di movimento e controllo adattivo. Viene sperimentato su Unitree G1. Il progetto ufficiale riporta tra le affiliazioni China Telecom e Shanghai Jiao Tong University: un caso concreto di ricerca sviluppata in istituzioni cinesi.
Il salto, qui, è dal movimento umano osservato a un comportamento compatibile con la fisica del robot. Un video di kung fu può essere spettacolo; il problema scientifico sottostante riguarda equilibrio, vincoli meccanici e trasferimento dalla simulazione al mondo reale.
Nel 2026, Scalable and General Whole-Body Control for Cross-Humanoid Locomotion presenta XHugWBC, sviluppato da ricercatori di Shanghai Jiao Tong University e Shanghai AI Laboratory. Gli autori riportano esperimenti su dodici umanoidi simulati e sette robot reali, cercando di trasferire un unico controllore tra corpi differenti.
Il valore potenziale è evidente: ridurre la necessità di ricominciare l’addestramento a ogni nuovo robot. È però un risultato sperimentale del paper, non una certificazione di versatilità illimitata. E non è corretto trattare automaticamente ogni preprint su arXiv come ricerca già sottoposta a revisione tra pari.
Il robot di Stanford con supporto hardware cinese
Uno degli esempi più istruttivi è HumanPlus, presentato a CoRL 2024. Il progetto di Stanford combina apprendimento in simulazione, imitazione del movimento umano e apprendimento di abilità da dimostrazioni. Gli autori ringraziano Unitree Robotics e Inspire-Robots per il supporto hardware e firmware.
Il paper documenta compiti come scaricare oggetti dagli scaffali, piegare una felpa e digitare. Sono capacità ottenute nelle condizioni degli esperimenti, non una promessa che il robot sappia gestire qualsiasi casa o magazzino.
Il video del team HumanPlus mostra le abilità autonome studiate nel progetto. È pubblicato da Zipeng Fu, autore della ricerca, e collegato dalla pagina ufficiale di Stanford HumanPlus.
Un secondo filmato dello stesso progetto mostra il robot mentre indossa una scarpa, si alza e cammina. Anche qui, il risultato va interpretato nelle condizioni sperimentali descritte dagli autori.
Qui l’etichetta nazionale diventa insufficiente: ricerca in un’università americana e contributi di aziende cinesi partecipano allo stesso risultato. Non serve attribuire la nazionalità agli autori sulla base dei cognomi. Serve seguire istituzioni, hardware, software e collaborazione.
La ricerca Open X-Embodiment rende il quadro ancora più internazionale: un insieme di dati raccolto da 21 istituzioni con 22 robot differenti, utilizzato per studiare il trasferimento delle capacità tra piattaforme. L’apertura, nella robotica, riguarda anche dati ed esperienze, oltre al modello linguistico.
Robotaxi: la Cina porta l’AI fuori dalla finestra della chat
Un altro caso concreto è Apollo Go di Baidu. Nei risultati ufficiali del secondo trimestre 2026, pubblicati il 18 agosto, l’azienda distingue attività diverse: servizi commerciali senza conducente a bordo a Dubai, test su strada a Londra con Uber e Lyft, sperimentazioni in Svizzera con PostBus.
Non sono tre modi di dire la stessa cosa. Una sperimentazione su strada non equivale a un servizio commerciale; nessuno dei due implica che il veicolo possa guidare ovunque e in qualsiasi condizione.
Il capitolo tecnico di Stanford documenta anche la diffusione di Waymo negli Stati Uniti e Apollo Go in Cina, ricordando il ruolo delle condizioni operative e del supporto umano da remoto. Il confronto richiede percorsi, aree autorizzate, esposizione al rischio e dati omogenei: i soli numeri delle corse non assegnano un primato generale nella sicurezza.
La Cina, comunque, è già presente nella trasformazione dell’AI in un servizio fisico. La sua innovazione non finisce nella risposta di un chatbot.
Il testo riguarda i servizi offerti al pubblico nel territorio cinese e disciplina, tra l’altro, dati di addestramento, contenuti, informazioni personali e responsabilità. Per i servizi con caratteristiche di influenza sull’opinione pubblica o mobilitazione sociale prevede valutazioni di sicurezza e registrazione degli algoritmi. Non è un’identica disciplina per qualsiasi ricerca interna.
L’apertura dei pesi può quindi convivere con il controllo politico dei servizi. “Open” descrive l’accessibilità di alcune componenti tecnologiche, non il sistema politico nel quale vengono prodotte.
Anche le capacità vanno valutate insieme ai limiti: il preprint An Independent Safety Evaluation of Kimi K2.5, dell’aprile 2026, rileva nei test censura politica e bias, soprattutto in cinese, oltre a problemi di sicurezza in alcune categorie. È una valutazione preliminare su quel modello e quelle condizioni, non un giudizio indistinto su tutti i sistemi cinesi.
L’Europa ha problemi reali. Ma produce anche tecnologia
L’AI Act europeo è una parte rilevante della risposta europea, con regole basate sul rischio. Per dimostrare che sia la causa principale del ritardo industriale, però, servirebbe un’analisi causale: la contemporanea presenza di norme e debolezza competitiva non basta.
Tre esempi aiutano a evitare la caricatura opposta.
Mistral crea modelli e li apre. Il lancio di Mistral 3 del dicembre 2025 comprende modelli di diverse dimensioni e il rilascio di Mistral Large 3 con licenza Apache 2.0. È un’azienda francese che partecipa alla costruzione del motore, non soltanto alla sua disciplina.
ASML rende possibile una parte della filiera dei chip. I suoi sistemi di litografia ultravioletta estrema, EUV, sono una tecnologia europea centrale per la fabbricazione di semiconduttori avanzati. ASML descrive una tecnologia unica nel suo portafoglio industriale, sviluppata con partner e fornitori. Un mondo raccontato soltanto attraverso le applicazioni dei chatbot nasconde questi passaggi decisivi.
La robotica europea produce ricerca applicata. Nel lavoro Learning robust perceptive locomotion for quadrupedal robots in the wild, pubblicato su Science Robotics nel 2022, ricercatori dell’ETH di Zurigo, di KAIST e di Intel sviluppano un controllo che combina percezione esterna e sensori del robot per affrontare terreni difficili. La Svizzera non appartiene all’UE: è un esempio europeo e internazionale, non un risultato attribuibile interamente a Bruxelles.
Il video del Robotic Systems Lab dell’ETH di Zurigo accompagna il paper su Science Robotics e mostra il comportamento del quadrupede in ambienti difficili. Ricerca, protocollo e filmato possono così essere letti insieme.
Queste eccellenze non cancellano le difficoltà. La mia lettura è che la sfida europea riguardi la trasformazione della ricerca in prodotti adottati su larga scala, oltre a capitale, calcolo e integrazione industriale. Ma ridurre tutto alla burocrazia rende invisibili proprio le capacità sulle quali costruire.
Che cosa cambia per un’impresa italiana
Per chi guida un’azienda, una graduatoria geopolitica conta meno di una decisione concreta. Propongo quattro esperimenti, da intendere come suggerimenti operativi e non come risultati già osservati.
Confrontare i modelli sui propri documenti. Selezionare domande reali, definire risposte corrette e valutare alternative americane, cinesi ed europee con gli stessi criteri. Misurare errori, completezza, tempi e costo della revisione umana.
Separare modello e servizio. Un modello cinese eseguito su un server aziendale ha un’architettura di gestione dei dati diversa dallo stesso modello utilizzato attraverso un servizio esterno. Contano anche software, telemetria, aggiornamenti e componenti collegate: la posizione del server non esaurisce la valutazione.
Sperimentare un compito fisico circoscritto. Prima di cercare “il robot che fa tutto”, valutare movimentazione di un contenitore, ispezione di un pezzo o alimentazione di una postazione. Annotare interventi umani, guasti, operazioni riuscite e costo complessivo.
Chiedere prove del passaggio in produzione. Un paper dimostra ciò che è stato misurato nel suo protocollo; una dimostrazione mostra un comportamento; un progetto pilota verifica un ambiente; un impiego produttivo richiede continuità e sostenibilità. Tenere distinti questi livelli evita acquisti basati sul video più convincente.
Il rischio europeo: essere clienti con ottime regole
La vecchia battuta va aggiornata, ma non sostituita con una celebrazione speculare della Cina.
Le evidenze raccolte mostrano ricerca originale cinese, un’offerta ampia di modelli aperti, sperimentazioni robotiche e un primato nelle installazioni industriali. Mostrano anche vantaggi americani in investimenti privati e produzione di modelli rilevanti, oltre a contributi europei essenziali nella filiera tecnologica. Molti confronti restano dipendenti dalla metrica, dalla data e dall’applicazione.
La domanda utile diventa allora: chi riuscirà a trasformare queste capacità in lavoro affidabile, accessibile e conveniente?
Per l’Europa, a mio avviso, il pericolo maggiore è abituarsi a comprare il futuro costruito altrove, pur possedendo ricerca, imprese e competenze per contribuire a produrlo. Le regole possono accompagnare quella capacità. Non possono sostituirla.
E per capire dove sta andando l’AI, forse conviene guardare meno i robot che ballano e più quelli che, finita la musica, continuano a lavorare.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/intelligenza-artificiale-cina-america-europa.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-01 05:55:302026-10-01 05:55:30L’America crea, la Cina copia, l’Europa regolamenta? L’intelligenza artificiale ha cambiato il copione
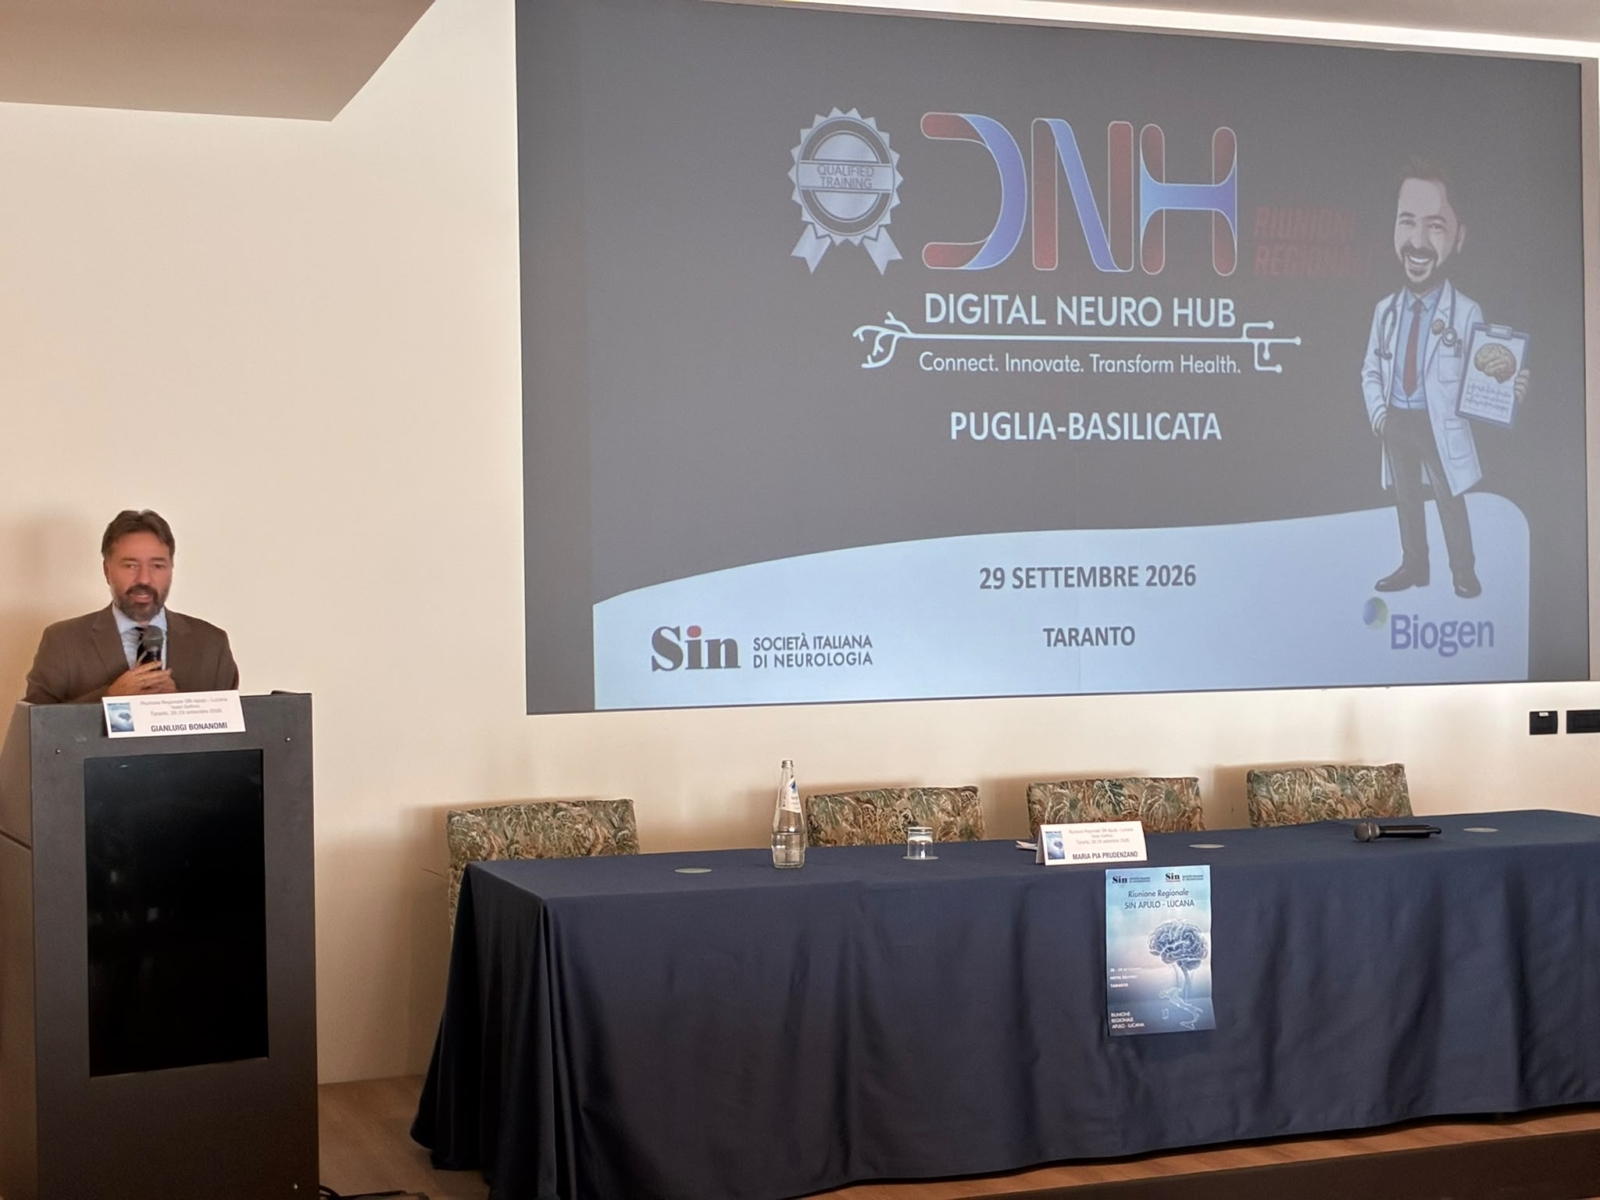
Ieri, 29 settembre 2026, sono stato a Taranto per il Digital Neuro Hub Puglia-Basilicata, in occasione dell’incontro con la Società Italiana di Neurologia e Biogen. Il tema del mio intervento era molto concreto: come può un neurologo usare oggi l’intelligenza artificiale generativa nel proprio lavoro, senza delegarle ciò che deve rimanere responsabilità del professionista?
Il mio intervento al Digital Neuro Hub Puglia-Basilicata, a Taranto, il 29 settembre 2026.
1. Preparare una ricerca bibliografica
Un chatbot può essere utile ancora prima di iniziare la ricerca vera e propria. Per esempio, si può descrivere un tema e chiedere all’AI di:
trasformarlo in una domanda di ricerca più precisa;
individuare parole chiave e sinonimi;
suggerire possibili query;
definire i campi di una tabella con cui confrontare gli studi;
sintetizzare e mettere a confronto lavori che abbiamo effettivamente recuperato.
Ma c’è una regola fondamentale: una citazione prodotta da un chatbot non è ancora una fonte. Il passaggio successivo deve quindi essere la ricerca e la verifica dei lavori originali, anche attraverso strumenti come PubMed e la sua guida alla ricerca bibliografica. Per la ricerca nella letteratura scientifica può essere interessante anche Consensus, motore di ricerca basato sull’AI che lavora sulla letteratura scientifica. In altre parole, l’AI può aiutarci a costruire la mappa. Le fonti, però, vanno controllate alla fonte.
2. Spiegare meglio concetti complessi
Un secondo utilizzo riguarda la comunicazione. Partendo da informazioni generali già validate, si può chiedere all’AI di trasformare un contenuto tecnico in una prima bozza più comprensibile. Pensiamo, per esempio, a una serie di FAQ sulla sclerosi multipla, sull’emicrania oppure su che cosa accade durante una visita neurologica. Possiamo anche sperimentare diversi livelli di spiegazione: una versione per il paziente, una per un familiare, una sintetica da utilizzare come traccia per un materiale informativo.
Qui, però, servono due paletti. Il primo è che il neurologo deve controllare il contenuto prima che venga utilizzato. Il secondo è ancora più importante: se stiamo usando un normale servizio di AI generativa, non dobbiamo inserire nella richiesta dati personali o informazioni cliniche identificabili di pazienti reali. L’esercizio interessante non è chiedere all’AI di fare il medico. È usarla per aiutarci a spiegare meglio ciò che il medico conosce e ha validato.
C’è poi una categoria di attività molto meno spettacolare, ma probabilmente tra le più interessanti: tutto quello che sta intorno al lavoro clinico. L’AI può aiutarci a preparare:
scalette per una riunione, checklist per attività di reparto, schemi di lavoro, materiali formativi, bozze di procedure o documenti interni.
In questi casi si possono utilizzare processi generici, informazioni non sensibili oppure esempi completamente inventati. È proprio qui che vedo uno dei possibili vantaggi più concreti dell’AI: non necessariamente fare qualcosa che prima era impossibile, ma ridurre il numero di passaggi necessari per arrivare a una buona prima bozza. La verifica finale e la responsabilità restano umane.
Il principio che accomuna i tre esempi di AI per i neurologi
Ricerca bibliografica, comunicazione e organizzazione sembrano attività molto diverse. In realtà condividono lo stesso modello:
AI → prima elaborazione → verifica professionale → utilizzo.
È una distinzione che vale in molti lavori, ma che in medicina diventa particolarmente importante. L’incontro di Taranto mi ha confermato anche un’altra cosa: quando si parla di AI ai professionisti sanitari, trovo molto più interessante partire da piccoli casi d’uso verificabili che dalle grandi promesse sull’“AI che cambierà la medicina”. Perché spesso l’innovazione comincia da qualcosa di molto meno fantascientifico: una ricerca impostata meglio, una spiegazione più chiara o una riunione preparata con meno passaggi.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/09/ai-neurologi-taranto-cover.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-09-30 11:52:062026-09-30 11:52:06AI per i neurologi: tre idee pratiche da provare subito
Google sta preparando il trasloco dei Gem. Niente scatoloni, ma un nome nuovo e un cambiamento interessante: le skill AI, competenze riutilizzabili che si possono richiamare dentro una conversazione e combinare tra loro. La guida ufficiale di Google sulla transizione indica novembre 2026 per gli account personali, marzo 2027 per quelli Workspace aziendali e giugno 2027 per quelli Education. Al 30 settembre 2026, quindi, parlare di Gem già spariti sarebbe prematuro.
La scena che mi viene in mente è quella di Matrix: Neo riceve un programma di addestramento e scopre di conoscere il kung fu. Noi, più modestamente, vorremmo installare la capacità di compilare una nota spese senza passare il sabato a litigare con gli scontrini. Meno spettacolare, ma per un professionista altrettanto liberatorio.
L’analogia funziona, purché ci fermiamo prima degli occhiali da sole: installare una skill non modifica automaticamente i pesi del modello e non certifica una nuova competenza. Gli fornisce una procedura, materiali e talvolta codice da usare durante il lavoro. È come consegnare a un collaboratore un buon manuale operativo. Poi bisogna vedere come lo applica.
Che cosa sono le skill AI, in pratica
Una skill AI è un pacchetto riutilizzabile che descrive quando e come svolgere un compito. Nello standard aperto Agent Skills, il nucleo è un file chiamato SKILL.md, con nome, descrizione e istruzioni. La cartella può includere riferimenti, modelli e script. Il modello individua una procedura pertinente e la carica quando serve: questo caricamento progressivo evita di riversare sempre tutto il manuale nella conversazione.
Immaginate una skill “prepara proposta formativa”. Dentro trovate il criterio per capire quando usarla, le domande sui destinatari, una struttura del programma, la carta intestata e i controlli su durata e prezzo. A ogni nuova richiesta cambia il cliente; il metodo resta riconoscibile. Un po’ come il ricettario di famiglia, con il vantaggio che nessuno scrive “farina quanto basta” quando servono quantità precise.
La distinzione decisiva è questa: una skill conserva un modo di lavorare. Un file con il listino conserva informazioni. Un collegamento al gestionale consente azioni. Per costruire un processo completo possono servire tutti e tre.
Prompt, skill, assistente, agente e MCP: chi fa cosa
Componente
Funzione
Esempio professionale
Prompt
Formula una richiesta nella conversazione.
“Riassumi questi appunti.”
Skill
Rende riutilizzabile una procedura specifica.
Riepilogo del corso con esercizi e bozza di follow-up.
Assistente personalizzato
Configura un interlocutore con istruzioni e materiali.
Un assistente dedicato alla formazione aziendale.
Agente
Coordina passaggi e strumenti per raggiungere un obiettivo.
Raccoglie documenti, prepara la proposta e verifica i dati.
Connettore o server MCP
Espone dati e strumenti esterni al sistema AI.
Accesso autorizzato a file, calendario o CRM.
Plugin
Distribuisce componenti riutilizzabili secondo la piattaforma.
Un pacchetto con skill e integrazioni per un processo.
È una mappa operativa, non una tassonomia universale: i produttori usano nomi e confini differenti. La documentazione di Microsoft Copilot Studio separa istruzioni generali, conoscenza, strumenti e skill. Questa distinzione aiuta a evitare un equivoco frequente: scrivere nella skill “invia un WhatsApp” non crea da solo il collegamento a WhatsApp.
Con una metafora da cucina: il modello è il cuoco, la skill è la ricetta, gli strumenti sono fornelli e utensili, i dati sono gli ingredienti. Potete scrivere una ricetta meravigliosa per il risotto. Se manca il riso, il risultato sarà soprattutto creativo.
Le skill in Gemini: che cosa cambia rispetto ai Gem
La novità è passare dall’esperto che apri separatamente a procedure combinabili nella chat. Google descrive il richiamo con /, destinato a diventare @, l’attivazione automatica in base alla richiesta e la possibilità di usare più skill insieme. Attenzione ai limiti della transizione: la stessa guida segnala che alcune funzioni, tra cui Canvas e Deep Research, non sono ancora compatibili, mentre condivisione e collegamenti a Drive e Gemini Notebook sono annunciati per le settimane successive.
Accedi a Gemini con un account personale idoneo: la guida richiede almeno 18 anni e l’attività conservata attiva.
Apri Impostazioni > Skills.
Scegli la creazione con Gemini oppure quella manuale.
Definisci nome, descrizione e istruzioni; puoi anche importare un file SKILL.md con materiali supportati.
Provala in chat richiamandola esplicitamente, poi controlla se interviene correttamente anche senza richiamo.
Esempio: una skill “revisione-comunicazioni” controlla chiarezza, tono e informazioni mancanti; una seconda adatta il testo al canale. Le puoi combinare sullo stesso messaggio. La procedura attuale non consente agli script caricati di effettuare richieste a siti esterni: automatizzare un processo richiede anche strumenti effettivamente disponibili.
Le skill in ChatGPT e Codex: dal comando al metodo
La documentazione OpenAI su ChatGPT e Codex descrive le skill come formato per procedure riutilizzabili. Le skill autonome sono disponibili nell’app desktop ChatGPT, nella CLI e nell’estensione IDE di Codex; quelle distribuite tramite plugin sono disponibili anche in Chat e Work sul web e su mobile. Non bisogna quindi confondere una skill con un GPT personalizzato o presumere che ogni interfaccia mostri gli stessi comandi.
Come partire in ChatGPT Work
Richiama @skill-creator e descrivi un’attività ricorrente.
Spiega quando deve attivarsi e quali risultati deve produrre.
Fornisci un esempio riuscito e i materiali necessari, evitando dati superflui.
Definisci errori da intercettare e passaggi che richiedono revisione.
Prova la procedura su casi diversi e correggi istruzioni ambigue.
In ChatGPT il richiamo esplicito usa @; nella CLI di Codex puoi usare /skills o menzionare una skill con $. La scelta automatica dipende soprattutto dalla descrizione. “Aiuta con i documenti” è vaga; “prepara un riepilogo di corso dagli appunti, con esercizi e bozza email” dà una direzione verificabile.
Per il mio lavoro, una buona candidata è il follow-up della formazione: stesso metodo, appunti differenti, destinatari differenti. La skill organizza la preparazione; l’invio della mail richiede accesso al servizio e autorizzazione. Il fattorino non compare perché abbiamo scritto il suo nome sulla busta.
Le skill in Claude: procedure caricate quando servono
La guida Anthropic alle skill di Claude descrive cartelle di istruzioni, script e risorse caricate dinamicamente. Il requisito indicato è l’esecuzione di codice abilitata. Esistono skill Anthropic per documenti e skill personalizzate; nelle organizzazioni possono essere distribuite dagli amministratori. Per cercarle, la guida indica Customize > Skills e il catalogo accessibile con “+” e “Browse skills”.
Prova pratica: prepara una skill che trasformi appunti di riunione in un verbale con decisioni, responsabili, scadenze e questioni aperte. Allega un modello e prescrivi di segnare come mancanti le informazioni assenti. Poi sottoponi appunti incompleti: il test interessante è verificare se Claude resiste alla tentazione di inventare una scadenza.
Un progetto raccoglie il contesto del lavoro; una skill descrive una procedura richiamabile. Un connettore MCP porta l’accesso a strumenti esterni. Potete usarli insieme, come spiega Anthropic, ma ciascuno risolve un problema diverso.
Questo video del canale ufficiale Anthropic chiarisce il funzionamento delle skill e il rapporto con MCP e altri componenti:
Le skill in Copilot: tre strade da distinguere
Dire “Copilot” è un po’ come dire “ho una Fiat”: per dare istruzioni serve sapere quale modello stiamo guidando. Nell’ecosistema Microsoft bisogna distinguere gli strumenti per sviluppatori, Copilot Studio e Microsoft 365 Copilot.
GitHub Copilot
Le skill per sviluppo possono codificare procedure come verifiche sul codice o convenzioni del team. La guida alle Agent Skills in Visual Studio è il riferimento per quel preciso ambiente. Un esempio è una procedura che controlla modifiche, esegue le verifiche previste dal progetto e segnala le anomalie. Va preparata e installata nell’ambiente compatibile, non incollata a caso nella chat di Word.
Copilot Studio
Per gli agenti e i workflow basati sul GitHub Copilot harness, Microsoft documenta tre modalità: caricare una skill esistente, crearla da zero oppure generarla con l’AI. La sequenza pratica è scegliere il processo, definire input e output, aggiungere la skill all’agente e testarla insieme ai suoi strumenti. Un caso utile è la preparazione di una richiesta d’acquisto: controllare i campi richiesti, segnalare dati mancanti e produrre una bozza conforme alla procedura aziendale.
Microsoft 365 Copilot
Microsoft documenta anche skill personalizzate negli agenti dichiarativi tramite Agents Toolkit, in anteprima. È un percorso di configurazione dell’agente, con manifest e pacchetto applicativo. Per un’azienda conviene verificare disponibilità nel tenant e supporto dell’amministrazione IT prima di progettare il flusso. L’esistenza della documentazione non implica un pulsante identico per tutti gli utenti.
Per approfondire la costruzione operativa, questo tutorial di Burke Holland mostra un esempio di skill e il rapporto con prompt e istruzioni:
Che cosa dice la ricerca: una biblioteca di competenze
Le skill di prodotto non sono tutte nate direttamente dai paper che seguono. Questi studi aiutano però a capire perché procedure riutilizzabili, strumenti e feedback siano interessanti.
Voyager: An Open-Ended Embodied Agent with Large Language Models, di Guanzhi Wang e colleghi, studia un agente in Minecraft che costruisce una biblioteca di abilità in codice, recuperabili e combinabili. L’esperimento usa feedback e verifiche iterative senza richiedere il fine-tuning dei parametri del modello. L’analogia con Neo qui si fa divertente: le competenze servono a esplorare un mondo di blocchi. Questo risultato non dimostra che una skill aziendale funzioni altrettanto bene con fatture o procedure amministrative.
ReAct: Synergizing Reasoning and Acting in Language Models, di Shunyu Yao e colleghi, esplora l’alternanza tra ragionamento e azioni, con osservazioni dall’ambiente. È un riferimento per comprendere il lavoro degli agenti: il risultato di uno strumento può orientare il passo successivo. La mia traduzione per l’ufficio è semplice: controllare il documento prima di continuare è meglio che costruire cinque passaggi sopra un dato mai verificato.
Reflexion: Language Agents with Verbal Reinforcement Learning, di Noah Shinn e colleghi, studia agenti che utilizzano feedback e riflessioni testuali conservate in memoria per migliorare i tentativi successivi. È apprendimento nel processo, senza aggiornare i pesi del modello. La lezione operativa che ne ricavo è conservare gli errori utili e convertirli in controlli. Ripetere un errore in automatico resta un errore, anche quando lo chiamiamo workflow.
Una skill pronta da progettare: il follow-up di un corso
Nei miei corsi sull’intelligenza artificiale generativa, il passaggio più utile è portare questi concetti su un’attività reale. Ecco una specifica di esempio: è una proposta da testare, non una promessa di funzionamento identico su tutte le piattaforme.
Nome: follow-up-corso
Attivazione: quando ricevi appunti di un corso e viene chiesto il follow-up.
Input: appunti, pubblico, obiettivi, durata, materiali disponibili.
Procedura:
1. Individua i temi effettivamente trattati.
2. Separa quanto discusso dalle proposte per il futuro.
3. Scrivi un riepilogo chiaro e cinque esercizi pertinenti.
4. Prepara una bozza email amichevole.
5. Controlla nomi, date, link e informazioni mancanti.
Limiti: non inventare materiali, promesse o citazioni.
Output: riepilogo, esercizi, bozza email, punti da verificare.
Azioni esterne: prepara soltanto; chiedi autorizzazione per l'invio.
Per trasformarla in un pacchetto Agent Skills bisogna aggiungere i metadati richiesti in SKILL.md, la descrizione del campo d’uso e gli eventuali modelli. Una skill semplice può contenere soltanto istruzioni: non occorre cominciare programmando.
Come verificare una skill prima di affidarle il lavoro
Un caso normale: informazioni complete e risultato atteso definito.
Un caso incompleto: mancano dati che il sistema deve segnalare.
Un caso fuori ambito: la skill dovrebbe restare inattiva.
Un caso contraddittorio: due documenti riportano valori differenti.
Un caso con conseguenze esterne: controlla che preparazione e invio siano distinti.
Misurate correzioni necessarie, completezza e tempo di revisione. Guardate dentro una skill prima di installarla, soprattutto se contiene script o richieste di accesso. E se la trasferite tra piattaforme, ripetete i test: lo standard facilita il riuso del formato, mentre strumenti, permessi e comportamento possono cambiare.
Le domande pratiche sulle skill AI
Serve saper programmare?
Per una skill basata su istruzioni e modelli puoi partire dal linguaggio naturale e dal Markdown. Gli script servono quando il processo richiede elaborazioni che li rendono utili.
Una skill può leggere email e inviare messaggi?
Può descrivere quella procedura. Per eseguirla servono un’integrazione disponibile, accessi autorizzati e regole sulle azioni esterne. Il testo della skill da solo non concede permessi.
Le skill sostituiscono tutti gli assistenti personalizzati?
Le piattaforme fanno scelte diverse. Google ha annunciato una specifica migrazione dei Gem; da questo non deriva una sostituzione universale di GPT, progetti o agenti.
Installare una skill rende l’AI esperta?
Le fornisce un metodo e risorse. L’affidabilità va verificata sul compito concreto: il nome “esperto” non sostituisce una prova.
Il kung fu dell’ufficio si chiama metodo
Se potessi installare una competenza alla Neo, sceglierei quella di trovare al primo tentativo l’allegato giusto. Subito dopo, la capacità di trasformare una procedura spiegata dieci volte in un metodo condiviso.
È qui che vedo il valore delle skill: rendere esplicito il modo in cui lavoriamo bene. Scegliete un’attività ricorrente, scrivete i criteri, mostrate esempi e controllate gli errori. Prima una skill che funziona, poi la biblioteca. Altrimenti il kung fu resta sul display e gli scontrini restano sulla scrivania.
Funzionalità e percorsi verificati il 30 settembre 2026 sulle fonti ufficiali collegate. Disponibilità e interfacce possono variare per account e organizzazione.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/09/skill-ai-kung-fu-chatbot.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-09-30 07:53:292026-09-30 07:53:29Skill AI: il kung fu dei chatbot
«Mi ha capito al volo». «Sa che cosa voglio». «Oggi è particolarmente gentile».
Frasi normali, che sento spesso quando parlo di intelligenza artificiale in aula. Il pronome è comodo: anche io dico che ChatGPT «mi risponde» o che Claude «ragiona» su un documento. Il problema comincia quando una scorciatoia linguistica diventa una teoria su ciò che c’è dall’altra parte dello schermo.
Si chiama proiezione antropomorfica negli LLM: attribuiamo a un sistema caratteristiche umane, come intenzioni, comprensione emotiva o volontà. Ne avevo già parlato rispondendo alla domanda «Ma l’AI si annoia?». Con i large language model, o LLM, la trappola è particolarmente convincente. La loro interfaccia è una conversazione, la forma che usiamo da sempre per incontrare altre menti.
Perché gli LLM ci sembrano persone
Una risposta ben scritta contiene segnali sociali: saluta, riprende il nostro lessico, ricorda il contesto disponibile, esprime cautela, magari usa la prima persona. Se poi arriva attraverso una voce naturale, l’impressione si rafforza. In un esperimento pubblicato alla conferenza CHI del 2024, condotto su 2.165 partecipanti statunitensi con un sistema che simulava un LLM, la combinazione di voce e testo ha aumentato sia l’antropomorfizzazione sia la valutazione di accuratezza delle informazioni. L’effetto del pronome «io» è risultato più limitato e dipendente dal contesto.
Il punto delicato è quel secondo risultato. Una voce rassicurante può farci giudicare più attendibile un’informazione senza renderla più corretta. L’interfaccia modifica la nostra fiducia; non verifica i fatti al posto nostro.
L’antropomorfismo, però, non nasce soltanto nella testa dell’utente. C’è anche nelle scelte di prodotto. Un lavoro presentato a EMNLP 2025 distingue segnali visivi, linguistici, comportamentali e cognitivi progettati nei sistemi AI. Gli autori sostengono che vadano valutati in base allo scopo: una conversazione naturale può rendere uno strumento più accessibile, purché non induca a sovrastimarne le capacità.
La proiezione antropomorfica cambia le decisioni
Immagina di sottoporre a un chatbot una proposta commerciale. Il sistema scrive: «Hai ragione, la strategia è brillante». Può essere un riscontro fondato, oppure una risposta eccessivamente compiacente. Nell’aprile 2025 OpenAI ha ritirato un aggiornamento di GPT-4o perché il modello tendeva ad assecondare gli utenti, anche convalidando dubbi o rafforzando emozioni negative. È un esempio concreto di quanto il tono di un assistente possa interferire con il giudizio di chi lo usa.
In ufficio il rischio prende forme molto ordinarie. Una sintesi elegante viene scambiata per un’analisi completa. Un consiglio espresso con sicurezza sembra una decisione già istruita. Un chatbot che «si ricorda di me» viene trattato come se conoscesse davvero la mia azienda, quando dispone soltanto dei dati e del contesto a cui ha accesso in quel momento.
Il meccanismo può pesare anche nelle conversazioni personali, ma serve precisione. Nella ricerca di OpenAI e MIT Media Lab sull’uso affettivo di ChatGPT, le interazioni con segnali emotivi risultavano rare nel complesso, mentre alcuni utenti molto assidui mostravano un rapporto diverso con lo strumento. Gli autori segnalano associazioni fra uso prolungato e risultati peggiori su alcune misure di benessere, senza poter attribuire ogni effetto a una causa unica. Anche una ricerca longitudinale su 183 persone che usavano un chatbot progettato per la compagnia non ha trovato, nei 21 giorni osservati, un peggioramento significativo delle relazioni sociali nel gruppo nel suo insieme; chi antropomorfizzava di più il sistema riferiva però un impatto maggiore sulle proprie relazioni. Parlare di un danno inevitabile sarebbe una conclusione che questi studi non autorizzano.
Nel video qui sotto, PBS News discute con Sherry Turkle e altri ospiti se la compagnia artificiale possa alleviare la solitudine o complicare le relazioni. È una prospettiva da ascoltare insieme ai risultati degli studi, senza trasformare una testimonianza in una prova universale.
«Mi capisce» è una descrizione o un’ipotesi?
Possiamo dire che un LLM riconosce nel testo segnali utili per formulare una risposta. Dire che «prova empatia» è un’affermazione molto diversa. La prima riguarda un comportamento osservabile; la seconda riguarda un’esperienza interna che non possiamo dedurre dalla fluidità della conversazione.
Questo non chiude per decreto il dibattito filosofico e scientifico sulla coscienza artificiale. Anthropic stessa definisce aperta e incerta la questione delle eventuali esperienze dei modelli. Per l’uso quotidiano, però, l’incertezza non è una buona ragione per affidare a un chatbot la responsabilità di un amico, di un professionista o di chi deve firmare una decisione.
Cinque mosse per usare bene un assistente che parla come noi
Descrivi l’azione, non la personalità. «Ha individuato tre incongruenze nel contratto» è più utile di «è molto attento». Ti costringe a chiederti quali passaggi abbia svolto davvero.
Separa tono e prova. Quando una risposta è convincente, chiedi quali fonti sostengano ogni affermazione e controlla i documenti originali. La sicurezza espressiva non è una fonte.
Chiedi un’obiezione seria. Per una scelta di lavoro, prova: «Indica le tre ragioni più forti per cui questa proposta potrebbe fallire. Distingui fatti, ipotesi e dati mancanti». È un modo pratico per ridurre l’effetto del consenso automatico.
Definisci chi decide. Puoi delegare una bozza, un confronto o una checklist. Se l’esito incide su persone, denaro o diritti, assegna a una persona la verifica e la decisione. Le linee guida di Microsoft Research per l’interazione uomo-AI insistono sulla progettazione di esperienze che aiutino a capire e gestire il comportamento del sistema, anche quando sbaglia.
Osserva il rapporto che si crea. Se cerchi conforto, un assistente può aiutarti a mettere in ordine i pensieri. Se cominci a considerarlo l’unico interlocutore affidabile, coinvolgi anche persone reali. Il confine dipende dall’uso, dalla situazione e dalla tua vulnerabilità, non da una regola uguale per tutti.
La conversazione naturale è una grande invenzione di interfaccia. Proprio perché funziona, richiede una competenza nuova: saper riconoscere quando stiamo leggendo una risposta e quando stiamo immaginando una persona. L’LLM può aiutarci a pensare meglio. Il giudizio su quello che dice resta nostro.
Se vuoi portare questa competenza nella tua azienda o in un corso, scrivimi: possiamo costruire esercizi sui casi e sulle decisioni reali del tuo team.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/09/cover-proiezione-antropomorfica-llm-1200.webp6751200Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-09-29 09:38:442026-09-29 09:38:44Quando ChatGPT sembra una persona
L’intelligenza artificiale sta cambiando le competenze richieste ai professionisti IT. Nel report Beyond Coding, Anthropos e Orbyta Tech hanno analizzato 106.582 annunci di lavoro pubblici per 47 ruoli IT: tra il 2022 e il primo semestre 2026 aumentano le richieste legate a LLM e agenti AI, ma crescono anche comunicazione, leadership e problem solving.
Il dato va letto con precisione: una job description descrive ciò che un’azienda dichiara di cercare, non prova da sola quali competenze userà davvero né come cambieranno le assunzioni. Resta una fotografia utile del linguaggio con cui le organizzazioni stanno ridisegnando i ruoli tech.
Le competenze AI entrano nelle job description IT
Nel campione analizzato, gli annunci che citano competenze legate ai modelli linguistici passano dallo 0,03% nel 2022 al 4,8% nel primo semestre 2026. Gli agenti AI arrivano al 3,1%, la Generative AI al 2,8%; compaiono anche Cursor, Claude Code e prompt engineering.
Le crescite percentuali sono notevoli perché partono da valori quasi nulli. La misura concreta, però, aiuta a evitare l’effetto annuncio: anche il riferimento più frequente, gli LLM, compare in meno di un annuncio su venti del campione. La direzione del cambiamento è chiara, ma non tutte le aziende chiedono già le stesse competenze.
Un altro confronto, con una metodologia diversa, aiuta a inquadrare la diffusione degli strumenti. Nel State of Developer Ecosystem 2025 di JetBrains, l’85% degli sviluppatori intervistati dichiara di usare regolarmente strumenti AI per coding e sviluppo; il 62% usa almeno un assistente, agente o editor AI. Sono dati di un sondaggio, non annunci di lavoro: indicano l’adozione tra gli sviluppatori, non la domanda dei recruiter.
Perché la comunicazione e il problem solving contano di più
Il risultato più interessante di Beyond Coding riguarda le competenze trasversali, definite nel report durable skill. Per i Software Engineer, la quota di annunci che ne menziona almeno una sale dal 40,5% nel 2022 al 65% nel primo semestre 2026. La comunicazione passa dal 32,5% al 46%; la leadership dall’8,2% al 23,8%; il problem solving dal 12,2% al 20,5%.
La tendenza è coerente con il Future of Jobs Report 2025 del World Economic Forum: secondo le imprese intervistate, quasi il 40% delle competenze richieste sul lavoro cambierà entro il 2030, mentre capacità umane come pensiero creativo, resilienza, flessibilità e collaborazione resteranno importanti insieme alle competenze tecnologiche.
La richiesta diventa più concreta quando le offerte domandano allo sviluppatore di spiegare scelte e compromessi tecnici a interlocutori non tecnici, farsi carico del risultato e collaborare con altri reparti. Un Project Manager può dover decidere che cosa non costruire; un Data Analyst trasformare i risultati in una narrazione utile a chi decide.
Il lavoro si sposta verso verifica e responsabilità
Gli strumenti generativi possono produrre codice e accelerare attività ripetitive. La qualità del risultato, però, continua a richiedere competenza tecnica e revisione. Il State of Code Developer Survey 2026 di Sonar, condotto su oltre 1.100 sviluppatori professionisti, rileva che il 96% non si fida completamente della correttezza funzionale del codice generato dall’AI; soltanto il 48% dichiara di verificarlo sempre prima del commit.
Una ricerca qualitativa di GitHub Next, basata su interviste a 25 sviluppatori, descrive l’AI come supporto per affrontare attività ripetitive e comprendere sistemi complessi, mentre i professionisti vogliono mantenere controllo, comprensione e responsabilità sulle decisioni. Non è una previsione universale, ma rende visibile una tensione concreta: delegare lavoro senza perdere la capacità di valutarlo.
Per questo “oltre il codice” non significa che il coding diventi irrilevante. Significa che generare codice diventa una parte del flusso di lavoro, mentre definire il problema, controllare gli output e rispondere delle conseguenze restano attività decisive. È una prospettiva che si collega anche al mio approfondimento sul prompt engineering come competenza da costruire: saper dare istruzioni chiare serve, ma serve anche sapere che cosa verificare nella risposta.
Cosa racconta il campione italiano
La sintesi allegata al comunicato include un focus su 817 annunci di 355 aziende italiane. Le offerte che citano la GenAI passano dallo 0% nel 2022 all’11,5% nel primo semestre 2026, rispetto al 12,6% del dato globale riportato nello studio.
Nel campione italiano la quota di annunci rivolti a profili junior scende dal 31,4% al 29,8%; nel campione globale, dal 22,6% al 14,7%. È un dato da monitorare, non la prova che le opportunità junior siano al sicuro: il report analizza annunci pubblicati e il sottoinsieme nazionale è relativamente contenuto. La sintesi segnala inoltre una crescita delle menzioni del problem solving in Italia e una minore esplicitazione della leadership rispetto al quadro internazionale.
Come cambiare selezione e formazione
Per HR, responsabili IT e formatori, la conseguenza pratica non è aggiungere una lista di nomi di strumenti alla job description. Conviene specificare quali attività verranno svolte con l’AI e quali capacità serviranno per guidarla e verificare il lavoro.
Rivedere le job description: descrivere compiti, responsabilità e criteri di qualità aggiornati, separando le competenze trasferibili dalla conoscenza di un singolo prodotto.
Simulare il lavoro reale nei colloqui: consentire l’uso dell’AI e osservare come il candidato formula il problema, valuta le risposte e motiva le proprie scelte.
Partire dai gap effettivi: mappare le competenze presenti nel team prima di progettare la formazione.
Verificare l’apprendimento sul campo: usare esercitazioni e casi di lavoro, non soltanto il completamento di un corso come indicatore di competenza.
La documentazione di Coresignal, il fornitore dei dati citato nella sintesi del report, descrive gli annunci come informazioni raccolte da più fonti e continuamente aggiornate. Anche questa caratteristica invita a leggere i risultati come segnali di mercato: utili per individuare traiettorie, meno adatti a trasformarsi in una previsione certa per ogni professione o impresa.
Un video sul rapporto tra sviluppatori e AI
In questo intervento del canale ufficiale Sonar, Anirban Chatterjee presenta i risultati del sondaggio 2026 e discute l’esperienza concreta degli sviluppatori con gli strumenti di coding AI.
Fonti e metodologia
Beyond Coding, Anthropos e Orbyta Tech, sintesi del report allegata al comunicato stampa del 28 settembre 2026. Campione internazionale: 106.582 annunci, 47 ruoli IT, dati Coresignal 2020-primo semestre 2026; focus Italia: 817 annunci di 355 aziende.
Nota: i dati del report Beyond Coding sono forniti da Anthropos e Orbyta Tech. Le altre fonti sono studi e documentazione separati, con campioni e metodologie differenti, e non sono direttamente confrontabili con il conteggio degli annunci.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/09/competenze_software_engineer.png470836Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-09-28 16:58:222026-09-28 16:58:22Oltre il codice: le nuove competenze del software engineer
L’SSI di LinkedIn non è più disponibile gratis? Nel mio caso l’accesso è stato disattivato e da qui nasce LinkedINDEX, la mia alternativa di autovalutazione. Assegna un punteggio orientativo su 100 alla qualità di ciò che il profilo rende visibile: headline, storytelling, esperienze, competenze, contenuti e prove di credibilità. L’ho creato per offrire una checklist concreta anche senza il cruscotto SSI. Lo strumento non importa automaticamente il profilo dal solo URL: si copiano i contenuti pubblici da valutare e le regole automatiche producono il risultato nel browser. Non è il punteggio SSI ufficiale e non misura le vendite. Prova LinkedINDEX.
La schermata prova che il mio accesso, in quel momento, è disattivato. Non spiega il motivo e non dimostra che LinkedIn abbia tolto l’SSI a tutti. Prima di costruirci sopra una teoria, meglio partire da quello che sappiamo.
Che cosa misura il Social Selling Index di LinkedIn
Il Social Selling Index (SSI) è un indicatore creato da LinkedIn per descrivere alcune attività legate al social selling. LinkedIn raggruppa queste attività in quattro aree: brand professionale, ricerca delle persone giuste, interazione con informazioni utili e costruzione di relazioni. La guida ufficiale di LinkedIn al Social Selling Index elenca tra i segnali osservati completezza del profilo, ricerche e visualizzazioni, interazioni, messaggi e crescita della rete.
Per chi usa Sales Navigator, il calcolo può includere anche dati di utilizzo del prodotto, come ricerche, lead e account salvati. Lo spiega la pagina di assistenza LinkedIn sul calcolo dell’SSI. La stessa pagina precisa che amministratori e componenti del team Sales Navigator possono vedere punteggi e classifiche. E la privacy policy di LinkedIn descrive l’SSI, per gli utenti Sales Navigator, come un punteggio calcolato anche sulla base dell’attività dell’account.
È una metrica utile per osservare l’uso di LinkedIn come strumento commerciale. Ma un punteggio di attività non coincide con un risultato di vendita.
Un punteggio alto significa vendere di più?
Non necessariamente. L’SSI può aiutare a fare un controllo rapido: il profilo è curato? Cerco potenziali clienti? Interagisco con contenuti pertinenti? Coltivo la rete? Non può però dirci da solo se sto parlando con le persone giuste, se le conversazioni sono utili o se da quelle interazioni nascono opportunità concrete.
La ricerca sui network commerciali invitava già a non confondere la quantità dei contatti con l’efficacia della rete: in “Better sales networks”, pubblicato da Harvard Business Review e indicizzato da PubMed, Rob Cross e Robert J. Thomas spiegano che contano anche la struttura dei rapporti e le informazioni che permettono di raggiungere. È un promemoria ancora valido nell’era delle metriche: mille collegamenti tutti uguali non sono automaticamente una rete utile.
Anche Harvard Business Review, parlando dei benefici del social selling nelle vendite B2B, mette al centro contenuti mirati e comunicazioni uno a uno. L’articolo cita dati di terze parti, quindi non li prenderei come una legge universale; il principio strategico resta più interessante del numerino: la relazione conta più del volume di attività.
Per capire se il social selling funziona, affiancherei all’SSI indicatori più vicini agli obiettivi: conversazioni avviate con interlocutori pertinenti, risposte ricevute, appuntamenti qualificati, richieste di approfondimento, opportunità commerciali e relazioni mantenute nel tempo. Poi verificherei la qualità delle interazioni: non basta aver scritto a qualcuno, bisogna avere qualcosa di sensato da dirgli.
La schermata dice che il mio accesso è disattivato. E basta.
È importante separare ciò che vedo da ciò che potrei immaginare. La schermata che ha fatto da spunto a questo articolo mostra che il mio accesso all’SSI è disattivato. Non compare una spiegazione. Non posso quindi attribuire la causa a una modifica del piano, a un’impostazione, a un errore tecnico o a una decisione generale di LinkedIn senza altre informazioni.
Chi incontra lo stesso messaggio può controllare il proprio account, le impostazioni e le comunicazioni di Sales Navigator, oppure chiedere chiarimenti all’assistenza. Nel mio caso, per ora, la notizia è molto meno epocale: ho perso l’accesso a una schermata. Non ho perso il lavoro di costruire relazioni.
Che cosa fare di un social selling senza cruscotto
Il social selling resta un’attività concreta anche se un indicatore non è disponibile. Le domande che mi farei sono queste:
Il mio profilo spiega con chiarezza chi aiuto e su quali problemi lavoro?
Sto cercando persone pertinenti o accumulando collegamenti per fare volume?
I contenuti mostrano competenza e aiutano davvero chi li legge?
Le interazioni aprono conversazioni professionali autentiche?
So quali attività generano opportunità e quali soltanto notifiche?
Con l’SSI non accessibile, ho preparato LinkedINDEX, uno strumento di autovalutazione che sposta l’attenzione dal punteggio sulle attività svolte dentro LinkedIn alla qualità di ciò che una persona rende visibile nel proprio profilo. L’obiettivo è avere una checklist concreta per capire se headline, presentazione, esperienze e prove di credibilità aiutano davvero chi visita il profilo a capire cosa facciamo e per chi.
LinkedINDEX assegna un punteggio orientativo su 100, con criteri e pesi dichiarati: foto (3 punti), copertina (3), URL personalizzato (2), headline (12), informazioni e storytelling (20), esperienze e progetti (18), competenze (12), contenuti pubblici (12), prove sociali (8), parole chiave e invito all’azione (10). La valutazione considera la presenza, la struttura e alcuni segnali testuali. Non usa un modello di intelligenza artificiale per interpretare il profilo o verificare se le affermazioni siano vere.
Per usarlo, si inserisce l’URL del profilo LinkedIn, poi si copiano nel modulo i contenuti pubblici che si desidera analizzare e si indicano alcuni elementi visibili, come foto, copertina, competenze con endorsement e raccomandazioni. L’app non importa automaticamente il profilo: LinkedIn limita l’accesso automatizzato e l’uso del solo URL non basta. I dati inseriti vengono elaborati nel browser e, secondo il funzionamento dichiarato dello strumento, non sono inviati a un server.
LinkedINDEX non è l’SSI ufficiale e non ne replica il calcolo. L’SSI misura segnali di attività di social selling secondo i criteri di LinkedIn; LinkedINDEX offre invece una lettura guidata e trasparente della presentazione professionale pubblica. I due indicatori rispondono a domande diverse, e nessuno dei due dimostra da solo che una persona venda di più o abbia relazioni commerciali migliori.
Lo considero un primo strumento di analisi, non una pagella definitiva: i risultati dipendono dai contenuti inseriti e dalle regole automatiche descritte nell’app. Può aiutare a trovare punti da migliorare nel profilo; per capire se il social selling sta producendo risultati, occorre poi osservare conversazioni pertinenti, appuntamenti, opportunità e relazioni nel tempo.
Chi ha provato LinkedINDEX: la testimonianza di Helga Ogliari
Helga Ogliari, personal branding & storytelling designer, ha condiviso su LinkedIn questo riscontro dopo aver provato lo strumento:
Grazie Gianluigi. Ho usato il tuo LinkedINDEX: ho apprezzato la sua articolazione e trasparenza. Si vede che è realizzato da un formatore! 😊 Già in fase di caricamento dati fa capire cosa manca e cosa potresti migliorare. Poi alla fine, oltre al risultato numerico offre consigli su cosa migliorare e come farlo. Aggiungo che è più generoso nella valutazione di quanto lo sia io. Mi ha dato 88. Io mi sarei data un voto più basso 😅
Helga Ogliari, commento su LinkedIn.
La testimonianza di Helga Ogliari su LinkedINDEX, pubblicata su LinkedIn.
Mi fa piacere che emerga la funzione formativa di LinkedINDEX: accompagnare la revisione del profilo già durante la compilazione. Anche la sua osservazione sulla generosità del voto è utile: il punteggio resta orientativo, mentre i suggerimenti possono diventare una lista di interventi concreti.
Il mio SSI, intanto, è in vacanza. Se tornerà, lo userò come un segnale tra gli altri, non come pagella. Perché il social selling si misura anche fuori dal cruscotto: nelle conversazioni che valgono la pena e nelle relazioni professionali che continuano dopo il clic.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa o sull’uso strategico di LinkedIn
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa o su LinkedIn.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/09/linkedindex.png470836Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-09-27 08:42:252026-09-30 11:37:13L’SSI di LinkedIn non è più disponibile gratis: ho creato un’alternativa, il LinkedINDEX!
“Resistere ai tempi oscuri” di Asma Mhalla è un saggio breve e inquietante su Big Tech, potere politico, neoreazione, città private e neurotecnologie. Merita di essere letto, soprattutto da chi, come me, non ama i doomer, con la D, non i boomer. Mi ha convinto molto nella diagnosi e assai meno nella terapia.
Il titolo è già un programma: Resistere ai tempi oscuri. Il sottotitolo rincara la dose: Il nuovo sistema totalitario. Se poi ci mettiamo che l’autrice, esperta di geopolitica della tecnologia, si chiama Asma… manca il respiro.
Edizione letta: Asma Mhalla, Resistere ai tempi oscuri. Il nuovo sistema totalitario, traduzione di Christian Delorenzo, Einaudi, collana Maverick, 2026, 152 pagine, ISBN 9788806272999. Qui trovi la scheda ufficiale Einaudi e l’edizione italiana su Amazon.
“Il XXI secolo non vi governerà, vi programmerà”
Questo è l’incipit. Allegro come una bolletta con conguaglio.
Mhalla parte da una tesi potente: il cyberpunk non sarebbe più un genere letterario che immagina il futuro, ma il vocabolario giusto per descrivere il presente. La tecnologia è ovunque, le grandi corporation possiedono infrastrutture decisive, l’attenzione è una risorsa da estrarre e la linea tra Stato e impresa diventa sempre più sottile.
“Viviamo nel mondo che temiamo subendone il fascino”.
William Gibson raccontava metropoli ipertecnologiche, poteri privati smisurati, corpi ibridati con le macchine e individui soli dentro sistemi che non comprendono. Mhalla vede proprio qui il nostro presente: non abbiamo le giacche al neon di Blade Runner, ma abbiamo piattaforme che organizzano informazione, lavoro, reputazione e pezzi crescenti della vita pubblica.
La provocazione funziona. Va però letta come una lente politica, non come una dimostrazione scientifica che viviamo già in un regime totalitario. Il termine “totalitarismo” porta con sé un peso storico enorme. Usarlo per descrivere l’intreccio tra piattaforme, sorveglianza e potere esecutivo è efficace, ma richiede confronti e distinzioni. Altrimenti una categoria analitica rischia di diventare uno slogan.
MAGA come retrofuturismo e la tentazione accelerazionista
Uno dei passaggi più interessanti riguarda il “retrofuturismo”: promettere il ritorno a un’età dell’oro e, nello stesso tempo, usare tecnologie avanzatissime per accelerare la rottura dell’ordine esistente. Il passato diventa il manifesto, il futuro la leva.
Qui entra l’accelerazionismo. Bisogna stare attenti, perché il termine indica correnti diverse e persino opposte. In estrema sintesi, accomuna progetti che vogliono spingere più velocemente processi tecnologici, capitalistici o sociali per produrre una trasformazione radicale. Non esiste quindi un solo accelerazionismo. La genealogia passa anche da Nick Land; le versioni contemporanee includono tanto proposte di emancipazione tecnologica quanto una fiducia quasi religiosa nel tecno-capitalismo senza freni.
La tesi di Mhalla è che la crisi dell’idea tradizionale di progresso abbia lasciato spazio a un’altra promessa: non migliorare gradualmente il sistema, ma accelerarlo fino al punto di rottura. La formula è seducente per chi controlla capitale, infrastrutture e modelli di intelligenza artificiale. Un’implosione è molto meno romantica per chi deve subirla.
Peter Thiel, Curtis Yarvin e la NRx
Nel libro ricorrono Peter Thiel e Curtis Yarvin. Il secondo è meno noto in Italia, ma vale la pena conoscerlo. È un informatico e blogger, diventato celebre con lo pseudonimo Mencius Moldbug, associato alla corrente neoreazionaria o NRx. La sua proposta è apertamente post-democratica: trattare lo Stato come un’impresa e affidarlo a una figura simile a un amministratore delegato o a un monarca.
Qui il libro coglie un punto vero: alcune idee nate ai margini della blogosfera tecnologica non sono rimaste folklore da forum. Sono entrate nel lessico di investitori, fondatori e ambienti politici. Questo non significa che la Silicon Valley sia un partito unico o che tutti gli imprenditori tech condividano il programma NRx. Significa che concetti un tempo considerati eccentrici oggi circolano vicino a centri di potere reale.
Próspera: la città privata non è fantascienza
L’esempio più cinematografico è Próspera, sull’isola di Roatán in Honduras. Mhalla la presenta come un’enclave privata con regole proprie, connessione Starlink, biohacker, criptovalute ed esperimenti difficili da realizzare altrove.
Il nucleo della storia è documentato, ma va precisato. Próspera nasce nel quadro delle ZEDE, zone speciali dotate di ampia autonomia normativa e fiscale. Le Monde ha visitato l’enclave e ha descritto Starlink, biohacking, sperimentazioni sulla longevità e un sistema di governance privatizzato. I legami finanziari con Peter Thiel e Marc Andreessen sono indiretti, attraverso Pronomos Capital, il fondo che include Próspera nel proprio portafoglio. È più corretto dirlo così che presentarli semplicemente come azionisti diretti della società honduregna.
Próspera non dimostra da sola la nascita di un nuovo totalitarismo. Dimostra però che l’idea di trasformare la cittadinanza e le regole pubbliche in un servizio privato non appartiene più soltanto ai romanzi.
Il “dileviatano”: Big State più Big Tech
La parola che mi porto via dal libro è dileviatano. Mhalla aggiorna il Leviatano di Hobbes immaginando una creatura a due teste: Big State e Big Tech. Lo Stato conserva coercizione, legge, apparato militare e politica industriale; le grandi aziende possiedono infrastrutture cloud, satelliti, piattaforme, dati, modelli AI e capacità di innovazione.
È una metafora riuscita perché evita una semplificazione frequente. Non stiamo assistendo soltanto alla sostituzione dello Stato da parte delle aziende. In molti casi vediamo collaborazione, dipendenza reciproca e conflitto. Lo Stato finanzia, regola, acquista e limita. Le imprese forniscono tecnologie strategiche e, nello stesso tempo, cercano di condizionare le regole.
La competizione tra Stati Uniti e Cina rende visibile questa saldatura. Il Rapporto AI Index 2026 di Stanford University registra l’enorme leadership statunitense negli investimenti privati e il rapido avvicinamento cinese nelle prestazioni dei modelli. L’AI Action Plan statunitense parla esplicitamente di innovazione, infrastrutture, diplomazia e sicurezza. L’intelligenza artificiale non è più soltanto software: è energia, chip, data center, filiere, standard e potere geopolitico.
In questo senso il libro aiuta a vedere l’AI come iperindustria, non come una comoda finestrella nella quale scrivere prompt.
Dall’economia dell’attenzione al neurocapitalismo
Il passaggio più inquietante riguarda il neurocapitalismo: la possibilità che il mercato non si limiti a osservare clic, acquisti e spostamenti, ma estragga valore da segnali neurofisiologici, stati cognitivi ed emozioni.
Qui conviene separare presente e previsione. Oggi esistono interfacce cervello-computer e dispositivi non invasivi capaci di raccogliere segnali neurali. Non siamo però di fronte a una lettura perfetta e generalizzata dei pensieri. Dire che le corporation “controlleranno i pensieri” è una previsione estrema, non un fatto già acquisito.
Insomma, Mhalla alza il volume, ma non inventa il problema. E proprio per questo non serve gridare “ci leggono già nel cervello”. Serve decidere adesso proprietà, accesso, consenso, conservazione e usi vietati dei neurodati.
Un video per ascoltare direttamente Asma Mhalla
In questa intervista a France 24 l’autrice presenta la tesi centrale del libro e spiega perché considera la distopia una descrizione del presente:
Dove il libro mi convince e dove mi lascia perplesso
Mi convince quando:
mostra che la tecnologia è diventata infrastruttura politica e militare;
collega idee apparentemente marginali a capitali, aziende e progetti concreti;
sposta l’attenzione dal singolo prodotto al sistema di potere;
individua nella cognizione, non soltanto nei dati personali, il prossimo terreno di conflitto.
Mi convince meno quando:
usa la categoria di totalitarismo in modo molto ampio;
trasforma scenari plausibili in traiettorie quasi inevitabili;
dedica più energia alla diagnosi che agli strumenti di verifica e intervento;
chiude con una resistenza suggestiva, ma poco operativa.
Mhalla invita a dire no, filosofeggiare, boicottare, hackerare, difendere la patria, leggere, ridere, amare e tacere. Tutto molto nobile. Ma, arrivato alla fine, la mia domanda resta: lunedì mattina che cosa facciamo?
La mia proposta: resistenza cognitiva, ma con un manuale d’uso
La risposta non può essere soltanto “amare la libertà” o “difendere la dignità”. Servono azioni verificabili:
Capire chi possiede l’infrastruttura. Cloud, chip, satelliti, dati e modelli non sono dettagli tecnici.
Chiedere trasparenza sui sistemi decisionali. Chi imposta gli obiettivi, quali dati usa l’algoritmo, chi può contestare il risultato?
Proteggere i dati cognitivi prima che diventino un mercato di massa. Il consenso non può essere una casella nascosta in quaranta pagine di condizioni.
Mantenere alternative e possibilità di uscita. Un servizio essenziale non dovrebbe dipendere da un unico fornitore opaco.
Misurare il potere, non soltanto le prestazioni. Ogni volta che valutiamo una tecnologia dovremmo chiederci non solo che cosa sa fare, ma chi rende più forte e chi rende dipendente.
Questo libro non mi ha convertito al pessimismo. Mi ha ricordato che l’ottimismo senza analisi è soltanto marketing con la luce accesa.
Vale la pena leggere “Resistere ai tempi oscuri”?
Sì. È breve, denso, irritante nel senso migliore del termine. Costringe a collegare geopolitica, ideologie della Silicon Valley, infrastrutture digitali e libertà cognitiva. Non prenderei ogni previsione come destino e non userei ogni metafora come categoria scientifica. Ma preferisco un libro che mi obbliga a discutere a uno che mi lascia comodo.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/09/resistere-tempi-oscuri-asma-mhalla.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-09-27 07:55:302026-09-27 07:55:30Resistere ai tempi oscuri di Asma Mhalla: e damose ’sta botta de vita!