Gianluigi Bonanomi riflette sull’uso dell’intelligenza artificiale nella ricerca scientifica

Sì, l’intelligenza artificiale può rendere più veloce la ricerca bibliografica, ma non può trasformare una sintesi automatica in una prova scientifica. Il modo più utile per usare l’AI nella letteratura scientifica è dividerne il lavoro in fasi: trovare gli studi, orientarsi tra i risultati, confrontare metodi e conclusioni, controllare le citazioni e solo alla fine scrivere.

In questo articolo presento PubMed.ai, Consensus e altre piattaforme che possono aiutare studenti, ricercatori, medici, docenti e professionisti a lavorare meglio con i paper.

Che cosa può fare l’AI per la letteratura scientifica

Un chatbot generalista è utile per riformulare una domanda, chiarire un concetto o trasformare appunti in una scaletta. Gli strumenti specializzati per la ricerca scientifica aggiungono però un elemento decisivo: cercano di ancorare le risposte a pubblicazioni, abstract, citazioni e metadati bibliografici.

Le attività più adatte sono:

  • tradurre una domanda generica in parole chiave e concetti correlati;
  • individuare articoli pertinenti;
  • riassumere abstract e risultati;
  • confrontare più studi in una tabella;
  • seguire citazioni, autori e filoni di ricerca;
  • estrarre variabili, campioni, metodi e limiti;
  • monitorare nuovi articoli su un tema.

L’AI è molto meno adatta a decidere da sola se una conclusione sia clinicamente valida, se due studi siano davvero comparabili o se una revisione sistematica rispetti tutti i criteri metodologici. Quella parte resta responsabilità del ricercatore.

Consensus: il punto di partenza per orientarsi nella letteratura

Consensus è un motore di ricerca accademico che permette di interrogare la letteratura con domande in linguaggio naturale. La sua documentazione descrive una ricerca ibrida: combina ricerca semantica, utile per cogliere il significato della domanda, e ricerca per parole chiave, utile per mantenere precisione terminologica.

Il valore pratico di Consensus è l’orientamento iniziale. Può aiutare a capire rapidamente quali sono gli studi più pertinenti, quali risultati ricorrono e dove esistono divergenze. La piattaforma dichiara inoltre di coprire una grande collezione di articoli accademici e l’intero corpus di PubMed.

Userei Consensus soprattutto per tre attività:

  1. trasformare una domanda ampia in una mappa iniziale del tema;
  2. identificare gli studi che meritano una lettura integrale;
  3. confrontare risultati concordanti e risultati contraddittori.

Il risultato di Consensus non va copiato come se fosse una conclusione definitiva. Bisogna aprire gli articoli originali, verificare il disegno dello studio, il campione, la data, la rivista e le condizioni in cui il risultato è stato ottenuto.

PubMed.ai: un esempio secondario per la ricerca biomedica

PubMed.ai è pensato per la ricerca biomedica. La piattaforma dichiara di usare la letteratura indicizzata in PubMed per aiutare l’utente a formulare ricerche, esplorare i risultati, porre domande sugli studi e generare sintesi strutturate.

Tra le funzioni presentate dal servizio ci sono la ricerca assistita dall’AI, l’analisi della letteratura, una chat sui contenuti recuperati, l’estrazione di informazioni e la generazione di report PDF. La pagina ufficiale specifica inoltre che il servizio lavora sulla letteratura biomedica disponibile pubblicamente e che alcune funzioni, come i protocolli di laboratorio e le revisioni della letteratura, risultano ancora indicate come in arrivo.

La differenza rispetto a una ricerca libera in un chatbot è importante: PubMed.ai dichiara di ottimizzare le query e di collegare l’analisi ai record bibliografici di PubMed. Questo può essere utile quando la domanda è espressa in linguaggio naturale, per esempio: “Quali effetti ha l’esercizio fisico nei pazienti con diabete?”.

Va ricordato che PubMed resta la banca dati di riferimento da consultare direttamente. La National Library of Medicine lo descrive come una risorsa con oltre 40 milioni di citazioni di letteratura biomedica, con collegamenti, quando disponibili, al testo completo su PubMed Central o sui siti degli editori.

Le altre piattaforme da conoscere

Strumento Quando è utile Attenzione
Elicit Screening, estrazione di dati, tabelle comparative e report ispirati alle revisioni sistematiche. Le estrazioni vanno controllate sulle pubblicazioni originali, soprattutto per numeri e risultati clinici.
Scite Valutare il contesto delle citazioni e capire se uno studio è sostenuto, contraddetto o semplicemente menzionato da lavori successivi. Una citazione favorevole o contraria non sostituisce la lettura critica dell’articolo citante.
Semantic Scholar Scoprire articoli correlati e orientarsi tra autori, citazioni e concetti. È uno strumento di scoperta, non un certificato automatico di qualità metodologica.
ResearchRabbit Partire da un paper e costruire una mappa di lavori, autori e connessioni bibliografiche. Le raccomandazioni dipendono dal paper di partenza e possono amplificare il punto di vista iniziale.
Connected Papers Visualizzare la vicinanza tra articoli e individuare filoni di ricerca. Una mappa visiva aiuta l’esplorazione, ma non è una revisione sistematica.
SciSpace Leggere PDF, porre domande sui documenti e organizzare una revisione assistita. Le risposte dipendono dalla qualità del PDF e dal modo in cui si formulano le domande.

Un workflow affidabile in cinque passaggi

1. Definisci la domanda

Evita richieste come “cerca tutto sull’intelligenza artificiale in medicina”. Specifica popolazione, intervento o esposizione, confronto, esito e intervallo temporale. Anche una domanda semplice migliora molto quando contiene un perimetro.

2. Usa due strumenti con funzioni diverse

Puoi partire da PubMed.ai o Consensus per l’orientamento, passare a PubMed per la verifica bibliografica e usare ResearchRabbit o Connected Papers per seguire le connessioni. La ridondanza è utile: se una fonte compare in più percorsi indipendenti, merita un controllo prioritario.

3. Leggi il paper, non soltanto il riassunto

Chiedi all’AI di estrarre metodo, campione, risultati e limiti. Poi controlla direttamente abstract, testo integrale, figure, tabelle e materiali supplementari. Un riassunto può omettere proprio la condizione che rende un risultato meno generalizzabile.

4. Costruisci una tabella delle evidenze

Per ogni studio registra almeno: riferimento completo, domanda, disegno, campione, intervento o variabile, risultato principale, limiti e livello di pertinenza. È un’attività molto adatta a Elicit o a uno strumento che lavori su documenti selezionati, come Gemini Notebook.

5. Verifica prima di citare

Controlla DOI, autori, rivista, anno, PMID e formulazione della conclusione. Se un riferimento non è rintracciabile, non inserirlo. L’output dell’AI è un supporto di lavoro, non una fonte.

Il rischio più grande: l’illusione della bibliografia pronta

La fluidità della risposta può creare una falsa sensazione di solidità. Un testo ben scritto non dimostra che gli studi citati esistano, che siano pertinenti o che sostengano davvero la frase a cui sono associati.

Lo stesso principio vale per una tesi. Nella mia guida Come fare una tesi di laurea con l’AI insisto su un punto semplice: l’AI può aiutare a restringere il campo, organizzare le fonti e chiarire il ragionamento, ma non sostituisce il progetto della ricerca né l’etica della citazione.

Per una revisione clinica, una tesi o una decisione professionale suggerisco questa regola: nessuna frase importante senza una fonte primaria verificata. Se la frase descrive un dato, va controllato il dato. Se interpreta un risultato, va controllata l’interpretazione. Se confronta studi, vanno controllati criteri e contesto.

Video: Semantic Scholar 101

Questo tutorial ufficiale mostra la ricerca in Semantic Scholar e si inserisce bene nel workflow descritto sopra: trovare un primo nucleo di articoli, seguirne le connessioni e poi verificare le fonti originali.

Domande frequenti

PubMed.ai sostituisce PubMed?

No. PubMed.ai può semplificare l’esplorazione e la sintesi, ma PubMed resta il database da controllare direttamente per record bibliografici, filtri e collegamenti al testo completo.

Consensus mostra il consenso scientifico?

Può aiutare a individuare convergenze e divergenze nella letteratura, ma la parola “consenso” non significa che ogni risultato sia definitivo. Bisogna valutare qualità, aggiornamento e comparabilità degli studi.

Quale piattaforma scegliere per una revisione sistematica?

Nessuna piattaforma dovrebbe essere l’unico strumento. Per una revisione formale servono una domanda definita, strategie di ricerca documentate, criteri di inclusione ed esclusione, gestione dei duplicati, valutazione del rischio di bias e controllo umano.

Posso usare ChatGPT o Gemini per leggere i paper?

Sì, se carichi documenti che puoi trattare in modo appropriato e chiedi estrazioni verificabili. Per la ricerca iniziale e per le citazioni è preferibile partire da banche dati e strumenti accademici, non da una chat generalista senza fonti.

Conclusione

Consensus, PubMed.ai, Elicit, Scite, Semantic Scholar, ResearchRabbit, Connected Papers e SciSpace non fanno tutti la stessa cosa. Alcuni cercano, alcuni sintetizzano, alcuni mappano le citazioni, altri estraggono dati dai documenti.

La scelta più efficace non è trovare “il miglior tool”, ma costruire una catena di controllo: domanda ben definita, ricerca specializzata, lettura dei paper, confronto tra fonti, verifica bibliografica e responsabilità umana. È così che l’AI diventa un supporto concreto alla letteratura scientifica, senza trasformarsi in un generatore di bibliografie plausibili.

Fonti e risorse

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Un corso su LinkedIn e AI dovrebbe insegnare a migliorare profilo, contenuti e relazioni, ma anche a verificare le presunte regole dell’algoritmo. L’intelligenza artificiale può aiutarti a organizzare le idee e scrivere meglio. Non conosce, per questo, una formula segreta per moltiplicare la visibilità.

Mi è stata sottoposta un’infografica intitolata How the LinkedIn algorithm works in 2026. Sette riquadri, numeri precisi, promesse rassicuranti. I primi 90 minuti deciderebbero tutto. Un salvataggio varrebbe cinque like. Un commento da otto a quindici. Sembra il listino della borsa delle interazioni.

Ho controllato le sette affermazioni confrontandole con documentazione tecnica, paper e benchmark. Il risultato è una guida pratica per chi cerca “LinkedIn AI corso” e vuole imparare un metodo verificabile. Per cominciare dalle basi, trovi anche il mio videocorso LinkedIn gratuito sull’ottimizzazione del profilo.

Verifica delle fonti: 20 settembre 2026. Le valutazioni riguardano le informazioni pubbliche consultate, non il codice interno di LinkedIn. Gli esempi didattici sono dichiarati come tali.

L’infografica sull’algoritmo LinkedIn 2026: verifica delle sette affermazioni

Una distinzione preliminare: “non verificato” non significa automaticamente “falso”. Significa che non ho trovato una fonte adeguata per presentare quella frase come un fatto. Un benchmark, inoltre, descrive un campione: non rivela da solo il funzionamento del ranking.

Affermazione dell’infografica Esito della verifica Come usarla correttamente
Il 70% della reach si decide nei primi 60-90 minuti; commenti e salvataggi iniziali decidono la distribuzione. Percentuale e finestra decisiva non documentate nelle fonti consultate. Rispondere quando si è disponibili è una scelta organizzativa. Non esiste qui una prova che il post scada dopo 90 minuti.
Un salvataggio vale 5 like e 2 commenti; i contenuti salvabili ottengono più distribuzione di qualsiasi altro contenuto. Moltiplicatori non verificati. Anche il primato assoluto è privo di prova. Creare risorse utili ha senso. Non attribuire loro un rendimento algoritmico fisso.
I commenti valgono 8-15 like; quelli articolati segnalano conversazioni autentiche, mentre “Great post!” viene escluso dalla distribuzione. Pesi non verificati. La preferenza per contributi sostanziali è coerente con le comunicazioni della piattaforma; l’esclusione automatica di una frase breve non è dimostrata. Aggiungere un esempio, una domanda pertinente o un’obiezione motivata.
Il tempo di permanenza conta più dei like; 60 secondi di lettura battono 50 like con letture da 3 secondi. Segnale reale, confronto numerico non provato. Favorire comprensione e utilità senza allungare artificialmente i testi.
360Brew legge headline, informazioni ed esperienze prima di distribuire ogni post; un profilo vago riduce sempre la reach. Attribuzione a 360Brew non giustificata. Il ruolo dei segnali di profilo va distinto dalla presunta penalità universale. Rendere chiaro il proprio lavoro ai lettori, evitando promesse sul ranking.
I documenti hanno engagement medio del 6,6%, il più alto del 2026; sfogliarli aumenta il dwell time e il valore algoritmico. Dato rintracciabile, generalizzazione scorretta. Il 6,6% compare nel Q2 2026 di Socialinsider, con i multi-immagine al 6,9%. Il meccanismo causale non è provato dal benchmark. Distinguere periodo, campione, formato e metrica.
La coerenza tematica batte la dimensione della rete; cambiare argomento confonde 360Brew. Consiglio editoriale trasformato in legge. Nessuna prova di questo confronto universale. Scegliere temi riconoscibili e sperimentare collegamenti pertinenti.

C’è persino un problema di coerenza interna. Se un salvataggio equivale a cinque like e a due commenti, un commento dovrebbe valere 2,5 like. Il riquadro successivo ne indica da otto a quindici. Senza spiegare contesti diversi, i due conti non tornano. Questo non dimostra quali siano i pesi reali: dimostra che quei numeri non possono essere utilizzati insieme come una formula.

360Brew e Feed SR: che cosa dicono davvero i paper

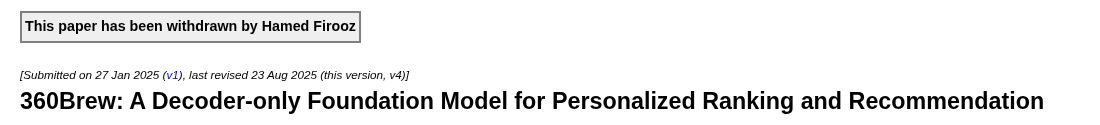
Il paper su 360Brew di Hamed Firooz e colleghi, presentato nel gennaio 2025, descriveva un modello di ricerca pre-production da 150 miliardi di parametri. La scheda arXiv segnala il ritiro; la nota amministrativa riguarda il diritto del depositante ad accettare la licenza. Il ritiro, da solo, non dimostra che i risultati tecnici fossero sbagliati. Ma quel documento non autorizza a descrivere 360Brew come il motore che decide oggi la visibilità di ogni post.

Screenshot arXiv: avviso di ritiro e titolo del paper 360Brew
Estratto della scheda arXiv di 360Brew, consultata il 20 settembre 2026. L’avviso di ritiro è visibile sopra il titolo.

Un riferimento più pertinente è An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking, di Lars Hertel, Gaurav Srivastava e colleghi. La versione consultata è del 16 settembre 2026. Gli autori descrivono Feed Sequential Recommender, o Feed SR, e dichiarano l’impiego sulla maggior parte del traffico del feed. Riportano test A/B con un aumento del 2,10% del tempo trascorso e del 3,52% della metrica che raggruppa like, commenti e ricondivisioni rispetto al modello precedente.

Sono risultati del sistema nel suo insieme. Non significano che un tuo post guadagnerà il 3,52%, né che un commento abbia un valore fisso. Il paper descrive una sequenza di interazioni e previsioni di azioni: non un tariffario pubblico per creator.

Screenshot arXiv del paper su Feed SR con revisione del 16 settembre 2026
La scheda del paper su Feed SR: titolo e data della revisione consultata.

La spiegazione ufficiale Engineering the next generation of LinkedIn’s Feed, firmata da Hristo Danchev il 12 marzo 2026, distingue la selezione dei contenuti candidati dal loro ordinamento. Descrive modelli che utilizzano significato dei contenuti, segnali professionali del lettore e storia delle interazioni. Gli aggiornamenti possono riguardare anche post già esistenti che ricevono nuove interazioni. Non pubblica la regola del “70% entro 90 minuti”.

Attenzione anche a una confusione frequente: i dati del tuo profilo che aiutano a personalizzare ciò che leggi non dimostrano automaticamente una penalità per ciò che pubblichi. Una headline chiara resta una buona scelta di comunicazione. Per esempio, “Consulente commerciale per aziende manifatturiere” permette a un potenziale cliente di orientarsi meglio di “Professionista appassionato di sfide”.

Tempo di lettura e commenti: i segnali esistono, i moltiplicatori no

Il tempo di permanenza non è un’invenzione dell’infografica. In Understanding dwell time to improve LinkedIn feed ranking, del 12 maggio 2020, il team di LinkedIn spiega l’uso del dwell time nel feed e dopo il clic, anche per individuare contenuti rapidamente saltati. È una fonte tecnica storica, non una descrizione completa del sistema del 2026. Non stabilisce l’equivalenza “60 secondi battono 50 like”.

La mia indicazione pratica: togli attriti alla lettura. Una spiegazione può richiedere dieci righe o dieci slide. Se aggiungo sette slide vuote per trattenere le persone, sto progettando un ostacolo, non una lezione.

Sull’autenticità c’è una comunicazione più recente: Keeping conversations real on LinkedIn, di Laura Lorenzetti, pubblicata il 20 maggio 2026. LinkedIn ammette l’uso dell’AI come supporto alla scrittura, ma annuncia interventi sui contenuti generici, sulle risposte che ripetono il post e sui commenti automatizzati su larga scala. Non dice che ogni ringraziamento breve sia falso.

Esempio didattico: sotto un post sulla formazione aziendale, “Concordo, tema fondamentale” aggiunge poco. “Nel tuo esempio manca il tempo per verificare l’output: come lo includeresti nell’esercitazione?” apre una questione precisa. Non servono cinque frasi quando ne basta una utile.

Il 6,6% dei documenti LinkedIn: leggere bene un benchmark

Il report LinkedIn Benchmarks 2026 di Socialinsider permette di rintracciare quel numero: nell’aggiornamento del secondo trimestre 2026 i documenti nativi sono al 6,6% di engagement medio, mentre i post multi-immagine sono al 6,9%. La tabella annuale indica invece il 7% per i documenti sui dati 2025.

La metodologia annuale dichiara 1,3 milioni di post di 16.645 pagine aziendali, tra gennaio 2024 e dicembre 2025. La pagina aggiunge aggiornamenti trimestrali, ma non si può attribuire automaticamente al solo Q2 l’intero campione annuale. Il tasso è calcolato rispetto alle impression, non ai follower. Sono dati osservazionali di un fornitore di analytics, non un esperimento causale di LinkedIn sui profili personali.

Un PDF e un album di immagini sono inoltre formati distinti. Dire “i caroselli fanno sempre il 6,6%” perde queste differenze. Per scegliere, partirei dalla domanda del lettore: un procedimento può diventare un documento; una visita a uno stabilimento può essere raccontata con fotografie. Misurerei poi i risultati sul mio pubblico.

LinkedIn e AI: corso pratico in cinque esercizi

La parte utile comincia qui. Propongo un piccolo laboratorio per consulenti, commerciali, professionisti e responsabili marketing. Puoi svolgerlo con un assistente AI testuale, usando materiali che hai titolo a condividere. Gli output sono bozze da controllare prima della pubblicazione.

1. Migliorare il profilo partendo da prove

Raccogli il testo attuale del profilo, una descrizione dei servizi e due esperienze documentate. Chiedi una diagnosi prima della riscrittura.

Agisci come un revisore del mio profilo LinkedIn. Il pubblico è [target] e voglio essere riconoscibile per [competenza]. Analizza headline, informazioni ed esperienze che incollo. Indica cinque passaggi generici e le domande necessarie per renderli concreti. Proponi tre headline usando solo le informazioni presenti. Non inventare clienti, certificazioni, anni di esperienza o risultati. Segna con [DA VERIFICARE] ciò che manca.

Esempio didattico: per un professionista che lavora realmente con PMI manifatturiere, “Aiuto le PMI manifatturiere a organizzare il processo commerciale” è una proposta più comprensibile di “Sales ninja orientato al successo”. Va usata soltanto se descrive ciò che fa davvero.

Per rivedere le basi prima di usare l’AI, il mio videocorso LinkedIn gratis offre dieci videopillole su profilo, posizionamento, keyword, esperienze e networking. È una base sul profilo; gli esercizi di questo articolo aggiungono il lavoro con l’AI.

2. Trasformare un’esperienza in un post verificabile

Parti da appunti reali: una domanda ricevuta, un errore corretto, una scelta progettuale. Un aneddoto inventato resta inventato anche se il chatbot lo racconta bene.

Trasforma questi appunti in una bozza LinkedIn per [pubblico]. Mantieni il mio punto di vista: [tesi]. Struttura: problema concreto, esempio, limite, domanda finale pertinente. Massimo 1.300 caratteri. Niente emoji, superlativi o statistiche aggiunte. Non attribuirmi esperienze assenti dagli appunti. Elenca separatamente le affermazioni da verificare e conserva i link alle fonti che ti fornisco.

Controllo finale: saprei rispondere se qualcuno mi chiedesse come ho ottenuto quel dato? Se no, cerco la fonte o elimino il dato. Se l’episodio contiene informazioni riservate di un cliente, preparo un esempio anonimo o un caso esplicitamente ipotetico.

3. Progettare un documento utile da conservare

Esempio didattico per un consulente AI: un PDF intitolato “Cinque controlli prima di usare un documento aziendale con un chatbot”. Ogni pagina contiene un controllo, una domanda e un esempio. Il formato segue il lavoro da svolgere.

Progetta una scaletta di sei slide sul tema [tema] per [pubblico]. Usa soltanto le fonti e gli appunti allegati. Per ogni slide scrivi titolo, messaggio principale, esempio e fonte, se necessaria. La prima deve spiegare l’utilità del documento; l’ultima deve contenere una checklist. Segnala informazioni mancanti. Evita slide riempitive e promesse di performance.

Prima di caricarlo, leggi il PDF sul telefono. Controlla dimensioni del testo, contrasto, ordine delle pagine e leggibilità dei collegamenti. Un contenuto “salvabile” deve essere utilizzabile anche domani.

4. Preparare una conversazione senza automatizzare il rapporto

L’AI può aiutarti a capire un testo prima di intervenire. La risposta pubblica deve riflettere ciò che pensi e conosci.

Riassumi la tesi di questo post in due frasi. Individua una domanda rimasta aperta e un possibile limite. Proponi tre spunti per un commento, senza scriverli come mie esperienze. Non fingere che conosca l’autore. Aspetta che io scelga lo spunto e aggiunga il mio punto di vista.

La verifica è semplice: se cancellassi il riferimento al post originale, il commento funzionerebbe sotto qualunque contenuto? Se sì, probabilmente è troppo generico.

5. Analizzare i risultati senza scambiare correlazione e causa

Prepara una tabella dei tuoi post con data, argomento, formato, impression, reazioni, commenti, clic e salvataggi quando disponibili. Aggiungi un campo per le conversazioni professionali pertinenti e uno per le richieste ricevute. Non confondere gli zeri con i dati mancanti.

Analizza questa tabella dei miei post LinkedIn. Distingui risultati osservati, ipotesi e dati mancanti. Confronta formati e argomenti usando numerosità, mediana e dispersione quando i dati lo consentono. Non dedurre i pesi dell’algoritmo. Se calcoli un tasso, esplicita numeratore e denominatore. Proponi due esperimenti editoriali cambiando una variabile alla volta. Non attribuire vendite ai post senza evidenze.

Come esercizio, puoi osservare i post dopo 24 ore e dopo sette giorni, mantenendo uguali le finestre di confronto. Sono scelte di misurazione del laboratorio, non scadenze imposte dall’algoritmo. Con pochi post parlerai di indizi, non di conclusioni statistiche robuste.

L’AI migliora la scrittura? Uno studio utile, con limiti precisi

Shakked Noy e Whitney Zhang hanno studiato l’uso di ChatGPT in compiti di scrittura professionale con 453 partecipanti. Il lavoro, Experimental evidence on the productivity effects of generative artificial intelligence, è stato pubblicato su Science nel 2023. Il resoconto del Massachusetts Institute of Technology, con collegamento al paper, riporta un tempo medio ridotto del 40% e una qualità valutata superiore del 18%.

Lo studio non misurava la reach su LinkedIn. I compiti non richiedevano lo stesso contesto aziendale e la stessa verifica fattuale di molte attività reali. È una base per sperimentare un assistente alla scrittura, non una prova che i post generati ottengano più clienti.

Nel laboratorio separerei quindi due misure: tempo necessario per produrre una bozza affidabile, compresa la revisione, e risultati del contenuto pubblicato. Risparmiare venti minuti e pubblicare un errore non è il miglioramento che cerchiamo.

Come scegliere un corso LinkedIn AI

Valuterei un corso dai materiali che permette di costruire e dai controlli che insegna. Ecco la mia checklist:

  • Profilo: il lavoro parte da pubblico, competenze e prove?
  • Prompt: le richieste includono fonti, vincoli e gestione delle informazioni mancanti?
  • Contenuti: si lavora su esperienze reali e revisioni, oltre che sulle prime bozze?
  • Relazioni: gli esercizi favoriscono conversazioni pertinenti?
  • Misurazione: si distinguono visibilità, interazioni, contatti e opportunità?
  • Algoritmo: il docente separa documentazione ufficiale, benchmark e ipotesi?

Se un programma promette il trucco definitivo per aggirare l’algoritmo, chiederei la fonte, la data e il metodo di verifica. È un ottimo esercizio già prima dell’iscrizione.

Domande frequenti su LinkedIn, AI e formazione

Posso usare l’AI per scrivere i post LinkedIn?

Sì, come supporto per struttura e formulazione. La comunicazione di LinkedIn sull’autenticità richiede che post e commenti rappresentino la voce e la prospettiva dell’autore. Verifica fatti, esempi e tono prima di pubblicare.

I primi 90 minuti decidono davvero tutto?

Non ho trovato nelle fonti tecniche consultate una conferma della finestra universale e della percentuale indicate nell’infografica. Conviene usare finestre di osservazione costanti, evitando di giudicare un contenuto soltanto dai primi minuti.

Il videocorso LinkedIn gratuito comprende questo laboratorio AI?

Il videocorso collegato insegna le basi dell’ottimizzazione del profilo. Il laboratorio AI è descritto in questo articolo: puoi affiancarlo alle videopillole, senza confondere i due materiali.

Come posso organizzare un corso LinkedIn e AI per l’azienda?

Puoi scrivermi tramite il form qui sotto indicando destinatari, livello di partenza e obiettivo: personal branding, comunicazione, social selling o ricerca di opportunità professionali. Possiamo costruire esercitazioni su profili e materiali pertinenti al tuo contesto.

Per iniziare subito: guarda il videocorso LinkedIn gratuito, scegli un esercizio di questa guida e confronta la bozza dell’AI con le prove che hai a disposizione. Il primo risultato da cercare è un profilo più chiaro e un contenuto di cui puoi rispondere personalmente.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

La memoria di ChatGPT permette al sistema di riutilizzare preferenze, dettagli e contesto pertinenti per offrirti risposte più personali e farti ripetere meno informazioni. Non è però una registrazione completa di tutto ciò che hai scritto: ChatGPT seleziona ciò che considera utile e, a seconda del piano e delle impostazioni, può attingere da chat precedenti, ricordi salvati, istruzioni personalizzate, file nella Libreria e contenuti delle app connesse.

In questa guida vediamo come controllare la memoria di ChatGPT, correggerla, cancellarla e usare le chat temporanee. Con una precisazione importante: le voci possono cambiare in base al piano, alla piattaforma, all’area geografica e alle regole dell’eventuale spazio di lavoro aziendale.

Che cos’è la memoria di ChatGPT, in breve

La memoria trasforma ChatGPT da interlocutore che riparte ogni volta da zero in un assistente capace di mantenere continuità. Se sa che lavoro fai, quali strumenti usi o come preferisci ricevere una risposta, può evitare premesse inutili e adattare meglio esempi e linguaggio.

OpenAI distingue però più meccanismi:

  • Ricordi salvati: informazioni che chiedi esplicitamente di ricordare o che ChatGPT conserva come contesto utile.
  • Cronologia chat: informazioni pertinenti ricavate dalle conversazioni precedenti. Possono cambiare quando il sistema rivaluta ciò che è più utile.
  • Istruzioni personalizzate: indicazioni dirette su ciò che ChatGPT deve sapere e sul modo in cui deve rispondere. Non sono la stessa cosa della memoria.
  • Memoria migliorata: dove disponibile, mantiene un riepilogo più ampio e aggiornato del contesto personale.

È una distinzione pratica. Se vuoi costruire un vero assistente personale o un secondo cervello digitale con ChatGPT, devi sapere da quale fonte arriva un’informazione e come rimuoverla davvero.

Come attivare e gestire la memoria di ChatGPT

Passaggio 1: apri le impostazioni

  1. Apri ChatGPT sul web o nell’app.
  2. Apri il menu del profilo.
  3. Seleziona Impostazioni.
  4. Vai su Personalizzazione.
  5. Apri Memoria.

Secondo la guida ufficiale OpenAI sulla memoria, qui potresti trovare voci come Memoria, Fai riferimento ai ricordi salvati, Fai riferimento alla cronologia chat, Riepilogo della memoria, Gestisci o Ricordi salvati. Se una voce non compare, non è necessariamente un errore: disponibilità e controlli variano.

Passaggio 2: scegli che cosa può essere usato

Se il tuo account mostra due interruttori separati, puoi controllare i ricordi salvati e la cronologia delle chat. Disattivando i ricordi salvati viene disattivato anche il riferimento alla cronologia; lasciandoli attivi, puoi invece gestire la cronologia separatamente.

Attenzione a un equivoco comune: spegnere la memoria non cancella automaticamente le vecchie chat. Se in seguito la riattivi, ChatGPT potrebbe ricavare nuovi elementi dalle conversazioni ancora presenti.

Passaggio 3: chiedi a ChatGPT che cosa ricorda

Il controllo più semplice parte da una domanda:

Che cosa ricordi di me? Organizza la risposta per categorie e segnala le informazioni che potrebbero essere obsolete o poco utili.

Dove disponibile, puoi anche aprire il Riepilogo della memoria. La schermata offre una vista sintetica, non necessariamente completa, delle informazioni usate per personalizzare le risposte.

Schermata ufficiale del riepilogo della memoria di ChatGPT con funzione di correzione
Il riepilogo della memoria può essere corretto direttamente. Schermata ufficiale OpenAI.

Passaggio 4: correggi ciò che è sbagliato

Puoi scrivere una correzione, selezionare il testo da modificare oppure dire in chat:

Correggi questa informazione: non uso più lo strumento X. Da oggi considera Y come mia preferenza.

Alcuni account mostrano anche l’opzione Non menzionarlo più. Serve a ridurre i riferimenti futuri, ma non elimina la fonte originale. È la differenza fra dire a qualcuno di non citare più un vecchio episodio e strappare la pagina dall’archivio.

Passaggio 5: controlla le fonti della personalizzazione

Quando ChatGPT usa contesto personale pertinente, sotto la risposta può comparire la sezione Fonti. Può rimandare a un ricordo, una chat, un’istruzione personalizzata, un file o un’email connessa. Non è detto che mostri ogni fattore che ha influenzato la risposta.

Schermata ufficiale delle fonti della memoria di ChatGPT con comandi per pertinenza e correzione
Dalle Fonti puoi verificare perché un’informazione è stata usata, correggerla o segnalarla come non pertinente. Schermata ufficiale OpenAI.

Questo controllo è prezioso perché la personalizzazione senza trasparenza rischia di diventare una scatola nera. Se un suggerimento ti sorprende, controlla prima la fonte e poi decidi se correggere, eliminare o ignorare l’informazione.

Come cancellare davvero un’informazione dalla memoria

Cancellare la chat non basta sempre. Un ricordo salvato è archiviato separatamente dalla conversazione originaria. Per rimuovere un’informazione in modo più completo:

  1. Elimina il ricordo dal riepilogo o dai controlli dei ricordi salvati.
  2. Elimina la chat in cui l’informazione è stata condivisa.
  3. Rimuovila anche da eventuali chat archiviate.
  4. Elimina i file pertinenti dalla Libreria.
  5. Se proviene da un’app connessa, valuta di rimuovere il contenuto o disconnettere l’app.

OpenAI avverte che aggiornamenti ed eliminazioni possono richiedere tempo e che i log dei ricordi salvati eliminati possono essere conservati fino a 30 giorni per sicurezza e debug. Per i documenti professionali conviene comunque ridurre i dati personali prima del caricamento: ho spiegato un approccio pratico nella guida a Rizzo PII per anonimizzare i documenti destinati a ChatGPT.

Chat temporanea: quando usare ChatGPT senza creare nuovi ricordi

La chat temporanea è utile quando la conversazione non deve comparire nella cronologia e non deve creare o aggiornare la memoria. Prima di inviare il primo messaggio puoi scegliere:

  • Personalizzata: usa ricordi esistenti, istruzioni personalizzate e plugin disponibili.
  • Non personalizzata: ignora memoria, istruzioni personalizzate e plugin.

La scelta non può essere modificata dopo l’inizio della conversazione. In entrambi i casi la chat temporanea non crea né aggiorna ricordi. Se però la salvi, diventa una chat normale e segue le impostazioni dell’account. La documentazione OpenAI sulle chat temporanee precisa inoltre che una copia può essere conservata fino a 30 giorni per finalità di sicurezza.

Schermata ufficiale di ChatGPT per scegliere una chat temporanea personalizzata o non personalizzata
Nella chat temporanea puoi scegliere Personalizzata o Non personalizzata prima del primo messaggio. Schermata ufficiale OpenAI.

Memoria e addestramento dei modelli non sono la stessa impostazione

Un altro equivoco frequente è confondere memoria e addestramento. La memoria personalizza le risposte. L’opzione Migliora il modello per tutti decide invece se, per un account personale, le nuove conversazioni possano contribuire al miglioramento dei modelli.

Per controllarla sul web:

  1. Apri il menu del profilo.
  2. Vai su Impostazioni.
  3. Apri Controlli dei dati.
  4. Attiva o disattiva Migliora il modello per tutti.

La FAQ ufficiale sui controlli dei dati chiarisce che, disattivando questa voce, le conversazioni restano nella cronologia ma non vengono usate per addestrare ChatGPT. Nei workspace ChatGPT Business, Enterprise, Edu e Healthcare, OpenAI dichiara che i contenuti non vengono usati per l’addestramento per impostazione predefinita.

Memoria nei progetti: contesto globale o isolato?

I Progetti aggiungono un’altra scelta importante. Dove disponibile, puoi usare la memoria predefinita oppure la memoria limitata al progetto. In questo secondo caso le chat possono fare riferimento alle altre conversazioni dello stesso progetto, ma non a quelle esterne; anche le chat esterne non possono richiamare il contenuto del progetto.

È una buona soluzione per separare clienti, corsi, ricerche o attività personali. Secondo la guida OpenAI ai Progetti, i progetti condivisi usano automaticamente la memoria limitata al progetto. È un confine di contesto, non una scusa per caricare qualsiasi dato senza valutare ruoli, permessi e policy aziendali.

Cinque prompt per gestire meglio la memoria

  1. Audit: “Che cosa ricordi di me? Dividi le informazioni in corrette, da verificare e non più utili”.
  2. Aggiunta: “Ricorda che preferisco risposte brevi, con esempi italiani e fonti primarie”.
  3. Correzione: “Sostituisci la vecchia informazione X con Y e dimmi che cosa hai aggiornato”.
  4. Rimozione: “Dimentica l’informazione X e spiegami quali altre fonti devo eliminare per rimuoverla completamente”.
  5. Controllo in risposta: “Per questa risposta indica se hai usato memoria, chat precedenti, file o app connesse”.

Le istruzioni personalizzate restano lo strumento migliore per regole stabili e intenzionali sul tono e sul formato. La memoria serve invece a mantenere continuità con ciò che emerge nel tempo. Per approfondire le forme più evolute di personalizzazione puoi leggere anche il mio articolo su skill, plugin e futuro dei GPT personalizzati.

La mia checklist mensile per una memoria utile

  • Chiedi a ChatGPT che cosa ricorda di te.
  • Correggi ruolo, preferenze e strumenti non più attuali.
  • Elimina ciò che è sensibile, superfluo o ambiguo.
  • Controlla file nella Libreria e app connesse.
  • Separa i contesti professionali con progetti dedicati.
  • Usa una chat temporanea non personalizzata quando non vuoi richiamare né creare memoria.
  • Verifica separatamente l’impostazione “Migliora il modello per tutti”.

Una memoria ben curata rende ChatGPT più utile. Una memoria lasciata crescere senza controllo può invece amplificare informazioni vecchie, interpretazioni sbagliate e preferenze che non ti rappresentano più. Cinque minuti di manutenzione ogni mese sono un investimento sensato.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

OpenAI ha annunciato il ritiro dei GPT personalizzati e la loro sostituzione con un sistema basato su skill, app e plugin. Non significa che ChatGPT rinunci alla personalizzazione. Significa il contrario: la personalizzazione smette di vivere dentro tanti piccoli chatbot separati e diventa modulare, riutilizzabile e collegabile agli strumenti di lavoro.

La formula più semplice è questa: la skill spiega a ChatGPT come svolgere un lavoro, l’app gli permette di accedere a dati e azioni esterne, il plugin mette insieme questi componenti in un flusso utilizzabile. ChatGPT resta il centro della conversazione e sceglie le capacità adatte al compito.

Addio ai GPT personalizzati: che cosa ha annunciato davvero OpenAI

La prima precisazione è importante: i GPT personalizzati non sono scomparsi da un giorno all’altro. Nella sua FAQ ufficiale sul ritiro e sulla migrazione, OpenAI spiega che la transizione riguarda tutti i piani, ma pubblica un calendario dettagliato soprattutto per gli ambienti Enterprise interessati.

  • 11 settembre 2026: comunicazione agli amministratori Enterprise.
  • 17 settembre 2026: data obiettivo per l’arrivo dello strumento di migrazione e dell’avviso agli utenti. OpenAI precisa che il rilascio può essere graduale.
  • 25 settembre 2026: termine pianificato per la creazione di nuovi GPT negli ambienti Enterprise interessati.
  • 11 dicembre 2026: ritiro programmato dei GPT personalizzati in quegli ambienti. Da quel momento i GPT coinvolti smetteranno di funzionare.

Per gli account personali Free, Go, Plus e Pro, la guida ufficiale alla creazione dei GPT indica che non è più possibile creare o pubblicare nuovi GPT. Quelli esistenti, per ora, restano utilizzabili e modificabili quando piano e autorizzazioni lo consentono. Per Business, Enterprise ed Edu la situazione dipende invece dalle impostazioni dell’area di lavoro e dalla tabella di marcia applicata all’account.

Quindi è corretto parlare di addio ai GPT personalizzati, ma non di spegnimento immediato e simultaneo per tutti. La data che conta è quella mostrata nell’avviso del proprio account o workspace.

Perché OpenAI cambia architettura

Il GPT personalizzato introdotto nel 2023 era un contenitore unico: nome, istruzioni, file di conoscenza, modello consigliato, funzioni e collegamenti esterni. Era facile da capire perché sembrava un piccolo ChatGPT specializzato. Questa semplicità, però, produceva duplicazioni.

Immaginiamo un’azienda con dieci GPT diversi. Cinque devono leggere Google Drive, quattro devono consultare il CRM e sette applicano la stessa procedura per verificare le fonti. Nel vecchio schema ogni GPT tendeva a portarsi dietro configurazioni simili. Nel nuovo schema la procedura di verifica può diventare una skill condivisa, mentre Drive e CRM restano app utilizzabili da più flussi.

La direzione strategica è evidente: non un negozio pieno di chatbot isolati, ma un solo ambiente di lavoro capace di caricare metodi e strumenti quando servono. È la stessa logica con cui un computer usa software diversi senza diventare ogni volta un computer nuovo.

Skill, app e plugin: le differenze in parole semplici

Componente Che cos’è Che cosa contiene o abilita Esempio
Skill Un metodo di lavoro riutilizzabile Istruzioni, esempi, risorse e anche codice o script Una procedura che verifica una notizia, cita le fonti e prepara un articolo SEO
App Un collegamento a un servizio esterno Ricerca, lettura e, se autorizzate, azioni sul servizio Gmail, Google Drive, Slack, GitHub, Canva o HubSpot
Plugin Il pacchetto che organizza un flusso Una o più skill, una o più app ed eventuali modelli di configurazione Un flusso commerciale che legge il CRM, prepara il follow-up e crea una bozza email

Secondo la documentazione OpenAI sulle skill, una skill è un workflow condivisibile che aiuta ChatGPT a eseguire un compito in modo più coerente. Può includere istruzioni, esempi, file di supporto e codice. Una volta installata, ChatGPT può selezionarla automaticamente quando la descrizione della richiesta corrisponde al suo scopo.

Le app di ChatGPT fanno un mestiere diverso: collegano la conversazione ai servizi che usiamo già. Possono cercare un file, leggere un documento, recuperare un messaggio e, quando previsto e autorizzato, compiere azioni come creare o aggiornare informazioni.

Il plugin in ChatGPT e Codex è il contenitore operativo. Può includere skill, app o entrambe. Alcuni plugin non richiedono alcun account esterno perché contengono soltanto procedure. Altri funzionano solo dopo aver collegato e autorizzato le app necessarie.

Come viene sostituito concretamente un GPT personalizzato

OpenAI prevede un flusso di migrazione. Nell’ambiente Enterprise, il creatore del GPT o un amministratore potrà avviarlo quando l’opzione sarà disponibile e i plugin saranno abilitati. Il GPT deve essere pubblicato nel workspace, anche privatamente: una semplice bozza non può essere migrata.

La conversione non è una fotocopia perfetta. Funziona così:

  1. Le istruzioni del GPT diventano una skill. Il metodo, il tono, le regole e i passaggi del lavoro vengono trasformati in indicazioni riutilizzabili.
  2. Le app collegate entrano nel plugin come app. Ogni collegamento conserva però le proprie autorizzazioni e i propri limiti.
  3. I file, gli esempi e i modelli vanno ricontrollati. OpenAI invita a verificare che il nuovo plugin usi correttamente tutto il materiale di riferimento.
  4. Gli starter di conversazione e le vecchie chat potrebbero non essere trasferiti. Non bisogna considerarli un archivio garantito.
  5. Il modello scelto dal GPT non viene trasferito. Negli ambienti Enterprise valgono le impostazioni predefinite dell’organizzazione.
  6. Le Custom Actions non migrano automaticamente. Le integrazioni API dovranno essere valutate e ricostruite tramite un connettore supportato o un server MCP personalizzato.
  7. Permessi e condivisione non vengono ereditati automaticamente. Il plugin nasce privato e deve essere testato, condiviso e installato dagli utenti autorizzati.
  8. Dopo la migrazione, il GPT originale diventa di sola lettura. Resta utilizzabile fino al ritiro, mentre le modifiche future si fanno sul plugin.

La conseguenza pratica è semplice: prima di migrare conviene inventariare istruzioni, file, integrazioni, utenti e cinque prompt di prova. Dopo la migrazione si eseguono gli stessi test, compreso almeno un caso difficile. Se le risposte o le azioni cambiano, si corregge il plugin prima di distribuirlo.

12 esempi concreti di skill e plugin al lavoro

1. Dalla notizia all’articolo verificato

Una skill editoriale impone di partire da fonti primarie, controllare date e affermazioni, usare una struttura SEO e aggiungere una checklist finale. Un’app di ricerca recupera le fonti, Google Drive fornisce materiali interni e una app personalizzata basata su MCP può creare la bozza su WordPress. Il risultato non è un chatbot “giornalista”, ma un flusso editoriale richiamabile quando serve.

2. Posta elettronica trasformata in lista di priorità

Una skill definisce le categorie “urgente”, “da delegare”, “da leggere” e “può aspettare”. L’app Gmail o Outlook legge i messaggi autorizzati, identifica scadenze e prepara una sintesi. Per rispondere o inviare, ChatGPT può chiedere conferma in base ai permessi impostati.

3. Follow-up commerciale dal CRM

Una skill commerciale stabilisce tono, criteri di qualificazione e struttura del messaggio. HubSpot recupera stato del contatto e ultime interazioni; Gmail prepara una bozza personalizzata. L’agente non inventa il rapporto con il cliente: lavora sui dati che l’utente è autorizzato a vedere.

4. Riunione trasformata in attività

Un plugin può combinare una skill per i verbali con Fathom o Zoom, Notion e Slack. Dalla trascrizione estrae decisioni, responsabili e date; crea una pagina di progetto e prepara il messaggio di riepilogo per il canale del team.

5. Materiale didattico trasformato in presentazione

Una skill didattica definisce pubblico, obiettivi, ritmo, esercizi e numero di slide. Google Drive recupera documenti e dispense, Canva crea la presentazione, mentre la skill controlla che ogni slide abbia un solo messaggio e un’attività concreta.

6. Report KPI con spiegazione manageriale

Una skill contiene definizioni dei KPI, regole per confrontare periodi e soglie di allarme. Le app Data, Microsoft Power BI o Tableau recuperano i dati disponibili. ChatGPT produce una lettura orientata alle decisioni, segnala anomalie e distingue fatti, ipotesi e domande ancora aperte.

7. Triage di issue e pull request su GitHub

Una skill tecnica definisce priorità, severità, criteri di sicurezza e formato del riepilogo. GitHub fornisce issue, pull request e stato della CI. Il plugin può classificare i problemi, proporre test e preparare una revisione, lasciando merge e pubblicazione ai permessi e alle conferme previste.

8. Agenda costruita dalle email

Una skill riconosce richieste di appuntamento, durata, vincoli e margini di viaggio. Gmail o Outlook recupera la conversazione e Google Calendar o Outlook Calendar mostra le disponibilità. ChatGPT propone gli slot e crea l’evento soltanto dopo l’approvazione richiesta.

9. Controllo dei documenti in Dropbox

Una skill definisce nomenclatura, versioni, scadenze e documenti obbligatori. Dropbox individua file mancanti o duplicati e prepara un piano di riordino. Le operazioni che spostano o rinominano file restano soggette ai controlli dell’app.

10. E-commerce e assistenza sui prodotti

Una skill di catalogo stabilisce come descrivere un prodotto senza inventare caratteristiche. Shopify recupera schede, varianti e disponibilità; la procedura prepara descrizioni coerenti, confronti e risposte ai clienti. Un controllo umano resta opportuno prima di modificare prezzi o pubblicare contenuti.

11. Ricerca scientifica con criteri trasparenti

Una skill specifica domanda di ricerca, criteri di inclusione, periodo, tipi di studio e formato delle citazioni. Plugin che includono strumenti come Consensus o SciSpace aiutano a trovare e leggere i paper. La skill obbliga a separare risultati, limiti e interpretazioni, evitando il classico riassunto che fa sembrare certo ciò che certo non è.

12. Radar quotidiano per un’azienda o un territorio

Una skill contiene fonti ammesse, parole chiave, criteri per scartare duplicati e struttura del report. La ricerca web trova gli aggiornamenti; Slack o l’email consegna la sintesi; un’attività programmata la esegue ogni mattina. È un esempio perfetto di componente riutilizzabile: la stessa skill può cambiare fonti e destinatari senza ricreare un GPT da zero.

Questi esempi vanno letti con una clausola: disponibilità, azioni di scrittura e automazioni dipendono dal piano, dall’area geografica, dal ruolo, dal workspace e dai permessi concessi alle singole app.

Che cosa cambia per aziende e professionisti

Il vantaggio maggiore non è estetico. È organizzativo. Una procedura ben scritta può essere condivisa da più plugin; una stessa app può servire più processi; gli amministratori possono separare l’accesso al metodo dall’accesso ai dati.

OpenAI mette a disposizione controlli distinti per plugin e app. Gli amministratori possono decidere quali plugin siano disponibili o installati, quali ruoli possano usarli, quali azioni siano consentite e quando serva un’approvazione. La documentazione sui controlli di sicurezza e conformità chiarisce che installare un plugin non concede automaticamente nuovi diritti sui servizi collegati.

Questo è anche il punto critico. Una skill può includere codice e script; un’app può leggere dati o eseguire azioni. Prima di installare un pacchetto esterno bisogna verificarne autore, contenuto, autorizzazioni e comportamento. Ne ho parlato anche nell’approfondimento sulle skill per Claude e i rischi da evitare: il principio resta valido anche qui. Una procedura sbagliata, automatizzata bene, sbaglia più velocemente.

La checklist per non perdere il lavoro costruito nei GPT

  1. Elenca tutti i GPT che usi davvero, non quelli creati per prova.
  2. Identifica proprietario, utenti e workspace di origine.
  3. Copia istruzioni, file, esempi e prompt di test in un archivio controllato.
  4. Segna app, Custom Actions e API utilizzate.
  5. Definisci quali azioni devono richiedere approvazione umana.
  6. Pubblica le bozze che devono essere migrate, senza renderle necessariamente pubbliche.
  7. Migra un GPT alla volta e prova casi facili, normali e difficili.
  8. Controlla accessi e condivisione del plugin sostitutivo.
  9. Confronta output, file prodotti e azioni eseguite.
  10. Forma gli utenti: non basta consegnare un nuovo pulsante.

Il vero cambiamento: da chatbot personalizzati a competenze componibili

Nel 2023 la metafora vincente era “costruisci il tuo ChatGPT”. Nel 2026 la metafora più utile è “costruisci il tuo sistema di lavoro”. Il centro non è più il personaggio con un nome e un’icona, ma la combinazione tra metodo, dati, strumenti, permessi e supervisione.

È un passaggio più maturo, ma anche più esigente. Creare un GPT richiedeva soprattutto buone istruzioni. Progettare un plugin utile richiede invece di descrivere il processo, decidere quali dati servono, limitare le azioni, definire i controlli e misurare il risultato.

Quindi sì, stiamo dicendo addio ai GPT personalizzati. Ma non alla personalizzazione di ChatGPT. Stiamo dicendo addio al piccolo chatbot isolato e passando a un’AI che carica competenze e strumenti come moduli. Meno personaggi. Più processi.

Domande frequenti

I miei GPT personalizzati sono già stati cancellati?

No. OpenAI ha annunciato un ritiro futuro. Gli account e i workspace possono avere calendari e avvisi diversi. Per gli ambienti Enterprise interessati, il ritiro è programmato per l’11 dicembre 2026.

Una skill è uguale a un GPT?

No. Un GPT era un assistente separato con identità, istruzioni, conoscenza e strumenti. Una skill è una procedura riutilizzabile che ChatGPT può applicare dentro flussi diversi.

Un plugin è la stessa cosa di un’app?

No. L’app collega ChatGPT a un servizio esterno. Il plugin organizza un workflow e può includere una o più app, una o più skill o entrambe.

La migrazione trasferisce tutto?

No. Le istruzioni diventano una skill e le app collegate possono entrare nel plugin, ma starter di conversazione, chat precedenti e modello selezionato possono non passare. Le Custom Actions devono essere ricostruite.

Posso creare una skill senza programmare?

Per gli account idonei, OpenAI consente di crearla conversando con ChatGPT o usando un editor. Le skill possono anche contenere codice, ma non è obbligatorio per i flussi basati soltanto su istruzioni ed esempi.

Le skill sono disponibili per tutti?

OpenAI indica le skill personali soprattutto per Business, Enterprise, Healthcare ed Edu, con disponibilità legata a impostazioni, ruolo e superficie del prodotto. Il catalogo dei plugin è visibile su più piani, ma installazione e funzioni possono variare.

Fonti originali

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Ogni mattina, in migliaia di caselle di posta, arriva la stessa email: tre risultati di Google Alerts, due dei quali duplicati e uno completamente fuori tema. Nel frattempo un agente AI potrebbe aver già letto centinaia di fonti, scartato il rumore e preparato una sintesi leggibile in trenta secondi. È la domanda che mi sento fare sempre più spesso da chi si occupa di comunicazione, SEO o brand reputation: ha ancora senso usare Google Alerts quando esistono motori di ricerca basati sull’intelligenza artificiale e veri agenti autonomi capaci di monitorare il web al posto nostro?

La risposta breve è: dipende da cosa dobbiamo monitorare, da quanto in fretta ci serve saperlo e da quanto siamo disposti a delegare. La risposta lunga richiede di capire come funziona oggi Google Alerts, dove si ferma, e che cosa cambia davvero con i motori AI e con gli agenti.

Che cos’è rimasto di Google Alerts nel 2026

Google Alerts nasce come strumento semplice: si imposta una query, si sceglie la frequenza (in tempo reale, una volta al giorno, una volta alla settimana) e si ricevono email quando compaiono nuovi risultati pertinenti su Ricerca Google. Il funzionamento, spiegato nella guida ufficiale di Google, non è cambiato di molto rispetto a quando lo strumento fu lanciato: resta gratuito, immediato da configurare, ma anche piuttosto rigido.

Negli anni Google ha investito pochissimo su questo prodotto. Non si integra con AI Overviews o con AI Mode, non distingue una menzione positiva da una negativa, non raggruppa le notizie per argomento, non impara dalle correzioni. È rimasto, di fatto, fermo a un’epoca precedente ai motori di ricerca conversazionali.

I limiti reali di Google Alerts oggi

  • Copertura parziale delle fonti. Fatica a coprire bene social network, forum verticali, gruppi Telegram o Facebook, marketplace: proprio i luoghi dove nascono molte crisi reputazionali.
  • Ritardo variabile. Anche in modalità “in tempo reale” possono passare ore o giorni prima che un contenuto già indicizzato generi una notifica.
  • Duplicati e rumore. La stessa notizia ripresa da decine di aggregatori riempie la casella di posta di link quasi identici.
  • Nessuna sintesi né priorità. Lo strumento non dice se una menzione è rilevante, virale o pericolosa: il lavoro di lettura e selezione resta interamente umano.
  • Nessuna azione. Si limita a notificare: non propone una risposta, non avvisa un collega, non aggiorna un foglio di lavoro, non apre un ticket.

Un esempio concreto: un’agenzia che monitora le menzioni di un brand riceve anche quaranta email al giorno, di cui solo tre davvero rilevanti, e nonostante questo si accorge in ritardo di una discussione nata su Reddit, perché quel tipo di fonte non viene intercettato con la stessa rapidità di una testata giornalistica.

Che cosa cambia con i motori di ricerca basati sull’AI

Con AI Overviews e AI Mode, Google non si limita più a restituire dieci link blu: costruisce una sintesi che cita le fonti. Strumenti come Perplexity vanno nella stessa direzione, ma capovolgono l’approccio di Alerts: invece di aspettare una notifica, si fa una domanda diretta e si ottiene una risposta aggiornata con le fonti citate. Nel mio articolo su come ho usato Perplexity per una ricerca mirata il principio è lo stesso applicato a un altro obiettivo: interrogare, non aspettare.

Questo cambiamento non riguarda solo come cerchiamo le informazioni, ma anche come veniamo trovati. Se le risposte AI sintetizzano il web al posto dell’utente, capire come il proprio brand o i propri contenuti vengono citati in quelle risposte diventa una nuova forma di monitoraggio, quella che nel mio approfondimento su SEO, GEO e AEO descrivo come necessità di ottimizzare non solo per l’algoritmo di ranking, ma per il modo in cui un modello linguistico riassume e cita le fonti.

Che cosa cambia davvero con gli agenti AI

I motori di ricerca AI rispondono a una domanda quando la facciamo. Un agente va oltre: lavora su un programma, consulta più fonti in autonomia, incrocia i dati, scarta il rumore, scrive una sintesi e, se lo abilitiamo, compie un’azione, come inviare un’email o aggiornare una tabella. È qui che la faccenda si fa interessante, e anche più delicata.

Più un agente passa dal “dire” al “fare”, più serve decidere quanto controllo umano mantenere. Nel mio articolo su human-in-the-loop e human-on-the-loop entro nel dettaglio di questa distinzione: per una sintesi giornaliera delle menzioni può bastare un supervisore che controlla a campione (on-the-loop), ma se l’agente deve rispondere pubblicamente a una recensione negativa, quel passaggio dovrebbe restare sotto approvazione umana (in-the-loop).

Quattro esempi pratici di monitoraggio con agenti AI

  • Rassegna stampa quotidiana automatica. L’agente legge decine di fonti ogni mattina, produce una sintesi con priorità e sentiment, e segnala alla persona solo le anomalie reali, invece di scaricare tutto il lavoro di lettura sull’utente.
  • Monitoraggio prezzi e attività dei concorrenti. L’agente controlla ogni giorno pagine e listini, e avvisa solo quando c’è una variazione significativa, non a ogni minima modifica del codice HTML.
  • Social listening esteso. L’agente copre Reddit, forum di settore, gruppi pubblici e community verticali che Google Alerts intercetta con difficoltà o in ritardo.
  • Monitoraggio della propria presenza nelle risposte AI. L’agente interroga periodicamente ChatGPT, Perplexity e AI Overviews con le domande tipiche del proprio settore, per verificare se e come il brand viene citato: un controllo che nessun Alert tradizionale può fare, perché non guarda “dentro” la risposta generata dal modello.

Per chi deve poi mettere in relazione documenti diversi raccolti durante il monitoraggio, come rassegne stampa, PDF e screenshot, uno strumento come Gemini Notebook può aiutare a incrociare fonti eterogenee invece di leggerle una per una.

Google Alerts, motori AI e agenti a confronto

Aspetto Google Alerts Motori di ricerca AI Agenti AI di monitoraggio
Copertura fonti Limitata, soprattutto su social e forum Ampia, ma legata al momento della domanda Ampia e programmabile su misura
Tempestività Da ore a giorni Immediata, ma solo su richiesta Continua, secondo la frequenza impostata
Sintesi e priorità Assente Buona sulla singola risposta Costruita su misura, con soglie e priorità
Azioni automatiche Nessuna Nessuna, resta conversazionale Possibili, da presidiare con attenzione
Costo Gratuito Gratuito o abbonamento Tempo di configurazione o costo del servizio
Controllo richiesto Minimo Minimo Da progettare (in-the-loop o on-the-loop)

Quando ha ancora senso usare Google Alerts

Non tutto merita un agente. Per un uso personale, per un tema poco competitivo, per un primo filtro gratuito su un argomento che non è ancora una priorità, Google Alerts resta uno strumento onesto: costa zero, si imposta in due minuti e, come rete a maglie larghe, qualcosa la intercetta comunque. Il problema nasce quando lo si usa come unico strumento per la reputazione di un brand, per la sicurezza di un’azienda o per capire in tempo reale una crisi in corso: lì il divario con motori AI e agenti diventa evidente, come racconto anche nella guida su come gestire la reputazione online, dove il monitoraggio è solo il primo passo di un processo più ampio.

Come costruire oggi un sistema di monitoraggio ibrido

  • Definire cosa conta davvero. Nome del brand, prodotti, dirigenti, hashtag, concorrenti diretti: non tutto merita lo stesso livello di attenzione.
  • Tenere Google Alerts come rete di base gratuita. Non va abbandonato, va ridimensionato al ruolo che può davvero sostenere.
  • Affiancare un motore AI per le domande puntuali. Utile quando serve una risposta rapida su un tema specifico, non una sorveglianza continua.
  • Costruire o adottare un agente per le fonti scoperte. Social, forum e community restano il punto debole di Alerts e il punto di forza di un agente ben configurato.
  • Scegliere il livello di supervisione giusto. Sintesi giornaliera in modalità on-the-loop, approvazione umana obbligatoria per ogni azione pubblica o sensibile.
  • Misurare che cosa si sarebbe perso. Confrontare periodicamente i risultati di Alerts con quelli dell’agente aiuta a capire quanto valore reale aggiunge il cambio di strumento.

Domande frequenti

Google Alerts è ormai inutile?

No, ma da solo non basta più per chi ha bisogno di rapidità, copertura ampia o sintesi. Resta valido come rete gratuita di base per temi a bassa priorità.

Gli agenti AI sostituiscono completamente Google Alerts?

Possono coprire molti dei suoi limiti, ma vanno progettati con attenzione: senza soglie, log e supervisione rischiano di generare falsi allarmi o azioni indesiderate.

Serve saper programmare per costruire un agente di monitoraggio?

Non sempre: esistono strumenti e piattaforme che permettono di collegare fonti, regole di sintesi e notifiche senza scrivere codice, anche se una configurazione più su misura richiede competenze tecniche.

Google Alerts copre bene i social network?

No, è uno dei suoi limiti più noti: social, forum e gruppi privati vengono intercettati in modo parziale e spesso in ritardo rispetto a siti di informazione indicizzati.

Qual è il rischio principale nel delegare il monitoraggio a un agente?

Perdere il controllo su ciò che l’agente fa in autonomia. Per questo conviene distinguere sempre tra un ruolo di supervisione (on-the-loop) e uno di approvazione obbligatoria (in-the-loop) per le azioni più delicate.

La domanda giusta non è più “Alerts sì o no”

Google Alerts non è morto, ma nel 2026 ha smesso di essere sufficiente da solo. Ha ancora senso quando serve un primo filtro gratuito su un tema semplice; ne ha molto meno quando in gioco ci sono la reputazione di un brand, la velocità di reazione o la comprensione di come l’intelligenza artificiale parla di noi. La domanda giusta non è più se usare Alerts, ma quale combinazione di motori AI, agenti e supervisione umana meriti la nostra attenzione, che resta la risorsa più limitata di tutte.

Per mesi abbiamo usato NotebookLM soprattutto così: carichiamo un PDF, chiediamo un riassunto e ci sentiamo già molto produttivi.

È utile, certo. Ma è anche un modo piuttosto limitato di usare lo strumento.

Il vero salto avviene quando non gli affidiamo una sola fonte, ma materiali diversi: un documento e una fotografia, un contratto e una planimetria, una presentazione e i relativi grafici, un report tecnico e le immagini scattate durante un sopralluogo.

A quel punto l’intelligenza artificiale non deve semplicemente riassumere. Deve incrociare le fonti, individuare corrispondenze, segnalare differenze e costruire una lettura unitaria.

Dal 16 luglio 2026, tra l’altro, NotebookLM ha ufficialmente cambiato nome ed è diventato Gemini Notebook. Google lo presenta come lo stesso prodotto autonomo, ma maggiormente integrato nell’ecosistema Gemini e nei servizi dell’azienda (fonte: blog.google).

Che cosa può leggere Gemini Notebook?

Gemini Notebook è un assistente di ricerca basato sulle fonti selezionate dall’utente. Può lavorare su testi, grafici, immagini e audio, restituendo risposte corredate da citazioni che permettono di risalire ai materiali utilizzati (fonte: Google Aiuto).

Tra i formati supportati troviamo:

  • PDF, Word, PowerPoint, CSV, Markdown ed ePub;
  • Google Docs, Presentazioni e Fogli;
  • file audio;
  • pagine Web;
  • video pubblici di YouTube con trascrizione;
  • immagini in formati come JPG, PNG, WebP, TIFF e HEIC (fonte: Google Aiuto).

Una precisazione importante: quando inseriamo l’indirizzo di una pagina Web, Gemini Notebook acquisisce principalmente il testo HTML. Le immagini presenti nella pagina non vengono automaticamente importate come fonti visuali. Per analizzarle conviene scaricarle, quando ne abbiamo il diritto, e caricarle separatamente.

Ecco dieci incroci che possono trasformare Gemini Notebook da riassuntore di PDF a vero assistente documentale.

1. Manuali tecnici e schemi

Immaginiamo di avere il manuale di una macchina industriale e alcune immagini con lo schema dei componenti.

Gemini Notebook può collegare le istruzioni scritte agli elementi rappresentati nel disegno, aiutandoci a capire:

  • quale componente viene citato in un determinato passaggio;
  • dove si trova fisicamente;
  • quale sequenza operativa seguire;
  • se lo schema appare coerente con le istruzioni;
  • quali avvertenze riguardano quella specifica parte.

È particolarmente utile quando un manuale usa sigle come “modulo A7” o “valvola V12”, mentre lo schema mostra decine di elementi quasi identici.

Prompt di esempio

Analizza il manuale tecnico e lo schema allegato. Individua nello schema tutti i componenti citati nella procedura di manutenzione descritta alle pagine 20-25. Crea una sequenza passo-passo. Per ogni passaggio indica il componente, la fonte, la pagina e gli eventuali dubbi. Non inventare collegamenti non verificabili.

Non sostituisce il tecnico qualificato, ma può ridurre parecchio il tempo perso a saltare continuamente dal testo al disegno.

2. Contratti e planimetrie

Un contratto di locazione, un capitolato o un regolamento possono contenere riferimenti a stanze, aree comuni, confini, pertinenze e destinazioni d’uso.

La planimetria mostra gli spazi. Il contratto stabilisce gli obblighi.

Incrociando le due fonti possiamo chiedere a Gemini Notebook di:

  • associare le clausole alle aree rappresentate;
  • distinguere spazi privati e comuni;
  • trovare obblighi di manutenzione collegati a locali specifici;
  • evidenziare zone presenti nella planimetria ma non citate nel contratto;
  • segnalare descrizioni potenzialmente ambigue.

Prompt di esempio

Confronta il contratto con la planimetria. Crea una tabella con: area, clausole collegate, obblighi del locatore, obblighi del conduttore, eventuali incongruenze e informazioni mancanti. Se una corrispondenza è soltanto probabile, dichiaralo esplicitamente.

Il risultato è una mappa di orientamento, non un parere legale. Le interpretazioni contrattuali devono essere verificate da un professionista.

3. Fatture e fotografie dei prodotti

Una fattura sostiene che sono stati consegnati dieci prodotti di un certo modello. Le fotografie mostrano ciò che è realmente arrivato.

Gemini Notebook può aiutare a confrontare:

  • descrizione e aspetto del prodotto;
  • modello, colore e confezione;
  • quantità documentata e quantità visibile;
  • accessori dichiarati;
  • eventuali codici o numeri di serie leggibili;
  • differenze tra quanto fatturato e quanto fotografato.

Prompt di esempio

Confronta le righe della fattura con i prodotti visibili nelle fotografie. Per ogni riga indica se esiste una corrispondenza visiva, quali elementi la supportano e quali non possono essere verificati. Non considerare l’aspetto esteriore una prova definitiva di autenticità.

È un ottimo primo controllo. Non è invece uno strumento forense per certificare l’originalità di un prodotto.

4. Report di sopralluogo e fotografie del cantiere

Questo è uno dei casi più interessanti per tecnici, aziende edili, amministratori di condominio e responsabili della sicurezza.

Carichiamo:

  1. il report del sopralluogo;
  2. le fotografie del cantiere;
  3. eventualmente il capitolato o il cronoprogramma.

Gemini Notebook può costruire una matrice con:

  • problema segnalato;
  • immagine associata;
  • posizione;
  • livello di urgenza indicato nel report;
  • intervento previsto;
  • prove mancanti;
  • possibili contraddizioni tra testo e fotografie.

Prompt di esempio

Associa ogni criticità citata nel report alle fotografie pertinenti. Crea una tabella con descrizione, posizione, fotografia, intervento richiesto, priorità dichiarata e informazioni da verificare. Non stimare autonomamente la sicurezza strutturale.

Sul mio sito ho già raccolto diversi esempi di utilizzo dell’intelligenza artificiale nei cantieri, tra capitolati, progetti e controlli documentali.

5. Curriculum e certificati

Il curriculum racconta le competenze. I certificati dovrebbero documentarne almeno alcune.

Gemini Notebook può confrontare le due fonti per individuare:

  • certificazioni citate nel CV ma non documentate;
  • date di rilascio e scadenza;
  • enti certificatori;
  • corsi apparentemente duplicati;
  • competenze dichiarate senza evidenze allegate;
  • attestati non menzionati nel curriculum.

Prompt di esempio

Confronta il curriculum con gli attestati allegati. Non esprimere giudizi sulla persona. Elenca soltanto le competenze documentate, quelle dichiarate ma non documentate, le date di validità e gli elementi che richiedono verifica umana.

Questo utilizzo richiede particolare attenzione a privacy, minimizzazione dei dati e possibili discriminazioni. Non si dovrebbe chiedere all’AI di stabilire chi “merita” un lavoro partendo da una fotografia o da caratteristiche personali.

6. Presentazioni e grafici

Una slide può affermare che “le vendite sono esplose”. Il grafico potrebbe raccontare una storia un po’ meno entusiasmante.

Incrociando testo e visualizzazioni possiamo verificare:

  • se il titolo della slide riflette davvero i dati;
  • se gli assi partono da zero;
  • se vengono confrontati periodi equivalenti;
  • se le percentuali hanno una base chiara;
  • se mancano fonti;
  • se alcuni dati importanti sono stati esclusi dalla narrazione.

Prompt di esempio

Analizza le affermazioni contenute nella presentazione e confrontale con i grafici. Per ogni affermazione indica: dato che la supporta, fonte, eventuali limiti, possibili interpretazioni alternative e informazioni mancanti.

Gemini Notebook può anche trasformare le fonti in presentazioni, report e altri artefatti. Google precisa però che i contenuti generati possono includere inesattezze visive o fattuali (fonte: blog.google).

7. Regolamenti e infografiche

Molte organizzazioni trasformano regolamenti complessi in infografiche da distribuire a dipendenti, cittadini o clienti.

L’infografica deve essere semplice. Il rischio è che diventi troppo semplice.

Gemini Notebook può confrontare il documento originale con la sintesi grafica per trovare:

  • eccezioni eliminate;
  • scadenze errate;
  • obblighi presentati come facoltativi;
  • indicazioni prive di contesto;
  • semplificazioni potenzialmente fuorvianti.

Prompt di esempio

Verifica se l’infografica rappresenta correttamente il regolamento. Individua omissioni, semplificazioni e affermazioni che potrebbero generare equivoci. Cita per ogni osservazione il punto preciso del regolamento.

È un uso molto concreto per Pubbliche Amministrazioni, associazioni, scuole e uffici delle risorse umane.

8. Ricerche di mercato e immagini dei prodotti

Una ricerca di mercato parla di posizionamento, target, prezzo, differenziazione e comportamento dei concorrenti.

Le immagini dei prodotti mostrano come quei concetti si traducono nella realtà.

Possiamo chiedere a Gemini Notebook di confrontare:

  • promessa del marchio e confezione;
  • target dichiarato e linguaggio visuale;
  • posizionamento premium e qualità percepita;
  • claim presenti sul prodotto;
  • colori, simboli e informazioni in evidenza;
  • differenze tra concorrenti.

Prompt di esempio

Incrocia le conclusioni della ricerca di mercato con le immagini dei prodotti. Analizza soltanto elementi visibili e informazioni presenti nelle fonti. Distingui chiaramente tra osservazioni oggettive e interpretazioni di marketing.

Questo può diventare il punto di partenza per un’analisi del packaging, una presentazione commerciale o un workshop sul posizionamento.

9. Casi clinici e immagini mediche

È l’esempio che richiede più prudenza.

Gemini Notebook può essere usato per organizzare materiali clinici, confrontare un referto con la documentazione allegata, estrarre domande da rivolgere allo specialista o individuare differenze terminologiche tra più documenti.

Non dovrebbe invece essere usato per formulare diagnosi autonome o decidere terapie.

Un prompt prudente potrebbe essere:

Organizza le informazioni presenti nel caso clinico e nei referti. Non formulare diagnosi e non interpretare autonomamente le immagini mediche. Evidenzia eventuali differenze tra i documenti, termini da chiarire e domande da sottoporre allo specialista.

Google stessa ricorda che Gemini Notebook può commettere errori e invita a consultare professionisti qualificati per questioni mediche, legali o finanziarie (fonte: Google Aiuto).

10. Articoli di giornale e fotografie

Un articolo descrive un evento. Le fotografie ne mostrano soltanto una porzione, scelta da chi ha scattato o selezionato l’immagine.

Incrociare le due fonti può servire per:

  • verificare se la didascalia corrisponde a ciò che è visibile;
  • ricostruire la sequenza temporale;
  • distinguere fatti riportati e interpretazioni;
  • individuare oggetti, cartelli e luoghi citati nel testo;
  • confrontare versioni diverse dello stesso evento;
  • segnalare elementi presenti nella foto ma ignorati dall’articolo.

Prompt di esempio

Confronta il contenuto dell’articolo con le fotografie. Elenca soltanto gli elementi direttamente verificabili. Non identificare persone basandoti esclusivamente sul volto e non dedurre intenzioni o responsabilità dalle immagini.

È un esercizio molto utile anche in un corso di educazione ai media: l’immagine sembra una prova oggettiva, ma anch’essa è una selezione della realtà.

Il prompt universale per incrociare documenti e immagini

Per ottenere risultati utili non basta scrivere: “Analizza questi file”.

Meglio fornire un metodo.

Agisci come analista documentale.
Esamina tutte le fonti selezionate, comprese immagini, documenti, tabelle e grafici.
Obiettivo: [descrivi il risultato che ti serve].
Per ogni osservazione:

  1. indica la fonte;
  2. cita la pagina, la sezione o l’immagine;
  3. separa i fatti dalle interpretazioni;
  4. segnala informazioni mancanti o illeggibili;
  5. non inventare corrispondenze;
  6. usa la dicitura “non verificabile” quando le fonti non sono sufficienti.

Presenta il risultato in una tabella con le colonne: elemento, fonte testuale, fonte visuale, corrispondenza, anomalia, livello di certezza e verifica umana richiesta.

Il passaggio decisivo è l’ultimo: obbligare l’AI a dichiarare ciò che non sa.

Tre limiti da non dimenticare

La qualità delle immagini conta

Una fotografia sfocata, tagliata o scattata da un’angolazione sbagliata produce inevitabilmente un’analisi più debole. Lo stesso vale per scansioni storte, tabelle minuscole e schemi privi di legenda.

Le citazioni aiutano, ma non certificano la verità

Gemini Notebook usa citazioni testuali e visuali per mostrare da dove proviene una risposta. Questo rende il controllo più semplice, ma non trasforma automaticamente ogni interpretazione in un fatto corretto (fonte: Google Aiuto).

I dati sensibili non vanno caricati con leggerezza

Prima di inserire contratti, documenti sanitari, dati personali o informazioni aziendali riservate, bisogna verificare il tipo di account, le condizioni applicabili e le regole della propria organizzazione.

Google dichiara che i dati non vengono usati per addestrare Gemini Notebook, salvo l’invio di feedback. Per gli account Workspace ed Education qualificati, caricamenti, richieste e risposte non vengono utilizzati per addestrare i modelli e non sono sottoposti a revisione umana (fonte: Google Aiuto).

Il punto non è “leggere una foto”

La funzione più interessante non consiste nel descrivere un’immagine.

Quello può farlo ormai qualsiasi chatbot multimodale.

Il vero valore sta nel collegare l’immagine a un insieme controllato di documenti e nel chiedere all’AI di lavorare all’interno di quel perimetro.

Non più:

Che cosa vedi in questa fotografia?

Ma:

Che relazione c’è tra questa fotografia, il contratto, il report e la fattura che ti ho fornito?

È qui che Gemini Notebook diventa realmente utile nel lavoro quotidiano: quando passa dalla generica produzione di risposte all’analisi di fonti che abbiamo scelto noi.

Per approfondire lo strumento puoi consultare il mio corso Gemini Notebook per aziende e professionisti e il confronto tra Gemini e NotebookLM, utile per capire quale ambiente usare nei diversi scenari professionali.

Domande frequenti su Gemini Notebook e le immagini

Gemini Notebook può leggere direttamente le immagini?

Sì. Le immagini possono essere caricate come fonti autonome e utilizzate insieme agli altri materiali del notebook. Sono supportati diversi formati, tra cui JPG, PNG, WebP, TIFF e HEIC.

Può analizzare le immagini contenute in un PDF?

Google ha introdotto la capacità di rispondere a domande su immagini, diagrammi e grafici presenti nelle fonti. Il risultato dipende comunque dalla qualità e dalla leggibilità del documento (fonte: blog.google).

Incollando un sito vengono analizzate anche le fotografie?

No, non automaticamente. Per le pagine Web viene importato principalmente il contenuto testuale. Le immagini devono essere aggiunte separatamente.

Gemini Notebook può citare anche un’immagine?

Sì. Le risposte possono utilizzare testo e immagini provenienti dalle fonti come citazioni, consentendo all’utente di tornare al contenuto originale.

Può sostituire un medico, un avvocato o un tecnico?

No. Può organizzare, confrontare e sintetizzare le fonti, ma le decisioni professionali e le interpretazioni ad alto rischio richiedono una verifica qualificata.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un email

Aggiornato al 18 luglio 2026. Un video TikTok di un minuto presenta cinque skill per Claude che promettono di migliorare scrittura, memoria, progettazione di interfacce, osservazione dei task e ricerca di altre skill. Le ho verificate una per una: sono progetti reali, ma non sono componenti ufficiali di Anthropic e non vanno installati come se fossero semplici prompt. Una skill può contenere istruzioni, script e accessi a strumenti: in pratica è codice operativo che entra nel flusso di lavoro dell’agente.

Il video di @ozzibig, intitolato “5 skill di Claude che il 99% delle persone non conosce”, cita Stop Slop, Claude Mem, UI UX Pro Max, Task Observer e Find Skill. L’elenco è interessante perché mostra cinque direzioni in cui si stanno evolvendo gli assistenti agentici. Il punto, però, non è collezionare estensioni: è capire che cosa fanno davvero, quali dati toccano e quanto ci si può fidare.

Che cosa sono le skill per Claude?

Le Agent Skills sono cartelle organizzate che forniscono a un agente istruzioni, risorse e, in alcuni casi, script eseguibili per svolgere un compito specializzato. Anthropic le descrive come moduli caricabili in modo progressivo: l’agente legge prima una descrizione sintetica e approfondisce la skill quando diventa pertinente. La documentazione ufficiale è disponibile nel manuale di Claude, nell’articolo tecnico “Equipping agents for the real world with Agent Skills” e nel repository pubblico di Anthropic.

Il formato non riguarda soltanto Claude. La specifica aperta Agent Skills punta alla portabilità tra strumenti diversi. È un passaggio importante: non stiamo più parlando di una frase salvata nel cassetto dei prompt, ma di un piccolo pacchetto di competenze riusabile da un agente.

Una distinzione evita molti equivoci:

  • prompt: dice al modello come rispondere in una determinata situazione;
  • skill: organizza istruzioni, file di supporto e talvolta automazioni o comandi;
  • connettore o tool: consente all’agente di leggere o modificare sistemi esterni;
  • agente: decide quali passaggi eseguire e può combinare più skill e strumenti.

Più si scende nell’elenco, più aumenta la capacità di agire. E con la capacità aumenta anche la superficie di rischio.

Le cinque skill del video, a colpo d’occhio

Skill Che cosa fa A chi può servire Dato o permesso delicato Rischio da valutare
Stop Slop Individua e riduce formule stereotipate della prosa generata dall’AI Autori, marketer, formatori, redazioni Testi e documenti sottoposti alla revisione Uniformare troppo la voce o confondere stile con veridicità
Claude Mem Conserva e recupera memoria tra sessioni Sviluppatori e team su progetti lunghi Contesto, attività e cronologia delle sessioni Privacy, retention e contaminazione tra progetti
UI UX Pro Max Propone stili, palette, font e regole per interfacce Designer, sviluppatori front-end, prototipatori Codice del progetto e requisiti di prodotto Design plausibile ma non testato con utenti o tecnologie assistive
Task Observer Osserva correzioni e lacune, poi propone miglioramenti alle skill Utenti avanzati che mantengono molte automazioni Log, errori, feedback e comportamenti ripetuti Trasformare un errore occasionale in una regola permanente
Find Skill Cerca skill in più cataloghi e può facilitarne l’installazione Chi esplora l’ecosistema di agenti Accesso a fonti esterne e installazione di pacchetti Supply chain: trovare più velocemente anche componenti insicuri

1. Stop Slop: ripulire la scrittura AI senza fingere che diventi “umana”

Stop Slop è una skill con licenza MIT che cerca segnali ricorrenti della scrittura artificiale: aperture generiche, contrasti costruiti in serie, enfasi eccessiva, conclusioni gonfie e frasi che sembrano autorevoli senza aggiungere informazione.

Immaginiamo una responsabile marketing che debba rivedere quindici schede prodotto. La skill può segnalare espressioni come “nel panorama in continua evoluzione” o una sequenza di paragrafi tutti costruiti nello stesso modo. La persona decide che cosa tagliare, verifica i dati e reinserisce esempi reali. Qui la skill funziona bene come editor di primo livello, non come certificatore di autenticità.

Altri casi concreti:

  • un consulente confronta una proposta commerciale con le proprie linee editoriali;
  • un insegnante fa individuare agli studenti le formule vaghe in una relazione;
  • una redazione usa il controllo prima della revisione umana, senza affidargli la decisione finale;
  • un ufficio HR elimina il linguaggio magniloquente da un annuncio di lavoro.

Il limite è semplice: un testo meno stereotipato non diventa automaticamente corretto, originale o scritto da una persona. Stop Slop non sostituisce fact-checking, competenza editoriale e controllo delle fonti. E usarlo per “battere i detector” sarebbe una promessa impropria: i detector di testo AI sono notoriamente fallibili e lo stile non prova l’origine di un contenuto.

2. Claude Mem: una memoria utile, quindi anche delicata

Claude Mem, distribuito con licenza Apache 2.0, aggiunge memoria persistente alle sessioni di lavoro. Registra osservazioni, le comprime e permette di recuperare il contesto rilevante in un secondo momento. L’obiettivo è evitare la scena che conoscono tutti: riaprire un progetto e dover spiegare da capo architettura, decisioni e problemi già risolti.

Per uno sviluppatore può significare ricordare che l’applicazione usa un certo schema dati, che una libreria è stata scartata per incompatibilità e che una determinata cartella non va modificata. Per un team di comunicazione potrebbe voler dire conservare terminologia approvata, pubblico, vincoli legali e decisioni prese durante le revisioni.

La memoria, però, è utile proprio perché trattiene informazioni. Prima di adottarla occorre chiedersi:

  • dove vengono archiviati i dati e per quanto tempo;
  • quali conversazioni, file e comandi vengono catturati;
  • come si cancellano o esportano i ricordi;
  • se progetti e clienti diversi restano davvero separati;
  • che cosa succede a credenziali, dati personali e segreti comparsi per errore.

La ricerca sui Generative Agents ha mostrato quanto memoria, riflessione e pianificazione possano rendere più coerente il comportamento di un agente. In un contesto aziendale, però, coerenza non significa automaticamente conformità: servono minimizzazione dei dati, separazione degli ambienti e una politica di conservazione.

Se ti interessa il tema della memoria personale e professionale, ho approfondito un approccio diverso nell’articolo su come creare un second brain con LLM, wiki e Obsidian.

3. UI UX Pro Max: molte opzioni non equivalgono a buon design

UI UX Pro Max è un progetto MIT che raccoglie conoscenza strutturata per progettare interfacce. Al momento della verifica il repository dichiara 84 stili, 161 regole di reasoning, 192 categorie di prodotto e palette, 34 modelli di landing page e 74 coppie tipografiche. Sono numeri dichiarati dal maintainer e descrivono il contenuto del progetto, non una valutazione indipendente della qualità dei risultati.

In pratica può aiutare una piccola impresa a trasformare un brief vago — “vorrei un sito moderno” — in decisioni più concrete: gerarchia, palette, tipografia, componenti, spaziature e stati di interazione. Un prototipatore può chiederle una dashboard per un amministratore di condominio; uno sviluppatore può usarla per controllare coerenza e responsive design; una startup può generare tre direzioni visive prima del confronto con il designer.

Il rischio è produrre un’interfaccia molto credibile in una schermata e poco usabile nella realtà. La skill non conosce automaticamente gli utenti, il loro contesto, le metriche di conversione o le esigenze di chi utilizza uno screen reader. Deve quindi entrare in un processo che includa test, analytics e Web Content Accessibility Guidelines.

Un esempio: il sistema propone testo grigio chiaro, animazioni e menu nascosti perché coerenti con uno stile minimal. Il designer verifica contrasto, navigazione da tastiera e comprensione dei comandi. La skill accelera l’esplorazione; la responsabilità sul prodotto resta umana.

4. Task Observer: l’agente che osserva come migliorare l’agente

Nel repository One Skill to Rule Them All la skill si chiama task-observer. Osserva correzioni, errori e schemi ricorrenti, poi formula raccomandazioni per creare o aggiornare altre skill. Un dettaglio importante: secondo la documentazione non modifica direttamente le skill, ma propone cambiamenti che devono essere approvati.

Può essere utile quando un team ripete ogni settimana la stessa correzione. Per esempio:

  • un report usa sempre il formato di data sbagliato;
  • le bozze citano una fonte secondaria quando è disponibile il paper originale;
  • un agente dimentica il controllo degli accenti prima di pubblicare in italiano;
  • un flusso di sviluppo esegue test generici ma trascura un caso limite ricorrente.

La skill può trasformare il feedback in una proposta stabile: “aggiungiamo questo controllo alla procedura”. È una forma di miglioramento operativo interessante, ma va governata. Una correzione fatta per un cliente non deve diventare una regola universale; un’eccezione non deve contaminare tutti i progetti; i log non devono raccogliere più dati del necessario.

Il README dichiara oltre 900 miglioramenti su 50 skill in sei mesi. È un dato del maintainer, non il risultato di uno studio indipendente: utile per capire il caso d’uso, non per misurare l’efficacia generale.

5. Find Skill: il motore di ricerca che rende decisiva la sicurezza

Find Skill cerca skill in più fonti e dichiara un indice di oltre 4.800 risorse provenienti da 14 cataloghi, con supporto per Claude Code, Codex, OpenCode e Cursor. Anche questi numeri descrivono lo stato dichiarato dal progetto alla data della verifica e possono cambiare.

Il vantaggio è evidente. Un analista può cercare una procedura per lavorare con fogli di calcolo; un formatore una skill per costruire una presentazione; uno sviluppatore un controllo di sicurezza. Invece di partire da zero, riusa una soluzione esistente.

Ma il discovery non è una certificazione. Se una skill può essere installata con pochi comandi, diminuisce anche l’attrito che normalmente ci spinge a ispezionarla. È lo stesso problema della supply chain software: un componente di terze parti può contenere dipendenze vulnerabili, istruzioni malevole o accessi eccessivi. Il catalogo skills.sh e il relativo progetto open source di Vercel Labs sono altre risorse utili per la scoperta, ma anche in quel caso ogni pacchetto va valutato singolarmente.

Una skill non è un prompt innocuo: quali rischi introduce?

Un agente può leggere documenti, eseguire script, usare la rete e modificare file. Una skill male progettata può quindi amplificare un errore o una manipolazione. L’OWASP Top 10 per applicazioni LLM richiama rischi come prompt injection, gestione insicura degli output, eccessiva autonomia e vulnerabilità della supply chain.

Il paper “More than you’ve asked for: A Comprehensive Analysis of Novel Prompt Injection Threats to Application-Integrated Large Language Models” mostra il problema delle indirect prompt injection: istruzioni ostili possono nascondersi nei contenuti che il modello legge, non soltanto nel prompt scritto dall’utente. Un agente che consulta pagine web o documenti può quindi incontrare testo progettato per deviarne il comportamento.

Anche la qualità del codice generato richiede verifica. Gli studi “Asleep at the Keyboard?” e “Do Users Write More Insecure Code with AI Assistants?” non valutano queste cinque skill specifiche, ma documentano un principio più generale: l’assistenza AI può produrre o favorire codice insicuro, e la fiducia dell’utente non è una garanzia di correttezza.

I rischi principali sono cinque:

  1. permessi eccessivi: una skill di scrittura non dovrebbe avere accesso indiscriminato alla rete o a tutto il disco;
  2. esfiltrazione di dati: testi, log o credenziali potrebbero uscire dall’ambiente previsto;
  3. istruzioni nascoste: file o pagine consultati dall’agente possono tentare di modificarne il comportamento;
  4. dipendenze compromesse: il repository visibile può richiamare componenti esterni non controllati;
  5. automazione dell’errore: una procedura sbagliata diventa più veloce, coerente e difficile da notare.

Per questo il modello di supervisione conta. Nell’approfondimento su human-in-the-loop e human-on-the-loop negli agenti AI spiego quando chiedere un’approvazione prima dell’azione e quando è sufficiente monitorare un sistema reversibile entro soglie definite.

Come verificare una skill prima di installarla

Io adotterei questa procedura in sette passaggi. Non garantisce rischio zero, ma rende l’adozione tracciabile e molto meno impulsiva.

  1. Verifica identità e provenienza. Controlla autore, cronologia del repository, release, issue aperte, licenza e manutenzione recente. Il numero di stelle non è una certificazione.
  2. Leggi tutto il pacchetto. Non fermarti al README: esamina integralmente SKILL.md, script, dipendenze, hook e file di configurazione.
  3. Esegui una scansione statica. Un progetto dedicato è NVIDIA SkillSpector. Nel mio flusso una skill esterna non viene installata se la scansione non restituisce SAFE.
  4. Mappa permessi e dati. Scrivi quali cartelle può leggere, quali comandi esegue, se usa la rete, dove conserva i log e come tratta i segreti.
  5. Prova in isolamento. Usa un ambiente temporaneo, dati fittizi, credenziali senza privilegi e nessun accesso ai sistemi di produzione.
  6. Osserva il comportamento. Controlla file creati, richieste di rete, processi e output. Prova anche input anomali e documenti contenenti istruzioni ostili.
  7. Approva, limita e versiona. Installa una versione precisa, concedi il minimo indispensabile e prevedi aggiornamento, rollback e rimozione.

Nel caso di una skill di memoria aggiungerei un controllo su retention e separazione dei clienti. Per una skill che genera codice, test di sicurezza e code review. Per una skill di ricerca e installazione, l’approvazione umana prima di aggiungere qualsiasi nuovo pacchetto.

Quale delle cinque scegliere? Cinque scenari pratici

Scenario 1: libero professionista che scrive contenuti

Stop Slop può diventare l’ultimo controllo prima della revisione manuale. Non serve Claude Mem se si trattano clienti diversi senza una strategia chiara di separazione. La priorità è proteggere bozze, dati e tono personale.

Scenario 2: team software su un prodotto complesso

Claude Mem può ridurre la perdita di contesto e Task Observer può rilevare correzioni ricorrenti. Ma entrambi lavorano su informazioni sensibili: vanno testati su un repository non critico, con segreti esclusi e supervisione degli aggiornamenti proposti.

Scenario 3: agenzia che produce molti prototipi

UI UX Pro Max può accelerare moodboard, design system iniziali e alternative di landing page. Il passaggio successivo deve includere designer, verifica WCAG, test con utenti e dati reali. Non si pubblica soltanto perché la prima schermata “sembra fatta bene”.

Scenario 4: formatore che prepara materiali

Find Skill può scoprire pacchetti per documenti, fogli e slide. La procedura corretta è cercare, selezionare due candidati, leggerli e scansionarli; non installare automaticamente il primo risultato davanti a una classe o su un computer aziendale.

Scenario 5: impresa con processi regolati

Nessuna delle cinque skill dovrebbe entrare direttamente in produzione. Prima servono responsabile del processo, classificazione dei dati, ambiente di prova, log, soglie di autonomia e un piano di risposta agli incidenti. L’utilità potenziale non elimina gli obblighi organizzativi.

Tre video per vedere Claude al lavoro

Le skill acquistano senso quando vengono collegate a un’attività concreta. In questi miei video mostro come Claude passa dalla conversazione al lavoro su documenti e procedure:

Per approfondire puoi leggere anche i tre esempi d’uso di Claude Cowork, la guida su Claude Cowork e la compilazione dei moduli e la pagina del mio corso su Claude per aziende e professionisti.

La vera competenza non è accumulare skill

Il video intercetta una tendenza reale: gli assistenti stanno diventando ambienti componibili. Possiamo aggiungere memoria, procedure editoriali, capacità di progettazione e persino meccanismi che osservano come lavoriamo. È un salto utile, ma cambia anche il modo in cui dobbiamo valutare questi strumenti.

La domanda meno interessante è “quante skill hai installato?”. Quelle importanti sono: chi le ha scritte, che cosa possono fare, quali dati vedono, come vengono aggiornate e chi approva un’azione irreversibile.

Una buona skill riduce lavoro ripetitivo e rende esplicito un metodo. Una cattiva skill rende più efficiente un rischio. La differenza non la fa il nome accattivante del repository, ma la qualità della verifica prima dell’installazione e della supervisione durante l’uso.

Domande frequenti

Le cinque skill del video sono ufficiali di Anthropic?

No. Stop Slop, Claude Mem, UI UX Pro Max, Task Observer e Find Skill sono progetti di terze parti. Anthropic mantiene documentazione, specifiche e un proprio repository pubblico di skill, ma la presenza su GitHub non equivale a un’approvazione ufficiale.

Qual è la migliore skill per Claude?

Dipende dal problema. Stop Slop è orientata alla revisione stilistica, Claude Mem alla continuità tra sessioni, UI UX Pro Max al design, Task Observer al miglioramento delle procedure e Find Skill alla scoperta. La scelta deve considerare valore, dati trattati, permessi e reversibilità.

Una skill per Claude può essere pericolosa?

Sì. Se include script, usa la rete, legge file o installa altri pacchetti, può introdurre rischi di prompt injection, esfiltrazione, dipendenze compromesse o modifiche indesiderate. Va ispezionata e provata in isolamento prima dell’uso reale.

Che cos’è SkillSpector?

SkillSpector è uno strumento open source di NVIDIA per l’analisi statica delle skill degli agenti. Aiuta a individuare pattern sospetti prima dell’installazione, ma non sostituisce la lettura del codice, la limitazione dei permessi e i test in sandbox.

Claude Mem è adatto a documenti riservati?

Non va deciso in astratto. Prima occorre verificare archiviazione, retention, accessi, cancellazione, separazione dei progetti e policy aziendali. Per documenti riservati è prudente iniziare con dati fittizi e coinvolgere chi gestisce privacy e sicurezza.

Le skill sostituiscono la supervisione umana?

No. Rendono un agente più specializzato, ma non garantiscono correttezza. Per azioni ad alto impatto, dati sensibili o modifiche difficili da annullare è opportuno mantenere un’approvazione umana esplicita e log verificabili.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email

Un agente AI prepara una risposta a un cliente, aggiorna il CRM, modifica un file, apre una richiesta di rimborso e programma l’invio di un’email. A quale passaggio deve fermarsi e chiedere il permesso? E quando, invece, può continuare mentre una persona controlla dall’alto?

È qui che entra in gioco la differenza tra human-in-the-loop e human-on-the-loop, IN da una parte e ON dall’altra. Nel primo modello l’essere umano è un passaggio obbligatorio del processo: senza la sua approvazione l’azione non parte. Nel secondo l’agente lavora in autonomia entro limiti prestabiliti, mentre una persona osserva indicatori, controlla campioni e può intervenire o fermare il sistema. Non è una scelta ideologica tra controllo e libertà: dipende dal rischio, dalla reversibilità dell’azione e dalla capacità di accorgersi in tempo di un errore.

La distinzione è particolarmente importante nei sistemi agentici usati in azienda. Un chatbot propone parole; un agente può usare strumenti e produrre effetti nel mondo: inviare, acquistare, modificare, pubblicare, cancellare. Più l’AI passa dal “dire” al “fare”, più occorre progettare con precisione il ruolo umano.

Che cosa significa human-in-the-loop

Human-in-the-loop (HITL) significa che una persona è dentro il flusso operativo. L’agente può analizzare dati, formulare una proposta o preparare un’azione, ma incontra un punto di controllo obbligatorio. L’umano approva, corregge o respinge; soltanto dopo il sistema può proseguire.

È il modello adatto quando una decisione può produrre conseguenze economiche, legali, sanitarie, reputazionali o difficili da annullare. Non basta mostrare un pulsante “Approva”: la persona deve ricevere il contesto necessario, avere tempo sufficiente e poter davvero cambiare la decisione.

Un esempio semplice: l’agente legge un reclamo, consulta l’ordine e propone un rimborso di 280 euro. In modalità human-in-the-loop il responsabile vede motivazione, dati usati e importo, poi autorizza o modifica l’operazione. Il sistema non trasferisce denaro da solo.

Che cosa significa human-on-the-loop

Human-on-the-loop (HOTL) significa che una persona supervisiona il processo senza approvare ogni singola azione. L’agente opera entro un perimetro definito; dashboard, registri, avvisi e controlli a campione permettono al supervisore di capire che cosa sta succedendo e intervenire in caso di anomalia.

È adatto ad attività frequenti, a rischio contenuto, misurabili e facilmente reversibili. L’autonomia non elimina il controllo: lo sposta dalla singola operazione alla qualità complessiva del sistema.

Per esempio, un agente classifica ogni notte centinaia di documenti interni. Il responsabile non conferma ogni etichetta, ma controlla un campione, osserva il tasso di errore e riceve un avviso se cresce oltre la soglia. Le classificazioni restano tracciate e correggibili.

Human-in-the-loop vs human-on-the-loop: la differenza in tabella

Aspetto Human-in-the-loop Human-on-the-loop
Ruolo umano Approva o corregge prima dell’azione Supervisiona il sistema mentre opera
Flusso predefinito L’agente si ferma L’agente continua
Controllo Su ogni caso sensibile Su metriche, anomalie e campioni
Velocità Più bassa e legata alla disponibilità umana Più alta e scalabile
Uso tipico Decisioni ad alto impatto o poco reversibili Attività a basso rischio, osservabili e reversibili
Rischio principale Approvazioni frettolose e “fatica da conferma” Accorgersi troppo tardi di una deriva
Strumenti necessari Gate, spiegazioni, confronto e possibilità di rifiuto Log, soglie, alert, audit e arresto immediato

Attenzione: on-the-loop non significa out-of-the-loop

Esiste una terza condizione: human-out-of-the-loop. L’AI decide e agisce senza approvazione puntuale, senza supervisione operativa efficace o senza una reale possibilità di intervento. Non è un sinonimo di human-on-the-loop.

La differenza sembra sottile finché non arriva un incidente. Se il supervisore riceve un report il giorno dopo, quando l’agente ha già inviato mille comunicazioni sbagliate, non era davvero “sopra il circuito”: era fuori dal circuito.

Il tema è noto da molto prima dell’AI generativa. Nel paper “Ironies of automation” del 1983, Lisanne Bainbridge osservava un paradosso ancora attuale: più il sistema automatizza il lavoro ordinario, più alla persona restano i casi rari e difficili, proprio quelli per cui è complicato mantenere allenamento e consapevolezza. Mica Endsley ha poi analizzato il problema nel lavoro “From Here to Autonomy”, collegandolo alla perdita di consapevolezza situazionale quando l’essere umano viene allontanato troppo dal processo.

La matrice pratica: rischio, reversibilità, osservabilità e tempo

L’articolo di Bajara Notes da cui nasce questa riflessione propone un criterio molto concreto per i team di sviluppo: guardare il costo dell’errore e la reversibilità dell’azione. È una buona base, che possiamo estendere a qualsiasi progetto agentico con quattro domande.

  1. Quanto è grave un errore? Una bozza imperfetta non equivale a un bonifico errato.
  2. L’azione è reversibile? Rinominare un file con cronologia è diverso dal cancellare dati o inviare una comunicazione pubblica.
  3. L’errore è osservabile? Possiamo accorgercene con test, metriche o controlli automatici?
  4. Quanto tempo abbiamo per intervenire? Un alert utile dopo un’ora può essere inutile in un processo che produce danni in pochi secondi.
Rischio e reversibilità Modello consigliato Esempio
Basso rischio, facile annullamento Human-on-the-loop Ordinare documenti interni con cronologia delle modifiche
Rischio medio, errore rilevabile prima dell’impatto On-the-loop con soglie ed escalation Aggiornare campi non critici del CRM e isolare i casi incerti
Rischio alto o annullamento costoso Human-in-the-loop Concedere un rimborso, pubblicare un listino, inviare un contratto
Impatto critico o irreversibile Più controlli umani e separazione dei ruoli Pagamento, terapia, rilascio in produzione o decisione sul personale

Otto esempi concreti di human-in-the-loop

1. Email a clienti e comunicazioni pubbliche

L’agente raccoglie i dati, prepara il testo e suggerisce i destinatari. Una persona verifica tono, fatti, allegati e lista di invio. È un controllo necessario soprattutto per crisi, reclami, variazioni di prezzo e comunicazioni legali.

2. Rimborsi, pagamenti e ordini

L’AI può controllare policy e documenti, ma l’azione che muove denaro richiede autorizzazione. Si può introdurre una soglia: piccoli rimborsi standardizzati vengono gestiti automaticamente; quelli anomali o sopra un importo definito arrivano a un responsabile.

3. Selezione del personale

Un agente può riordinare candidature e mettere in evidenza competenze dichiarate. Non dovrebbe trasformare un punteggio opaco in un rifiuto automatico. Il recruiter deve poter vedere i dati usati, correggere il risultato e valutare elementi che il sistema non conosce.

4. Sanità e percorsi di cura

L’AI può segnalare una possibile anomalia o preparare un riepilogo clinico; diagnosi e terapia richiedono giudizio professionale. Nel mio approfondimento su AI e ruolo del medico il punto centrale è proprio questo: supporto e sostituzione non sono la stessa cosa.

5. Contratti e pareri legali

L’agente confronta clausole, segnala differenze e propone una bozza. Un professionista controlla interpretazione, giurisdizione e rischio prima che il documento venga condiviso o firmato.

6. Deploy e modifiche a database di produzione

L’agente può scrivere codice, test e documentazione in un ambiente isolato. Il passaggio in produzione, una migrazione di dati o la modifica di credenziali richiedono un gate umano, spesso con una seconda approvazione.

7. Decisioni su credito, assicurazioni e frodi

Il sistema può ordinare i casi per rischio. Se blocca un conto, rifiuta una pratica o modifica un premio, serve un riesame effettivo: non una firma automatica su un punteggio incomprensibile.

8. Pubblica amministrazione e servizi essenziali

Un agente può verificare la completezza di una domanda e preparare l’istruttoria. La decisione che incide su diritti, benefici o accesso a un servizio deve restare contestabile e attribuita a un responsabile. È un’applicazione concreta del tema affrontato nell’articolo sull’intelligenza artificiale nella Pubblica Amministrazione.

Otto esempi concreti di human-on-the-loop

1. Classificazione di documenti interni

L’agente assegna cartelle e metadati. Il supervisore controlla campioni settimanali e riceve un alert se aumenta la percentuale di documenti classificati con bassa confidenza.

2. Arricchimento del CRM in modalità reversibile

L’agente completa settore, dimensione e informazioni pubbliche sulle aziende, senza modificare campi critici. Ogni variazione è registrata e può essere annullata; i conflitti vengono inviati a una persona.

3. Preparazione di report ricorrenti

L’AI raccoglie dati da più fonti e genera una sintesi interna. Il responsabile non approva ogni report, ma controlla indicatori di qualità, citazioni e anomalie. Se il documento deve uscire dall’azienda, si aggiunge un gate.

4. Ricerca documentale con escalation

L’agente cerca informazioni, confronta fonti e produce una risposta con link verificabili. Se le fonti sono insufficienti o in conflitto, non improvvisa: chiede aiuto.

5. Sviluppo software in ambienti isolati

L’agente crea test, documentazione o componenti standard su un branch separato. La pipeline automatica controlla il codice e il team esamina le eccezioni. I permessi non includono il rilascio autonomo in produzione.

6. Assistenza clienti per domande standard

Il sistema risponde usando una base di conoscenza approvata, ma passa a un operatore reclami, minacce, richieste economiche, dati sensibili e casi con bassa confidenza. Il supervisore osserva tasso di escalation e correzioni.

7. Gestione di file e fogli di calcolo

Un agente riordina righe, normalizza formati e compila campi derivabili, lavorando su una copia o con cronologia attiva. La persona controlla il risultato complessivo e può ripristinare la versione precedente.

Nel blog trovi anche cinque esempi pratici dell’agente Genspark e una prova di Claude Cowork in tre attività concrete.

8. Monitoraggio tecnico e manutenzione

L’agente individua pattern insoliti, apre ticket e applica correzioni già approvate su sistemi non critici. Se supera una soglia di costo, tocca un servizio sensibile o incontra un evento mai visto, si ferma e chiama il tecnico.

Il modello migliore è spesso ibrido e dinamico

In-the-loop e on-the-loop non devono essere due etichette assegnate una volta per tutte. Lo stesso agente può cambiare modalità a seconda del caso.

  • Una risposta informativa standard può partire in modalità on-the-loop; un reclamo passa in-the-loop.
  • Un rimborso entro 20 euro e conforme alla policy può essere automatico; un importo maggiore richiede approvazione.
  • Una modifica su un ambiente di test può essere sorvegliata; il deploy in produzione richiede un gate.
  • Una ricerca con fonti concordanti può proseguire; fonti in conflitto attivano l’escalation.
  • Dopo una serie di anomalie, il sistema può retrocedere automaticamente da on-the-loop a in-the-loop.

Questa è la vera maturità agentica: non concedere autonomia in blocco, ma costruire una scala di autonomia legata a condizioni osservabili.

Che cosa dice la ricerca sull’interazione tra persone e automazione

Il paper di Parasuraman, Sheridan e Wickens “A model for types and levels of human interaction with automation” propone di non considerare l’automazione come un interruttore acceso o spento. Un sistema può automatizzare in misura diversa raccolta delle informazioni, analisi, scelta e azione. È esattamente ciò che serve per progettare un agente: possiamo lasciargli cercare e confrontare, ma mantenere umana la decisione finale.

Le “Guidelines for Human-AI Interaction” di Amershi e colleghi, presentate alla conferenza CHI 2019 dell’ACM, ricordano che un buon sistema deve rendere chiaro che cosa sa fare, mostrare informazioni contestuali, permettere correzioni e sostenere un controllo umano coerente nel tempo.

Ben Shneiderman, nel lavoro “Human-Centered Artificial Intelligence: Reliable, Safe & Trustworthy”, contesta l’idea che molta automazione implichi necessariamente poco controllo umano. Si possono progettare sistemi con alta automazione e alto controllo: l’agente svolge molto lavoro, ma le persone mantengono comprensione, responsabilità e capacità d’intervento.

Anche l’AI Risk Management Framework 1.0 del NIST insiste su governance, mappatura del contesto, misurazione e gestione del rischio. Non prescrive un unico livello di autonomia: chiede di collegare controlli e responsabilità all’impatto concreto del sistema.

AI Act e supervisione umana: che cosa cambia

Il Regolamento europeo sull’intelligenza artificiale, Regolamento (UE) 2024/1689, dedica l’articolo 14 alla supervisione umana dei sistemi ad alto rischio. È importante non generalizzare: la disposizione riguarda quella specifica categoria di sistemi, non qualunque chatbot o agente.

Il principio, però, è utile a ogni progetto serio. La supervisione deve consentire alle persone di comprendere capacità e limiti, riconoscere anomalie, evitare un affidamento automatico eccessivo, interpretare correttamente l’output, ignorarlo o annullarlo e fermare il sistema. Una casella da spuntare non soddisfa questo obiettivo se l’operatore non ha informazioni, autorità o tempo per agire.

Per approfondire il contesto organizzativo, rimando anche alla guida sulla formazione AI in azienda e AI Act e all’articolo sulle decisioni artificiali che possono aiutare o distorcere le scelte.

Come progettare una supervisione che funzioni davvero

  1. Definire le azioni consentite. Leggere, proporre, scrivere, inviare, acquistare e cancellare non devono avere gli stessi permessi.
  2. Stabilire i gate. Importi, categorie di dati, destinatari, strumenti e condizioni che richiedono approvazione.
  3. Mostrare il contesto. Il supervisore deve vedere fonti, passaggi, incertezze e conseguenze dell’azione.
  4. Costruire escalation reali. L’agente deve saper dire “non lo so” e passare il caso alla persona giusta.
  5. Registrare tutto. Prompt, strumenti usati, dati consultati, output, approvazioni, modifiche e identità di chi interviene.
  6. Preparare l’arresto. Un pulsante, una regola automatica o un limite di spesa devono fermare il processo prima che l’anomalia si moltiplichi.
  7. Testare anche i casi brutti. Dati mancanti, istruzioni in conflitto, prompt injection, servizi non disponibili e richieste fuori policy.
  8. Misurare gli esiti. Non soltanto quante attività sono state completate, ma errori, danni evitati, correzioni, escalation e tempo umano recuperato.

I due fallimenti opposti da evitare

Il primo è mettere una persona dentro ogni passaggio. Dopo cento conferme al giorno, l’approvazione diventa un riflesso. L’agente sembra controllato, ma l’essere umano fa soltanto clic. È la cosiddetta automation bias: tendiamo ad accettare il suggerimento della macchina, soprattutto quando arriva spesso e sembra plausibile.

Il secondo fallimento è mettere una persona “sopra” un processo che non può davvero vedere o fermare. Una dashboard piena di numeri non è supervisione se gli indicatori non mostrano il rischio, gli avvisi arrivano tardi o l’operatore non ha l’autorità per intervenire.

La domanda giusta non è quindi “c’è un umano?”. È: quale decisione può prendere, con quali informazioni e prima di quale conseguenza?

Una checklist per decidere domani mattina

Prima di attivare un agente, classifica ogni azione con queste domande:

  • può causare un danno economico, legale, fisico o reputazionale?
  • coinvolge dati personali, credenziali o categorie sensibili?
  • l’azione è visibile all’esterno?
  • possiamo annullarla in pochi minuti?
  • esiste una metrica capace di rivelare un errore?
  • il supervisore può intervenire prima che il danno si propaghi?
  • l’agente sa riconoscere l’incertezza ed effettuare un’escalation?
  • chi risponde del risultato è chiaramente identificato?

Se il danno potenziale è alto, l’azione poco reversibile o il tempo d’intervento breve, scegli human-in-the-loop. Se rischio e impatto sono contenuti, l’errore è osservabile e il ripristino semplice, puoi valutare human-on-the-loop. Se non puoi rispondere alle domande, non aumentare l’autonomia: prima rendi il processo comprensibile.

Il ruolo umano non sparisce: cambia livello

Con gli agenti AI l’umano non deve necessariamente controllare ogni riga, ogni file o ogni messaggio. Deve progettare il perimetro, definire le eccezioni, osservare gli effetti e assumersi la responsabilità delle decisioni importanti.

Il modello corretto non è “AI libera” contro “AI al guinzaglio”. È un sistema in cui l’autonomia cresce soltanto quando aumentano test, tracciabilità, reversibilità e capacità di intervento.

In altre parole: human-in-the-loop quando serve consenso; human-on-the-loop quando serve supervisione; mai human-out-of-the-loop per distrazione.

Domande frequenti

Qual è la differenza tra human-in-the-loop e human-on-the-loop?

Nel modello human-in-the-loop una persona deve approvare o correggere prima che l’agente compia un’azione sensibile. Nel modello human-on-the-loop l’agente opera entro limiti stabiliti, mentre una persona monitora risultati e anomalie e può intervenire.

Human-on-the-loop significa che l’AI lavora senza controllo?

No. Servono log, metriche, controlli a campione, alert, soglie ed efficaci meccanismi di arresto. Senza questi strumenti il sistema rischia di essere human-out-of-the-loop.

Quando è obbligatoria l’approvazione umana?

È prudente renderla obbligatoria per azioni ad alto impatto o difficili da annullare: pagamenti, decisioni sul personale, salute, contratti, sicurezza, servizi essenziali, pubblicazione esterna e modifiche critiche in produzione.

Si può cambiare livello di autonomia in base al caso?

Sì. È spesso la soluzione migliore: casi standard e reversibili procedono sotto supervisione; importi elevati, bassa confidenza, anomalie o dati sensibili attivano un gate umano.

Quali strumenti servono per supervisionare un agente AI?

Permessi minimi, audit log, dashboard, alert, soglie di costo e rischio, versionamento, rollback, escalation e un arresto immediato. Il supervisore deve anche ricevere contesto sufficiente per valutare le azioni.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email

Succede sempre più spesso: qualcuno mostra una demo in cui un agente AI legge le email, aggiorna il CRM, prepara una presentazione e prenota una riunione. A quel punto parte la domanda: “Possiamo averne uno anche noi?”.

La domanda giusta, però, è un’altra: in quale processo un agente AI crea più valore di una normale automazione? In azienda gli agenti AI servono quando il percorso non è completamente prevedibile, occorre interpretare informazioni, scegliere tra più strumenti e gestire eccezioni. Se i passaggi sono fissi e le regole sono chiare, un workflow tradizionale è spesso più economico, veloce e controllabile.

Questa distinzione è il punto di partenza dell’articolo di Digital4 “C’è un agent per tutto. Ma non tutto ha bisogno di un agent”. Un tema molto attuale: oggi costruire una demo è relativamente facile; trasformarla in uno strumento affidabile è tutto un altro lavoro.

Che cos’è un agente AI, in parole semplici

Un agente AI è un sistema capace di perseguire un obiettivo, osservare ciò che succede, decidere il passo successivo e utilizzare strumenti: per esempio un motore di ricerca, un database, la posta elettronica, un foglio Excel o un gestionale.

La differenza rispetto a un chatbot non è che “scrive meglio”. La differenza è che può agire. E la differenza rispetto a un workflow è che non deve per forza seguire sempre la stessa strada.

Anthropic distingue chiaramente workflow e agenti: nei primi, modelli e strumenti vengono orchestrati attraverso percorsi definiti in anticipo; nei secondi, è il modello a decidere dinamicamente come procedere. Anche la guida pratica di OpenAI alla costruzione degli agenti suggerisce di partire da processi in cui regole rigide e automazioni deterministiche non bastano.

Workflow, assistente o agente? La scelta pratica

Non tutti i problemi aziendali richiedono lo stesso grado di autonomia. Prima di aggiungere la parola “agentico” a una presentazione, conviene usare questa matrice.

Il principio è semplice: usare il livello minimo di autonomia necessario. Più autonomia significa più flessibilità, ma anche più costi, più variabilità e più controlli.

Il test delle cinque domande prima di creare un agente AI

Nei corsi e nei progetti aziendali partirei da cinque domande molto concrete.

  1. Il processo cambia spesso percorso? Se la risposta è no, probabilmente basta un’automazione.
  2. Occorre interpretare informazioni non strutturate? Email, documenti, note e richieste ambigue sono un terreno più adatto agli agenti.
  3. L’agente deve usare più strumenti? Per esempio cercare un dato nel CRM, confrontarlo con un contratto e preparare una risposta.
  4. Possiamo verificare il risultato? Se non esiste un modo per sapere se il lavoro è corretto, non esiste nemmeno un buon progetto.
  5. Un errore è reversibile? Cancellare una bozza non equivale a inviare un bonifico o pubblicare un listino sbagliato.

Se il processo non supera questo test, aggiungere un agente rischia di automatizzare non il lavoro, ma la confusione.

Tre casi in cui un agente AI può avere senso

1. Gestire richieste con molte eccezioni

Immaginiamo un servizio clienti che riceve richieste via email. Un workflow può riconoscere alcune parole e assegnare un’etichetta. Un agente, invece, può leggere la conversazione, consultare la scheda cliente, verificare la policy, cercare un ordine e preparare una risposta o chiedere l’intervento di una persona.

Il valore non sta nel testo prodotto, ma nei passaggi manuali eliminati. Naturalmente l’agente deve avere fonti definite, permessi limitati e regole chiare per l’escalation.

2. Raccogliere dati da strumenti diversi

Molte attività aziendali consistono nel fare il giro delle sette chiese digitali: CRM, gestionale, email, fogli, cartelle condivise e piattaforme analytics. Un agente può cercare le informazioni, controllarne la completezza e restituire una sintesi utilizzabile.

Un esempio concreto è il lavoro sui fogli di calcolo. In questo video mostro un agente Genspark che interviene su un file Excel:

Per approfondire, sul blog trovi anche cinque esempi pratici di utilizzo dell’agente Genspark.

3. Preparare un lavoro che una persona deve approvare

L’agente può cercare fonti, confrontare documenti, compilare una bozza e segnalare le anomalie. La persona prende la decisione finale. È un modello molto più realistico del fantomatico collega digitale che sa tutto e non chiede mai aiuto.

Il punto non è sostituire il giudizio, ma recuperare tempo sulle attività preparatorie. Nel video seguente racconto dieci esempi con cui ho misurato un risparmio complessivo di dieci ore in una settimana:

Qui trovi anche l’articolo completo su come recuperare dieci ore alla settimana con l’AI.

Il lavoro difficile non è scrivere il prompt

Con un agente il prompt conta, ma non basta. Bisogna progettare il contesto: quali dati può vedere, quali fonti deve considerare autorevoli, che cosa deve ricordare, quali strumenti può utilizzare e quando deve fermarsi.

Anthropic parla di context engineering per gli agenti AI: non si progetta soltanto una richiesta, ma l’intero ambiente informativo in cui il sistema deve operare. È un passaggio che approfondisco anche nell’articolo dal prompt al contesto.

Se i documenti sono vecchi, le autorizzazioni sono eccessive o le procedure aziendali si contraddicono, l’agente non risolve il problema. Lo esegue più velocemente.

Come avviare un progetto pilota senza farsi male

Un buon progetto non parte dal super-agente aziendale. Parte da un processo piccolo, frequente e misurabile.

  1. Scegliere un solo processo. Per esempio classificare le richieste commerciali in entrata.
  2. Misurare il punto di partenza. Tempo impiegato, errori, volumi, costi e passaggi manuali.
  3. Definire una job description. Obiettivo, strumenti, fonti, divieti, condizioni di arresto ed escalation.
  4. Limitare i permessi. All’inizio meglio leggere e proporre; l’azione autonoma viene dopo.
  5. Creare casi di test. Non solo richieste normali, ma dati mancanti, istruzioni contraddittorie ed eccezioni.
  6. Tenere una persona nel circuito. Le azioni sensibili devono richiedere approvazione.
  7. Decidere in anticipo quando fermare il progetto. Se costa più del lavoro risparmiato o non raggiunge la qualità minima, si torna a un workflow più semplice.

Quali metriche usare per valutare un agente AI

Contare le risposte generate serve a poco. Le metriche utili sono legate al lavoro:

  • tempo medio per completare un’attività;
  • percentuale di attività completate correttamente;
  • numero di interventi umani necessari;
  • costo per attività completata;
  • tasso di errore e gravità degli errori;
  • numero di escalation corrette e mancate;
  • tracciabilità delle fonti e delle azioni;
  • tempo realmente recuperato dalle persone.

Gartner ha previsto che oltre il 40% dei progetti di agentic AI sarà cancellato entro la fine del 2027, citando costi crescenti, valore poco chiaro e controlli del rischio insufficienti. La lezione non è “gli agenti non funzionano”, ma “una demo non è un risultato aziendale”.

Governance: chi controlla l’agente che controlla il processo?

Un agente deve essere trattato come un componente operativo, non come un collega infallibile. Servono registri delle azioni, gestione delle identità, limiti di spesa, fonti approvate, valutazioni periodiche e una persona responsabile del processo.

Il Playbook del NIST per la gestione del rischio AI propone azioni organizzate attorno a quattro funzioni: governare, mappare, misurare e gestire. È una buona bussola anche per un progetto piccolo.

Attenzione inoltre alla Shadow AI in azienda: se gli strumenti ufficiali sono assenti o troppo complicati, le persone ne adotteranno altri senza controllo. La governance efficace non è un elenco di divieti; è un modo sicuro per ottenere risultati.

E nei casi delicati bisogna ricordare che l’AI può anche influenzare male le scelte. Ne parlo nell’approfondimento sulle decisioni artificiali in azienda.

La regola finale: autonomia solo dove produce valore

Gli agenti AI in azienda possono essere molto utili. Ma la maturità non si misura dal numero di agenti attivati. Si misura dalla capacità di scegliere il processo giusto, assegnare un perimetro chiaro, controllare i risultati e fermarsi quando una soluzione più semplice funziona meglio.

Prima si mette ordine nel processo. Poi si decide che cosa automatizzare. Solo alla fine si valuta quanta autonomia concedere all’AI.

Il futuro del lavoro non sarà popolato soltanto da super-agenti. Sarà fatto soprattutto di buoni strumenti, piccoli automatismi e agenti specializzati che fanno poche cose, verificabili, davvero utili.

Domande frequenti sugli agenti AI in azienda

Qual è la differenza tra un agente AI e un chatbot?

Un chatbot risponde principalmente a richieste. Un agente AI può pianificare più passaggi, scegliere strumenti, osservare i risultati intermedi e compiere azioni per raggiungere un obiettivo.

Quando conviene usare un workflow invece di un agente?

Quando il processo è stabile, i passaggi sono noti, le regole sono chiare e le eccezioni sono poche. In questi casi il workflow è generalmente più semplice, economico e prevedibile.

Quali processi sono adatti a un primo agente AI?

Processi frequenti, circoscritti e misurabili: classificazione delle richieste, raccolta di dati da più fonti, controllo della completezza dei documenti e preparazione di bozze da approvare.

Un agente AI può lavorare senza supervisione umana?

Può farlo solo in attività a basso rischio, ben testate e facilmente reversibili. Per pagamenti, contratti, decisioni sulle persone o comunicazioni pubbliche è prudente mantenere un’approvazione umana.

Come si misura il valore di un agente AI?

Con indicatori operativi: tempo risparmiato, costo per attività, qualità del risultato, errori, escalation, interventi umani e tracciabilità delle azioni.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un’email