Tag Archivio per: privacy

Immaginiamo una scena molto concreta: un dipendente carica in ChatGPT un contratto con un cliente, un altro incolla il verbale di una riunione, un terzo chiede di analizzare un foglio con stipendi e nominativi. Tutti stanno cercando di lavorare meglio. Ma chi ha deciso quali dati possono uscire dall’azienda, attraverso quale account e con quali garanzie?

Quando mi chiedono quale abbonamento renda sicuro ChatGPT in azienda, parto da qui. Per l’uso quotidiano di informazioni riservate, gli account personali Free e Plus non sono la soluzione organizzativa che consiglierei. Business offre protezioni e gestione aziendale; Enterprise aggiunge controlli più articolati. La residenza europea richiede però una verifica separata. E nessun piano autorizza a caricare qualsiasi documento senza valutare il caso d’uso.

Condizioni e documentazione verificate l’8 ottobre 2026. Le funzionalità possono cambiare e dipendono da disponibilità, contratto e configurazione dell’area di lavoro.

ChatGPT e dati aziendali: cinque domande prima dell’abbonamento

“I dati sono protetti” è una frase troppo generica per prendere una decisione. Io la tradurrei in cinque domande:

  1. Addestramento: prompt, allegati e risposte possono essere usati per migliorare i modelli?
  2. Accesso: chi può entrare nell’account, condividere documenti o collegare altri servizi?
  3. Conservazione: quali copie restano, per quanto tempo e come si eliminano?
  4. Localizzazione: dove sono archiviati i contenuti e dove vengono elaborati?
  5. Responsabilità: chi ha approvato questo trattamento e verificato contratto, finalità e rischi?

Sono domande diverse. Spegnere l’addestramento risponde alla prima. Non risolve automaticamente le altre quattro.

Perché Free e Plus personali non bastano per l’azienda

Prima una precisazione: non sarebbe corretto scrivere che ChatGPT gratuito è sempre vietato in ufficio, o che ogni uso di Plus viola il GDPR. Preparare una scaletta con informazioni pubbliche è diverso dal caricare il database dei clienti. La mia raccomandazione riguarda la gestione sistematica di dati aziendali riservati e personali.

Nelle regole ufficiali sull’uso dei dati per migliorare i modelli, OpenAI distingue servizi individuali e servizi aziendali. Per quelli individuali è possibile disattivare “Improve the model for everyone”, in italiano “Migliora il modello per tutti”, da Impostazioni e Controlli dei dati. Dopo la rinuncia, le nuove conversazioni non vengono usate per migliorare i modelli. La documentazione segnala anche un’eccezione: inviando volontariamente feedback su una risposta, la conversazione associata può essere utilizzata per l’addestramento.

È un controllo utile. Pagare Plus, però, non trasforma un account personale in un’area di lavoro aziendale gestita. Lo stesso ragionamento vale per Pro personale: capacità e limiti di utilizzo non equivalgono a una diversa governance dell’azienda.

Se l’organizzazione affida tutto alle impostazioni del singolo, deve anche affidarsi alla sua memoria: selezionare l’account giusto, non attivare condivisioni inappropriate, non collegare app non autorizzate, gestire l’uscita dall’azienda. Il costo nascosto è questa frammentazione. Avevo già affrontato il problema nel mio decalogo sul Bring Your Own AI.

Per sperimentazioni con dati pubblici o davvero anonimizzati, un piano personale può avere senso se la policy lo consente. Per contratti riservati, dati HR e documenti dei clienti, proporrei un ambiente aziendale approvato e una procedura documentata.

Che cosa offre ChatGPT Business per proteggere i dati

Secondo le FAQ ufficiali di ChatGPT Business, il piano offre un’area di lavoro condivisa per il team, fatturazione centralizzata e controlli amministrativi. Si applicano i termini aziendali e gli impegni di privacy enterprise. L’area di lavoro richiede almeno due licenze a pagamento.

La documentazione OpenAI sulla sicurezza dei dati aziendali descrive, per Business:

  • Esclusione dall’addestramento per impostazione predefinita dei dati dell’organizzazione.
  • Cifratura dei dati a riposo con AES-256 e in transito con TLS 1.2 o superiore.
  • Ruoli Member, Admin e Owner, per distinguere utenti e amministratori.
  • Autenticazione a più fattori e SAML SSO, cioè accesso tramite il sistema di identità dell’organizzazione.
  • Controlli sui GPT di terze parti e statistiche di base sull’utilizzo.

La guida alla privacy e alla condivisione in Business chiarisce inoltre che gli altri membri non vedono automaticamente tutte le chat di un collega. Un ambiente collaborativo non significa che ogni conversazione sia visibile a tutto l’ufficio.

Per una PMI, Business è quindi una base da valutare seriamente per l’adozione quotidiana, purché i dati e i processi siano compatibili con le condizioni del servizio. Va configurato: nominare amministratori, gestire gli accessi, scegliere gli strumenti consentiti e spiegare alle persone come usarli.

La cifratura, da sola, non impedisce a un utente autorizzato di condividere il documento sbagliato. Inoltre, cifratura a riposo e in transito non significa che il fornitore non possa elaborare il contenuto per erogare il servizio.

Business conserva i dati in Europa? La novità e l’eccezione americana

Qui serve leggere la documentazione più recente. Nella pagina dove vengono conservati i contenuti di ChatGPT Business, OpenAI dichiara che la scelta della regione è in distribuzione graduale e non è ancora disponibile per tutti.

La regione selezionabile durante l’acquisto riguarda l’archiviazione principale dei contenuti a riposo. Non determina dove viene eseguita l’inferenza, cioè l’elaborazione che produce le risposte.

Soprattutto, OpenAI precisa che, scegliendo una regione fuori dagli Stati Uniti, una copia di ogni prompt e risposta viene comunque conservata temporaneamente negli Stati Uniti per sicurezza, monitoraggio degli abusi e applicazione delle regole.

La pagina non indica una durata numerica di quella conservazione. È una domanda da chiarire con il fornitore prima di approvare dati delicati.

Quindi, se nel tuo acquisto è offerta una regione europea, non leggere quella scelta come una promessa che tutto resti esclusivamente in Europa. E non dare per scontato che un’area Business già esistente sia configurata nella regione desiderata.

Quando serve Enterprise e che cosa significa residenza europea

Enterprise va valutato quando servono una gestione più articolata delle identità e dei permessi, controlli di conformità e requisiti contrattuali specifici. La guida ufficiale per amministratori Enterprise comprende SCIM per gestire gli utenti, ruoli e gruppi, strumenti di audit e integrazione con sistemi di controllo, restrizioni di rete e opzioni come Enterprise Key Management, dove disponibili.

Gli impegni di privacy enterprise prevedono inoltre controlli amministrativi sulla conservazione. Prima dell’acquisto, chiederei quali dati e funzionalità rientrano concretamente nei controlli concordati.

La documentazione sulla residenza dei dati e dell’inferenza distingue due opzioni per clienti Enterprise idonei:

  • Data residency: contenuti coperti conservati a riposo nella regione configurata.
  • Inference residency: elaborazione GPU dei contenuti coperti nella stessa regione, se abilitata.

La regione “Europe” comprende Spazio economico europeo e Svizzera. Non significa Italia né esclusivamente i 27 Paesi dell’UE.

Anche con entrambe le opzioni, alcune elaborazioni CPU, come estrazione del testo e instradamento, possono avvenire fuori regione; integrazioni esterne e categorie di metadati hanno regole separate. Occorre verificare anche le funzionalità escluse.

Se il requisito è archiviazione e inferenza GPU europee, valuterei Enterprise con entrambe le opzioni confermate. Se il requisito vieta qualsiasi trattamento fuori dall’UE, non presenterei questa configurazione come sufficiente senza una verifica specifica del perimetro contrattuale e tecnico.

Free, Plus, Business ed Enterprise: una tabella per decidere

Questa è una sintesi operativa della documentazione collegata sopra, non una certificazione di conformità del singolo utilizzo.

PianoAddestramentoGestione aziendaleLocalizzazioneLa mia indicazione
Free personaleControllabile tramite impostazioni personaliNon equivale a un workspace aziendaleNon assumere garanzie europeeSperimentazioni autorizzate con dati pubblici o anonimizzati
Plus e Pro personaliControllabile tramite impostazioni personaliNon sostituisce BusinessIl pagamento non dimostra residenza europeaNon li sceglierei per governare dati riservati del team
BusinessEscluso per defaultWorkspace, amministrazione, ruoli, SSOScelta della regione in rollout; copie di sicurezza negli USABase da valutare per PMI e processi compatibili
EnterpriseEscluso per defaultControlli più articolatiStorage e inferenza regionali per clienti idonei, con esclusioniRequisiti più stringenti, da configurare e verificare

GDPR: l’abbonamento aiuta, la responsabilità resta all’azienda

Il GDPR, nel testo messo a disposizione dal Garante per la protezione dei dati personali, richiede finalità e basi giuridiche appropriate, minimizzazione, sicurezza e responsabilizzazione. Sono pertinenti gli articoli 5 e 6, il contratto con il responsabile del trattamento previsto dall’articolo 28, le misure dell’articolo 32 e, quando ricorrono i presupposti, la valutazione d’impatto dell’articolo 35.

Il GDPR non impone in generale che ogni dato sia sempre conservato nell’UE: i trasferimenti verso Paesi terzi richiedono il rispetto delle condizioni del Capo V. E conservare un dato in Europa non rende lecito un utilizzo privo di una base giuridica.

OpenAI pubblica un Data Processing Addendum, l’accordo sul trattamento dei dati. Va verificato e formalizzato secondo il percorso applicabile al proprio contratto. Consiglierei di far controllare al referente privacy o al DPO, se nominato, finalità, categorie di dati, subfornitori e trasferimenti effettivi del flusso.

Ricordiamoci anche dei segreti aziendali: un progetto industriale o un listino riservato può richiedere protezione pur senza contenere dati personali. La policy deve coprire entrambi.

Una procedura pratica per usare ChatGPT ogni giorno

Queste sono le regole operative che proporrei a un’azienda prima di distribuire gli accessi.

  1. Scegliere tre attività iniziali. Per esempio riscrivere email, sintetizzare procedure e preparare presentazioni. Definire quali documenti servono davvero.
  2. Classificare i dati. Pubblici, interni, riservati e ad alta criticità. Per ogni categoria indicare strumenti ammessi, persone autorizzate e approvazioni richieste.
  3. Usare l’area aziendale. Ogni persona deve riconoscere il workspace corretto prima di incollare o allegare qualcosa. Evitare account condivisi e credenziali passate tra colleghi.
  4. Gestire gli accessi. Configurare MFA o SSO secondo la policy, ridurre gli amministratori al necessario, verificare cosa succede quando un dipendente cambia ruolo o lascia l’azienda.
  5. Ridurre i dati prima dell’invio. Eliminare informazioni inutili, commenti, revisioni, fogli nascosti e metadati. Controllare il file effettivo che si sta caricando.
  6. Limitare collegamenti e condivisioni. Consentire solo app e GPT approvati, con accessi coerenti con il compito.
  7. Definire conservazione e cancellazione. Stabilire chi gestisce chat, allegati, progetti e memorie, verificando i controlli disponibili nel piano.
  8. Provare il flusso con documenti sintetici. Controllare permessi, risultati e possibili errori prima di passare ai dati reali.
  9. Formare e verificare. Far esercitare le persone sui casi del loro reparto, compreso il riconoscimento delle informazioni da non inviare.
  10. Prevedere un canale per gli incidenti. Se viene caricato il file sbagliato, serve un referente e una procedura; il dipendente deve sapere come segnalarlo subito.

Tre esempi: email, vendite e risorse umane

AttivitàPreparazione consigliataErrore da evitare
Riscrivere un’email a un clientePassare il testo necessario, sostituendo identificativi e dettagli superfluiIncollare tutta la catena con recapiti e allegati non pertinenti
Analizzare l’andamento commercialeUsare dati aggregati o un estratto approvato nel workspace autorizzatoCaricare l’intero CRM per ottenere un semplice grafico
Preparare una procedura HRDescrivere il processo con un caso fittizioUsare fascicoli sanitari o disciplinari senza una valutazione specifica

Per dati sanitari, credenziali, chiavi API, informazioni disciplinari o progetti strategici, la mia regola iniziale sarebbe: non caricarli nel flusso ordinario. Un eventuale impiego richiede un progetto dedicato e l’approvazione delle funzioni competenti.

Anonimizzare prima di caricare, non dopo

Chiedere a ChatGPT di anonimizzare il documento originale comporta già l’invio del documento. Per evitare quella trasmissione, la preparazione deve avvenire prima, con strumenti e procedure approvati dall’azienda.

Sostituire “Maria Rossi” con “Dipendente 17” non basta se ruolo, ufficio e vicenda permettono comunque di riconoscerla. Il GDPR distingue la pseudonimizzazione dai dati resi effettivamente anonimi: la prima resta nel suo ambito di applicazione.

Un esercizio utile arriva dal video ufficiale di OpenAI Academy su privacy e informazioni da non condividere: partire da una bolletta e individuare quali dettagli servono per la domanda. Lo proporrei in aula con una fattura fittizia, prima di passare ai documenti dell’azienda.

OpenAI Academy: quali informazioni evitare di condividere e quando verificare le risposte.

Connettori e agenti: verificare anche la destinazione successiva

Collegare ChatGPT alla posta, a Drive o al CRM aggiunge un altro passaggio al flusso. La documentazione sui controlli di plugin e servizi connessi spiega che contano i permessi dell’account autorizzato e che il servizio esterno applica le proprie condizioni di conservazione, trattamento e residenza.

Per questo partirei con un servizio alla volta e con sole operazioni di lettura. Prima di consentire invii, scritture o pubblicazioni, farei verificare destinatari, ambito dei permessi e possibilità di recuperare da un errore. Un agente autorizzato a leggere l’intera casella e spedire email ha esigenze diverse da un chatbot che corregge una bozza.

Anche la cancellazione va controllata per posizione: la guida alla sicurezza di ChatGPT Work chiarisce che eliminare una conversazione, un file salvato, una memoria e una connessione sono azioni separate. Non presumere che la cancellazione della chat elimini ogni copia del lavoro.

Se serve un’applicazione su misura: le API hanno regole proprie

Le API di OpenAI possono essere una strada per costruire un assistente interno con controlli definiti dal progetto. La documentazione ufficiale sui controlli dei dati API prevede residenza regionale e opzioni come Zero Data Retention per clienti, endpoint e funzionalità idonei.

Non basta però scrivere “API” nel preventivo: vanno verificati configurazione regionale, conservazione, compatibilità delle funzioni e log dell’applicazione sviluppata. Zero Data Retention nelle API non è una proprietà generale di ChatGPT Business o Enterprise.

Se l’organizzazione richiede che un certo documento non esca mai dal proprio perimetro, valuterei con l’IT anche un’architettura interna. Bisogna verificare l’intero flusso, compresi telemetria, backup e servizi esterni eventualmente usati.

La scelta che consiglierei a un’azienda

Per iniziare con attività ordinarie e informazioni compatibili con le condizioni del servizio, valuterei Business insieme a una policy concreta. Per requisiti più stringenti di identità, audit, conservazione e localizzazione, valuterei Enterprise con configurazione e contratto verificati.

Prima di firmare chiederei una risposta scritta su quattro punti: dati coperti, copie ed eccezioni, luoghi di archiviazione ed elaborazione, tempi di conservazione. E farei approvare tre casi d’uso reali, non soltanto il nome del prodotto.

La prova finale la farei con un dipendente: “Devi sintetizzare questo documento. Quale account apri? Quali parti rimuovi? Puoi collegare il CRM? Chi controlla la risposta?”. Se non sa rispondere, manca ancora un pezzo dell’adozione.

Nel mio corso ChatGPT per aziende e professionisti lavoro anche su queste decisioni: partire dai processi, preparare i documenti e costruire abitudini che permettano di usare l’AI senza improvvisare sui dati.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Invia un'email

Meta non sa letteralmente tutto di noi, ma può dedurre interessi, caratteristiche personali e importanza delle relazioni osservando la struttura della rete e i comportamenti digitali. Alcuni studi mostrano che Facebook può perfino riconoscere con buona accuratezza il partner romantico. Non esiste invece una ricerca che dimostri che sappia identificare con certezza un amante segreto.

Immagina di non aver mai dichiarato apertamente chi sia la persona più importante della tua vita.

Nessun post romantico. Nessuna fotografia insieme. Nessun cuoricino sotto una dichiarazione pubblica. Eppure un algoritmo potrebbe comunque riuscire a individuarla osservando soltanto la struttura della tua rete sociale.

Da qui nasce una frase che circola da anni: Facebook sa chi sono i tuoi amici più cari, il tuo partner e perfino la tua amante.

La prima parte ha basi scientifiche. L’ultima, quella dell’amante, è una provocazione efficace ma non è stata dimostrata da uno studio specifico. Eppure la questione resta inquietante: Meta non deve necessariamente leggere un contenuto esplicito per ricostruire una relazione. Può inferirla dai segnali che lasciamo.

Chi cerchiamo. Con chi interagiamo. Quali profili visitiamo. Chi compare in più cerchie della nostra vita. A quali contenuti reagiamo e quali ignoriamo.

Meta non deve leggere nella nostra mente. Le basta formulare previsioni sufficientemente accurate.

Come Meta usa i dati per costruire modelli su di noi

Quando pensiamo ai dati personali immaginiamo nome, età, indirizzo, fotografia, posizione e numero di telefono. È una visione ormai antiquata.

Il vero valore non si trova soltanto nei dati che dichiariamo, ma nelle informazioni che possono essere dedotte dai nostri comportamenti.

Esiste una differenza fondamentale tra ciò che comunichiamo esplicitamente, ciò che facciamo e ciò che un sistema può inferire mettendo insieme migliaia di segnali.

Meta stessa, spiegando come funziona il sistema di ranking del Feed di Facebook, parla di migliaia di segnali elaborati per prevedere quali contenuti troveremo più rilevanti e con quali avremo maggiori probabilità di interagire. Non si tratta di un unico algoritmo, ma di diversi modelli di machine learning che assegnano punteggi e probabilità ai contenuti.

Facebook non deve chiedermi: «Quanto è importante per te questa persona?».

Può osservare quanto spesso interagisco con lei, quali contenuti guardo, se rispondo ai suoi commenti, quali amici abbiamo in comune e in quali ambienti della mia vita compare.

In un mio precedente approfondimento sull’ingegnerizzazione e misurazione delle relazioni nei social network avevo già evidenziato questo meccanismo: misurare i legami permette alla piattaforma di decidere a chi mostrare un contenuto e quali conversazioni stimolare.

Il social network, quindi, non si limita a rappresentare le relazioni. Le trasforma in variabili.

Lo studio che permise a Facebook di riconoscere il partner

Nel 2013 Lars Backstrom, allora ingegnere di Facebook, e Jon Kleinberg della Cornell University pubblicarono lo studio Romantic Partnerships and the Dispersion of Social Ties, successivamente presentato alla conferenza ACM CSCW del 2014.

I ricercatori analizzarono un campione di circa 1,3 milioni di utenti Facebook che avevano dichiarato sul profilo una relazione sentimentale. L’obiettivo era capire se fosse possibile riconoscere il partner osservando soltanto la struttura della rete di amicizie.

Si potrebbe pensare che la persona più importante sia semplicemente quella con cui condividiamo più amici. Non è così.

I ricercatori introdussero un indicatore chiamato dispersione. Una relazione assume un valore strutturalmente particolare quando collega parti diverse della nostra vita.

Il collega conosce soprattutto altri colleghi. Il compagno di calcetto conosce gli amici della squadra. Il partner, invece, può essere collegato contemporaneamente ai familiari, agli amici d’infanzia, ai colleghi e ai vicini di casa.

Queste persone non si conoscono necessariamente tra loro, ma conoscono tutte il partner. È questa particolare distribuzione dei legami a renderlo riconoscibile.

Secondo i risultati riportati, l’algoritmo riusciva a identificare il coniuge nel 60% circa dei casi e un partner non sposato in quasi il 50% dei casi. Non era infallibile, ma era enormemente più efficace di una scelta casuale.

Facebook può scoprire un amante?

Qui serve una precisazione fondamentale: lo studio prendeva in esame utenti che avevano dichiarato la relazione. Non dimostrava che Facebook potesse scoprire un amante segreto.

Dire che «Facebook conosce la tua amante» è quindi un’estrapolazione, non un risultato scientifico. La ricerca dimostra qualcosa di più preciso: la geometria delle nostre relazioni può rivelare legami importanti anche senza analizzare il contenuto dei messaggi.

I tuoi Mi piace possono raccontare ciò che non hai dichiarato

Nel 2013 Michal Kosinski, David Stillwell e Thore Graepel pubblicarono su PNAS lo studio Private traits and attributes are predictable from digital records of human behavior.

Analizzando i Mi piace di oltre 58.000 volontari, i ricercatori mostrarono che le tracce digitali potevano essere utilizzate per stimare caratteristiche sensibili quali orientamento politico, religione, personalità, età, genere e orientamento sessuale.

L’aspetto più interessante non era la capacità di interpretare un like esplicito. Non serve un algoritmo sofisticato per dedurre le idee politiche di chi segue la pagina di un partito.

Le previsioni potevano basarsi anche su combinazioni di comportamenti apparentemente innocui e privi di un collegamento evidente con la caratteristica da individuare.

La privacy non riguarda soltanto ciò che pubblichiamo, ma anche ciò che può essere dedotto da quello che pubblichiamo.

Due anni dopo, un altro studio pubblicato su PNAS, condotto su 86.220 volontari, confrontò i giudizi sulla personalità elaborati dai computer con quelli espressi da colleghi, amici, familiari e partner.

Secondo i risultati, con circa 100 Mi piace il modello poteva superare il giudizio della persona media. Con 300 poteva risultare più accurato del coniuge nel descrivere alcuni tratti della personalità.

Sono dati provenienti da una fase precedente della storia di Facebook e non vanno trasferiti automaticamente agli algoritmi odierni. Il principio, però, rimane valido: una grande quantità di piccoli segnali può produrre inferenze che il singolo segnale non consentirebbe.

Dalla misurazione delle relazioni all’influenza sociale

Misurare un legame non serve soltanto a capire chi conosciamo. Serve anche a prevedere chi può influenzarci.

Nel 2012 uno studio pubblicato su Nature descrisse un esperimento realizzato durante le elezioni statunitensi del 2010, coinvolgendo circa 61 milioni di utenti Facebook.

I messaggi mostrati dalla piattaforma influenzarono, con effetti individuali piccoli ma misurabili, l’espressione politica, la ricerca di informazioni e il comportamento elettorale. Soprattutto, la trasmissione sociale avvenne prevalentemente attraverso gli amici più stretti.

Questo spiega perché la misurazione delle relazioni abbia un valore enorme.

Un messaggio pubblicitario può essere ignorato. Lo stesso messaggio, associato al comportamento di una persona di cui ci fidiamo, può diventare molto più persuasivo.

L’algoritmo non deve soltanto stabilire quale contenuto mostrarci. Deve capire anche quale relazione può renderlo più credibile.

L’esperimento di Facebook sul contagio emotivo

Nel 2014 Facebook fu coinvolta in uno degli studi più controversi della storia dei social media: Experimental evidence of massive-scale emotional contagion through social networks.

I ricercatori modificarono per una settimana il numero di contenuti positivi o negativi mostrati nel Feed di 689.003 utenti. Successivamente osservarono un piccolo ma statisticamente misurabile cambiamento nel tono dei post pubblicati dagli stessi utenti.

L’effetto rilevato era modesto. Sarebbe quindi scorretto dire che Facebook possa accendere o spegnere a piacimento le emozioni delle persone.

Lo studio dimostrò comunque un fatto rilevante: modificare la composizione del flusso informativo può produrre effetti osservabili sul comportamento di una popolazione enorme.

Non esiste un pulsante segreto chiamato «rendi triste Gianluigi». Variazioni minuscole, applicate a milioni o miliardi di persone, possono però avere conseguenze collettive significative.

La persuasione diventa personalizzata

Nel 2017 un ulteriore studio pubblicato su PNAS sulla persuasione psicologica analizzò tre esperimenti pubblicitari che raggiunsero oltre 3,5 milioni di persone.

Quando il messaggio veniva adattato a caratteristiche psicologiche come estroversione o apertura mentale, i ricercatori registrarono fino al 40% di clic in più e fino al 50% di acquisti in più rispetto ai messaggi non corrispondenti al profilo. Gli autori avvertivano anche del rischio di sfruttare le vulnerabilità psicologiche delle persone.

La sequenza diventa chiara:

  1. la piattaforma osserva il comportamento;
  2. ricostruisce interessi e caratteristiche probabili;
  3. misura la forza delle relazioni;
  4. seleziona il messaggio;
  5. decide quando e in quale contesto mostrarlo;
  6. misura la reazione e aggiorna il modello.

È un ciclo continuo di osservazione, previsione, intervento e verifica.

Nel mio articolo sul film Brexit: The Uncivil War e il microtargeting di Facebook raccontavo proprio questa trasformazione: non parlare a tutti, ma individuare gruppi specifici e mostrare a ciascuno ciò che ha maggiori probabilità di funzionare.

Un video per capire perché ogni dato può diventare sensibile

Nel TED Talk ufficiale What will a future without secrets look like?, Alessandro Acquisti, professore alla Carnegie Mellon University, mostra come informazioni pubbliche, riconoscimento facciale e modelli statistici possano essere combinati per ricostruire dati che una persona non aveva deciso di comunicare.

Facebook, Instagram e WhatsApp sanno tutti le stesse cose?

Occorre evitare un’altra semplificazione.

Facebook, Instagram, Messenger, Threads e WhatsApp appartengono allo stesso gruppo, ma questo non significa che tutti i contenuti confluiscano automaticamente in un unico calderone accessibile senza limiti.

Su WhatsApp, per esempio, i messaggi e le chiamate personali sono protetti dalla crittografia end-to-end. Secondo la documentazione ufficiale, nemmeno WhatsApp e Meta possono leggerne o ascoltarne il contenuto.

Questo non significa che WhatsApp sia privo di dati. Contenuto e metadati non sono la stessa cosa. Informazioni tecniche, dati dell’account e determinati segnali di utilizzo possono comunque avere valore operativo e relazionale, secondo le informative applicabili.

Per essere rigorosi, quindi, non bisogna dire che Meta legge tutte le nostre conversazioni WhatsApp. Non è ciò che dimostrano le fonti.

Ogni servizio digitale può però generare segnali e ogni segnale, combinato con altri, può contribuire a un modello probabilistico.

Questa è ingegneria sociale?

Nel campo della sicurezza informatica, l’espressione «ingegneria sociale» indica solitamente la manipolazione delle persone per ottenere informazioni, accessi o comportamenti.

Nel caso di Meta parlerei più precisamente di ingegnerizzazione dell’ambiente sociale.

Le piattaforme trasformano le relazioni in dati, attribuiscono un peso ai legami, prevedono quali contenuti genereranno una reazione, ordinano il nostro ambiente informativo e misurano gli effetti delle proprie scelte.

Non è necessario immaginare una stanza segreta piena di persone che decidono che cosa dobbiamo pensare. La forma più potente di influenza è automatizzata, statistica e impersonale.

Nessuno deve conoscere davvero Gianluigi Bonanomi. È sufficiente che il sistema sappia che utenti con un comportamento simile al suo tendono a fermarsi davanti a un certo contenuto, fidarsi di determinate persone o reagire a una specifica formulazione.

Profilazione non significa conoscenza

Gli algoritmi non costruiscono necessariamente un ritratto vero di noi. Costruiscono un ritratto utile ai loro obiettivi.

Una previsione può essere sbagliata sul singolo individuo e rimanere economicamente efficace su milioni di persone. La conoscenza cerca di capire chi sei. La profilazione cerca di prevedere che cosa farai.

Anche le autorità hanno contestato nel tempo alcune pratiche legate alla gestione e all’utilizzo dei dati. Nel 2019 la Federal Trade Commission statunitense impose a Facebook una sanzione da 5 miliardi di dollari e nuovi vincoli in materia di privacy. Nel 2023 lo European Data Protection Board intervenne sul trattamento dei dati personali di Meta per la pubblicità comportamentale nello Spazio economico europeo.

Sono vicende diverse, che non dimostrano l’esistenza di un’unica macchinazione. Dimostrano però che il modello basato sulla profilazione produce problemi concreti di trasparenza, consenso e controllo.

Non proteggere soltanto i dati: proteggi le inferenze

Possiamo evitare completamente la profilazione? Probabilmente no, a meno di rinunciare a molti servizi digitali.

Possiamo però ridurre la quantità e la qualità dei segnali disponibili:

  • controllare periodicamente le preferenze pubblicitarie;
  • limitare la sincronizzazione dei contatti quando non è necessaria;
  • verificare quali applicazioni sono collegate agli account;
  • eliminare autorizzazioni obsolete;
  • evitare di usare l’account Facebook o Instagram come chiave universale per altri servizi;
  • limitare posizione, microfono, fotocamera e accesso alla rubrica;
  • ricordare che anche un comportamento passivo, come soffermarsi su un contenuto, può diventare un segnale.

Non basta chiedersi: «Quali dati ho consegnato?».

Bisogna aggiungere una domanda più scomoda: «Che cosa può essere dedotto mettendo insieme questi dati?».

Forse Facebook non conosce davvero la tua amante. Potrebbe però accorgersi che una certa persona occupa, nella tua rete e nelle tue abitudini, una posizione molto diversa da tutte le altre.

E potrebbe farlo prima che tu abbia deciso di raccontarlo.

Domande frequenti

Meta può leggere i messaggi di WhatsApp?

I messaggi e le chiamate personali sono protetti dalla crittografia end-to-end. Secondo WhatsApp, né WhatsApp né Meta possono accedere al loro contenuto. Questo non equivale all’assenza completa di dati tecnici e di utilizzo.

Facebook può capire chi sono i miei amici più stretti?

Può stimarlo attraverso frequenza delle interazioni, struttura della rete, amici comuni, attività e altri segnali. Una stima algoritmica non coincide però con una conoscenza certa della relazione.

Facebook può scoprire una relazione sentimentale segreta?

Lo studio di Backstrom e Kleinberg dimostrò che la struttura della rete poteva identificare con buona accuratezza un partner dichiarato. Non dimostrò la capacità di individuare amanti o relazioni segrete.

Qual è la differenza tra dati raccolti e dati inferiti?

I dati raccolti derivano da azioni, contenuti e informazioni registrate. I dati inferiti sono previsioni prodotte combinando quei segnali, per esempio interessi, personalità probabile o importanza di una relazione.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Claude ha certamente un posizionamento da intelligenza artificiale colta, professionale e moralmente consapevole. Ma definirla semplicemente snob sarebbe ingiusto: dietro la comunicazione sofisticata di Anthropic ci sono scelte tecniche, commerciali ed etiche reali, insieme a contraddizioni altrettanto reali.

Claude non ti risponde. Ti accoglie.

Non sembra un chatbot incontrato in metropolitana alle sette del mattino. Ha più l’aria di qualcuno che ha letto Hannah Arendt, beve caffè monorigine e, prima di darti un consiglio, vuole assicurarsi che siano state considerate tutte le implicazioni etiche.

Da qui la domanda, volutamente provocatoria: Claude di Anthropic è un’intelligenza artificiale fighetta?

Con “fighetta” non intendo dire inutile, debole o incompetente. Al contrario. Intendo un prodotto che comunica una certa superiorità culturale: più riflessivo, più rispettoso, più elegante, più attento alla privacy e meno disposto a sporcarsi le mani rispetto ai concorrenti.

Perché Claude viene percepita come l’AI elegante

ChatGPT è diventato un prodotto popolare. Lo usa lo studente, il pensionato, il manager, il candidato che deve sistemare il curriculum e quello che gli chiede i numeri del Superenalotto.

Claude, invece, ha conquistato inizialmente soprattutto sviluppatori, professionisti, ricercatori e utenti che lavorano con documenti complessi. Non è una semplice impressione. Secondo il rapporto 2025 State of Generative AI in the Enterprise di Menlo Ventures, Anthropic avrebbe raggiunto una posizione di leadership nella spesa aziendale per modelli linguistici nel campione analizzato. È un dato prodotto da una società di venture capital, quindi non va trattato come un censimento universale, ma indica un posizionamento enterprise molto forte. Anche la Developer Survey 2025 di Stack Overflow segnalava una diffusione rilevante dei modelli Claude Sonnet fra gli sviluppatori.

Il pubblico di riferimento influenza inevitabilmente il carattere percepito del prodotto.

Claude non è stato presentato come l’amico che sa fare tutto. Anthropic lo ha definito fin dall’inizio un assistente “helpful, honest and harmless”, cioè utile, onesto e non dannoso. Una formula che sembra più il programma elettorale di un filosofo morale che lo slogan di un software. La presentazione ufficiale di Claude insisteva proprio su affidabilità, prevedibilità e possibilità di controllarne tono e comportamento.

Anche il nome contribuisce. ChatGPT sembra il codice di un elettrodomestico. Gemini richiama costellazioni e missioni spaziali. Claude porta il nome di una persona, presumibilmente con un riferimento a Claude Shannon, padre della teoria dell’informazione. Già questo ti fa sentire in difetto se lo usi soltanto per riscrivere una mail.

Anthropic vende un prodotto o una visione morale?

Anthropic si presenta come una società di ricerca e sicurezza dell’intelligenza artificiale. Il suo elemento più riconoscibile è la Constitutional AI, un metodo con cui il modello viene addestrato a valutare e correggere le proprie risposte sulla base di un insieme esplicito di principi.

Nel paper originale sulla Constitutional AI, i ricercatori di Anthropic descrivono un processo nel quale il modello genera risposte, le critica alla luce di una “costituzione”, le riscrive e successivamente impara dalle preferenze prodotte da un altro sistema di AI.

È un approccio interessante perché rende almeno parzialmente visibili i criteri normativi usati per orientare il chatbot. Ma attenzione: Claude non possiede una coscienza morale e non “crede” nei diritti umani. Risponde secondo schemi appresi e criteri stabiliti durante l’addestramento.

La Costituzione di Claude resta inoltre il risultato di scelte umane. La stessa Anthropic riconosce che decidere quali principi inserire attribuisce agli sviluppatori un potere enorme. Nel 2023 l’azienda ha coinvolto circa mille cittadini statunitensi in un esperimento di Collective Constitutional AI. Il progetto ha evidenziato differenze tra i valori scelti internamente e quelli indicati dal campione pubblico, soprattutto su imparzialità, accessibilità e formulazione positiva delle regole.

È un segnale di apertura, ma mille americani non rappresentano l’umanità.

Un altro studio sulle opinioni globali rappresentate nei modelli linguistici, pubblicato da ricercatori di Anthropic, ha rilevato che le risposte tendevano ad avvicinarsi maggiormente alle opinioni diffuse negli Stati Uniti e in alcune popolazioni europee e sudamericane. Persino un’AI costituzionale, quindi, può incorporare una geografia culturale dei valori.

La costituzione non elimina il problema. Lo rende più visibile. Ed è già qualcosa.

Una comunicazione che profuma di biblioteca

Nel febbraio 2026 Anthropic ha pubblicato un manifesto intitolato Claude is a space to think. La promessa è che le conversazioni con Claude resteranno prive di pubblicità e di inserimenti commerciali non richiesti.

La motivazione è interessante: quando parliamo con un assistente AI condividiamo problemi lavorativi, dubbi personali, documenti e informazioni che difficilmente inseriremmo in un motore di ricerca. Secondo Anthropic, introdurre annunci in questo spazio potrebbe creare un conflitto tra l’interesse dell’utente e quello dell’inserzionista.

Fin qui, applausi.

Poi arriva la frase che definisce perfettamente il posizionamento: Claude deve essere uno spazio pulito nel quale pensare e lavorare. Non una piazza, non un supermercato, non un social network. Piuttosto un taccuino ben rilegato, possibilmente appoggiato su una scrivania di legno chiaro.

Questa è comunicazione. Ed è comunicazione molto ben costruita.

Anthropic vuole che Claude venga associato a concentrazione, profondità, lavoro intellettuale e assenza di distrazioni. È il contrario del modello basato su engagement, pubblicità e permanenza sulla piattaforma.

Il rischio è che questo linguaggio produca un effetto collaterale: far sembrare Claude l’AI di chi si considera più consapevole degli altri.

Quello che usa ChatGPT chiede una ricetta. Quello che usa Claude “esplora le implicazioni sistemiche dell’alimentazione contemporanea”. Sto scherzando, ma non troppo.

Claude rispetta davvero di più la privacy?

Qui occorre separare la percezione dai contratti.

Per le offerte aziendali Anthropic dichiara che prompt, documenti e risultati non vengono utilizzati per addestrare i modelli per impostazione predefinita. È un elemento importante per imprese, professionisti e organizzazioni che trattano informazioni riservate.

Per gli account personali la situazione è diversa. La Privacy Policy di Anthropic prevede che input e output possano essere utilizzati per migliorare i modelli, salvo disattivazione nelle impostazioni. Esistono inoltre eccezioni per conversazioni segnalate dai sistemi di sicurezza o inviate esplicitamente come feedback.

Il Privacy Center di Claude spiega che, quando un utente autorizza l’uso delle conversazioni, queste vengono scollegate dall’identificativo dell’account e sottoposte a processi destinati a filtrare o oscurare i dati sensibili.

Privacy di Claude: affermazioni e realtà

Affermazione Valutazione
Claude non usa mai le conversazioni per l’addestramento Falso per gli account consumer
Gli utenti personali possono opporsi Sì, attraverso le impostazioni
I dati aziendali vengono usati per addestrare Claude Non per impostazione predefinita
Anthropic non raccoglie dati tecnici e di utilizzo Falso
Claude garantisce privacy assoluta No, nessun servizio cloud può prometterla

Bisogna inoltre evitare di confondere due questioni differenti: la protezione delle conversazioni inserite dall’utente e la presenza di dati personali nel materiale originariamente usato per addestrare i modelli.

La ricerca ha dimostrato che i modelli linguistici possono, in determinate condizioni, memorizzare e restituire sequenze presenti nei dati di addestramento. Nel paper peer-reviewed Extracting Training Data from Large Language Models, presentato a USENIX Security 2021, i ricercatori riuscirono a estrarre da GPT-2 frammenti testuali contenenti anche nomi, email e numeri di telefono. Lo studio non riguardava Claude, ma dimostra perché la privacy nei modelli linguistici non possa essere ridotta a uno slogan aziendale.

Anthropic appare più esplicita di altri concorrenti su principi e controlli. Questo non trasforma Claude in una cassaforte. Se un documento non dovrebbe uscire dall’azienda, non basta scegliere il chatbot con l’aria più educata.

Anthropic ha davvero rotto con il Pentagono per motivi etici?

Questa vicenda è il principale argomento di chi considera Anthropic la società moralmente più coerente del settore. Ma va raccontata con precisione.

Anthropic non è un’azienda pacifista. Claude era già utilizzato negli apparati statunitensi per intelligence, pianificazione operativa, simulazioni e operazioni informatiche. La società aveva inoltre ottenuto un accordo con un valore massimo di 200 milioni di dollari.

Lo scontro nacque quando il Pentagono chiese di poter usare il modello per tutti gli impieghi consentiti dalla legge. Anthropic rifiutò di eliminare due limiti:

  • impiego per la sorveglianza interna di massa;
  • impiego in armi completamente autonome capaci di selezionare e colpire bersagli senza controllo umano.

Nella dichiarazione del 26 febbraio 2026, Dario Amodei sostenne che gli attuali modelli non fossero abbastanza affidabili per decisioni autonome di vita o di morte e che l’AI potesse trasformare dati legalmente acquistabili in sistemi di sorveglianza incompatibili con i valori democratici.

Il Pentagono replicò di non voler realizzare nessuno dei due scenari, ma pretese la possibilità di utilizzare Claude per qualsiasi finalità legale. Secondo Reuters, il rifiuto mise a rischio il contratto e portò alla minaccia di classificare Anthropic come rischio per la catena di approvvigionamento.

La designazione arrivò nel marzo 2026. Anthropic la contestò in tribunale, sostenendo che fosse una ritorsione. Un’ordinanza della Corte distrettuale della California ritenne plausibile che alcuni provvedimenti governativi eccedessero quanto necessario per proteggere la sicurezza nazionale e fossero motivati anche dalle critiche pubbliche dell’azienda. La controversia proseguì su più fronti giudiziari. Il quadro legale, quindi, era ben più complesso del titolo “Anthropic rompe con il Pentagono”. La dichiarazione successiva di Amodei ribadiva infatti la volontà di continuare a collaborare con le forze armate, mantenendo soltanto quelle due eccezioni.

La lettura equilibrata è questa: Anthropic non rifiutò il settore militare. Accettò però un costo economico e politico pur di non rinunciare a due limiti dichiarati pubblicamente.

È una scelta etica? Sì, almeno in parte.

È anche una scelta strategica di posizionamento? Quasi certamente.

Le due cose possono convivere. Un’azienda può difendere sinceramente un principio e contemporaneamente trasformarlo in reputazione, differenziazione e valore commerciale.

Etica autentica o sofisticato marketing?

La tentazione è dividere il mondo in santi e ipocriti.

Da una parte Anthropic, che parla di sicurezza, diritti e controllo. Dall’altra le aziende che inseguono crescita, pubblicità e diffusione di massa.

La realtà è meno cinematografica.

Anthropic è una società sostenuta da colossi come Amazon e Google. Vende abbonamenti, API e contratti enterprise. Compete per fatturato, talenti, potenza di calcolo e quote di mercato. Non è un’organizzazione umanitaria.

Anche l’etica può diventare un vantaggio competitivo.

La Constitutional AI differenzia tecnicamente il prodotto. La promessa di assenza di pubblicità lo differenzia economicamente. Lo scontro con il Pentagono lo differenzia politicamente. La comunicazione sobria lo differenzia culturalmente.

Questo non rende false le sue scelte. Impone però di valutarle attraverso comportamenti verificabili, non soltanto attraverso manifesti ben scritti.

Un buon criterio potrebbe essere questo:

  1. L’azienda pubblica principi verificabili?
  2. Accetta conseguenze economiche per difenderli?
  3. Applica gli stessi principi quando diventano scomodi?
  4. Offre agli utenti controlli comprensibili?
  5. Consente verifiche indipendenti sui propri modelli?
  6. Ammette limiti, errori e conflitti di interesse?

Anthropic ottiene risultati interessanti sui primi punti. Sugli ultimi, come tutto il settore, ha ancora parecchia strada da percorrere.

Anche il tono di Claude influenza la nostra fiducia

Quando giudichiamo un chatbot non valutiamo soltanto l’accuratezza. Ne interpretiamo tono, prudenza, empatia e sicurezza.

Un preprint del 2026 su antropomorfismo e fiducia, basato su oltre duemila interazioni uomo-LLM, ha rilevato che calore comunicativo, competenza percepita ed empatia cognitiva influenzano fiducia, utilità percepita e vicinanza relazionale. Il lavoro non riguarda specificamente Claude e, trattandosi di un preprint, i risultati vanno considerati provvisori. Offre però una chiave di lettura utile.

Claude tende a esprimersi in modo composto, collaborativo e prudente. Questa personalità può comunicare maggiore affidabilità. Può anche sembrare paternalistica, evasiva o eccessivamente diplomatica.

  • Per un utente è cautela.
  • Per un altro è censura.
  • Per qualcuno è eleganza.
  • Per qualcun altro è puzza sotto il naso.

Non esiste, al momento, una solida ricerca scientifica che dimostri che Claude sia percepito dal pubblico come “snob”. Questa è un’interpretazione culturale del marchio, non un dato sperimentale.

Quindi Claude è davvero un’intelligenza artificiale fighetta?

Un po’ sì.

Lo è nella comunicazione, nel lessico e nell’immaginario costruito attorno al prodotto. Claude si presenta come l’assistente che non vuole venderti nulla, non vuole farti perdere tempo, legge documenti lunghi, riflette prima di rispondere e possiede perfino una Costituzione.

È l’AI che non ti invita a “scatenare la creatività”. Preferisce aiutarti a “pensare con maggiore chiarezza”.

Ma ridurla a un vezzo per intellettuali sarebbe un errore. Claude è diventato uno strumento importante per programmatori e imprese, e Anthropic ha trasformato alcuni principi in limiti tecnici, contrattuali e commerciali. Nel confronto con il Pentagono ha accettato conseguenze concrete, pur senza rinnegare la collaborazione militare.

Sulla privacy, invece, il quadro è meno eccezionale di quanto suggerisca la reputazione. Le differenze tra account consumer ed enterprise sono decisive, le conversazioni personali possono essere utilizzate per l’addestramento se non si interviene sulle impostazioni e nessun modello cloud è immune dai problemi generali legati ai dati.

La mia conclusione?

Claude è un’intelligenza artificiale fighetta, ma non nel senso di un prodotto tutto posa e niente sostanza. È una fighetta con il badge enterprise, una Costituzione nello zaino e le scarpe antinfortunistiche.

A volte il suo tono può infastidire. A volte la comunicazione di Anthropic sembra suggerire: “Noi non siamo come gli altri”.

Però, in un mercato nel quale molte aziende parlano di principi finché non compare un contratto importante, averne almeno due che resistono davanti a 200 milioni di dollari non è proprio irrilevante.

Resta una domanda da fare a tutte le aziende dell’AI, Anthropic compresa: quanto valgono i vostri principi quando smettono di essere una campagna di comunicazione e iniziano a costare davvero?

Per sperimentare Claude e gli altri assistenti in modo più consapevole, puoi partire anche dalla mia raccolta di prompt per l’intelligenza artificiale generativa, ricordando che nessun prompt sostituisce la verifica delle fonti e la responsabilità umana.

FAQ su Claude, Anthropic, privacy ed etica

Claude e Anthropic sono la stessa cosa?

No. Anthropic è la società che sviluppa Claude. Claude è il nome della famiglia di modelli e dell’assistente di intelligenza artificiale.

Claude è più sicuro di ChatGPT?

Non è possibile dare una risposta assoluta. Anthropic utilizza tecniche specifiche come la Constitutional AI e pubblica numerosi documenti sulla sicurezza. La sicurezza effettiva dipende però dal modello, dal tipo di utilizzo, dalle configurazioni e dai criteri adottati per misurarla.

Claude usa le conversazioni per addestrare i modelli?

Per gli account consumer Anthropic può utilizzare input e output, salvo disattivazione nelle impostazioni. Per i servizi commerciali e aziendali i dati non vengono usati per l’addestramento per impostazione predefinita.

Anthropic ha interrotto il contratto con il Pentagono?

La vicenda è più complessa. Anthropic ha rifiutato di eliminare due limitazioni relative a sorveglianza interna di massa e armi completamente autonome. Il governo statunitense ha quindi adottato provvedimenti contro l’azienda, successivamente contestati in tribunale.

Claude è l’intelligenza artificiale degli snob?

È una definizione ironica, non una categoria scientifica. La comunicazione di Anthropic punta su riflessione, sicurezza, lavoro professionale e assenza di pubblicità. Questo posizionamento può far percepire Claude come un prodotto più colto, elitario o sofisticato rispetto ad altri chatbot.

La Constitutional AI rende Claude moralmente neutrale?

No. La Constitutional AI rende più espliciti alcuni principi usati nell’addestramento, ma quei principi sono comunque selezionati, interpretati e applicati da persone e organizzazioni inserite in uno specifico contesto culturale.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Usare dati aziendali con l’intelligenza artificiale può essere utile e sostenibile, ma richiede strumenti autorizzati, informazioni selezionate e regole precise. Il rischio cambia in base a ciò che carichiamo, alle condizioni del servizio e alle operazioni che permettiamo all’AI di svolgere. Pagare un abbonamento non basta a mettere al sicuro un documento.

Immaginiamo questa scena: un dipendente deve riassumere un contratto di trenta pagine. Lo carica nel chatbot, scrive “evidenzia le clausole critiche” e ottiene una risposta in pochi secondi.

Ottimo risparmio di tempo. Ma prima del caricamento mancavano alcune domande: quel servizio è autorizzato dall’azienda? Nel contratto ci sono dati personali? Ci sono vincoli di riservatezza? Chi conserverà il file e per quanto tempo?

Il pulsante “allega” è facilissimo da usare. Le decisioni che dovrebbero precederlo meritano qualche attenzione in più.

Quali dati aziendali possiamo inserire nell’AI?

Propongo un semaforo operativo. È uno schema orientativo per decidere come comportarsi, non una classificazione prevista dalla legge. La valutazione effettiva dipende dal contesto.

Tipo di informazione Esempi Indicazione operativa
Pubblica e non personale Schede prodotto, brochure, descrizioni di servizi Generalmente adatta agli strumenti autorizzati, verificando diritti d’uso e risultati
Interna Procedure, istruzioni di lavoro, bozze organizzative Verificare riservatezza, necessità e ambiente utilizzato
Riservata o personale Contratti, elenchi clienti, retribuzioni, valutazioni del personale Richiedere una valutazione specifica e protezioni adeguate
Particolarmente critica Credenziali, segreti industriali, dati sanitari, fascicoli delicati Escluderla dai chatbot generici; eventuali usi richiedono procedure e ambienti dedicati

Attenzione anche alla parola “pubblico”: un documento disponibile online può contenere dati personali. La pubblicazione non autorizza automaticamente qualsiasi riutilizzo. I principi di liceità, finalità e minimizzazione restano centrali nel Regolamento generale sulla protezione dei dati, consultabile sul sito del Garante.

ChatGPT usa i dati aziendali per addestrarsi?

Occorre distinguere il servizio e il tipo di account.

Nella documentazione sui dati aziendali, OpenAI dichiara che gli input e gli output di ChatGPT Business, Enterprise e della piattaforma API non sono utilizzati per addestrare i modelli per impostazione predefinita.

Per i servizi destinati ai singoli utenti, le condizioni sono differenti: OpenAI spiega quali contenuti possono essere utilizzati per migliorare i modelli e come intervenire nelle impostazioni nella pagina How your data is used to improve model performance.

Quindi la frase “uso ChatGPT” dice troppo poco per valutare il rischio. Servono almeno il piano, l’account effettivamente utilizzato, le impostazioni e le funzionalità attive.

L’esclusione dall’addestramento, inoltre, non equivale all’assenza di conservazione. È una garanzia importante, ma bisogna verificare anche tempi di conservazione, accessi e condizioni contrattuali.

Copilot è sicuro perché è già dentro Microsoft 365?

Microsoft documenta protezioni aziendali per Copilot e Copilot Chat, compreso il mancato utilizzo di prompt, risposte e dati recuperati tramite Microsoft Graph per addestrare i modelli di base.

La stessa documentazione Microsoft sulla protezione dei dati aziendali precisa però che i controlli disponibili dipendono dall’abbonamento e che ricerca web e agenti richiedono attenzione alle rispettive condizioni.

La conseguenza pratica è semplice: occorre verificare l’intero percorso dell’informazione.

Un assistente che consulta un documento interno, effettua una ricerca sul web e richiama un servizio esterno coinvolge passaggi diversi. Le garanzie del prodotto principale non vanno estese automaticamente a ogni integrazione.

Togliere i nomi rende anonimo un documento?

Non necessariamente. Ecco un esempio inventato:

“Il responsabile dell’unico stabilimento di Sulbiate, assunto a marzo, ha chiesto un’aspettativa per una specifica patologia.”

Il nome non compare. Tuttavia, per chi conosce l’organizzazione, la persona potrebbe essere riconoscibile.

Sostituire “Mario Rossi” con “Dipendente A” può ridurre l’esposizione, ma non garantisce l’anonimato. Se una persona resta identificabile, il dato continua a richiedere protezione.

Il Comitato europeo per la protezione dei dati, nel parere sui modelli di AI, sottolinea la necessità di valutare l’anonimato caso per caso.

Per le esercitazioni suggerisco dati interamente fittizi. Per il lavoro reale, invece, conviene selezionare soltanto i campi indispensabili, eliminando anche gli indizi identificativi non necessari.

GDPR e AI Act: quali obblighi considerare?

Quando vengono trattati dati personali, l’uso dell’AI deve rispettare il GDPR. Occorre verificare, tra le altre cose:

  • finalità e base giuridica del trattamento;
  • informazioni da fornire agli interessati;
  • ruoli e accordi con i fornitori;
  • misure di sicurezza e tempi di conservazione;
  • eventuali trasferimenti di dati fuori dallo Spazio economico europeo.

La valutazione d’impatto sulla protezione dei dati, o DPIA, è richiesta quando il trattamento può presentare un rischio elevato per le persone: non è automaticamente obbligatoria per qualsiasi uso di un chatbot. Il riferimento è l’articolo 35 del GDPR.

Sul versante dell’AI Act, l’alfabetizzazione sull’intelligenza artificiale è oggetto dell’articolo 4. Le domande e risposte della Commissione europea aiutano a capire come affrontarla nel contesto dell’organizzazione.

Per me la ricaduta formativa è molto concreta: chi usa l’AI deve sapere quali informazioni può caricare, come verificare le risposte e quando coinvolgere un responsabile. Saper scrivere un prompt efficace è solo una parte della competenza.

Sette regole operative da mettere nella policy aziendale

Queste sono le regole organizzative che suggerisco come base, da adattare con IT, responsabili di funzione e referente privacy.

1. Indicare strumenti e account autorizzati

La policy dovrebbe nominare prodotti, piani e modalità di accesso consentite. “È permesso usare l’AI” lascia troppe decisioni al singolo dipendente.

2. Definire quali dati sono ammessi

Servono esempi riconoscibili: preventivi, curriculum, verbali, progetti, dati dei clienti. Per ciascuna categoria bisogna chiarire condizioni, limiti e responsabile a cui rivolgersi.

3. Caricare solo ciò che serve

Se l’obiettivo è migliorare la formulazione di una clausola, valutiamo se basti quella clausola. Allegare l’intero contratto dovrebbe essere una scelta motivata.

4. Controllare collegamenti e autorizzazioni

Prima di collegare posta, archivi o CRM, definiamo quali fonti l’assistente può consultare e quali azioni può eseguire.

Nel mio approfondimento su agenti AI e second brain mostro perché il contesto documentale è utile. Proprio questa utilità rende essenziale governare gli accessi.

5. Separare preparazione e azioni delicate

Suggerisco di richiedere un’approvazione umana prima di inviare comunicazioni sensibili, pubblicare documenti o modificare informazioni importanti nei sistemi aziendali.

6. Assegnare la verifica a una persona

“Controllare il risultato” è un’indicazione incompleta. Meglio precisare chi verifica importi, scadenze, riferimenti normativi, destinatari e fedeltà ai documenti originali.

7. Prevedere cosa fare in caso di errore

La procedura dovrebbe indicare a chi segnalare un caricamento improprio e quali informazioni conservare per ricostruirlo. Cancellare la conversazione non dimostra, da solo, che il problema sia risolto.

Tre esempi pratici: commerciale, HR e Comune

I seguenti sono scenari didattici, non casi di cronaca.

Commerciale. Per migliorare la struttura di un’offerta, si può iniziare da un modello privo di nominativi, prezzi riservati e condizioni negoziali. I dati reali vengono inseriti successivamente nell’ambiente autorizzato.

Risorse umane. Per creare una scaletta di colloquio, spesso bastano mansione, competenze e obiettivi. Non occorre partire dall’intero archivio dei curriculum.

Comune. Per preparare una checklist relativa a un bando, si può partire dal testo pubblico. L’analisi delle domande dei cittadini, con allegati e dati personali, richiede una valutazione distinta.

La domanda utile, in tutti e tre i casi, è: quali informazioni sono davvero necessarie per ottenere questo risultato?

Un prompt non sostituisce le protezioni tecniche

Scrivere “questi dati sono riservati, non divulgarli” non modifica il contratto del fornitore, le impostazioni di conservazione o i permessi degli strumenti collegati.

Un prompt può aiutare a circoscrivere il compito. Non può diventare una cassaforte.

Prima di caricare un documento, consiglio quindi un controllo essenziale:

Sono autorizzato a far trattare questi dati da questo fornitore, per questa finalità?

Se la risposta è incerta, il passo successivo è chiarirla con chi governa il servizio.

Per costruire un percorso pratico sull’uso dell’AI in azienda o nella pubblica amministrazione, puoi contattarmi per una formazione dedicata: possiamo partire dalle attività quotidiane e trasformarle in esercitazioni, criteri di verifica e regole comprensibili.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

La memoria di ChatGPT permette al sistema di riutilizzare preferenze, dettagli e contesto pertinenti per offrirti risposte più personali e farti ripetere meno informazioni. Non è però una registrazione completa di tutto ciò che hai scritto: ChatGPT seleziona ciò che considera utile e, a seconda del piano e delle impostazioni, può attingere da chat precedenti, ricordi salvati, istruzioni personalizzate, file nella Libreria e contenuti delle app connesse.

In questa guida vediamo come controllare la memoria di ChatGPT, correggerla, cancellarla e usare le chat temporanee. Con una precisazione importante: le voci possono cambiare in base al piano, alla piattaforma, all’area geografica e alle regole dell’eventuale spazio di lavoro aziendale.

Che cos’è la memoria di ChatGPT, in breve

La memoria trasforma ChatGPT da interlocutore che riparte ogni volta da zero in un assistente capace di mantenere continuità. Se sa che lavoro fai, quali strumenti usi o come preferisci ricevere una risposta, può evitare premesse inutili e adattare meglio esempi e linguaggio.

OpenAI distingue però più meccanismi:

  • Ricordi salvati: informazioni che chiedi esplicitamente di ricordare o che ChatGPT conserva come contesto utile.
  • Cronologia chat: informazioni pertinenti ricavate dalle conversazioni precedenti. Possono cambiare quando il sistema rivaluta ciò che è più utile.
  • Istruzioni personalizzate: indicazioni dirette su ciò che ChatGPT deve sapere e sul modo in cui deve rispondere. Non sono la stessa cosa della memoria.
  • Memoria migliorata: dove disponibile, mantiene un riepilogo più ampio e aggiornato del contesto personale.

È una distinzione pratica. Se vuoi costruire un vero assistente personale o un secondo cervello digitale con ChatGPT, devi sapere da quale fonte arriva un’informazione e come rimuoverla davvero.

Come attivare e gestire la memoria di ChatGPT

Passaggio 1: apri le impostazioni

  1. Apri ChatGPT sul web o nell’app.
  2. Apri il menu del profilo.
  3. Seleziona Impostazioni.
  4. Vai su Personalizzazione.
  5. Apri Memoria.

Secondo la guida ufficiale OpenAI sulla memoria, qui potresti trovare voci come Memoria, Fai riferimento ai ricordi salvati, Fai riferimento alla cronologia chat, Riepilogo della memoria, Gestisci o Ricordi salvati. Se una voce non compare, non è necessariamente un errore: disponibilità e controlli variano.

Passaggio 2: scegli che cosa può essere usato

Se il tuo account mostra due interruttori separati, puoi controllare i ricordi salvati e la cronologia delle chat. Disattivando i ricordi salvati viene disattivato anche il riferimento alla cronologia; lasciandoli attivi, puoi invece gestire la cronologia separatamente.

Attenzione a un equivoco comune: spegnere la memoria non cancella automaticamente le vecchie chat. Se in seguito la riattivi, ChatGPT potrebbe ricavare nuovi elementi dalle conversazioni ancora presenti.

Passaggio 3: chiedi a ChatGPT che cosa ricorda

Il controllo più semplice parte da una domanda:

Che cosa ricordi di me? Organizza la risposta per categorie e segnala le informazioni che potrebbero essere obsolete o poco utili.

Dove disponibile, puoi anche aprire il Riepilogo della memoria. La schermata offre una vista sintetica, non necessariamente completa, delle informazioni usate per personalizzare le risposte.

Schermata ufficiale del riepilogo della memoria di ChatGPT con funzione di correzione
Il riepilogo della memoria può essere corretto direttamente. Schermata ufficiale OpenAI.

Passaggio 4: correggi ciò che è sbagliato

Puoi scrivere una correzione, selezionare il testo da modificare oppure dire in chat:

Correggi questa informazione: non uso più lo strumento X. Da oggi considera Y come mia preferenza.

Alcuni account mostrano anche l’opzione Non menzionarlo più. Serve a ridurre i riferimenti futuri, ma non elimina la fonte originale. È la differenza fra dire a qualcuno di non citare più un vecchio episodio e strappare la pagina dall’archivio.

Passaggio 5: controlla le fonti della personalizzazione

Quando ChatGPT usa contesto personale pertinente, sotto la risposta può comparire la sezione Fonti. Può rimandare a un ricordo, una chat, un’istruzione personalizzata, un file o un’email connessa. Non è detto che mostri ogni fattore che ha influenzato la risposta.

Schermata ufficiale delle fonti della memoria di ChatGPT con comandi per pertinenza e correzione
Dalle Fonti puoi verificare perché un’informazione è stata usata, correggerla o segnalarla come non pertinente. Schermata ufficiale OpenAI.

Questo controllo è prezioso perché la personalizzazione senza trasparenza rischia di diventare una scatola nera. Se un suggerimento ti sorprende, controlla prima la fonte e poi decidi se correggere, eliminare o ignorare l’informazione.

Come cancellare davvero un’informazione dalla memoria

Cancellare la chat non basta sempre. Un ricordo salvato è archiviato separatamente dalla conversazione originaria. Per rimuovere un’informazione in modo più completo:

  1. Elimina il ricordo dal riepilogo o dai controlli dei ricordi salvati.
  2. Elimina la chat in cui l’informazione è stata condivisa.
  3. Rimuovila anche da eventuali chat archiviate.
  4. Elimina i file pertinenti dalla Libreria.
  5. Se proviene da un’app connessa, valuta di rimuovere il contenuto o disconnettere l’app.

OpenAI avverte che aggiornamenti ed eliminazioni possono richiedere tempo e che i log dei ricordi salvati eliminati possono essere conservati fino a 30 giorni per sicurezza e debug. Per i documenti professionali conviene comunque ridurre i dati personali prima del caricamento: ho spiegato un approccio pratico nella guida a Rizzo PII per anonimizzare i documenti destinati a ChatGPT.

Chat temporanea: quando usare ChatGPT senza creare nuovi ricordi

La chat temporanea è utile quando la conversazione non deve comparire nella cronologia e non deve creare o aggiornare la memoria. Prima di inviare il primo messaggio puoi scegliere:

  • Personalizzata: usa ricordi esistenti, istruzioni personalizzate e plugin disponibili.
  • Non personalizzata: ignora memoria, istruzioni personalizzate e plugin.

La scelta non può essere modificata dopo l’inizio della conversazione. In entrambi i casi la chat temporanea non crea né aggiorna ricordi. Se però la salvi, diventa una chat normale e segue le impostazioni dell’account. La documentazione OpenAI sulle chat temporanee precisa inoltre che una copia può essere conservata fino a 30 giorni per finalità di sicurezza.

Schermata ufficiale di ChatGPT per scegliere una chat temporanea personalizzata o non personalizzata
Nella chat temporanea puoi scegliere Personalizzata o Non personalizzata prima del primo messaggio. Schermata ufficiale OpenAI.

Memoria e addestramento dei modelli non sono la stessa impostazione

Un altro equivoco frequente è confondere memoria e addestramento. La memoria personalizza le risposte. L’opzione Migliora il modello per tutti decide invece se, per un account personale, le nuove conversazioni possano contribuire al miglioramento dei modelli.

Per controllarla sul web:

  1. Apri il menu del profilo.
  2. Vai su Impostazioni.
  3. Apri Controlli dei dati.
  4. Attiva o disattiva Migliora il modello per tutti.

La FAQ ufficiale sui controlli dei dati chiarisce che, disattivando questa voce, le conversazioni restano nella cronologia ma non vengono usate per addestrare ChatGPT. Nei workspace ChatGPT Business, Enterprise, Edu e Healthcare, OpenAI dichiara che i contenuti non vengono usati per l’addestramento per impostazione predefinita.

Memoria nei progetti: contesto globale o isolato?

I Progetti aggiungono un’altra scelta importante. Dove disponibile, puoi usare la memoria predefinita oppure la memoria limitata al progetto. In questo secondo caso le chat possono fare riferimento alle altre conversazioni dello stesso progetto, ma non a quelle esterne; anche le chat esterne non possono richiamare il contenuto del progetto.

È una buona soluzione per separare clienti, corsi, ricerche o attività personali. Secondo la guida OpenAI ai Progetti, i progetti condivisi usano automaticamente la memoria limitata al progetto. È un confine di contesto, non una scusa per caricare qualsiasi dato senza valutare ruoli, permessi e policy aziendali.

Cinque prompt per gestire meglio la memoria

  1. Audit: “Che cosa ricordi di me? Dividi le informazioni in corrette, da verificare e non più utili”.
  2. Aggiunta: “Ricorda che preferisco risposte brevi, con esempi italiani e fonti primarie”.
  3. Correzione: “Sostituisci la vecchia informazione X con Y e dimmi che cosa hai aggiornato”.
  4. Rimozione: “Dimentica l’informazione X e spiegami quali altre fonti devo eliminare per rimuoverla completamente”.
  5. Controllo in risposta: “Per questa risposta indica se hai usato memoria, chat precedenti, file o app connesse”.

Le istruzioni personalizzate restano lo strumento migliore per regole stabili e intenzionali sul tono e sul formato. La memoria serve invece a mantenere continuità con ciò che emerge nel tempo. Per approfondire le forme più evolute di personalizzazione puoi leggere anche il mio articolo su skill, plugin e futuro dei GPT personalizzati.

La mia checklist mensile per una memoria utile

  • Chiedi a ChatGPT che cosa ricorda di te.
  • Correggi ruolo, preferenze e strumenti non più attuali.
  • Elimina ciò che è sensibile, superfluo o ambiguo.
  • Controlla file nella Libreria e app connesse.
  • Separa i contesti professionali con progetti dedicati.
  • Usa una chat temporanea non personalizzata quando non vuoi richiamare né creare memoria.
  • Verifica separatamente l’impostazione “Migliora il modello per tutti”.

Una memoria ben curata rende ChatGPT più utile. Una memoria lasciata crescere senza controllo può invece amplificare informazioni vecchie, interpretazioni sbagliate e preferenze che non ti rappresentano più. Cinque minuti di manutenzione ogni mese sono un investimento sensato.

Fonti

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

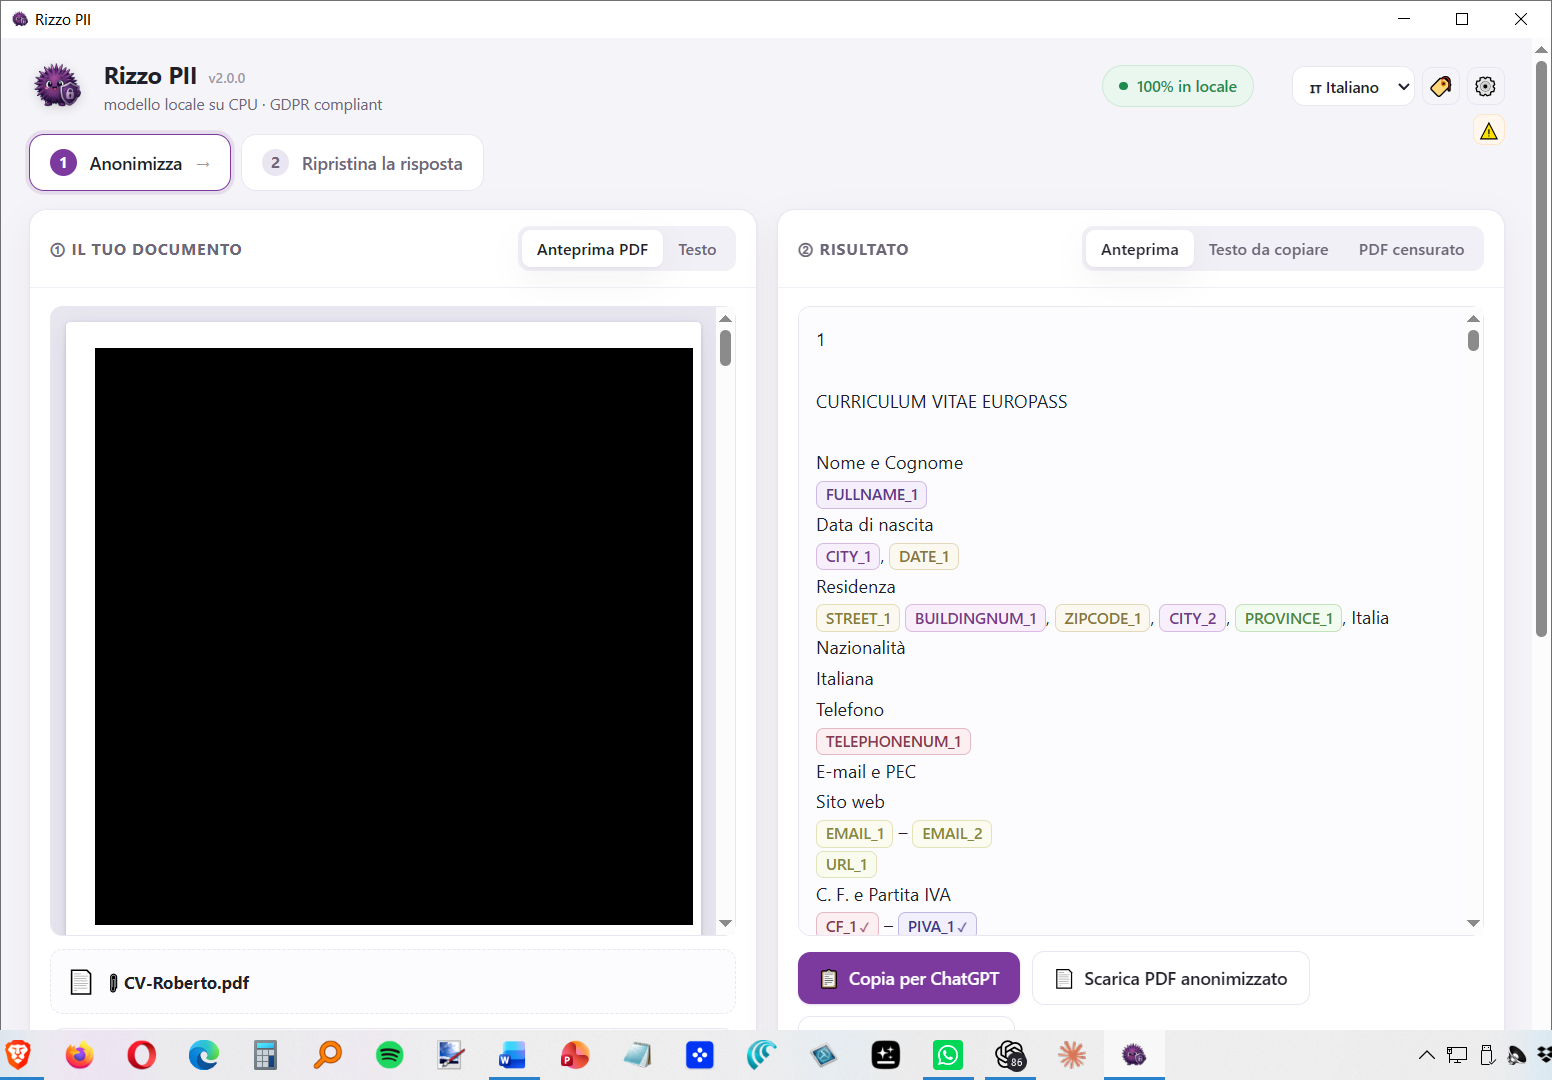
Rizzo PII è un’applicazione gratuita e open source che individua e sostituisce localmente molti dati personali presenti nei documenti, prima che il testo venga inviato a ChatGPT, Claude o Gemini. Non è una skill da installare dentro ChatGPT. È un filtro che lavora sul computer e trasforma nomi, codici fiscali, IBAN e altri identificativi in segnaposto come [FULLNAME_1] o [IBAN_1].

Per chi usa l’intelligenza artificiale con contratti, pratiche, verbali, documenti amministrativi o clinici, il problema è concreto: il documento può essere utilissimo per ottenere una sintesi o una prima analisi, ma può contenere molte più informazioni personali di quelle realmente necessarie.

La soluzione non è fare finta che il problema non esista. E nemmeno rinunciare all’AI. È togliere i dati che il modello non ha bisogno di conoscere.

Che cos’è Rizzo PII

Rizzo PII è un progetto della Rizzo AI Academy pensato soprattutto per testi giuridici e professionali italiani. Il suo modello di riconoscimento, secondo la documentazione del progetto, ha circa 0,3 miliardi di parametri e può funzionare sulla CPU di un normale computer.

L’applicazione riconosce 22 categorie tramite il modello, alle quali l’interfaccia aggiunge il rilevamento degli URL. Tra le informazioni gestite ci sono:

  • nomi e cognomi;
  • indirizzi, città, CAP e province;
  • email, PEC e numeri telefonici;
  • codici fiscali e partite IVA;
  • IBAN e numeri di carte di credito;
  • targhe, numeri di documenti e protocolli;
  • importi e dati catastali.

È proprio l’attenzione agli identificativi italiani a rendere il progetto interessante. Un sistema generico, nato principalmente per l’inglese, può riconoscere una persona o un indirizzo ma lasciarsi sfuggire un codice fiscale, una partita IVA o un riferimento catastale.

Come funziona l’anonimizzazione dei documenti

Il flusso è semplice. Rizzo PII analizza il documento sul computer, individua le informazioni personali e le sostituisce con etichette coerenti. Conserva poi localmente un dizionario che permette di effettuare l’operazione inversa.

Un testo come questo:

Il signor Mario Rossi, codice fiscale RSSMRA85H12F205Z, comunica il proprio IBAN.

può diventare:

Il signor [FULLNAME_1], codice fiscale [CF_1], comunica il proprio [IBAN_1].

ChatGPT riceve la seconda versione. Può ancora capire la struttura del documento, distinguere i soggetti e svolgere l’analisi richiesta, senza avere bisogno del nome o del numero di conto reali. Quando la risposta torna, Rizzo PII può ripristinare localmente i valori originali.

Come usare Rizzo PII con ChatGPT: esempio pratico

Immaginiamo di dover analizzare un contratto contenente dati di clienti o collaboratori.

  1. Scarica l’applicazione dalla pagina ufficiale delle release di Rizzo PII e installa la versione adatta al tuo sistema operativo.
  2. Apri l’app e incolla il testo oppure carica il PDF.
  3. Controlla i dati personali evidenziati.
  4. Aggiungi manualmente eventuali elementi non riconosciuti e disattiva solo le categorie che devono davvero restare leggibili.
  5. Genera la versione anonimizzata e copiala.
  6. Incollala in ChatGPT accompagnandola con un prompt preciso.

Per esempio:

Analizza questo contratto. Individua clausole squilibrate, scadenze, obblighi delle parti e punti che richiedono il controllo di un professionista. Cita per ogni osservazione il passaggio pertinente. Non inventare informazioni mancanti.

Dopo aver ricevuto il risultato, si copia la risposta nell’area di ripristino dell’app. I segnaposto vengono sostituiti con i dati reali, sempre sul computer.

Lo stesso metodo si presta a verbali di riunione, lettere disciplinari, curriculum, fascicoli, pratiche assicurative, documenti condominiali e corrispondenza con clienti. Cambia il prompt, non cambia la regola: al modello vanno forniti solo i dati necessari.

Anonimizzazione e pseudonimizzazione non sono la stessa cosa

Qui serve una precisazione importante. Rizzo PII parla spesso di anonimizzazione, ma il flusso reversibile descritto dal progetto è più vicino alla pseudonimizzazione: esiste infatti un dizionario locale capace di ricostruire i valori originali.

Il Regolamento generale sulla protezione dei dati distingue i dati anonimi da quelli pseudonimizzati. Questi ultimi restano dati personali se possono essere ricollegati a una persona usando informazioni aggiuntive.

Quindi Rizzo PII può essere un utile strumento di minimizzazione del rischio, ma non è un bollino automatico di conformità al GDPR. Restano da valutare finalità del trattamento, base giuridica, ruoli, sicurezza, istruzioni interne e condizioni del servizio AI utilizzato.

I limiti da conoscere prima di usarlo

Il primo limite è il più ovvio: nessun riconoscitore automatico è infallibile. La scheda ufficiale del modello pubblica risultati molto elevati sui propri test, ma una metrica non garantisce che ogni documento reale sia trattato perfettamente.

Scansioni poco leggibili, tabelle complesse, abbreviazioni interne, dati scritti in formati insoliti e nomi ambigui possono produrre omissioni o falsi positivi. Anche un singolo IBAN lasciato in chiaro può essere troppo.

Per questo suggerisco una procedura a tre controlli:

  • verifica visiva del documento anonimizzato;
  • ricerca manuale degli identificativi più delicati;
  • prova iniziale con documenti non critici, prima di introdurre lo strumento in un processo aziendale.

Attenzione anche al dizionario reversibile: è utile, ma contiene proprio l’associazione tra segnaposto e dati reali. Va protetto, conservato solo quando serve e cancellato secondo le regole dell’organizzazione.

Perché è interessante per aziende e pubbliche amministrazioni

Molte organizzazioni affrontano l’AI generativa in uno di due modi: vietano tutto oppure lasciano fare. Entrambe le scorciatoie funzionano male.

Uno strumento locale come Rizzo PII suggerisce una terza strada: progettare un passaggio intermedio tra il documento e il chatbot. È un esempio concreto di privacy by design e di minimizzazione dei dati, concetti richiamati dagli articoli 5 e 25 del GDPR.

Non basta installare il programma. Bisogna definire quali documenti possono essere trattati, quali categorie devono essere eliminate, chi controlla il risultato e quale piattaforma AI può riceverlo. La tecnologia aiuta quando diventa parte di una procedura, non quando sostituisce la procedura.

Rizzo PII è una skill di ChatGPT?

No. Il repository GitHub non contiene il file SKILL.md richiesto dalle skill di Codex e ChatGPT Work. Rizzo PII è un’applicazione desktop, disponibile anche come servizio HTTP locale e container Docker.

Questa distinzione non è pignoleria informatica. Una skill istruisce l’assistente su come svolgere un compito. Rizzo PII, invece, esegue materialmente un trattamento locale sui dati. In futuro si potrebbe costruire una skill che richiami l’API locale dell’applicazione, ma richiederebbe un’integrazione specifica e controlli di sicurezza adeguati.

Domande frequenti

Rizzo PII invia i documenti su Internet?

Secondo la documentazione ufficiale, analisi, sostituzione e ripristino avvengono localmente. Sarà l’utente a copiare il testo già pseudonimizzato nel servizio AI scelto.

Serve una scheda grafica potente?

No. Il progetto dichiara che il modello è progettato per funzionare su CPU e richiede una quantità contenuta di memoria.

Posso usarlo con PDF?

Sì. La versione 2.0.0 supporta l’analisi e la produzione di PDF redatti, oltre a file di testo e Markdown.

Usarlo rende automaticamente conforme al GDPR?

No. Riduce l’esposizione dei dati, ma la conformità dipende dall’intero trattamento e dalle misure organizzative adottate.


Vuoi introdurre ChatGPT e gli altri strumenti di intelligenza artificiale nella tua organizzazione senza improvvisare sulla gestione dei dati? Posso aiutarti a progettare formazione, regole operative e casi d’uso sostenibili. Contattami.

Una volta l’OSINT sembrava una cosa da investigatori con tre monitor, mappe piene di fili rossi e caffè freddo. Oggi, invece, una parte del lavoro parte da una domanda molto più banale: che cosa è già pubblico online?

Profili social, nickname riutilizzati, indirizzi email, vecchi forum, marketplace, repository, immagini, leak, metadati, commenti, recensioni: il problema non è solo trovare informazioni. Il problema è capirle, collegarle, verificarle e non scivolare oltre il confine etico e legale.

È il tema che ho affrontato nel libro Il nuovo petrolio (online). OSINT e intelligenza artificiale: a caccia di dati pubblici nell’era dei chatbot, scritto con Gianluca Boccacci e pubblicato da Ledizioni nel 2026. Il titolo dice già molto: i dati pubblici sono una risorsa, ma senza metodo diventano rumore. E senza responsabilità diventano un rischio.

Sul sito ho già raccontato perché OSINT e AI stanno cambiando il valore delle informazioni online. Qui faccio un passo più pratico: vediamo tre strumenti open source, uno per uno.

Copertina del libro Il nuovo petrolio online su OSINT e intelligenza artificiale
Il nuovo petrolio (online), il libro su OSINT e intelligenza artificiale scritto con Gianluca Boccacci e pubblicato da Ledizioni nel 2026.

Che cosa cambia con l’AI nell’OSINT?

L’AI rende l’OSINT più veloce, ma non automaticamente più vera. Può aiutare a riassumere pagine, confrontare profili, estrarre entità, costruire timeline, tradurre contenuti, classificare risultati e generare ipotesi investigative. Però deve lavorare su fonti verificabili. Se l’AI inventa collegamenti, confonde omonimi o interpreta male un dato pubblico, il risultato può essere elegante e sbagliato. Nell’OSINT il valore nasce da tre cose: fonti, metodo e controllo umano.

Che cos’è l’OSINT, in pratica

OSINT significa Open Source Intelligence: raccolta, analisi e interpretazione di informazioni disponibili da fonti aperte. Non vuol dire “spiare”. Non vuol dire violare account. Non vuol dire forzare password. Vuol dire lavorare su dati pubblici, accessibili, osservabili, documentabili.

Il punto è che il web ha reso le fonti aperte enormi e disordinate. Una persona può usare lo stesso nickname per anni. Un’azienda può lasciare tracce in documenti, sottodomini, offerte di lavoro, comunicati, profili LinkedIn, PDF indicizzati, repository e social. Una notizia può essere confermata o smentita incrociando archivi, immagini, mappe, date e testimonianze.

Qui entra l’intelligenza artificiale: non come bacchetta magica, ma come assistente per leggere, filtrare e organizzare. Il lavoro serio resta quello umano: fare domande buone, separare fatti e ipotesi, controllare le fonti, rispettare privacy e normativa.

Perché se ne parla adesso

Nel 2026 l’OSINT è diventata una competenza utile ben oltre la cybersecurity. Serve a giornalisti, aziende, comunicatori, HR, formatori, consulenti, enti pubblici, associazioni e professionisti che vogliono capire meglio il contesto in cui si muovono.

Tre cambiamenti hanno accelerato tutto:

  • l’esplosione dei dati pubblici: ogni piattaforma lascia tracce, spesso frammentate;
  • la disponibilità di strumenti open source: molti tool automatizzano ricerche prima molto lente;
  • l’AI generativa: chatbot e modelli linguistici aiutano a sintetizzare, confrontare e formulare ipotesi, purché non vengano trattati come oracoli.

Nel libro Il nuovo petrolio (online) insistiamo proprio su questo: cercare non basta più. Bisogna trasformare dati pubblici in conoscenza utile, verificabile e responsabile.

Il flusso corretto: prima il metodo, poi gli strumenti

Prima di usare Maigret, Trape, Blackbird o qualsiasi altro strumento, conviene impostare un piccolo protocollo. Sembra noioso. In realtà evita molti errori.

  1. Definisci l’obiettivo: che cosa vuoi capire davvero?
  2. Stabilisci il perimetro: persona, azienda, dominio, nickname, evento, periodo, fonte.
  3. Raccogli solo ciò che serve: il fatto che un dato sia pubblico non significa che sia necessario.
  4. Annota le fonti: URL, data di accesso, screenshot, contesto.
  5. Distingui fatto, inferenza e ipotesi: “ho trovato questo profilo” non equivale a “è sicuramente la stessa persona”.
  6. Usa l’AI per organizzare, non per inventare: chiedile sintesi, tabelle, timeline, ma verifica sempre.
  7. Rispetta legge, consenso e finalità: l’OSINT non è una scusa per molestare, profilare o danneggiare qualcuno.

Tool 1: Maigret, il dossier da un nome utente

Maigret è uno strumento OSINT open source che cerca un nome utente su migliaia di siti e produce report consultabili. Il repository ufficiale lo descrive come un tool capace di raccogliere un dossier partendo da un solo username, senza richiedere API key.

Esempio di report HTML generato da Maigret per una ricerca OSINT su username
Un esempio di report HTML di Maigret: i risultati vengono organizzati per rendere più leggibile la ricerca su uno username.

Come funziona Maigret

Maigret parte da un identificatore, di solito un nickname. Poi controlla se quel nome utente compare su piattaforme diverse: social network, forum, siti tecnici, servizi fotografici, community, portali locali, piattaforme di gaming e altri archivi pubblici.

Il principio è semplice: molte persone riutilizzano lo stesso username in contesti diversi. Questo permette di ricostruire una possibile impronta digitale. Ma attenzione alla parola “possibile”: uno username trovato su due siti non prova automaticamente che dietro ci sia la stessa persona.

Le funzioni più interessanti sono:

  • ricerca su oltre 3.000 siti, con una selezione predefinita dei più rilevanti;
  • esportazione in formati utili per l’analisi, come HTML, PDF, CSV, JSON e grafi;
  • filtri per categorie, Paesi e tag;
  • interfaccia web per esplorare i risultati;
  • modalità AI opzionale per sintetizzare i risultati, usando un’API compatibile con OpenAI.

Dove entra l’AI

Con Maigret l’AI può aiutare soprattutto dopo la raccolta. Può riassumere un report, estrarre pattern, evidenziare account probabilmente collegati, costruire una tabella con piattaforma, URL, indizi e livello di confidenza.

Un uso sensato dell’AI non è: “dimmi chi è questa persona”. Un uso sensato è: “riassumi questi risultati separando dati certi, collegamenti deboli e ipotesi da verificare”. La differenza sembra piccola, ma è enorme.

Quando usarlo

Maigret è utile per audit della propria presenza online, verifica di brand impersonation, ricerca su nickname pubblici, analisi reputazionale e controllo di tracce lasciate nel tempo. È meno adatto quando mancano identificatori stabili o quando il rischio di omonimia è alto.

Tool 2: Trape, il caso delicato del tracciamento web

Trape è il più delicato dei tre strumenti citati. Nel README ufficiale viene presentato come tool OSINT di analisi e ricerca per tracciare persone su Internet e studiare dinamiche di social engineering in tempo reale. È stato presentato anche a Black Hat Arsenal Asia nel 2018.

Schermata del progetto Trape per OSINT e tracking pubblicata nel README ufficiale
Trape è uno strumento storico e controverso: interessante per capire il tracciamento web, ma da trattare con grande cautela etica e legale.

Come funziona Trape, in modo difensivo

Trape aiuta a capire una cosa importante: un browser comunica molte informazioni. Quando una persona visita una pagina, il sito può osservare elementi tecnici come indirizzo IP, user agent, sistema operativo, browser, lingua, risoluzione, referrer, tempi di visita, sessioni e altri segnali. In alcuni casi, combinando script, link e pagine-esca, si possono creare scenari di tracciamento molto invasivi.

Qui bisogna essere chiari: non è uno strumento da usare contro persone inconsapevoli. Il suo valore, in un articolo divulgativo, è far capire come funzionano certe tecniche di tracking e social engineering, in modo da difendersi meglio.

Dal punto di vista concettuale, Trape lavora su tre livelli:

  • pagina osservata: una pagina web controllata dall’operatore riceve visite e raccoglie segnali tecnici;
  • pannello di analisi: le informazioni vengono mostrate in una dashboard;
  • azioni lato browser: il progetto documenta funzioni che possono diventare molto invasive se usate male.

Proprio per questo non ha senso trasformare Trape in una guida operativa passo passo. È molto più utile usarlo come caso studio per parlare di consenso, consapevolezza, sicurezza dei browser, link sospetti, permessi di geolocalizzazione, fingerprinting e formazione anti-phishing.

Cosa può insegnare a un’azienda

Trape è utile, in contesti autorizzati di formazione e security awareness, per mostrare perché non bisogna cliccare link ricevuti fuori contesto, perché i permessi del browser contano, perché la geolocalizzazione non va concessa con leggerezza e perché una pagina apparentemente innocua può raccogliere segnali tecnici.

La lezione pratica non è “usa Trape”. La lezione pratica è: capisci come vieni tracciato, così riduci la tua superficie esposta.

Tool 3: Blackbird, username, email e profili AI

Blackbird è un tool OSINT open source per cercare account collegati a username ed email su centinaia di piattaforme. Il progetto dichiara l’integrazione con WhatsMyName, una base dati molto usata per ridurre falsi positivi nella ricerca di username.

Schermata dimostrativa di Blackbird con analisi AI dei risultati OSINT
Blackbird integra anche una funzione AI per trasformare risultati grezzi in una prima lettura comportamentale e tecnica.

Come funziona Blackbird

Blackbird prende in input un nome utente o un indirizzo email e controlla se esistono account pubblici associati a quel dato. La logica è simile a quella di altri strumenti di username enumeration, ma con due elementi interessanti: la ricerca su molte piattaforme e la possibilità di generare output più leggibili, anche in PDF o CSV.

La funzione AI, secondo la documentazione del progetto, analizza i siti in cui un username o un’email vengono trovati e produce un profilo comportamentale e tecnico. Il README precisa anche un dettaglio importante: vengono inviati solo i nomi dei siti, non dati sensibili.

In pratica Blackbird può aiutare a rispondere a domande come:

  • questo nickname compare su molte piattaforme?
  • ci sono account potenzialmente collegati a una stessa identità pubblica?
  • quali categorie di siti emergono: developer, gaming, social, forum, marketplace?
  • il pattern sembra coerente o pieno di falsi positivi?
  • quali risultati meritano verifica manuale?

Dove entra l’AI

Blackbird mostra bene la differenza tra raccolta e interpretazione. La raccolta dice: “ho trovato risultati su questi siti”. L’interpretazione prova a dire: “questi risultati suggeriscono un certo profilo di attività”.

Qui il rischio è evidente: l’AI può trasformare segnali deboli in conclusioni troppo forti. Per questo, anche quando il report è ben scritto, conviene aggiungere sempre un livello di confidenza e una colonna “da verificare”.

Maigret, Trape e Blackbird a confronto

Tool Input principale Output Uso consigliato Attenzione
Maigret Username Dossier, report, grafi, esportazioni Audit di impronta digitale e ricerca su nickname Omonimie e falsi collegamenti
Trape Visita a pagina controllata Segnali tecnici e tracking Formazione difensiva e consapevolezza Consenso, legalità, rischio abuso
Blackbird Username o email Account trovati, export, profilo AI Ricerca rapida e reportistica Interpretazioni AI da verificare

Come usare l’AI senza farsi ingannare dall’AI

Il modo migliore per usare l’AI nell’OSINT è darle un compito da analista ordinato, non da indovino.

Un prompt utile può essere questo:

Analizza questi risultati OSINT.
Separa:
1. fatti verificabili;
2. collegamenti probabili;
3. ipotesi deboli;
4. falsi positivi possibili;
5. informazioni da non usare perché irrilevanti o troppo invasive.

Per ogni elemento indica:
- fonte;
- livello di confidenza;
- motivo della classificazione;
- controllo manuale consigliato.

Non identificare persone reali se le fonti non lo dimostrano.
Non trasformare coincidenze in certezze.

Questo tipo di richiesta costringe il modello a rallentare. Ed è una buona cosa. Nell’OSINT la fretta produce errori, e gli errori possono danneggiare persone.

Video per approfondire

Per approfondire i tre strumenti e il contesto OSINT, ecco alcuni video utili. Come sempre, guardali con spirito critico: i video tecnici invecchiano, i tool cambiano, e non tutto ciò che è dimostrabile è anche opportuno da fare.

Maigret: ricerca OSINT da username

Blackbird: username, email e ricerca account

Trape: caso studio su tracking e consapevolezza

OSINT e AI: quadro generale

I rischi da evitare

L’OSINT con l’AI è potente proprio perché sembra semplice. Inserisci un nickname, ottieni un report, chiedi al chatbot di riassumere. Il problema è che la semplicità dell’interfaccia nasconde la complessità del giudizio.

I rischi principali sono:

  • falsi positivi: due persone diverse possono usare lo stesso nickname;
  • profilazione eccessiva: raccogliere più dati del necessario può essere scorretto o illegale;
  • allucinazioni dell’AI: il modello può inventare collegamenti plausibili;
  • doxing: pubblicare o diffondere dati personali può causare danni reali;
  • effetto tunnel: una prima ipotesi sbagliata può guidare tutta l’indagine;
  • strumenti obsoleti: molti tool OSINT dipendono da siti che cambiano interfacce, blocchi e policy.

Da dove iniziare in modo responsabile

Il miglior primo esercizio non è investigare sugli altri. È fare OSINT su se stessi o sulla propria azienda, con finalità difensiva.

Puoi partire così:

  1. scegli un tuo nickname pubblico;
  2. cerca dove appare;
  3. controlla quali informazioni emergono dai profili;
  4. verifica vecchi account dimenticati;
  5. rimuovi o aggiorna ciò che non vuoi più lasciare pubblico;
  6. documenta le fonti e chiedi all’AI solo una sintesi ragionata;
  7. ripeti l’audit ogni sei mesi.

Questo esercizio ha un vantaggio: ti insegna a usare gli strumenti senza trasformare l’OSINT in curiosità invasiva. Ed è anche un buon modo per capire quanto siamo trasparenti online senza accorgercene.

In sintesi

Maigret, Trape e Blackbird mostrano tre facce diverse dell’OSINT. Maigret lavora bene sui nickname e sui report. Blackbird aggiunge ricerca su username ed email con una componente AI. Trape, invece, è un caso da trattare con cautela: utile per capire il tracking e difendersi, pericoloso se usato senza consenso.

L’intelligenza artificiale non sostituisce l’analista. Lo aiuta a leggere meglio, ordinare meglio e porsi domande migliori. Ma nell’OSINT, più che altrove, vale una regola semplice: un’informazione trovata non è ancora una verità. È solo l’inizio del lavoro.

Per approfondire il metodo, i casi d’uso e i confini etici, trovi il libro Il nuovo petrolio (online) sul sito di Ledizioni.

FAQ

Che cos’è l’OSINT?

L’OSINT, Open Source Intelligence, è la raccolta e analisi di informazioni disponibili da fonti aperte: siti, social, archivi pubblici, documenti, immagini, mappe, repository e altre fonti accessibili legalmente.

L’AI può fare OSINT da sola?

No. L’AI può aiutare a riassumere, classificare, tradurre e collegare informazioni, ma deve essere guidata da fonti verificabili e controllata da una persona. Può sbagliare o inventare collegamenti.

Maigret e Blackbird sono simili?

Sì, entrambi cercano tracce pubbliche collegate a username. Maigret è molto orientato ai dossier e ai report su nickname; Blackbird lavora su username ed email e include una funzione AI per sintetizzare i risultati.

Trape è sicuro da usare?

Trape va trattato con molta cautela. È utile come caso studio difensivo sul tracking web e sulla social engineering awareness, ma usarlo contro persone inconsapevoli può violare privacy, legge ed etica professionale.

Qual è il rischio principale dell’OSINT con l’AI?

Il rischio principale è trasformare segnali deboli in certezze. L’AI può rendere un report più leggibile, ma può anche amplificare errori, falsi positivi e collegamenti non dimostrati.

Da dove conviene iniziare?

Conviene iniziare con un audit personale o aziendale: cercare i propri nickname, verificare profili pubblici, documentare le fonti e usare l’AI solo per organizzare i risultati, non per trarre conclusioni non verificate.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Hai trenta secondi liberi?

Vai su LinkedIn. Clicca sulla tua foto profilo. Entra in Impostazioni e privacy, poi in Privacy dei dati e infine in Come LinkedIn usa i tuoi dati.

Troverai una voce chiamata “Dati per il miglioramento dell’AI generativa”.

Se è attiva, LinkedIn può utilizzare alcuni dei tuoi dati e contenuti pubblici per contribuire allo sviluppo e al miglioramento dei propri sistemi di intelligenza artificiale.

Puoi disattivarla con un semplice clic.

Perché dovresti farlo? Per una ragione molto semplice: la maggior parte delle persone non sa nemmeno che questa impostazione esiste. Non si tratta di allarmismo. Non significa che LinkedIn stia facendo qualcosa di illegale o nascosto. L’opzione è documentata e modificabile. Il punto è un altro: la consapevolezza.

Ogni giorno condividiamo post, commenti, articoli, esperienze professionali e informazioni sul nostro lavoro. Sono dati che raccontano chi siamo, come ragioniamo, quali competenze possediamo e quali problemi risolviamo.

L’intelligenza artificiale si nutre di dati. E quando un servizio ci offre la possibilità di scegliere se contribuire o meno all’addestramento e al miglioramento dei modelli, vale la pena sapere che quella scelta esiste.

La vera domanda non è se lasciare attiva o disattivare l’opzione. La vera domanda è: quante altre impostazioni simili abbiamo accettato senza leggerle?

Negli ultimi mesi l’AI generativa è entrata nelle aziende con una velocità impressionante. ChatGPT, Copilot, Gemini, Claude e decine di altri strumenti sono diventati parte della quotidianità lavorativa.

Molti dipendenti li utilizzano convinti che siano semplicemente una versione più evoluta di Google. Non è così.

Domani parleremo proprio di questo: perché alcuni strumenti di AI che sembrano innocui possono rappresentare un rischio per la privacy aziendale, quali informazioni vengono realmente condivise e che cosa il datore di lavoro può vedere o monitorare quando utilizzi determinate piattaforme.

Nel frattempo, controlla quella impostazione su LinkedIn. Trenta secondi. Un clic. E una maggiore consapevolezza digitale.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

C’è una scena che ormai vedo ovunque nei corsi: qualcuno carica un PDF su ChatGPT o su un altro strumento di intelligenza artificiale e dice “fammi un riassunto”. Domanda: cosa c’era dentro quel PDF? Nome, cognome, codice fiscale, partita IVA, email, indirizzi, magari dei clienti. E a quel punto non stai più usando l’AI: stai regalando dati personali.

Anonimizzare documenti e PDF prima di caricarli su ChatGPT, Copilot o altri strumenti AI non è un optional: è un passaggio fondamentale per proteggere la privacy, ridurre i rischi GDPR e lavorare in modo consapevole con l’intelligenza artificiale. In questa guida pratica scopri come farlo, quali dati rimuovere, quali strumenti usare e quando conviene lavorare in locale.

Il problema non è l’AI. È come la usi

L’intelligenza artificiale è uno strumento straordinario. Ma ha una caratteristica che spesso ignoriamo: non distingue tra dato utile e dato sensibile. Se carichi un documento “sporco”, lei lo elabora comunque. E tu sei responsabile di ciò che hai condiviso.

Come dici: chi diavolo lo fa?

L’intelligenza artificiale entra sempre più nelle aziende, ma non sempre viene utilizzata in modo sicuro. Secondo il Report 2025 di Cyberhaven, citato da Federprivacy, il 77% dei lavoratori copia e incolla dati aziendali sensibili in ChatGPT e altri chatbot AI. Tra le informazioni condivise figurano documenti interni, dati dei clienti e contenuti riservati. Un comportamento che può esporre le organizzazioni a rischi di violazione della privacy, perdita di proprietà intellettuale e problemi di conformità normativa. Per questo gli esperti sottolineano l’importanza di formazione, policy aziendali e strumenti di governance dedicati all’uso dell’AI generativa.

Ecco i rischi principali di caricare documenti non anonimizzati su piattaforme AI:

  • violazioni del GDPR (Regolamento Europeo sulla protezione dei dati personali)
  • perdita di controllo sui dati personali e aziendali
  • condivisione involontaria di informazioni riservate
  • esposizione di clienti, fornitori, dipendenti e collaboratori

Non è paranoia. È igiene digitale di base per chiunque usi l’intelligenza artificiale in modo professionale.

Quali dati personali rimuovere prima di usare l’intelligenza artificiale

Prima di caricare qualsiasi documento su un sistema AI, dovresti sempre rimuovere o oscurare questi elementi:

  • Nomi e cognomi di persone fisiche
  • Email e numeri di telefono
  • Codici fiscali e numeri di partita IVA
  • IBAN e dati bancari
  • Indirizzi e riferimenti geografici precisi
  • Dati sanitari e informazioni sulla salute
  • Segreti aziendali e informazioni riservate

Questa è la regola aurea dell’anonimizzazione: prima anonimizzi, poi usi l’AI. Dovrebbe essere una procedura standard, come lavarsi le mani prima di operare.

Come anonimizzare un PDF online con redactpdf.io

Dalle ricerche che ho condotto emerge uno strumento interessante: redactpdf.io. Si tratta di un servizio online progettato per anonimizzare documenti e PDF in modo rapido e sicuro.

Funziona così:

  • carichi il documento
  • il sistema individua automaticamente i dati sensibili
  • tu verifichi le modifiche proposte
  • scarichi il PDF anonimizzato

Semplice ed efficace.

Nella versione gratuita puoi caricare un documento alla volta (fino a 25 pagine), con una dimensione massima di 5 MB.

È sicuro usare redactpdf.io?

Lo strumento dichiara espressamente:

  • crittografia dei documenti durante il trattamento
  • elaborazione lato browser o in ambiente sicuro
  • nessun uso di AI di terze parti per l’elaborazione
  • server situati in Europa (infrastruttura EU-compliant)
  • cancellazione immediata dei file dopo il download
  • nessun account richiesto per utilizzare il servizio

Tradotto: privacy by design. Un approccio che mette la protezione dei dati al centro del processo di anonimizzazione.

Il punto critico che molti ignorano

“Uso uno strumento sicuro, quindi sono a posto”.

Non è così.

Il vero problema non è lo strumento. È il processo. Se tu:

  • carichi il file sbagliato
  • dimentichi un dato sensibile
  • non controlli l’output prima di usarlo

hai già perso. L’AI aiuta, ma non sostituisce la responsabilità umana. Anonimizzare documenti per l’AI richiede sempre una verifica finale da parte tua.

OpenAI lancia Privacy Filter

C’è una novità che merita attenzione da parte di chi usa l’intelligenza artificiale in azienda, negli studi professionali o nella Pubblica Amministrazione: OpenAI ha presentato Privacy Filter, un modello open-weight progettato per individuare e oscurare dati personali nei testi prima che vengano elaborati da altri sistemi di intelligenza artificiale.

Secondo OpenAI, il modello può funzionare anche in locale, senza inviare contenuti nel cloud. Questo aspetto è cruciale per settori delicati come sanità, legale, HR, finanza e pubblica amministrazione.

Come funziona? Si scarica il modello dalla pagina ufficiale di OpenAI o dal repository indicato e si installa in ambiente locale tramite Python, usando librerie come Transformers o vLLM. Un approccio che mette il controllo dei dati nelle mani dell’utente, non del fornitore del servizio.

Microsoft Presidio: la soluzione per anonimizzare dati in locale

Se lavori con dati sensibili (aziende, PA, sanità), la domanda è un’altra: ha senso usare strumenti online? Spesso la risposta è no.

Qui entra in gioco un approccio più solido, come quello di Microsoft Presidio, un framework open source progettato per:

  • rilevare dati personali (PII) nei testi e nei documenti
  • anonimizzare testi e documenti in modo automatizzato
  • lavorare su dati strutturati e non strutturati
  • funzionare in ambienti controllati, anche on-premise

Non è plug-and-play come redactpdf.io. Ma è molto più governabile. E quando gestisci dati veri, la governance vale più della comodità.

Workflow sicuro per usare documenti con l’intelligenza artificiale

Ti propongo una procedura concreta, replicabile subito:

  1. Classifica il documento
    • contiene dati personali?
    • contiene dati sensibili?
    • contiene segreti aziendali?
  2. Scegli il livello di protezione
    • basso rischio → tool online
    • medio rischio → tool verificati + revisione manuale
    • alto rischio → solo strumenti locali
  3. Anonimizza
    • automatico (AI o tool dedicati)
    • manuale (controllo umano)
  4. Verifica
    • rilettura completa del documento
    • ricerca di pattern (email, numeri, nomi)
  5. Solo ora usa l’AI

Questo è il punto: l’AI è l’ultimo passo, non il primo. Il workflow sicuro per documenti con l’AI parte sempre dall’anonimizzazione.

Una domanda scomoda (ma necessaria)

Se quel documento finisse online domani, cosa succederebbe?

Se la risposta è “nulla”, sei tranquillo.

Se la risposta è “un problema”, allora devi cambiare processo.

FAQ sull’anonimizzazione dei documenti per l’intelligenza artificiale

Come anonimizzare un PDF prima di caricarlo su ChatGPT?

Prima di caricare un PDF su ChatGPT, conviene rimuovere o oscurare nomi, email, numeri di telefono, codici fiscali, IBAN, indirizzi e altri dati personali. Puoi farlo con strumenti di redazione automatica come redactpdf.io oppure manualmente, ma è sempre importante controllare il file finale prima di usarlo con l’AI.

Quali dati personali vanno rimossi da un documento prima di usare l’AI?

In generale vanno rimossi tutti i dati che identificano direttamente o indirettamente una persona: nome e cognome, email, telefono, indirizzo, codice fiscale, partita IVA, IBAN, dati sanitari, riferimenti geografici precisi e informazioni aziendali riservate.

È sicuro usare strumenti online per anonimizzare documenti?

Dipende dal tipo di documento e dal livello di rischio. Per file poco critici può avere senso usare tool online verificati con infrastruttura europea e policy GDPR-compliant. Per contenuti sensibili o riservati è preferibile lavorare in locale o in ambienti controllati con strumenti come Microsoft Presidio o OpenAI Privacy Filter.

Che cos’è OpenAI Privacy Filter?

OpenAI Privacy Filter è un modello open-weight pensato per individuare e oscurare informazioni personali nei testi prima che vengano elaborati da altri sistemi AI. Secondo la documentazione ufficiale, il modello può funzionare anche in locale, senza inviare contenuti nel cloud. È particolarmente indicato per settori come sanità, legale, HR, finanza e pubblica amministrazione.

Microsoft Presidio serve per anonimizzare documenti?

Sì. Microsoft Presidio è un framework open source usato per rilevare e anonimizzare PII (Personally Identifiable Information) nei testi e in altri contenuti. Si integra bene in flussi di lavoro aziendali e può funzionare anche on-premise, offrendo un controllo maggiore rispetto ai semplici tool online.

Qual è il metodo più sicuro per usare documenti con l’intelligenza artificiale?

Il metodo più prudente è questo: classificare il documento in base al livello di rischio, scegliere il livello di protezione adeguato, anonimizzare i dati personali, verificare manualmente il risultato e solo alla fine usare l’AI. L’intelligenza artificiale deve essere l’ultimo passo, non il primo.

Gli algoritmi, spesso, sono programmati per fare cose a noi poco comprensibili. È il caso di una piattaforma come Instagram che sembra prediligere le foto di uomini e donne in costume da bagno o, comunque, poco vestiti (come evidenziato da questo articolo di Open). Le preferenze dell’algoritmo di proprietà di Meta, purtroppo, possono influenzare non solo il comportamento delle principali star della piattaforma (influencer e creatori di contenuti) ma anche il destino di aziende che si affidano a Instagram per vendere i propri prodotti.

È il caso di Marco (nome fittizio), un piccolo imprenditore che vive in una grossa città del Vecchio Continente e promuove i prodotti creati dalla sua azienda attraverso i canali social. Di che cosa si occupa la piccola impresa di Marco? La sua azienda produce delle barrette energetiche studiate appositamente per gli sportivi. Il reparto marketing di Marco utilizza le piattaforme social per attirare nuove clienti e per fidelizzare quelli più affezionati. In Europa i social network di proprietà di Mark Zuckerberg la fanno da padrone e una presenza su questi canali è fondamentale per il successo della propria azienda. Instagram, in particolare, punta tutto su foto e video. Marco e i suoi responsabili del reparto marketing hanno scoperto che “solo” alcuni dei numerosi post pubblicati hanno raggiunto gli oltre 100.000 follower della propria azienda. In particolare, è stato notato che le foto e i video che hanno funzionato meglio sono quelle che avevano come soggetto alcune modelle in bikini o in attillate tute sportive. Giovanna, autrice di una serie libri di successo, ha dichiarato che le foto più apprezzate dai suoi fan sono quelle che la ritraggono in costume di bagno o con addosso qualche sexy minigonna.

Purtroppo, l’algoritmo di Instagram sembra essere attratto da uomini e donne poco vestiti: per chi si affida alla piattaforma di Meta per lanciare le proprie campagne marketing è un problema non da poco. E, soprattutto, proporre foto e video di questo tipo per un’azienda potrebbe essere qualcosa che va contro i propri valori.

Come funziona l’algoritmo di Instagram?

Per capire come funziona l’algoritmo di Instagram e come vengano effettuate certe scelte, un organismo come l’European Data Journalism Network e un sito come AlgorithmWatch hanno condotto un interessante esperimento. Sono stati selezionati 26 volontari a cui è stato chiesto di installare un’estensione per il browser e di seguire un certo numero di influencer/creatori di contenuti. Nello specifico, sono stati selezionati 37 personaggi (di cui 14 uomini) provenienti da 12 diversi paesi che utilizzano Instagram per pubblicizzare marchi o acquisire nuovi clienti per le loro attività, principalmente nei settori food, viaggi, fitness, moda e bellezza.

L’estensione aggiunta al browser ha permesso di controllare automaticamente l’home page di Instagram a intervalli regolari, monitorando i post visualizzati in cima ai newsfeed. In questo modo i ricercatori hanno potuto avere una panoramica dettagliata di quello che l’algoritmo considera rilevante per ogni utente che ha partecipato all’esperimento. Nell’arco di tre mesi sono stati analizzati qualcosa come 1.737 post (contenenti 2.400 foto):

Il 21% del materiale pubblicato conteneva immagini di donne in bikini o in biancheria intima o di uomini a torso nudo.

In particolare, nei feed dei partecipanti all’esperimento i post con immagini di questo tipo arrivavano al 30% (alcuni contenuti sono stati mostrati più di una volta). In particolare, i post che contenevano immagini di donne con indumenti intimi o in bikini avevano il 54% di probabilità in più di apparire nel feed delle notizie degli utenti partecipanti all’esperimento. I post contenenti immagini di uomini a torso nudo, invece, avevano il 28% di probabilità in più di essere mostrati; quelli con cibo o paesaggi avevano circa il 60% in meno di probabilità di essere visualizzati nel feed delle notizie.

A Instagram piacciono i costumi da bagno

La “propensione” di Instagram verso i corpi umani poco vestiti potrebbe non essere applicabile a ogni contesto e a ogni utente presente sulla piattaforma: la personalizzazione e altri fattori possono arginare/amplificare questo fenomeno. Interpellata sulla questione, Meta ha sostenuto che la ricerca condotta fosse viziata in partenza, ribadendo che la classificazione sulle sue piattaforme funziona in base ai contenuti per i quali un utente mostra interesse, e non per la presenza di qualche sexy costume da bagno. Senza avere accesso ai dati ufficiali di Meta è difficile trarre delle conclusioni anche se c’è la forte convinzione tra i ricercatori che i risultati ottenuti siano abbastanza “rappresentativi” del funzionamento generale di Instagram.

In ogni caso, grazie ai whistleblower, sappiamo che Meta è consapevole dei danni che sta facendo sui teenager:

La metrica del coinvolgimento

Gli ingegneri di Meta hanno più volte affermato (le informazioni sono state recuperate attraverso i brevetti presentati) che l’algoritmo di Instagram analizza ogni immagine pubblicata sulla piattaforma assegnandogli una “metrica per misurare il coinvolgimento” che tiene conto dei comportamenti degli utenti. Per esempio, se a una persona piace un brand particolare e una foto mostra un prodotto di quello stesso marchio, la metrica di coinvolgimento aumenta. Altri parametri come il sesso, la provenienza e lo stato di vestizione delle persone in una foto possono influenzare il calcolo di questo parametro.

Sulla piattaforma, però, viene specificato che l’elenco dei contenuti proposto viene organizzato in base agli interessi degli utenti. Nel brevetto registrato da Facebook (ora Meta) nel 2015 veniva spiegato come l’algoritmo fosse in grado di classificare i contenuti in base a quello che potesse interessare agli utenti presenti sulla piattaforma.

Le immagini pubblicate possono essere visualizzate nei newsfeed di uno o più utenti in base al loro storico (i comportamenti tenuti finora) ma anche prestando attenzione alle preferenze stesse di Instagram, che può decidere arbitrariamente quello che può essere coinvolgente per i frequentatori della sua piattaforma. Facebook, per esempio, analizza automaticamente le immagini con un software specifico prima che il suo algoritmo decida quali mostrare nel newsfeed di un utente. L’intelligenza artificiale è stata addestrata attraverso migliaia di immagini che sono state analizzate manualmente: questa modalità tende a influenzare il modo in cui Instagram assegna le priorità nei feed di notizie.

Tutta colpa dell’IA?

Questo sistema, purtroppo, non è esente da problemi come sanno benissimo programmatori e ingegneri informatici: si possono verificare delle correlazioni spurie o fallaci. Per esempio, un algoritmo allenato a riconoscere lupi e cani attraverso una serie di immagini specifiche, non sempre riuscirà a identificare questi animali con la precisione di un essere umano. È possibile che consideri un lupo qualsiasi altro animale presente su uno sfondo con neve.

I dati che alimentano gli algoritmi nella maggior parte dei casi non sono di grande qualità (principalmente per una questione economica) e spesso vengono tralasciati dettagli e variabili che potrebbero fare la differenza nei sistemi automatizzati. Le conseguenze, alle volte, possono essere spiacevoli: lo scorso anno un artista brasiliano ha visto bloccati alcuni post su Instagram perché conteneva dei contenuti ritenuti violenti; peccato che le immagini raffigurassero il sette volte campione del mondo della F1 Lewis Hamilton e un ragazzino. Entrambi avevano la pelle scura. Un’insegnante di yoga di asiatica-americana è stata protagonista di un altro episodio particolare: una foto che la ritraeva nella posizione della gru laterale è stata bloccata perché secondo l’algoritmo di Instagram era volgare. Le linee guida di Instagram affermano che la nudità “non è consentita” ma la piattaforma sembra favorire quei post che mostrano centimetri e centimetri di pelle umana. La differenza tra quello che è lecito e quello che non lo è davvero sottile: il rischio di essere cacciati dalla piattaforma è sempre dietro l’angolo.

Giovanna, Marco e molti altri imprenditori che si affidano a Instagram per le loro campagne marketing avevano il terrore di parlare con i media. La maggior parte dei creatori di contenuti professionisti teme ritorsioni da parte di Meta sotto forma di cancellazione dell’account o divieti nascosti (per esempio i post mostrati a pochissimi follower o a nessuno!): una vera e propria condanna a morte per loro attività.

L’introduzione in Europa del GDPR sulla protezione dei dati nel 2018 e la promulgazione del Regolamento europeo Platform to Business (P2B) nel 2020 hanno obbligato i servizi di intermediazione online a rendere noti i principali parametri che determinano il ranking algoritmico. Purtroppo, nessuna autorità, a livello europeo o all’interno degli stati membri, ha il potere o gli strumenti necessari per controllare quello che fanno Meta, Google, Microsoft, Amazon e compagnia bella. Sebbene la discriminazione basata sul genere sia vietata dalla Carta dei diritti fondamentali dell’Unione europea, non esistono attualmente vie legali che permettano a un utente di avviare un procedimento contro la piattaforma di Meta.

Alcune organizzazioni/sindacati combattono per i diritti dei creatori indipendenti sui social media: sono già partite una serie di azioni collettive contro Google per chiedere una maggiore equità e trasparenza sulle politiche attuate su YouTube. Instagram, per ora, non è stato toccato: gli imprenditori e le imprenditrici sono costretti a rispettare le regole stabilite dagli ingegneri di Facebook se vogliono avere la possibilità di guadagnarsi da vivere…