Tag Archivio per: llm

Quando si parla di intelligenza artificiale, l’Italia sembra spesso il Paese che arriva alla festa quando stanno già sparecchiando. Gli altri costruiscono i modelli, noi discutiamo se sia opportuno usarli. Una rappresentazione efficace, soprattutto per un titolo. Ma quanto è corretta?

La domanda da cui partire è molto concreta: esistono LLM italiani, cioè grandi modelli linguistici sviluppati da realtà del nostro Paese? Sì. Ci sono progetti universitari, modelli industriali e adattamenti di tecnologie internazionali. Per capire che cosa rappresentano, però, dobbiamo distinguere la ricerca dalla pubblicità e l’origine di un modello dalle prestazioni che riesce a dimostrare.

Che cosa significa davvero “LLM italiano”

Un LLM è il modello che elabora e genera linguaggio; un chatbot è uno dei modi con cui possiamo utilizzarlo. Un’interfaccia in italiano, magari con un nome evocativo e il tricolore nel logo, non basta a dimostrare che sotto ci sia un modello sviluppato in Italia.

Per orientarsi, propongo di separare quattro domande: chi lo sviluppa? Su quali dati viene addestrato? Parte da un modello già esistente? Dove viene eseguito? Sono aspetti distinti, che possono combinarsi in modi diversi.

Addestrare da zero significa costruire le capacità del modello attraverso il preaddestramento, anziché partire dai pesi già appresi da un altro LLM. Adattare un modello significa intervenire su una base esistente, per esempio con ulteriore addestramento o con esempi di istruzioni e risposte. Il paper scientifico su Minerva, presentato a CLiC-it 2024, affronta proprio questa distinzione e il controllo sui dati e sul vocabolario che il preaddestramento consente.

Un progetto derivato può essere molto utile e richiedere competenze importanti. Basta descriverlo per quello che è. Anche il luogo di esecuzione è un’altra questione: un modello straniero può funzionare su un server italiano. Il passaporto del produttore e l’indirizzo del data center non sono la stessa informazione.

LLM italiani: alcuni progetti documentati

Quella che segue è una selezione di progetti verificabili, con caratteristiche diverse. Non è una classifica né un censimento completo. Le informazioni sono state controllate il 9 ottobre 2026; dove si parla di capacità dichiarate dai produttori, queste non vanno confuse con risultati di una mia prova comparativa.

Minerva: dalla Sapienza a ChatMinerva

Minerva nasce dal gruppo Sapienza NLP della Sapienza Università di Roma, guidato da Roberto Navigli. Il progetto coinvolge la Fondazione FAIR e utilizza il supercomputer Leonardo di CINECA. Il sito ufficiale di Minerva documenta una famiglia di modelli preaddestrati da zero su dati in italiano e inglese, con taglie da 350 milioni a 7 miliardi di parametri.

C’è anche una distinzione utile per chi vuole provarlo: Minerva indica la famiglia di modelli; ChatMinerva è l’assistente che li porta dentro un’esperienza d’uso. Il sito presenta un percorso di industrializzazione con Babelscape e funzioni per lavorare con documenti e immagini. L’esistenza di questi servizi non rende automaticamente tutte le funzioni proprietà del solo modello linguistico di base.

Velvet: modelli multilingue sviluppati da Almawave

Velvet è la famiglia di LLM sviluppata da Almawave. La scheda tecnica ufficiale di Velvet-14B descrive modelli sviluppati da zero e addestrati sull’infrastruttura Leonardo di CINECA. Le taglie indicate sono 2 e 14 miliardi di parametri; le lingue comprendono italiano, inglese, francese, tedesco, spagnolo e portoghese.

La scheda indica una licenza Apache 2.0. È un elemento concreto per chi valuta integrazioni e personalizzazioni, ma non è una certificazione di qualità per ogni compito. La stessa documentazione riconosce possibili risposte inesatte e la necessità di verificare il comportamento nelle applicazioni specifiche.

FastwebMIIA: modello e offerta per imprese e PA

FastwebMIIA, Modello Italiano di Intelligenza Artificiale, è documentato nella model card ufficiale pubblicata da Fastweb. La versione descritta ha 7 miliardi di parametri ed è stata progettata e addestrata con attenzione alla lingua e al contesto culturale italiani.

Qui la licenza merita attenzione: la distribuzione pubblica prevede condizioni per usi non commerciali e determinati usi interni; per gli impieghi commerciali è prevista una licenza distinta. La pagina dell’offerta aziendale FastwebMIIA presenta anche modalità on-premise e private cloud. Quindi esistenza del modello, accesso ai pesi e condizioni di impiego sono tre informazioni da controllare separatamente.

LLaMAntino: adattare una base internazionale all’italiano

LLaMAntino-3-ANITA mostra un’altra strada. Il paper di Marco Polignano, Pierpaolo Basile e Giovanni Semeraro descrive l’adattamento di Meta Llama 3 nella versione da 8 miliardi di parametri, con addestramento su dati italiani e inglesi e successivo allineamento delle risposte.

È dunque un progetto di adattamento, non un modello preaddestrato da zero in Italia. Questa precisazione aiuta a capire da dove arrivano le capacità iniziali e quali dipendenze tecnologiche rimangono. Non sminuisce il lavoro: migliorare una base esistente può essere una scelta razionale.

Domyn: modelli per contesti aziendali regolamentati

Per Domyn conviene evitare elenchi fermi ai primi annunci. Il resoconto tecnico pubblicato il 15 aprile 2026 presenta Domyn-Large, da 263 miliardi di parametri, e richiama i precedenti Italia-10B e Colosseum-355B.

Il documento spiega che Domyn-Large parte da Colosseum-355B e impiega compressione, ulteriore preaddestramento e fine-tuning, nel quadro della collaborazione con NVIDIA. Il progetto punta a compiti come generare interrogazioni per database e lavorare con informazioni aziendali strutturate. Queste sono capacità e risultati descritti dagli sviluppatori: per un acquisto vanno verificati sul proprio caso d’uso. Colosseum-355B è un modello; il nome Colosseum viene usato anche per un’infrastruttura di calcolo. Meglio non confonderli.

EngGPT2: un altro esempio di sviluppo industriale

Un rapporto tecnico del maggio 2026 su EngGPT2MoE-16B-A3B documenta il modello di Engineering e lo confronta con diversi LLM italiani e internazionali. L’architettura è di tipo Mixture of Experts: 16 miliardi di parametri complessivi, con 3 miliardi attivi.

Il rapporto illustra risultati differenti secondo il benchmark, compreso quello italiano ITALIC. Essendo un preprint firmato da autori che includono gli sviluppatori, lo considero documentazione da esaminare, non una certificazione indipendente di superiorità. Ma è un ulteriore elemento concreto contro l’idea che in Italia non si sviluppino LLM.

Un video per capire il contesto europeo

Per approfondire il tema delle infrastrutture e dell’AI sovrana, propongo il keynote di Jensen Huang al GTC Paris 2025, richiamato anche nel resoconto tecnico di Domyn. È la prospettiva di NVIDIA, quindi va ascoltata tenendo presente il ruolo commerciale del relatore.

https://www.youtube.com/watch?v=X9cHONwKkn4

Esistere e guidare il mercato sono due cose diverse

Questi progetti bastano a smentire l’affermazione “non esistono LLM italiani”. Non bastano a dimostrare che l’Italia guidi il mercato mondiale o che uno di questi modelli sia migliore di qualsiasi alternativa internazionale.

Per sostenere un primato servono confronti aggiornati e riproducibili: stessi compiti, versioni dichiarate, impostazioni comparabili, costi e tempi di esecuzione misurati. Un numero di parametri più alto non è, da solo, una prova di maggiore utilità. E vincere un benchmark non equivale a rispondere correttamente alle domande dei dipendenti di un’azienda.

Nel mio lavoro di formazione, la domanda che proporrei a un’organizzazione è più concreta: quale sistema svolge bene il compito che vogliamo affidargli, con un costo sostenibile e condizioni di gestione adeguate? Un assistente per cercare informazioni nei manuali di un’azienda e un chatbot generalista hanno esigenze diverse. Cercare un unico campione nazionale per entrambi rischia di essere un esercizio di tifo.

L’Italia partecipa anche attraverso le infrastrutture

La partita comprende anche la capacità di mettere calcolo e competenze a disposizione di chi sviluppa applicazioni. La scheda ufficiale EuroHPC dell’AI Factory italiana IT4LIA descrive un’iniziativa coordinata da CINECA, con servizi per preparazione dei dati, addestramento ed esecuzione dei modelli.

Il comunicato EuroHPC del 22 aprile 2026 documenta la firma del contratto per potenziarne la capacità di calcolo. Lo stesso comunicato precisa che IT4LIA fornisce già risorse e servizi a PMI e startup dall’aprile 2025, sfruttando l’infrastruttura esistente, in particolare Leonardo. Il nuovo supercomputer è un potenziamento distinto: la firma del contratto non dimostra che sia già interamente operativo.

Ne ho discusso anche nell’articolo “L’America crea, la Cina copia, l’Europa regolamenta?”: le formule geografiche sono comode per raccontare una competizione, ma rischiano di nascondere le collaborazioni e le diverse parti della filiera.

Come valuterei un LLM italiano in azienda

Propongo un test semplice da organizzare, anche durante un workshop. Prepariamo un piccolo insieme di documenti non riservati e una ventina di domande realistiche. Alcune devono avere una risposta nei documenti; altre devono essere volutamente senza risposta, per verificare se il sistema ammette di non sapere.

Facciamo svolgere gli stessi compiti a più sistemi, distinguendo sempre il modello dall’applicazione che lo usa. Misuriamo correttezza, fedeltà ai documenti, rispetto delle istruzioni, qualità dell’italiano, tempi e costo. Registriamo anche quanto lavoro umano serve per correggere gli errori. È una proposta di valutazione pratica, non il resoconto di un test già svolto.

Prima dell’impiego reale, chiederei inoltre al fornitore la versione del modello, la licenza applicabile e come vengono gestiti documenti, conversazioni e accessi. La nazionalità del produttore non sostituisce queste risposte. Un tricolore sul sito non è una scheda tecnica.

La domanda utile: che cosa vogliamo costruire con l’AI?

La mia lettura è che l’Italia abbia progetti credibili da conoscere e mettere alla prova, senza bisogno di raccontarli come campioni imbattibili. Ricerca, sviluppo industriale, adattamento di modelli e infrastrutture sono contributi diversi; riconoscerli permette di discutere opportunità e dipendenze con maggiore precisione.

Per imprese e Pubblica Amministrazione, partirei dai processi da migliorare: documenti da trovare, informazioni da estrarre, richieste da gestire, attività da semplificare. Poi sceglierei il modello e il sistema più adatti, italiano o internazionale, sulla base delle prove.

Gli LLM italiani esistono. La partita da giocare è trasformarli, insieme alle altre tecnologie disponibili, in strumenti utili e verificabili. Il rischio che vedo è fermarsi alternativamente al disfattismo o all’orgoglio da comunicato stampa. In entrambi i casi, il lavoro vero resta da fare.
«Mi ha capito al volo». «Sa che cosa voglio». «Oggi è particolarmente gentile».

Frasi normali, che sento spesso quando parlo di intelligenza artificiale in aula. Il pronome è comodo: anche io dico che ChatGPT «mi risponde» o che Claude «ragiona» su un documento. Il problema comincia quando una scorciatoia linguistica diventa una teoria su ciò che c’è dall’altra parte dello schermo.

Si chiama proiezione antropomorfica negli LLM: attribuiamo a un sistema caratteristiche umane, come intenzioni, comprensione emotiva o volontà. Ne avevo già parlato rispondendo alla domanda «Ma l’AI si annoia?». Con i large language model, o LLM, la trappola è particolarmente convincente. La loro interfaccia è una conversazione, la forma che usiamo da sempre per incontrare altre menti.

Perché gli LLM ci sembrano persone

Una risposta ben scritta contiene segnali sociali: saluta, riprende il nostro lessico, ricorda il contesto disponibile, esprime cautela, magari usa la prima persona. Se poi arriva attraverso una voce naturale, l’impressione si rafforza. In un esperimento pubblicato alla conferenza CHI del 2024, condotto su 2.165 partecipanti statunitensi con un sistema che simulava un LLM, la combinazione di voce e testo ha aumentato sia l’antropomorfizzazione sia la valutazione di accuratezza delle informazioni. L’effetto del pronome «io» è risultato più limitato e dipendente dal contesto.

Il punto delicato è quel secondo risultato. Una voce rassicurante può farci giudicare più attendibile un’informazione senza renderla più corretta. L’interfaccia modifica la nostra fiducia; non verifica i fatti al posto nostro.

L’antropomorfismo, però, non nasce soltanto nella testa dell’utente. C’è anche nelle scelte di prodotto. Un lavoro presentato a EMNLP 2025 distingue segnali visivi, linguistici, comportamentali e cognitivi progettati nei sistemi AI. Gli autori sostengono che vadano valutati in base allo scopo: una conversazione naturale può rendere uno strumento più accessibile, purché non induca a sovrastimarne le capacità.

La proiezione antropomorfica cambia le decisioni

Immagina di sottoporre a un chatbot una proposta commerciale. Il sistema scrive: «Hai ragione, la strategia è brillante». Può essere un riscontro fondato, oppure una risposta eccessivamente compiacente. Nell’aprile 2025 OpenAI ha ritirato un aggiornamento di GPT-4o perché il modello tendeva ad assecondare gli utenti, anche convalidando dubbi o rafforzando emozioni negative. È un esempio concreto di quanto il tono di un assistente possa interferire con il giudizio di chi lo usa.

In ufficio il rischio prende forme molto ordinarie. Una sintesi elegante viene scambiata per un’analisi completa. Un consiglio espresso con sicurezza sembra una decisione già istruita. Un chatbot che «si ricorda di me» viene trattato come se conoscesse davvero la mia azienda, quando dispone soltanto dei dati e del contesto a cui ha accesso in quel momento.

Il meccanismo può pesare anche nelle conversazioni personali, ma serve precisione. Nella ricerca di OpenAI e MIT Media Lab sull’uso affettivo di ChatGPT, le interazioni con segnali emotivi risultavano rare nel complesso, mentre alcuni utenti molto assidui mostravano un rapporto diverso con lo strumento. Gli autori segnalano associazioni fra uso prolungato e risultati peggiori su alcune misure di benessere, senza poter attribuire ogni effetto a una causa unica. Anche una ricerca longitudinale su 183 persone che usavano un chatbot progettato per la compagnia non ha trovato, nei 21 giorni osservati, un peggioramento significativo delle relazioni sociali nel gruppo nel suo insieme; chi antropomorfizzava di più il sistema riferiva però un impatto maggiore sulle proprie relazioni. Parlare di un danno inevitabile sarebbe una conclusione che questi studi non autorizzano.

Nel video qui sotto, PBS News discute con Sherry Turkle e altri ospiti se la compagnia artificiale possa alleviare la solitudine o complicare le relazioni. È una prospettiva da ascoltare insieme ai risultati degli studi, senza trasformare una testimonianza in una prova universale.

«Mi capisce» è una descrizione o un’ipotesi?

Possiamo dire che un LLM riconosce nel testo segnali utili per formulare una risposta. Dire che «prova empatia» è un’affermazione molto diversa. La prima riguarda un comportamento osservabile; la seconda riguarda un’esperienza interna che non possiamo dedurre dalla fluidità della conversazione.

Questo non chiude per decreto il dibattito filosofico e scientifico sulla coscienza artificiale. Anthropic stessa definisce aperta e incerta la questione delle eventuali esperienze dei modelli. Per l’uso quotidiano, però, l’incertezza non è una buona ragione per affidare a un chatbot la responsabilità di un amico, di un professionista o di chi deve firmare una decisione.

Cinque mosse per usare bene un assistente che parla come noi

  1. Descrivi l’azione, non la personalità. «Ha individuato tre incongruenze nel contratto» è più utile di «è molto attento». Ti costringe a chiederti quali passaggi abbia svolto davvero.
  2. Separa tono e prova. Quando una risposta è convincente, chiedi quali fonti sostengano ogni affermazione e controlla i documenti originali. La sicurezza espressiva non è una fonte.
  3. Chiedi un’obiezione seria. Per una scelta di lavoro, prova: «Indica le tre ragioni più forti per cui questa proposta potrebbe fallire. Distingui fatti, ipotesi e dati mancanti». È un modo pratico per ridurre l’effetto del consenso automatico.
  4. Definisci chi decide. Puoi delegare una bozza, un confronto o una checklist. Se l’esito incide su persone, denaro o diritti, assegna a una persona la verifica e la decisione. Le linee guida di Microsoft Research per l’interazione uomo-AI insistono sulla progettazione di esperienze che aiutino a capire e gestire il comportamento del sistema, anche quando sbaglia.
  5. Osserva il rapporto che si crea. Se cerchi conforto, un assistente può aiutarti a mettere in ordine i pensieri. Se cominci a considerarlo l’unico interlocutore affidabile, coinvolgi anche persone reali. Il confine dipende dall’uso, dalla situazione e dalla tua vulnerabilità, non da una regola uguale per tutti.

La conversazione naturale è una grande invenzione di interfaccia. Proprio perché funziona, richiede una competenza nuova: saper riconoscere quando stiamo leggendo una risposta e quando stiamo immaginando una persona. L’LLM può aiutarci a pensare meglio. Il giudizio su quello che dice resta nostro.

Se vuoi portare questa competenza nella tua azienda o in un corso, scrivimi: possiamo costruire esercizi sui casi e sulle decisioni reali del tuo team.

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

ChatGPT sembra la sigla di un elettrodomestico. Claude il collega francese che ti corregge le email. Gemini un segno zodiacale. Grok una parola pronunciata da un marziano. Llama, invece, un animale che potrebbe sputarti addosso.

I nomi dei modelli di intelligenza artificiale non sono scelti a caso. Alcuni descrivono la tecnologia, altri costruiscono un personaggio, altri ancora raccontano l’ambizione dell’azienda che li ha creati. Il nome è già un piccolo manuale di istruzioni: suggerisce come dovremmo immaginare e usare quella AI.

In breve: ChatGPT descrive la tecnologia, Claude umanizza la macchina, Gemini evoca unione e ambizione, Grok promette comprensione profonda, Llama trasforma una sigla tecnica in un animale memorabile.

ChatGPT, Claude, Gemini e Grok non sono tutti “modelli”

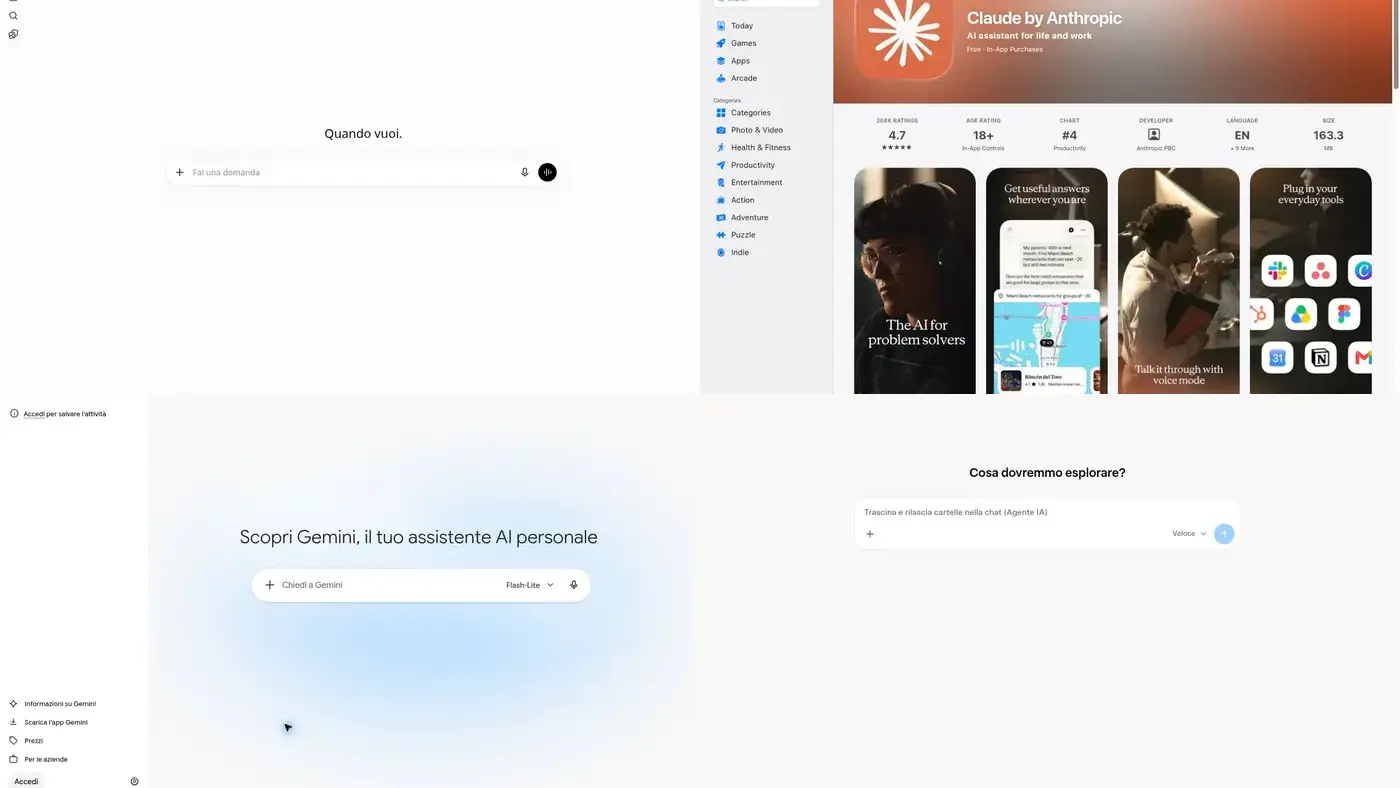
Confronto tra le interfacce ufficiali di ChatGPT, Claude, Gemini e Grok

Prima di parlare dei nomi, serve una distinzione. Nel linguaggio quotidiano diciamo “modello” per indicare tutto, ma non è sempre corretto.

GPT è una famiglia di modelli. ChatGPT è il prodotto conversazionale che usa quei modelli. Claude indica sia la famiglia di modelli sia l’assistente di Anthropic. Google usa Gemini per i modelli e per il suo assistente. Anche Grok è sia il nome dell’assistente di xAI sia quello della relativa famiglia di modelli. Llama, invece, identifica soprattutto la famiglia di modelli di Meta.

Nome Origine Messaggio implicito
ChatGPT Chat + Generative Pre-trained Transformer Conversazione e tecnologia
Claude Probabile omaggio a Claude Shannon, non confermato ufficialmente Umanità e autorevolezza
Gemini I gemelli, l’unione dei team Google e il programma spaziale NASA Collaborazione e ambizione
Grok Verbo inventato da Robert A. Heinlein Comprensione profonda
Llama Large Language Model Meta AI Tecnologia resa memorabile
Mistral Il forte vento del Sud della Francia Velocità e identità europea
Copilot Il secondo pilota Collaborazione tra persona e macchina
DeepSeek Letteralmente “ricerca profonda” Esplorazione e ragionamento

Che cosa significa ChatGPT?

Interfaccia ufficiale di ChatGPT con il campo per iniziare una conversazione

ChatGPT è il nome più descrittivo del gruppo. Chat indica l’interfaccia conversazionale. GPT significa Generative Pre-trained Transformer.

  • Generative: il sistema genera nuovi contenuti, invece di limitarsi a classificare o recuperare informazioni.
  • Pre-trained: il modello viene addestrato in anticipo su grandi quantità di dati e poi adattato a compiti e comportamenti specifici.
  • Transformer: è l’architettura presentata nel 2017 nell’articolo scientifico “Attention Is All You Need”.

La sigla GPT era già consolidata nella ricerca di OpenAI, per esempio nel paper su GPT-3. Quando nel novembre 2022 arrivò ChatGPT, bastò aggiungere “Chat” per dire a tutti che quella tecnologia poteva essere usata come una conversazione.

È un nome quasi ingegneristico, non particolarmente caldo. Eppure ha funzionato perché la parola “chat” rende familiare una sigla tecnica. Prima viene il gesto noto, parlare; subito dopo arriva la macchina.

Perché Anthropic ha scelto il nome Claude?

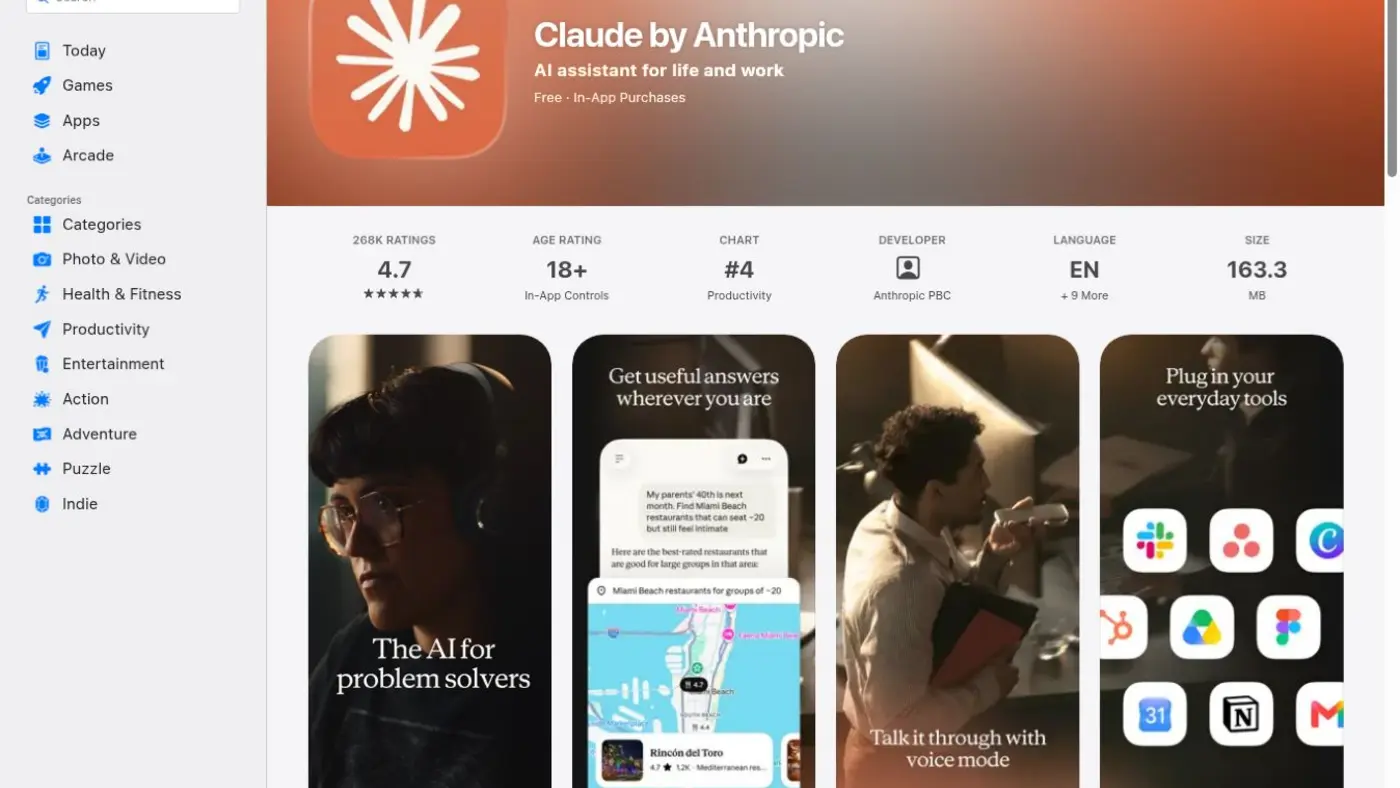
Schermate ufficiali dell'app Claude di Anthropic

Claude è il caso opposto. Non è una sigla, ma un nome proprio. Sembra una persona. Questa scelta abbassa la distanza psicologica: non stai interrogando una macchina, stai chiedendo aiuto a “Claude”. Il marchio diventa più facile da ricordare e più naturale da nominare in una frase.

L’interpretazione più diffusa è che il nome sia un omaggio a Claude Shannon, matematico e padre della teoria dell’informazione. Il collegamento è molto plausibile per un’azienda che lavora sul linguaggio e sull’informazione. Va però aggiunta una cautela importante: Anthropic non ha pubblicato una spiegazione ufficiale e definitiva. Anche il San Francisco Chronicle, ricostruendo la storia del nome, tratta il riferimento a Shannon come una spiegazione probabile, non come una dichiarazione aziendale incontrovertibile.

Anthropic continua poi con nomi letterari e musicali per le diverse classi di modello: Haiku, Sonnet e Opus. Il risultato è un universo semantico meno da laboratorio e più da scrivania creativa. Ne avevo già parlato riflettendo sul posizionamento quasi “fighetto” di Claude di Anthropic.

Qui il naming non spiega come funziona il modello. Spiega come l’azienda vorrebbe farcelo percepire: colto, misurato, collaborativo.

Perché Google ha chiamato il suo modello Gemini?

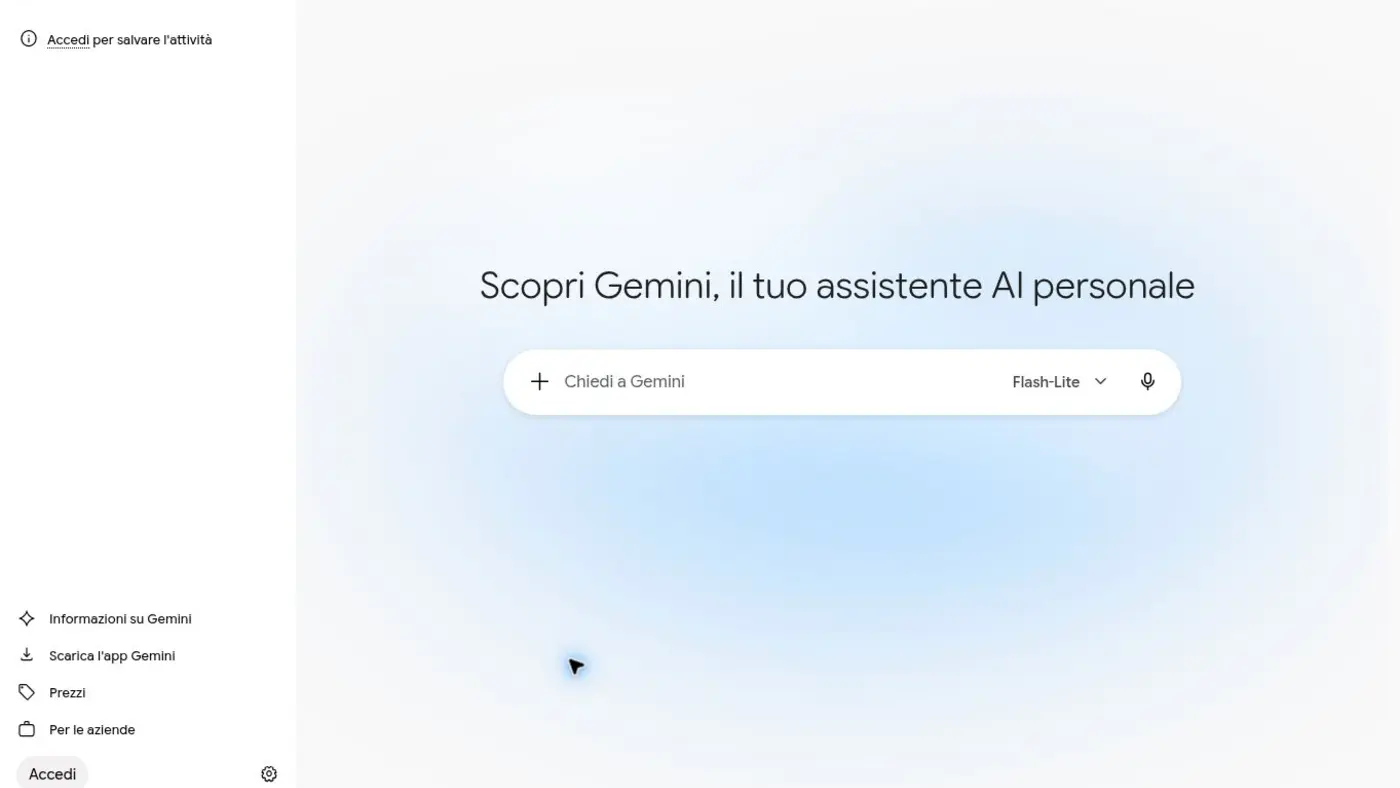
Interfaccia ufficiale di Google Gemini con il campo Chiedi a Gemini

Per Gemini abbiamo una spiegazione ufficiale. In latino gemini significa “gemelli” e rimanda a Castore e Polluce, le due stelle più note della costellazione dei Gemelli.

Secondo il racconto pubblicato da Google, il nome sintetizza soprattutto la collaborazione tra i team di Google Brain e DeepMind, riuniti nel 2023 in Google DeepMind. Due grandi tradizioni di ricerca che lavorano come una coppia.

C’è anche un secondo riferimento: Project Gemini, il programma spaziale della NASA che preparò le missioni Apollo. Il nome, quindi, porta con sé un’idea di incontro, coordinamento e corsa verso una nuova frontiera.

Google ha presentato il modello come nativamente multimodale, capace di lavorare con testo, immagini, audio, video e codice. Anche il rapporto tecnico di Gemini insiste sulla combinazione di modalità diverse. Il nome funziona perché racconta proprio questo: componenti differenti che diventano un unico sistema.

Video ufficiale di Google:

Perché Grok si chiama così?

Interfaccia ufficiale di Grok con il campo per iniziare una conversazione

Prima precisazione, utile anche per Google: si scrive Grok, con una sola “c”. Non “Grock”.

Il verbo to grok fu inventato dallo scrittore Robert A. Heinlein nel romanzo di fantascienza Stranger in a Strange Land, pubblicato nel 1961. Nel tempo è entrato nel lessico inglese, soprattutto informatico, con il senso di capire qualcosa in modo profondo, intuitivo e completo. È questa anche la definizione registrata da Merriam-Webster.

Nel suo annuncio di lancio, xAI presentò Grok come un assistente ispirato alla Guida galattica per gli autostoppisti, capace di rispondere con umorismo e con una vena ribelle. Il nome promette quindi due cose: comprensione profonda e cultura fantascientifica.

È una scelta coerente con Elon Musk. Non un assistente neutro e aziendale, ma un personaggio con un tono riconoscibile. Se ChatGPT descrive una tecnologia e Claude sembra un collega, Grok entra in scena come il protagonista di un romanzo.

Perché Llama si chiama Llama?

Interfaccia ufficiale di Meta AI, il prodotto collegato ai modelli di Meta

Llama è un acronimo: Large Language Model Meta AI. Meta lo esplicitò già nel primo annuncio ufficiale del 2023.

La parte brillante è che l’acronimo forma una parola vera e visiva. Un animale è molto più facile da ricordare di una sequenza di lettere. Consente anche di costruire loghi, immagini, giochi di parole e una comunità riconoscibile.

In questo caso il nome mantiene la precisione tecnica, ma la confeziona in modo pop. È un piccolo capolavoro di memorabilità: chiunque ricorda il lama, quasi nessuno ricorderebbe “LLMMAI”.

Mistral: il vento francese dell’intelligenza artificiale

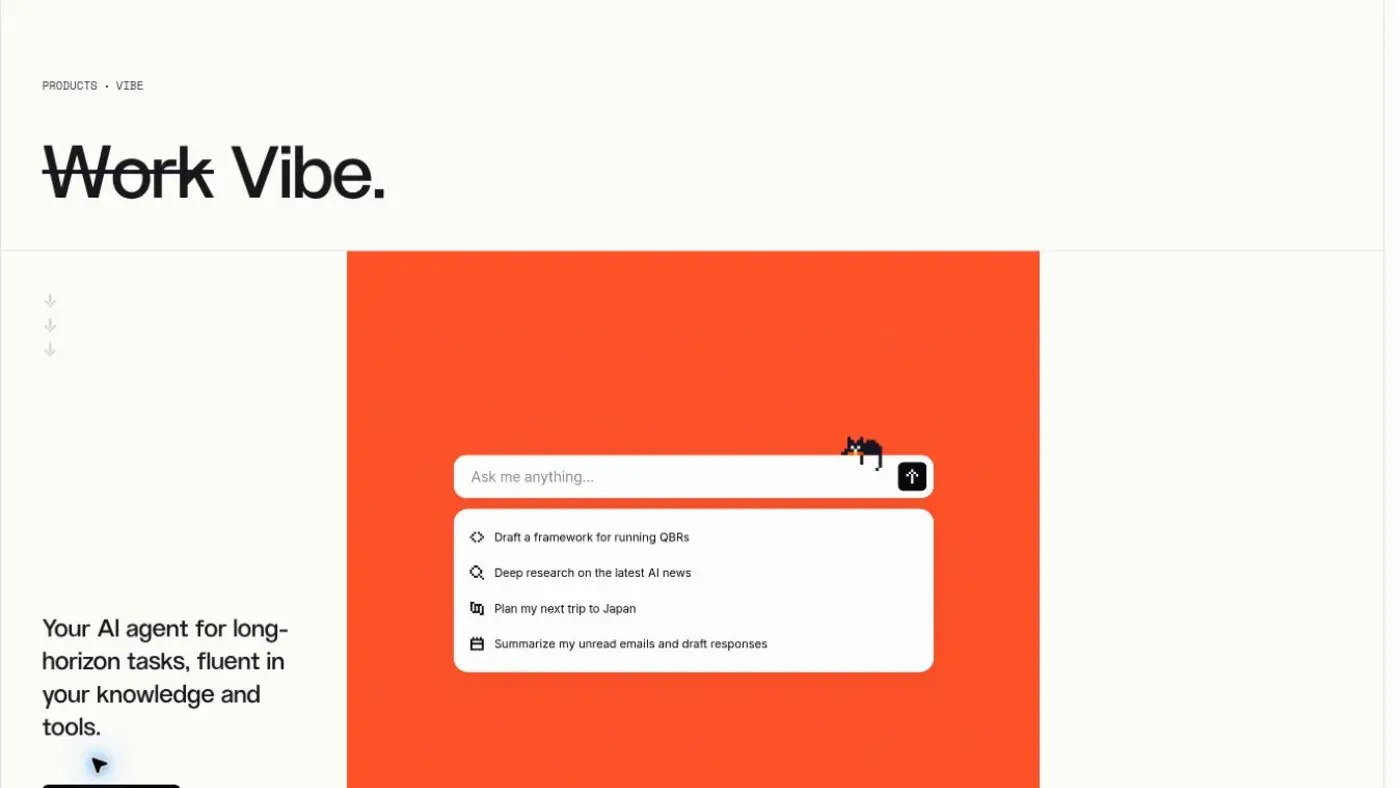
Interfaccia mostrata nella pagina ufficiale del prodotto Mistral Vibe

Mistral AI è un’azienda francese e il mistral, in italiano maestrale, è il vento forte e freddo che soffia verso il Mediterraneo dal Sud della Francia. Il nome comunica velocità, energia e radicamento geografico.

Sul proprio sito ufficiale, l’azienda non propone una lunga storia del naming. Il riferimento culturale e territoriale è evidente, ma è corretto non trasformarlo in una spiegazione ufficiale mai pubblicata.

È anche un nome che suona bene in molte lingue. Non ha bisogno di traduzione e porta immediatamente l’azienda fuori dal solito immaginario della Silicon Valley. Nel settore AI, dove moltissimi marchi parlano inglese americano, questa identità europea è già un posizionamento.

DeepSeek, Qwen, Copilot e Perplexity: nomi che creano aspettative

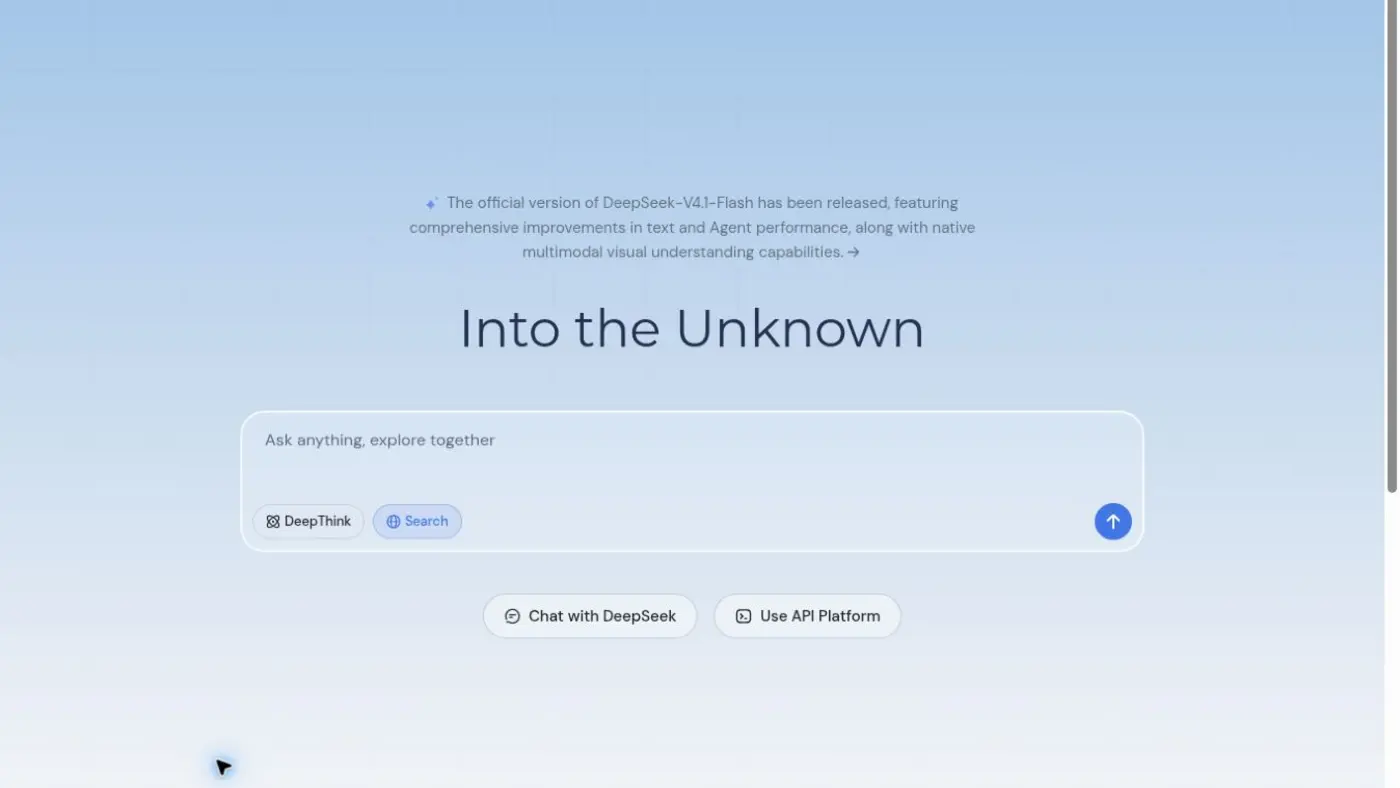
Interfaccia ufficiale di DeepSeek con le opzioni DeepThink e Search

DeepSeek unisce “deep” e “seek”: cercare in profondità. È un nome che evoca esplorazione e ragionamento.

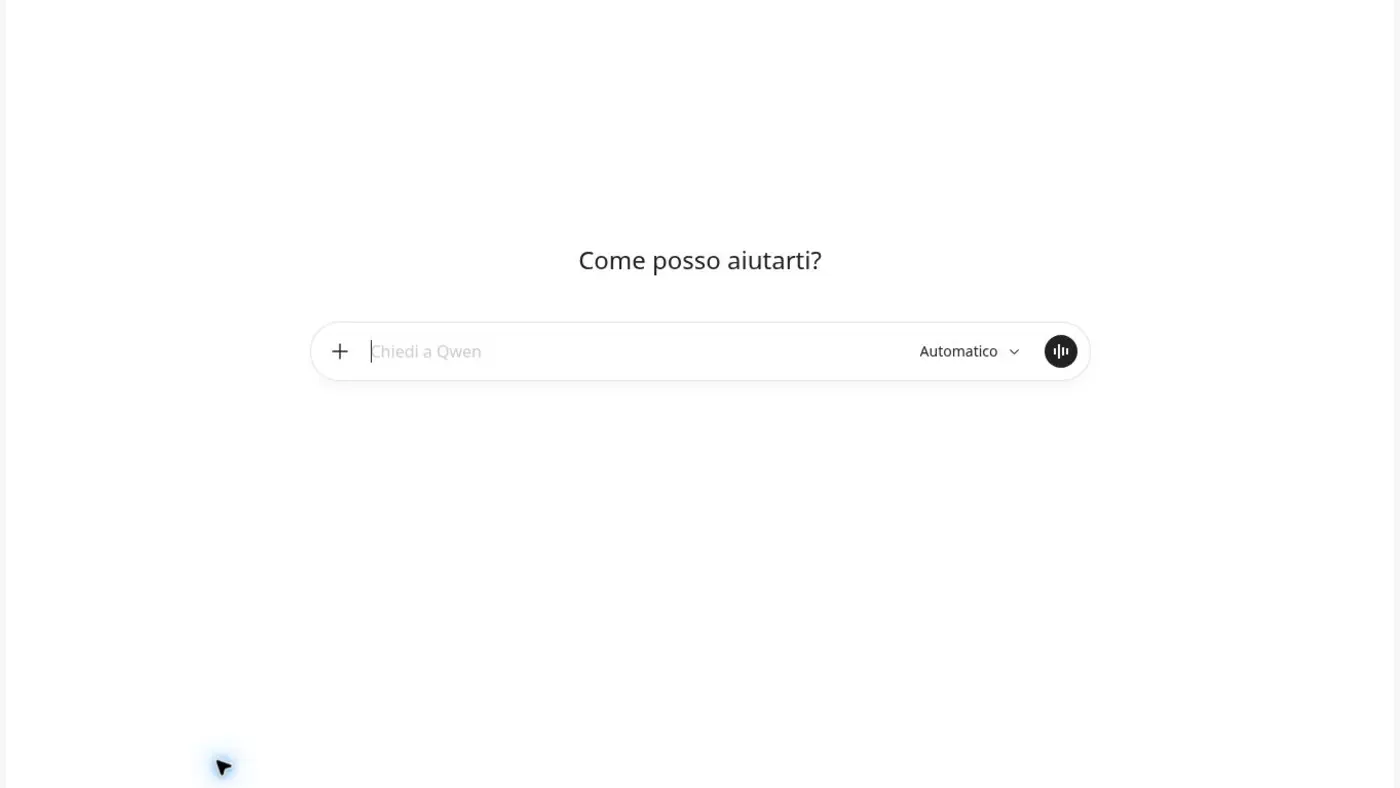
Interfaccia ufficiale di Qwen Studio con il campo Chiedi a Qwen

Qwen è il marchio scelto da Alibaba per la propria famiglia di modelli e oggi raccoglie versioni dedicate a testo, codice, immagini e altre modalità. Sul mio sito trovi anche gli articoli dedicati a Qwen.

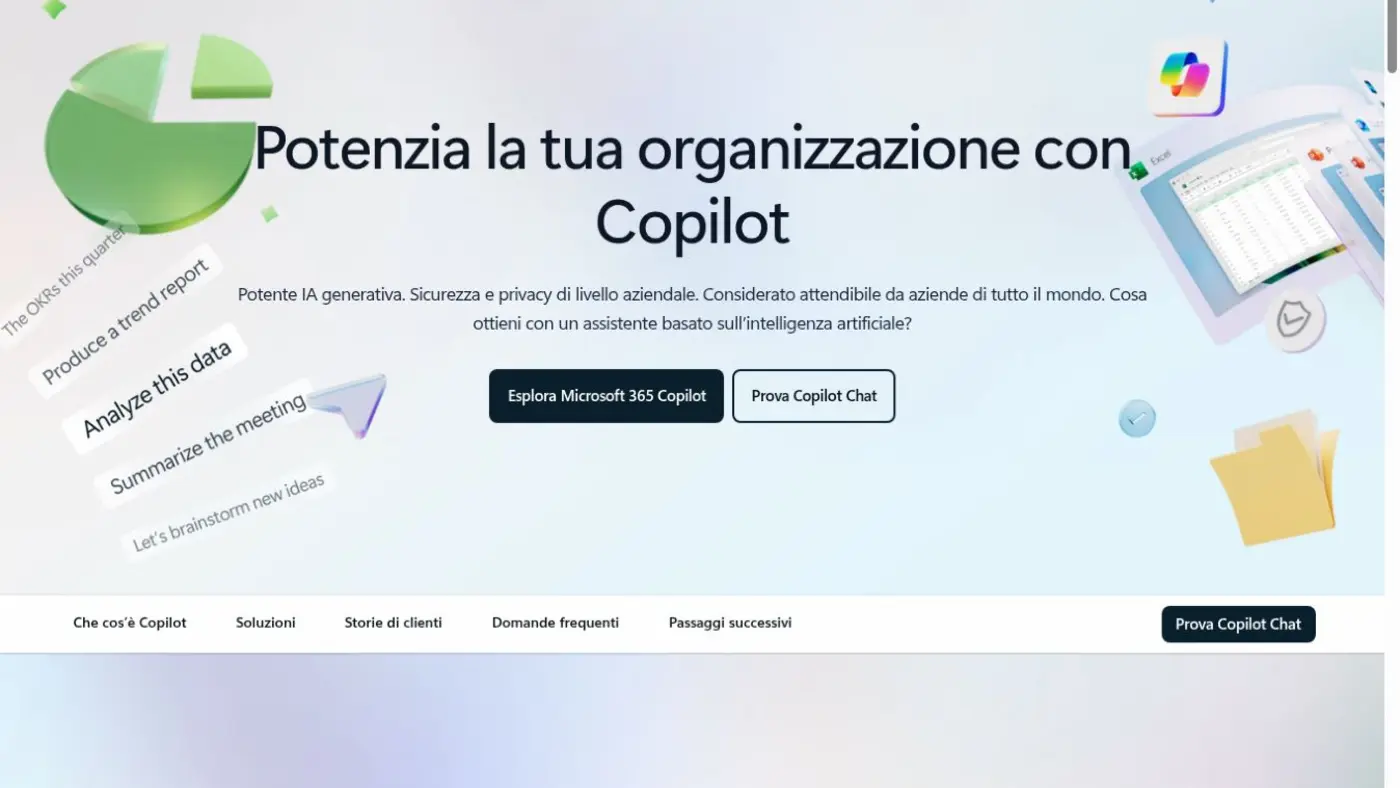
Pagina ufficiale di Microsoft Copilot con esempi d'uso e accesso a Copilot Chat

Copilot usa una metafora aeronautica. Il pilota resta la persona, l’AI siede accanto e aiuta. È una scelta linguistica strategica perché presenta la macchina come collaboratore, non come sostituto.

Schermate dell'app ufficiale Perplexity pubblicate sull'App Store

Perplexity è una parola inglese che significa perplessità o complessità. È anche il nome di una misura usata per valutare quanto un modello linguistico trovi prevedibile una sequenza di parole. Il richiamo tecnico è evidente, anche se il marchio non va ridotto a quella sola metrica.

I nomi influenzano il modo in cui usiamo l’intelligenza artificiale. “Copilot” ci invita a mantenere il controllo. “Claude” favorisce un rapporto quasi personale. “Grok” promette intuizione. “DeepSeek” suggerisce profondità. Queste sono promesse di marca, non prove di qualità.

Un modello con un nome rassicurante può ancora sbagliare. Uno con un nome tecnico può essere creativo. Per ottenere risultati migliori servono obiettivi chiari, verifica delle fonti e buoni prompt, non simpatia per il logo.

Domande frequenti sui nomi dei modelli AI

Che cosa significa GPT?
GPT significa Generative Pre-trained Transformer: generativo, preaddestrato e basato sull’architettura Transformer.

Claude prende davvero il nome da Claude Shannon?
È l’ipotesi più diffusa e plausibile, ma Anthropic non l’ha confermata ufficialmente in modo definitivo.

Perché Gemini si chiama così?
Il nome richiama i gemelli, la collaborazione tra Google Brain e DeepMind e il programma spaziale Gemini della NASA.

Si scrive Grok o Grock?
La grafia corretta è Grok, con una sola “c”. Il termine nasce nel romanzo di Heinlein Stranger in a Strange Land.

Llama è soltanto il nome di un animale?
No. È l’acronimo di Large Language Model Meta AI. Il fatto che coincida con il nome dell’animale lo rende più memorabile.

Il nome dice quale modello AI è migliore?
No. Il naming comunica identità e posizionamento, ma la qualità va valutata in base al compito, ai dati, ai test e all’affidabilità delle risposte.

Il nome è la prima risposta dell’intelligenza artificiale

Le interfacce ufficiali mostrano come ChatGPT, Claude, Gemini e Grok si presentano agli utenti

Prima ancora di rispondere alla nostra prima domanda, ogni AI ci ha già suggerito come vorrebbe essere percepita. ChatGPT vuole essere uno strumento conversazionale. Claude un interlocutore. Gemini una fusione di capacità. Grok una mente che comprende in profondità. Llama una tecnologia aperta e memorabile.

Poi tocca a noi verificare se mantiene la promessa. Possibilmente senza chiedere direttamente al modello perché si chiama così e prendere la sua risposta per buona. Se vuoi continuare l’esplorazione, trovi qui tutti i miei articoli su tecnologia, comunicazione e intelligenza artificiale.

Fonti autorevoli

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

ChatGPT produce una risposta perfetta. È ordinata, chiara, convincente. Non esita, non balbetta e spesso aggiunge esempi, termini tecnici e una conclusione ben confezionata. C’è solo un problema: non sappiamo ancora se quella risposta sia vera. Il problema più grande è che, dopo averla letta, spesso smettiamo di chiedercelo.

È qui che nasce l’epistemia: una condizione in cui la plausibilità linguistica prende il posto della valutazione epistemica. In parole semplici, una risposta ci sembra conoscenza perché è scritta bene, anche se non abbiamo verificato fonti, prove e passaggi logici. Il termine è proposto da Walter Quattrociocchi, Valerio Capraro e Matjaž Perc nel paper Epistemological Fault Lines Between Human and Artificial Intelligence, pubblicato su arXiv il 22 dicembre 2025.

L’epistemia non coincide con una semplice allucinazione dell’AI. Può verificarsi anche quando la risposta è corretta: il punto è che riceviamo il risultato senza attraversare il processo necessario per giustificarlo. La sensazione di sapere sostituisce il lavoro del conoscere.

Che cos’è l’epistemia?

L’epistemia descrive la separazione tra un contenuto e la sua valutazione. Il chatbot ci consegna un testo finito, ma noi non vediamo la ricerca delle fonti, il confronto tra prove, la ricerca di controesempi e la revisione delle ipotesi. A volte questi passaggi non sono stati svolti affatto; altre volte sono stati simulati nel linguaggio.

L’AI ci consegna il piatto pronto. Noi non vediamo la cucina, non conosciamo tutti gli ingredienti e, in molti casi, non controlliamo nemmeno la data di scadenza.

Non è una diagnosi clinica e non è un nuovo nome per la disinformazione. È un concetto filosofico e sociotecnico che aiuta a descrivere un ambiente in cui diventa difficile distinguere tra sapere, sembrare di sapere e simulare la conoscenza.

Epistemia e allucinazioni dell’AI non sono la stessa cosa

Una allucinazione si verifica quando un sistema genera un’informazione falsa o inventata presentandola in modo plausibile. L’epistemia è un fenomeno più ampio: riguarda il modo in cui la risposta viene accettata e inserita nei nostri processi decisionali.

Allucinazione Epistemia
La risposta contiene informazioni errate o inventate. La risposta viene accettata senza un vero processo di valutazione.
Il problema principale è l’errore fattuale. Il problema principale è la sostituzione del giudizio.
Può essere scoperta confrontando il testo con le fonti. Può esistere anche quando il contenuto è corretto.
Riguarda soprattutto l’output. Riguarda l’intero ambiente in cui produciamo conoscenza.

Potremmo dire che l’allucinazione è un possibile sintomo, mentre l’epistemia è la condizione che ci rende disposti a fidarci del sintomo.

Perché una risposta ben scritta ci sembra più vera?

Noi esseri umani usiamo continuamente scorciatoie cognitive. La fluidità di un testo, la sicurezza del tono, la familiarità delle parole e la chiarezza dell’esposizione diventano indicatori indiretti di attendibilità. Un messaggio facile da elaborare tende a sembrarci più credibile di uno confuso o esitante.

I chatbot generativi sono particolarmente efficaci su questo terreno. Producono testi fluidi, coerenti e formalmente autorevoli. Il rischio è confondere:

  • la coerenza con la correttezza;
  • la sicurezza espressiva con la competenza;
  • la precisione linguistica con la precisione fattuale;
  • una spiegazione plausibile con una spiegazione dimostrata.

Uno studio pubblicato su PNAS ha mostrato che affidare a un modello linguistico il fact-checking di titoli di notizie può, in alcune condizioni, peggiorare la capacità delle persone di distinguere il vero dal falso. Aggiungere un chatbot al processo non produce automaticamente una verifica migliore.

Un lavoro pubblicato su Nature parla invece di “illusioni di comprensione” nella ricerca scientifica: l’aumento della produttività può far credere di capire un fenomeno meglio di quanto lo si comprenda davvero. Più output non significa necessariamente più conoscenza.

Le sette fratture tra intelligenza umana e LLM

Il paper individua sette fault lines, cioè sette fratture epistemologiche tra il modo in cui una persona forma un giudizio e il modo in cui un Large Language Model genera una risposta. Per comprendere il meccanismo di base può essere utile anche il mio simulatore LLM, che mostra come l’AI sceglie la parola successiva.

1. Grounding: esperienza del mondo contro input

Una persona incontra il mondo attraverso il corpo, i sensi, le relazioni e le conseguenze delle proprie azioni. Un modello elabora dati trasformati in rappresentazioni numeriche. Può descrivere un mal di schiena, un treno perso o un progetto fallito, ma non li ha vissuti.

2. Parsing: interpretazione contro tokenizzazione

Quando entriamo in una stanza osserviamo parole, tono, silenzi, espressioni e relazioni di potere. Il modello scompone l’input in token e ricostruisce una risposta sulla base delle regolarità apprese. Può cogliere molti segnali, ma dipende sempre dalle informazioni disponibili e dal modo in cui la situazione è stata rappresentata.

3. Esperienza: memoria autobiografica contro associazioni statistiche

Un essere umano collega ciò che accade a episodi vissuti, concetti appresi e intuizioni fisiche e sociali. Un LLM non possiede una biografia. Quando usa formule come “nella mia esperienza”, salvo particolari contesti applicativi, sta generando linguaggio: non sta aprendo il cassetto dei ricordi.

4. Motivazione: obiettivi umani contro ottimizzazione

Noi decidiamo sotto l’influenza di bisogni, paure, valori, interessi e progetti. Il modello non vuole fare carriera, non teme di perdere un cliente e non desidera proteggere la propria reputazione. Può simulare prudenza ed empatia, ma la simulazione funzionale non equivale a una motivazione intrinseca.

5. Causalità: spiegare il perché contro riconoscere regolarità

Gli esseri umani cercano rapporti causali: che cosa ha prodotto un evento? Che cosa cambierebbe modificando una variabile? Gli LLM sanno descrivere bene relazioni causali presenti nei testi, ma possono diventare fragili quando la situazione è insolita, contraddittoria o rompe le correlazioni più frequenti.

6. Metacognizione: sapere di non sapere

Una persona può fermarsi e ammettere di non avere elementi sufficienti. Un chatbot può pronunciare la stessa frase, ma non è detto che derivi da un’autentica consapevolezza del limite. Uno studio su dodici modelli, pubblicato su Nature Communications, ha rilevato difficoltà importanti nel riconoscere i propri limiti durante compiti di ragionamento medico.

7. Valori: responsabilità contro probabilità

Un medico, un insegnante, un dirigente pubblico o un giornalista rispondono delle proprie decisioni. Il modello non subisce direttamente le conseguenze di un errore. Può essere vincolato da regole, ma non porta sulle proprie spalle il peso morale, sociale o professionale della scelta.

Il vero rischio: trasformare la conoscenza da processo a prodotto

Questa è la parte più utile del concetto di epistemia. Siamo abituati a pensare alla conoscenza come a un risultato: una risposta, una definizione, un documento, una presentazione. In realtà, conoscere è un processo.

  1. formulare una domanda;
  2. raccogliere elementi;
  3. valutarne la provenienza;
  4. confrontare versioni diverse;
  5. riconoscere ciò che manca;
  6. modificare la propria opinione;
  7. assumersi la responsabilità della conclusione.

L’AI generativa comprime questi passaggi in un unico output. Scriviamo una domanda, aspettiamo qualche secondo e riceviamo il prodotto finale. È un vantaggio enorme in termini di velocità, ma può renderci epistemicamente passivi: non esercitiamo più il giudizio, lo consumiamo.

Cinque esempi concreti di epistemia al lavoro

Un responsabile HR chiede all’AI quale candidato assumere

Il chatbot confronta i curriculum e produce una graduatoria impeccabile. Se nessuno controlla quali elementi siano stati privilegiati, quali informazioni mancassero e quali bias fossero presenti nei documenti, la classifica viene trattata come conoscenza anche se è soltanto un’elaborazione plausibile.

Un avvocato riceve una sintesi giuridica

Il testo contiene sentenze e riferimenti normativi, ma basta una pronuncia inesistente o una norma superata per renderlo pericoloso. Il problema non è usare l’AI per preparare una bozza: è scambiare la bozza per un parere verificato.

Un medico usa un chatbot per interpretare un caso

La risposta può essere utile per ampliare le ipotesi. Diventa epistemia quando l’ordine e la sicurezza del testo sostituiscono anamnesi, linee guida, esami e responsabilità professionale.

Un funzionario pubblico prepara una risposta a un cittadino

L’AI scrive una comunicazione chiara e cortese. Se nessuno verifica la versione aggiornata della normativa, la competenza dell’ente e le particolarità del caso, la fluidità linguistica nasconde una fragilità amministrativa. Per questo, nella mia guida a ChatGPT nella Pubblica Amministrazione, il controllo umano resta centrale.

Uno studente prepara un’interrogazione

Legge un riassunto e riesce a ripeterlo. Ma saprebbe affrontare un’obiezione, collegare due opere o riconoscere un’interpretazione controversa? L’epistemia compare quando la capacità di ripetere un contenuto viene scambiata per comprensione. È uno dei motivi per cui i percorsi di AI literacy per scuole, docenti e studenti devono insegnare metodo, non soltanto prompt.

Una tesi potente, ma da non trasformare in dogma

Il lavoro di Quattrociocchi, Capraro e Perc è una Perspective depositata su arXiv. È una proposta teorica utile, non l’ultima parola scientifica sul funzionamento degli LLM. Alcune formulazioni sono volutamente forti, soprattutto quando negano ai modelli ogni forma di metacognizione.

Sul piano filosofico, distinguere tra consapevolezza e simulazione linguistica della consapevolezza è fondamentale. Sul piano ingegneristico, però, esistono tecniche per migliorare la calibrazione, misurare l’incertezza e permettere ai sistemi di astenersi. La calibration tuning, per esempio, prova ad allineare meglio la fiducia espressa dal modello con la probabilità che la risposta sia corretta.

Questo non dimostra che il modello possieda una metacognizione simile a quella umana. Dimostra però che possiamo progettare sistemi capaci di comportarsi in modo epistemicamente più prudente. Un comportamento affidabile non prova l’esistenza di una coscienza, ma può ridurre i rischi pratici.

Come difendersi dall’epistemia

La soluzione non è smettere di usare ChatGPT, Gemini, Claude, Copilot o gli altri strumenti. Sarebbe come rinunciare alla calcolatrice perché qualcuno potrebbe usarla senza capire la matematica. Serve progettare meglio il rapporto tra generazione automatica e giudizio umano.

1. Separare generazione e verifica

La stessa risposta non dovrebbe essere contemporaneamente bozza, prova, verifica e decisione finale. Usiamo l’AI per proporre ipotesi e sintetizzare documenti; la verifica deve appoggiarsi a fonti identificabili e, quando possibile, indipendenti.

2. Chiedere la provenienza delle affermazioni

Non basta domandare “indicami le fonti”. Conviene chiedere la fonte primaria, il passaggio che supporta ogni affermazione, la data di pubblicazione e ciò che non è stato possibile verificare. Il collegamento fornito dal chatbot va comunque aperto e controllato.

3. Rendere visibile l’incertezza

Un buon workflow distingue tra informazioni presenti nelle fonti, inferenze, ipotesi, elementi controversi e dati mancanti. La sicurezza grammaticale non deve cancellare l’incertezza reale del contenuto.

4. Cercare controesempi

Dopo una risposta possiamo chiedere: “Quali elementi potrebbero smentire questa conclusione?” oppure: “Assumi che la risposta precedente sia sbagliata: quali sono le tre cause più probabili dell’errore?”. L’obiettivo non è ottenere automaticamente la verità dal secondo prompt, ma impedire che il primo output chiuda troppo presto il ragionamento.

5. Collegare le risposte a fonti delimitate

Sistemi basati su RAG, knowledge base aziendali o raccolte documentali definite riducono la distanza tra risposta e prove. Gemini Notebook (ex NotebookLM), per esempio, è utile quando vogliamo interrogare un insieme preciso di documenti e risalire ai passaggi citati. Il grounding non rende il sistema infallibile, ma rende più semplice controllarlo.

6. Mantenere l’essere umano nel punto giusto

Il controllo deve essere proporzionato alle conseguenze. Per una bozza di newsletter può bastare una rilettura. Per un pagamento, una diagnosi, un contratto, una selezione o una comunicazione istituzionale serve una responsabilità umana identificata. È il principio dell’human-in-the-loop e human-on-the-loop: l’AI prepara e propone, ma alcune decisioni non devono essere eseguite senza approvazione.

7. Valutare il processo, non soltanto il risultato

Quando uno studente, un dipendente o un consulente consegna un documento realizzato con l’AI, non dovremmo chiedere soltanto se il testo è fatto bene. Dovremmo sapere quali fonti sono state usate, quali parti sono state generate, quali controlli sono stati eseguiti, quali modifiche sono state apportate e quali dubbi restano aperti.

Un prompt antiepistemia da provare

Analizza la richiesta senza dare per scontato che esista una risposta certa.

Separa chiaramente: fatti verificati, informazioni ricavate dalle fonti, inferenze, ipotesi ed elementi controversi o mancanti.

Per ogni affermazione importante indica una fonte primaria e verificabile. Cerca almeno due controesempi o interpretazioni alternative. Segnala ciò che non puoi verificare.

Se i dati non sono sufficienti, non completare la risposta con informazioni plausibili: formula le domande necessarie. Concludi indicando quali controlli deve svolgere una persona prima di usare il risultato.

Il prompt può migliorare il workflow. Non trasforma il chatbot in un’autorità epistemica. Anche la risposta a questo prompt deve essere controllata.

Dall’alfabetizzazione digitale all’alfabetizzazione epistemica

Per anni abbiamo parlato di alfabetizzazione digitale: sapere usare dispositivi, software, motori di ricerca e piattaforme. Ora serve qualcosa in più.

Gli autori parlano di epistemic literacy, cioè alfabetizzazione epistemica. Significa comprendere non soltanto come usare un sistema, ma anche come produce le risposte, quali operazioni non svolge, quando il contenuto è collegato a prove, quali responsabilità devono restare umane e quando è necessario sospendere il giudizio.

L’alfabetizzazione epistemica non sostituisce il pensiero critico. Lo aggiorna per un ambiente in cui testi e argomentazioni credibili possono essere prodotti automaticamente e in quantità quasi illimitata.

L’AI può rispondere, ma chi sta giudicando?

L’intelligenza artificiale generativa non ci obbliga a smettere di pensare. Ci rende però molto più facile farlo. Una risposta elegante arriva in pochi secondi; verificarla richiede tempo, aprire le fonti richiede fatica e confrontare ipotesi contrastanti produce incertezza.

L’epistemia nasce in questo spazio: la risposta è immediata, mentre il giudizio resta faticoso.

La domanda pratica non è soltanto se ChatGPT capisca davvero nello stesso modo in cui capiamo noi. È questa: stiamo usando l’AI per sostenere il nostro giudizio o per evitarlo?

Quando un chatbot produce una risposta, il lavoro cognitivo non è terminato. È appena iniziato.

Domande frequenti sull’epistemia

Che cosa significa epistemia?

Indica una condizione in cui una risposta linguisticamente plausibile viene scambiata per conoscenza verificata. La sensazione di sapere prende il posto del controllo di prove, fonti e ragionamento.

Epistemia e allucinazioni AI sono sinonimi?

No. Un’allucinazione è un’informazione falsa o inventata generata dall’AI. L’epistemia riguarda il modo in cui accettiamo una risposta senza valutarne adeguatamente le basi e può verificarsi anche quando il contenuto è corretto.

L’epistemia è una malattia?

No. Non è una diagnosi medica o psicologica, ma un concetto filosofico e sociotecnico proposto per descrivere alcuni effetti dell’integrazione dell’AI nei processi di conoscenza e decisione.

Come si evita l’epistemia?

Separando generazione e verifica, controllando le fonti primarie, rendendo visibile l’incertezza, cercando controesempi, mantenendo la supervisione umana e valutando il processo seguito.

L’intelligenza artificiale può sapere di non sapere?

I modelli possono essere addestrati a esprimere incertezza, chiedere informazioni e astenersi dal rispondere. È discusso se questo comportamento rappresenti metacognizione o una sua simulazione funzionale.

Possiamo fidarci delle risposte dei chatbot?

Possiamo usarle come bozze, sintesi, ipotesi e strumenti di supporto. La fiducia deve però dipendere dal contesto, dalle fonti, dai controlli effettuati e dalle conseguenze di un eventuale errore.

Fonti principali

Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

Inviaci email

Quando durante i miei corsi sull’intelligenza artificiale generativa spiego come funziona un LLM, cioe un Large Language Model, a un certo punto arriva sempre la stessa domanda: “Ma quindi ChatGPT pensa?”.

Risposta breve: no, almeno non nel senso umano del termine.

Risposta un po’ piu utile: un modello linguistico genera testo calcolando, passo dopo passo, quali pezzi di testo sono piu probabili dopo quelli gia scritti. Non sceglie una parola perche “ha capito” come noi. La sceglie perche, in base all’addestramento e al contesto, quella continuazione ha una certa probabilita.

Detta cosi sembra una faccenda da matematici con il camice. Per questo ho preparato un piccolo simulatore didattico: scrivi l’inizio di una frase e il sistema ti mostra alcune possibili parole successive, con la relativa percentuale di probabilita.

Non e un vero ChatGPT. E, volutamente, molto piu semplice. Ma serve a visualizzare il meccanismo chiave: un LLM non scrive tutto il testo in un colpo solo. Predice il prossimo token, poi il prossimo, poi il prossimo ancora. Come quando in autostrada segui i cartelli, solo che qui i cartelli sono statistici.

Prova il simulatore

Qui sotto puoi inserire l’inizio di una frase. Il simulatore propone diverse parole successive e mostra una probabilita per ciascuna. Piu alta e la percentuale, piu quella parola e “attesa” in quel contesto.

Nota importante: questo e un simulatore divulgativo. Le probabilita sono generate da un piccolo modello dimostrativo scritto in JavaScript, non da un LLM reale. Serve per capire il principio, non per replicare ChatGPT.

Simulatore: qual e la prossima parola?

Scrivi l’inizio di una frase. Il simulatore calcola alcune possibili continuazioni e mostra una distribuzione di probabilita.

Bassa: scelta piu prevedibile. Alta: piu varieta, anche con qualche sorpresa.
Parole candidate Contesto: lavoro/AI
     

    Che cosa sta succedendo nel simulatore

    Il simulatore fa tre cose:

    1. Legge l’inizio della frase.
    2. Cerca alcuni indizi nel testo: per esempio parole legate ad aziende, formazione, dati, scrittura o intelligenza artificiale.
    3. Assegna un punteggio ad alcune possibili parole successive e le trasforma in percentuali.

    Il risultato e una distribuzione di probabilita. Questo concetto e fondamentale: un LLM non ha una sola risposta “giusta” gia pronta in memoria. Ha molte possibili continuazioni, ciascuna con un peso diverso.

    Se scrivo:

    L’intelligenza artificiale puo aiutare le aziende a

    una continuazione come “automatizzare” o “analizzare” ha piu senso di “friggere”. Non perche il modello abbia buon gusto, ma perche nel suo addestramento ha visto moltissime frasi in cui AI, aziende, processi, dati e automazione stanno vicini.

    Poi entra in gioco un altro parametro: la creativita, che nei modelli reali viene spesso avvicinata al concetto di “temperatura”. Con una temperatura bassa il sistema sceglie parole piu prevedibili. Con una temperatura alta lascia piu spazio a opzioni meno probabili.

    Come funziona davvero un LLM

    Un LLM, semplificando, e un modello addestrato su enormi quantita di testo. Durante l’addestramento impara relazioni statistiche tra parole, frasi, concetti, stili e contesti. Quando gli scriviamo un prompt, il modello non consulta un dizionario magico delle risposte. Calcola una sequenza.

    Il processo, molto semplificato, e questo:

    1. Il testo viene diviso in token, cioe pezzi di parole o parole intere.
    2. Il modello analizza il contesto gia presente.
    3. Produce una lista di possibili token successivi.
    4. A ogni token assegna una probabilita.
    5. Viene scelto un token.
    6. Il token scelto viene aggiunto al testo.
    7. Il processo ricomincia.

    Ecco perche, quando usiamo ChatGPT, Claude, Gemini, Copilot o altri chatbot, vediamo il testo comparire poco alla volta. Il modello sta costruendo la risposta un passo dopo l’altro.

    Token: perche non parliamo solo di parole

    Nel simulatore parlo di “parole successive” perche e piu intuitivo. In realta gli LLM lavorano con i token. Un token puo essere una parola, una parte di parola, uno spazio, un segno di punteggiatura o un frammento.

    Per esempio, una parola lunga puo essere spezzata in piu token. Una frase breve puo contenere piu token di quanto immaginiamo. Questo dettaglio tecnico ha effetti pratici: i modelli hanno una finestra di contesto, cioe una quantita massima di token che riescono a considerare in una conversazione o in un documento.

    Tradotto in linguaggio da aula: se butti dentro troppa roba, il modello non diventa automaticamente piu intelligente. A volte diventa solo piu confuso.

    Perche a volte l’AI sbaglia

    Capire la previsione della parola successiva aiuta anche a capire gli errori dell’intelligenza artificiale generativa.

    Un LLM puo produrre una frase fluida, elegante e sbagliata. Questo succede perche la probabilita linguistica non coincide sempre con la verita. Una frase puo “suonare bene” anche se contiene un dato inventato, una fonte inesistente o un ragionamento debole.

    Ecco perche nei miei corsi insisto sempre su tre verbi:

    • chiedere bene;
    • verificare meglio;
    • usare con criterio.

    Il prompt engineering non e l’arte di trovare la formula segreta. E il metodo per dare contesto, obiettivo, vincoli, esempi e criteri di controllo. Poi serve comunque la testa dell’utente. Spiace, ma quella non e ancora disponibile in abbonamento.

    A cosa serve questo progetto

    Questo simulatore nasce per rendere visibile un meccanismo che di solito resta nascosto. Quando una tecnologia sembra magia, la usiamo peggio: o la sopravvalutiamo, o la demonizziamo. In entrambi i casi capiamo poco.

    Visualizzare le probabilita aiuta a fare tre passi:

    1. Capire che un chatbot non “sa” nel modo in cui sa una persona.
    2. Capire perche lo stesso prompt puo generare risposte leggermente diverse.
    3. Capire perche contesto, istruzioni e verifica sono decisivi.

    Il pubblico ideale e molto ampio: aziende, scuole, universita, formatori, professionisti, comunicatori, giornalisti, manager e chiunque voglia capire l’AI generativa senza perdersi subito nelle formule.

    Un esempio pratico per aziende e professionisti

    In azienda la domanda non dovrebbe essere: “Possiamo usare ChatGPT per tutto?”.

    La domanda migliore e: “Quali attivita hanno abbastanza testo, regole, esempi e controllo umano da poter essere aiutate da un LLM?”.

    Un modello linguistico puo essere utile per:

    • riassumere documenti;
    • preparare bozze di email, post, comunicati e report;
    • trasformare testi tecnici in versioni piu accessibili;
    • creare scalette, FAQ, checklist e materiali formativi;
    • analizzare feedback, note, trascrizioni e contenuti non strutturati;
    • simulare domande, obiezioni o scenari.

    Ma non dovrebbe essere usato alla cieca per decisioni delicate, dati sensibili, diagnosi, consulenze legali, valutazioni finanziarie o contenuti che richiedono fonti verificate.

    Il punto non e sostituire le competenze. Il punto e aumentare la qualita del lavoro dove il modello puo davvero aiutare, lasciando all’essere umano controllo, responsabilita e giudizio.

    Perche il prompt cambia il risultato

    Se nel simulatore scrivi una frase generica, le probabilita restano piu distribuite. Se invece inserisci parole come “azienda”, “report”, “corso”, “studenti” o “articolo”, alcune continuazioni diventano piu probabili.

    Succede qualcosa di simile anche con gli LLM reali. Un prompt vago produce una risposta generica. Un prompt con contesto, ruolo, pubblico, obiettivo, formato e vincoli permette al modello di muoversi in uno spazio piu preciso.

    Esempio debole:

    Scrivi un testo sull’AI.

    Esempio migliore:

    Scrivi un’introduzione divulgativa di 1.500 battute per un pubblico di manager non tecnici. Spiega che gli LLM generano testo prevedendo il token successivo, usa un esempio pratico e chiudi con un invito alla verifica delle fonti.

    Non e questione di “parlare bene alla macchina”. E questione di progettare bene la richiesta.

    Limiti del simulatore

    Questo progetto non pretende di spiegare tutta l’architettura dei transformer, l’attenzione, gli embedding, il fine-tuning, il reinforcement learning from human feedback o le tecniche usate nei modelli piu recenti.

    Fa una cosa sola: mostrare in modo interattivo che la generazione del testo e una scelta probabilistica progressiva.

    Per una prima comprensione e gia molto. Perche appena si capisce questo, molte stranezze dell’AI diventano meno strane:

    • perche due risposte allo stesso prompt possono essere diverse;
    • perche una risposta puo essere fluida ma falsa;
    • perche il contesto migliora la qualita;
    • perche la verifica resta indispensabile;
    • perche “fammi tutto tu” e quasi sempre un pessimo prompt.

    Conclusione: meno magia, piu metodo

    Gli LLM sono strumenti potentissimi, ma funzionano meglio quando smettiamo di considerarli oracoli. Non leggono nella mente, non hanno intenzioni, non verificano automaticamente la realta. Generano testo in base al contesto e alle probabilita.

    Questo non li rende meno utili. Anzi: li rende piu utilizzabili.

    Quando capiamo il meccanismo, possiamo fare domande migliori, progettare flussi di lavoro piu sensati, controllare gli output e scegliere quando l’AI e davvero adatta al compito.

    Il simulatore serve proprio a questo: aprire il cofano, senza dover diventare ingegneri. Perche l’intelligenza artificiale generativa non va adorata e non va temuta. Va capita, provata e governata.

    FAQ

    Questo simulatore usa davvero un LLM?

    No. Usa un piccolo modello dimostrativo in JavaScript. Serve per spiegare il principio della previsione probabilistica della parola successiva, non per replicare un modello come ChatGPT.

    Gli LLM prevedono parole o token?

    Tecnicamente prevedono token. Un token puo essere una parola, una parte di parola, un segno di punteggiatura o un altro frammento di testo. Nell’articolo uso spesso “parola” per rendere il concetto piu comprensibile.

    Perche le percentuali cambiano quando modifico la frase?

    Perche cambia il contesto. Nel simulatore alcune parole attivano scenari diversi, come azienda, formazione, dati o scrittura. Nei modelli reali il meccanismo e molto piu complesso, ma l’idea di base e simile: il contesto influenza le probabilita.

    Che cosa significa temperatura?

    La temperatura e un parametro che influenza la varieta dell’output. Valori bassi rendono il testo piu prevedibile; valori alti aumentano la possibilita di scelte meno probabili.

    Perche un LLM puo inventare informazioni?

    Perche genera testo probabile, non necessariamente vero. Per questo le risposte vanno verificate, soprattutto quando riguardano dati, fonti, norme, salute, finanza o decisioni importanti.


    Guida pratica all’AI multimodale di Google

    Google Gemini è la famiglia di modelli di intelligenza artificiale multimodale sviluppata da Mountain View. Alimenta l’ecosistema Google e rappresenta uno degli snodi centrali dell’AI generativa contemporanea.

    Questo corso intensivo ti accompagna dalla comprensione dei modelli Gemini all’uso pratico nelle attività professionali quotidiane: generazione di testi, analisi di immagini e video, comprensione dell’audio, automazione di processi e progettazione di agenti AI.

    Un percorso pensato per chi vuole capire come funziona Gemini, quando usarlo e come integrarlo davvero nel proprio lavoro.


    A chi è rivolto il corso

    • Professionisti della comunicazione, del marketing e del digitale
    • Manager, consulenti e formatori
    • Studenti universitari e post-laurea
    • Aziende che utilizzano Google Workspace

    Non è richiesta esperienza di programmazione. È consigliata una familiarità di base con gli strumenti Google.


    Obiettivi del corso

    Al termine del corso sarai in grado di:

    • Comprendere la famiglia di modelli Google Gemini e le differenze tra le versioni
    • Utilizzare Gemini come strumento multimodale: testo, immagini, video e audio
    • Integrare Gemini con Gmail, Docs e altri servizi Google
    • Sfruttare il contesto esteso di Gemini per analisi complesse
    • Capire come funziona Gemini 3 e la modalità Deep Think
    • Configurare e usare la funzione Personal Intelligence in modo consapevole
    • Utilizzare Gemini come agente per task complessi e flussi multi-step
    • Valutare limiti, rischi, bias e aspetti di privacy

    Programma del corso

    1. Introduzione a Google Gemini

    • Cos’è Google Gemini e come si differenzia dagli altri modelli
    • Uso in sicurezza e gestione della privacy
    • Personal Intelligence: collegare Gmail, Google Foto, YouTube e Search

    2. Uso pratico e sintesi

    • Analisi di documenti lunghi e sintesi avanzate
    • Uso su grandi basi testuali e gestione del contesto

    3. Uso avanzato e creatività

    • Ragionamento avanzato e multimodalità evoluta
    • Vibe coding e creazione di contenuti (immagini e video)

    4. I Gem: i tuoi assistenti personali

    • Introduzione e panoramica dei Gem di Google
    • Creare, testare e personalizzare il proprio Gem

    Metodo didattico e durata

    • Lezioni teoriche orientate alla comprensione
    • Dimostrazioni live ed esercitazioni pratiche su casi reali
    • Sessioni di Q&A e follow-up online

    Durata: 10 ore (5 incontri da 2 ore ciascuno).
    Materiali inclusi: slide ed eBook.

    Il corso può essere personalizzato per aziende o gruppi di lavoro, sia nella durata sia nei contenuti.

    Organizziamo un corso su Google Gemini?

    Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

    Inviaci email

    Nell’ottobre 2024 è uscita su Silhouette Donna una mia intervista su iGenius, Modello Italia. Ecco l’articolo:

    Qui la trascrizione dell’articolo.

    E se l’intelligenza artificiale parlasse italiano? Se fosse di facile accesso ma soprattutto etica e responsabile? E se riuscisse anche a valorizzare il nostro immenso patrimonio culturale? Questo è il sogno da cui nasce il modello Italia, praticamente la risposta italiana ai colossi della intelligenza artificiale, un chatGPT tutto nostrano. Adesso il nostro primo LLM – ovvero Large Language Model, una tecnologia AI avanzata incentrata sulla comprensione e analisi del testo – è realtà.
    Con un database che ha come riferimento principale la nostra lingua e cultura, si propone come alternativa etica e strumento capace di superare pregiudizi e storture di traduzione. Presentato da poco, 100% open source, è già disponibile per il download. La prima versione di Italia ha 9 miliardi di parametri, è stata addestrata da zero in italiano e sarà presto accessibile in una versione multi lingua.

    Un mercato competitivo

    Viene da chiedersi se davvero ci fosse bisogno di un chat bot italiano all’interno di un mercato che si sta moltiplicando nelle proposte e negli upgrade. «Stiamo vivendo una fase di sviluppo che non ha mai avuto pari in questo settore» sottolinea Gianluigi Bonanomi esperto di web, social media e AI, «dalla nascita di chatGPT alla fine del 2022 è stata un’accelerata tecnologica incredibile, gli annunci si susseguono a cadenza quasi quotidiana, lo stesso OpenAI ha annunciato una nuova versione potentissima e gratuita, chatGPT 4o, in grado non solo di comprendere istruzioni testuali, ma anche di caricare dei file e di interpretare le immagini. Già ci sono tantissimi strumenti e alternative allo stesso chatGPT, è un rimpallo continuo per cercare di essere un passo avanti rispetto ai competitor. Le due grandi parrocchie americane sono Microsoft e Google, con il primo che ha investito in chatGPT ma ha anche i suoi prodotti. Per esempio Copilot di Microsoft fa concorrenza a Gemini di Google e sono entrambi in costante miglioramento. Da segnalate anche l’outsider Anthropic con il suo Claude. E sembra che dalla Cina siano in arrivo prodotti rivoluzionari».

    La prima legge sull’AI

    La grande sfida quindi è tra americani e cinesi con il terzo incomodo rappresentato dagli arabi, grossi investitori in tecnologie. In questo contest, la nostra startup iGenius insieme a un consorzio di enti italiani ha sviluppato questo modello di linguaggio. «È un bel messaggio perché in questa sfida noi europei eravamo gli spettatori» evidenzia Bonanomi «eppure siamo i migliori a normare, non a caso abbiamo fatto l’AI Act, la prima legge sull’intelligenza artificiale, approvata dal Parlamento europeo il 13 marzo 2024 allo scopo di regolamentare gli usi ed evitare gli abusi. Uno dei fenomeni che si cerca di prevenire è il cosiddetto deep fake ovvero quei falsi contenuti in cui ci si appropria dell’immagine di qualsiasi persona per fargli fare o dire cose che non ha mai fatto o detto. Finché è Sinner che manda a quel paese il giudice di sedia è satira e non fa danni ma se è Zelenski che si arrende a Putin senza condizioni, quando non è vero e qualcuno ci crede, il discorso cambia».

    Attenzione alla sicurezza e all’etica

    Nel modello Italia ci sono dei filtri di sicurezza a garanzia dell’integrità e dell’eticità dei contenuti generati dal modello stesso, ottimizzati per la lingua italiana. Se cerchi di far dire a un politico qualcosa che non ha detto, il modello filtra questa cosa e la rimuove. Allo stesso modo rimuove anche contenuti sensibili ed espliciti, inadatti ai minori, ed è molto attento al rispetto del copyright. L’apprendimento del chatbot Italia è avvenuto su contenuti italiani. «Questo significa che per addestrare la nostra AI sono stati utilizzati soltanto documenti italiani, legittimamente, e non si è andati in rete a “trarre ispirazione” da giornali e libri più o meno famosi» spiega l’esperto, «cosa che è stata fatta in precendenza, come dimostrano le cause in corso fatte da John Grisham e dal New York Times contro OpenAI. Non a caso anche in Italia cominciano a vedersi sui giornali e in sovrimpressione sui programmi tv scritte del tipo “non autorizziamo l’utilizzo per formare e addestrare l’intelligenza artificiale».

    Superare i pregiudizi

    «Quando si istruisce un chatbot su una serie pressoché infinita di dati, questo prenderà per buoni tutta una serie di contenuti e di idee che sono stati generati dagli umani nel corso dei dei secoli, contenuti e idee purtroppo non esenti da distorsioni e pregiudizi» continua Bonanomi. «Per esempio all’inizio, quando chiedevi a ChatGPT “X sta stirando e lavando il pavimento, chi è X?”, ti rispondeva sempre che era donna, perché così era stato “istruito”. Chiedendo oggi la stessa cosa, ti dirà nel 50% dei casi che è donna e nel 50% dei casi che è uomo, perché è stato praticamente corretto il pregiudizio. Se un’intelligenza artificiale impara che in passato una certa categoria di persone era privilegiata rispetto a un’altra, si regolerà di conseguenza. Guardando le statistiche, le donne guadagnano a parità di livello il 15% meno degli uomini. A questo punto in una trattativa di assunzione un chatbot che deve proporre un contratto andrà in automatico a proporre il 15% in meno alle donne. Il modello Italia si è dotato degli strumenti per correggere sessismo e discriminazioni pur mantenendo una visione realistica dei fatti».

    Una AI addestrata tutta in italiano

    L’idea di avere quindi un’intelligenza artificiale più etica è sicuramente uno degli obiettivi del modello Italia ma non è l’unico, l’altro era quello di addestrarlo prevalentemente su fonti italiane. Una cosa nuova rispetto a chatGPT è riferito a testi in lingua inglese nella stragrande maggioranza dei casi. Per istruire il nostro sono state utilizzate diverese tipologie di contenuti dal web come per esempio wikipedia ma anche riviste, libri e documenti a libero accesso. Per farlo è stato utilizzato un super computer che si chiama Leonardo, che sostanzialmente è un progetto di un’università italiana, ed è stata attivata una proficua collaborazione con un editore nazionale per un archivio di articoli di stampa eticamente utilizzati.

    Per un rinascimento digitale

    Fare riferimento alle nostre opere tramite un modello con DNA umanistico italiano può essere un bel modo di valorizzare la cultura italiana promuovendo una sorta di rinascimento digitale. Un patrimonio immenso che merita di essere rinverdito, rinfrescato, potenziato e fatto conoscere al grosso pubblico e alle giovani generazioni che usano molto AI e tecnologie ma sono più avvezze allo smartphone e ai social media che alla Divina Commedia o ai Promessi Sposi. «Magari mentre impara dall’AI come prevalere all’interno di una contrattazione un utente potrebbe incontrare il principe di Machiavelli. Se poi dovesse aver bisogno di un aiuto per visitare Roma, un chatbot che conosce approfonditamente i testi archeologici e la nostra cultura di epoca romana sarà in grado di dire cose più interessanti rispetto a un modello americano, portato per sua formazione a stare sulle generali. Un bel progetto, quindi, la cui necessità è dimostrata dal fatto che in Europa non siamo nemmeno stati i primi. I francesi ci hanno preceduto con il loro Mistral, un ottimo
    modello di AI addestrato sulla cultura d’oltralpe e apprezzato anche qui in Italia. Non chiedetegli, però, consigli su come migliorare il vostro bagno. Potreste trovarvi all’improvviso senza bidet» conclude sardonico Gianluigi Bonanomi.

    ChatGPT, come stai?

    Gli appassionati del “Fai da tech” troveranno interessante la lettura del nuovo libro di Gianluigi Bonanomi dal titolo “ChatGPT, come stai? Il prompt engineering come nuova skill ibrida”. Uno sguardo diverso su un mondo solo apparentemente freddo e prevedibile. Chi di noi non si è divertito a mettere in imbarazzo il chatbot con domande strane e chi non lo ha insultato in mille modi perché non capiva di cosa avevamo bisogno? Il rapporto con l’AI è complesso e stimolante. Questo libro è al tempo stesso una riflessione innovativa sul rapporto tra umani e intelligenze artificiali generative e un manuale pratico. Bonanomi guida il lettore in un viaggio attraverso le sfaccettature dell’AI, analizzando la capacità “emotiva” e di “comprensione” di ChatGPT e degli altri modelli di linguaggio. Il testo illustra, passo a passo, come interagire efficacemente con i chatbot grazie al prompt engineering, sfruttando trucchi, tecniche evolute e metodi esclusivi come G.O.L.D. e SO.C.RA.T.E.

    Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

    Scrivimi mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

    Inviaci email

    Dal marzo 2024 Claude, LLM di Anthropic dei fratelli Amodei, è accessibile in Italia nella versione gratis. In questo video spiego cos’è, cosa fa, chi l’ha fondato, perché si chiama così e cosa lo differenzia da ChatGPT:

    Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

    Scrivimi mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

    Inviaci email

    Nel febbraio 2024 ho scritto per il sito Dillofacile.it un articolo sul prompt engineering, o meglio sul mio metodo SO.C.RA.T.E. Lo riporto integralmente qui.

    Intelligenza Artificiale Generativa e Prompt Engineering

    Nel panorama sempre più complesso dell’intelligenza artificiale generativa, il prompt engineering emerge come una disciplina cruciale per ottimizzare l’interazione tra umani e macchine. Qualcuno parla di nuovo mestiere, per me è una nuova skill.

    Il metodo SO.C.RA.T.E.
    Lavorando su vari prompt, mi sono inventato il metodo SO.C.RA.T.E., che rappresenta una strategia innovativa e potente per affinare la comunicazione con gli strumenti basati sull’IA, come ChatGPT e compagnia bella, ribaltando la situazione: non dobbiamo essere noi a interrogare il chatbot, ma viceversa!

    Il metodo socrAItico
    Mi sono ispirato al metodo socratico: una forma di indagine, basata su domande e risposte che stimolano il pensiero critico e generano idee, che si trova in molte delle opere di Platone (dove Socrate è spesso il personaggio principale). In pratica, la cosiddetta maieutica.

    Questo approccio può essere applicato anche al rapporto tra ChatGPT e l’utente.
    Come Socrate, ChatGPT può porre domande per capire meglio le esigenze dell’utente, per guidarlo verso una comprensione più profonda della sua esigenza.

    Se dovessi chiedere a ChatGPT di generare un piano editoriale per alimentare il blog della mia azienda, non è detto che in un prompt io riesca a fargli comprendere al meglio che cosa produciamo, per chi, ecc. Bisogna scatenare il ping pong.

    Che cosa vuole dire “SO.C.RA.T.E.”?
    “SO.C.RA.T.E.” è un acronimo, e sta per:

    • SOllecito
    • Contesto
    • RAffinamento
    • Turni
    • Esortazione

    Sollecito
    Il primo passo consiste nel sollecitare il chatbot, ovvero formulare una richiesta chiara e diretta.

    La precisione nella domanda è cruciale. Come già visto, una richiesta vaga o generica può portare a risposte meno pertinenti. È importante essere specifici: se si desidera una risposta in un determinato ambito o contesto, questo deve essere esplicitato.

    Per esempio, chiedere “Quali sono le ultime tendenze nel marketing digitale nel mercato B2C?” è più efficace di un generico “Parlami di marketing”.

    Contesto
    Il contesto riguarda l’inserimento di informazioni aggiuntive che possono aiutare ChatGPT a comprendere meglio la richiesta. Questo include dettagli specifici, sfumature o condizioni particolari.

    Per esempio, se si chiede un contenuto che riguarda un argomento tecnico, specificare il livello di complessità desiderato nella risposta può essere molto utile.

    RAffinamento
    Il raffinamento – fase non indispensabile – si riferisce a ulteriori dettagli, ancora più specifici.

    Per esempio, se sto chiedendo a ChatGPT di simulare un colloquio di lavoro, posso indicare il link dell’offerta.

    Turni
    Questo è il cuore del prompt socratico: occorre chiedere al chatbot di organizzare una conversazione a turni, una vera intervista.

    Invece di aspettarsi una risposta completa e definitiva in un solo scambio, è spesso più produttivo provocare un ping pong, dove ogni risposta fornisce la base per la domanda successiva.
    Questo approccio è particolarmente utile per esplorare argomenti complessi o per affinare gradualmente il focus della conversazione.

    Il comando è molto semplice: “Fammi una serie di domande”.

    Esortazione
    Se mi limitassi a chiedere al chatbot “fammi una serie di domande”, però, avrei un problema: le farebbe tutte insieme, in una volta sola. Non va bene. Se voglio che ogni domanda alimenti la successiva, devo specificare che deve aspettare la mia risposta prima di porre la domanda successiva.

    In conclusione
    Il metodo SO.C.RA.T.E. è un approccio strutturato per interagire efficacemente con ChatGPT. Attraverso una buona richiesta e un dialogo a turni, è possibile ottenere il massimo dal chatbot. Provare per credere, come diceva un altro grande filosofo (non è vero, era Guido Angeli, imbonitore televisivo!).

    Un esempio d’uso del metodo SO.C.RA.T.E.

    Ecco l’esito:

    Il video che spiega il metodo SO.C.RA.T.E.

    Il mio libro sul prompt engineering

    Il mio libro “ChatGPT come stai?” comprende questo e altri metodi di prompt engineering. Ecco la presentazione del libro:

    Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa

    Scrivimi mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.

    Inviaci email

    Ecco un possibile percorso formativo sull’intelligenza artificiale generativa, suddiviso in 10 appuntamenti da 3/4 ore ciascuno.

    Scenario

    Da decenni si parla di intelligenza artificiale, da anni di AI generativa. Ma è solo dalla fine del 2022, con l’esplosione della ChatGPT-mania, che molte aziende e professionisti hanno iniziato a interrogarsi su come potrebbe cambiare il mondo del lavoro. In questi primi mesi si è già visto come l’intelligenza artificiale travolgerà l’80% dei lavori e una vasta gamma di settori, dalla medicina alla finanza, dall’ingegneria al marketing, per non parlare dei mestieri creativi.

    L’intelligenza artificiale generativa, in particolare i modelli di linguaggio come GPT-4 o PaLM, può creare contenuti originali, rispondere a domande, scrivere codice, tradurre lingue, fare brainstorming e analisi evolute, e molto altro ancora. Questo apre una serie di opportunità per i professionisti in termini di efficienza, creatività e personalizzazione. Per esempio, i lavoratori del marketing e della comunicazione possono utilizzare l’IA generativa per creare piani editoriali e contenuti personalizzati, migliorando l’engagement e la conversione. Per questo il corso affronta il tema dei contenuti sia dal punto di vista strategico (piano editoriale) che tattico (come creare diversi tipi di contenuti, compresi quelli multimediali). Inoltre, l’IA generativa può aiutare i professionisti a rimanere competitivi in un mercato del lavoro sempre più digitalizzato: per questo nel percorso è stato inserito un incontro anche sul personal branding. In generale, l’IA generativa può aiutare i professionisti a liberare tempo da compiti ripetitivi (per esempio rispondere a decine di email o creare grafici e slide) e a concentrarsi su attività più strategiche e creative. Questo non solo può migliorare la produttività, ma può anche portare a un lavoro più gratificante. Del resto, come si suol dire, non è l’intelligenza artificiale a rubare il lavoro, ma un professionista che la sa usare bene.

    Il percorso è adatto a ogni professionista, dai C-level che vogliono comprendere il fenomeno AI ai lavoratori che vogliono capire come cambia il proprio lavoro da subito. Ogni appuntamento includerà una parte di spiegazione e una parte pratica, laboratoriale.

    Materiale

    Al termine di ogni lezioni i discenti riceveranno copia delle slide e spunti di approfondimento.

    Il percorso in 10 appuntamenti

    1. Introduzione agli LLM e all’intelligenza artificiale generativa

    • Panoramica dell’intelligenza artificiale generativa
    • Cos’è un LLM e come funziona
    • Prompt engineering
    • Problemi e limiti degli LLM
    • Casi di successo
    • Esercizio pratico: primi passi con un modello di linguaggio (es: ChatGPT)

    2. Piano editoriale data-driven

    • Cos’è un piano editoriale e perché è importante
    • Come utilizzare i dati per informare il tuo piano editoriale
    • Strumenti di analisi dei dati per il content marketing
    • Esercizio pratico: creazione di un piano editoriale basato sui dati

    3. AI Web Writing

    • Cosa differenzia la scrittura web da quella tradizionale
    • Come l’IA può migliorare la scrittura sul web (titoli, testi, cta, ecc.)
    • Strumenti di IA per la scrittura e la revisione dei contenuti
    • Esercizio pratico: utilizzo di LLM per la scrittura di un articolo, generazione di un prompt per la revisione dei articoli in ottica web writing

    4. Digital Storytelling

    • Cos’è il digital storytelling: principi di base e tecniche più diffuse
    • Come l’IA può migliorare il digital storytelling
    • Esercizio pratico: creazione di una storia con l’aiuto dell’IA

    5. Neuromarketing con l’intelligenza artificiale

    • Introduzione al neuromarketing
    • Come l’IA può essere utilizzata nella creazione di contenuti digitale e social grazie ai principi del neuromarketing
    • Esercizio pratico: creazione di contenuti con l’AI

    6. Contenuti multimediali

    • Come l’IA può migliorare la creazione di contenuti multimediali
    • Strumenti di IA per la creazione e l’editing di foto e video
    • Esercizio pratico: utilizzo di un tool di IA per la creazione di un video

    7. Presentazioni multimediali

    • I principi di base per fare una buona presentazione
    • Come l’IA può migliorare le presentazioni multimediali
    • Strumenti di IA per la creazione di presentazioni
    • Esercizio pratico: creazione di una presentazione con l’aiuto dell’IA

    8. Personal Branding con l’AI

    • Come l’IA può aiutare a costruire e gestire il personal branding
    • Strumenti di IA per il personal branding
    • Esercizio pratico: utilizzo di un tool di IA per migliorare il profilo LinkedIn

    9. Data Analysis

    • Introduzione all’analisi dei dati
    • Come l’IA può migliorare l’analisi dei dati
    • Strumenti di IA per l’analisi dei dati
    • Esercizio pratico: utilizzo di un tool di IA per analizzare un set di dati

    10. Q&A

    Sessione di domande e risposte per risolvere eventuali dubbi e approfondire gli argomenti trattati durante il corso.

    Che cosa dice chi ha seguito il corso

    Scrivimi per organizzare un corso sull’intelligenza artificiale generativa

    Scrivimi mandami un WhatsApp al 339.6325418 per organizzare un corso (o una conferenza) sull’A.I. generativa.

    Inviaci email