
C’è un paradosso nel mercato dei computer: l’intelligenza artificiale potrebbe offrire al PC una seconda vita domestica proprio mentre contribuisce a renderlo più caro. Da una parte i data center si contendono memorie e capacità produttiva. Dall’altra, modelli eseguibili sul nostro hardware permettono di immaginare un computer che consulta gli archivi di famiglia, prepara documenti e fa partire automazioni.
La mia tesi è questa: il prossimo motivo convincente per avere un PC in casa sarà un assistente personale che lavora sui nostri dati e svolge attività ricorrenti, con una parte dell’intelligenza sotto il nostro controllo. Un computer acceso può diventare un piccolo laboratorio e un centro di automazione: n8n organizza i passaggi, Ollama esegue i modelli, LM Studio permette di provarli e confrontarli. È un’ipotesi sul futuro degli usi domestici, non una previsione già dimostrata sulle vendite.
Dati e documentazione verificati il 14 ottobre 2026. Le automazioni descritte sono esempi progettuali, non risultati di test effettuati per questo articolo.
Vendite PC in calo: che cosa dicono davvero i dati del 2026
Il comunicato Gartner del 12 ottobre 2026 stima 55,35 milioni di PC consegnati nel terzo trimestre, il 22,4% in meno rispetto al terzo trimestre 2025. Sono stime preliminari sulle consegne ai canali distributivi e comprendono desktop e portatili con Windows, macOS e Chrome OS.
Il rapporto Omdia del 9 ottobre 2026 indica 58,1 milioni di unità e un calo del 21,2%, includendo desktop, notebook e workstation. Per Omdia, i desktop scendono del 23,5% e i notebook del 20,6%.
| Rilevazione | Periodo | Consegne globali | Variazione annua | Perimetro dichiarato |
|---|---|---|---|---|
| Gartner | Terzo trimestre 2026 | 55,35 milioni | -22,4% | Desktop e laptop, Windows/macOS/Chrome OS |
| Omdia | Terzo trimestre 2026 | 58,1 milioni | -21,2% | Desktop, notebook e workstation |
Le due serie hanno perimetri e metodi propri: non le fondo in una media. Il segnale comune è un forte arretramento delle consegne globali. Questi numeri, però, non misurano da soli gli acquisti delle famiglie italiane. Dire che il mercato PC si contrae è sostenuto dai dati; dire che un italiano su cinque ha smesso di comprare computer sarebbe un salto logico.
Gartner collega il calo ai rincari e alla minore disponibilità di configurazioni economiche. Omdia segnala anche l’effetto degli acquisti anticipati nella prima parte dell’anno: chi si è portato avanti per evitare aumenti non ricompra pochi mesi dopo. Il PC sul tavolo continua a funzionare; quello in negozio costa di più. Una combinazione poco invitante.
Il paradosso: l’AI che promette di rilanciare i PC ne aumenta i costi
Nell’analisi di International Data Corporation sulla crisi delle memorie, lo spostamento della produzione verso memorie destinate ai data center AI restringe la disponibilità per l’elettronica di consumo. Il problema si intreccia con la domanda di computer capaci di eseguire modelli in locale, che hanno a loro volta bisogno di memoria.
Una previsione IDC pubblicata il 2 giugno 2026 stimava per l’intero anno un calo delle consegne dell’11,3% e un aumento del prezzo medio del 17%. Sono previsioni datate, non consuntivi né l’ultima rilevazione trimestrale. Omdia, nel comunicato di ottobre, prevede un ulteriore calo del 7% per il 2027: anche questo è uno scenario di mercato, non un fatto già avvenuto.
Qui nasce il conflitto: i produttori vorrebbero venderci computer più potenti per l’AI, ma il consumatore deve avere un motivo concreto per pagarli. Scrivere «AI PC» sulla scatola non risolve il problema. Serve un’attività utile, ripetuta abbastanza spesso da giustificare l’acquisto.
AI locale: che cosa cambia per il computer di casa
Far girare un modello in locale significa eseguire il calcolo sul proprio computer. Dopo aver scaricato programma, modello e componenti necessari, alcune attività possono funzionare senza connessione. La documentazione sul funzionamento offline di LM Studio indica che chat, elaborazione dei documenti e server locale possono operare senza Internet e che, in quelle funzioni locali, documenti e conversazioni rimangono sul dispositivo.
È una possibilità interessante per un archivio di bollette, contratti, manuali e appunti. Alla domanda «Dove trovo le condizioni della mia assicurazione?» il valore sta nel recuperare il passaggio giusto dal documento. Il computer può diventare la porta d’accesso al proprio patrimonio informativo, un tema che ho approfondito anche nell’articolo su agenti AI e second brain.
Ma leggere e riassumere è soltanto una parte della storia. Il passaggio più interessante è collegare quell’intelligenza a un processo: ricevere un file, estrarre informazioni, verificarle, salvare un risultato e presentarlo alla persona. È qui che il PC comincia a lavorare anche quando non stiamo scrivendo nella chat, purché resti acceso e i servizi siano attivi.
LM Studio: un laboratorio per provare modelli gratuiti in locale
LM Studio permette di scaricare e utilizzare modelli linguistici attraverso un’interfaccia grafica. È un punto d’ingresso per chi vuole confrontare famiglie come Qwen, Mistral, Gemma e gpt-oss nelle versioni compatibili con il proprio hardware. I nomi delle famiglie non bastano: bisogna scegliere dimensione, formato e licenza della singola versione.
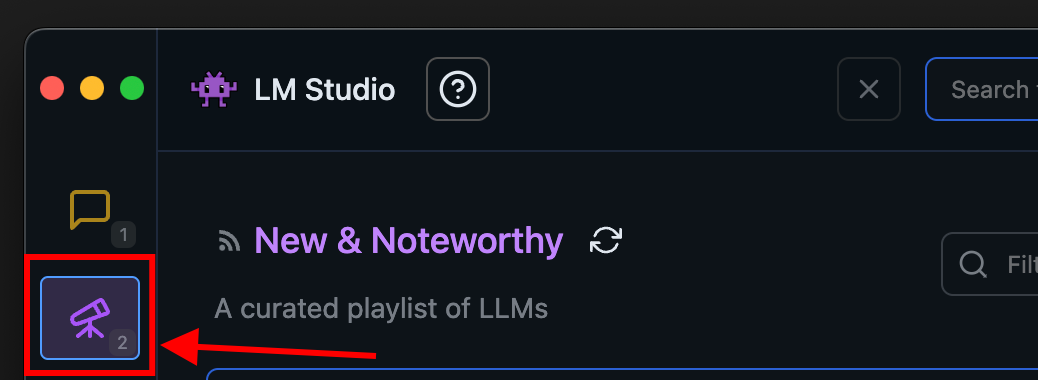
Open source, open weights e gratuito non sono sinonimi. Un modello con pesi scaricabili può avere condizioni d’uso specifiche. LM Studio è un’applicazione distinta dai modelli che esegue: scaricare un modello non rende automaticamente open source ogni componente del sistema. Per un utilizzo professionale bisogna controllare anche gli usi consentiti dalla licenza.
Una prova utile consiste nel dare a tre modelli lo stesso testo e la stessa richiesta. Per esempio:
Analizza esclusivamente il documento allegato. Estrai oggetto, date, importi e attività richieste in una tabella. Per ciascun dato indica il passaggio del testo che lo sostiene. Se un’informazione manca, scrivi «non presente». Non completare i vuoti con supposizioni.
Per rendere il confronto sensato, userei una decina di documenti con risposte già controllate. Annoterei errori, omissioni, tempi di risposta e facilità di utilizzo, mantenendo comparabili le impostazioni. Sono criteri di prova proposti, non un benchmark svolto qui. Un modello brillante nella scrittura potrebbe essere mediocre nell’estrazione di scadenze.
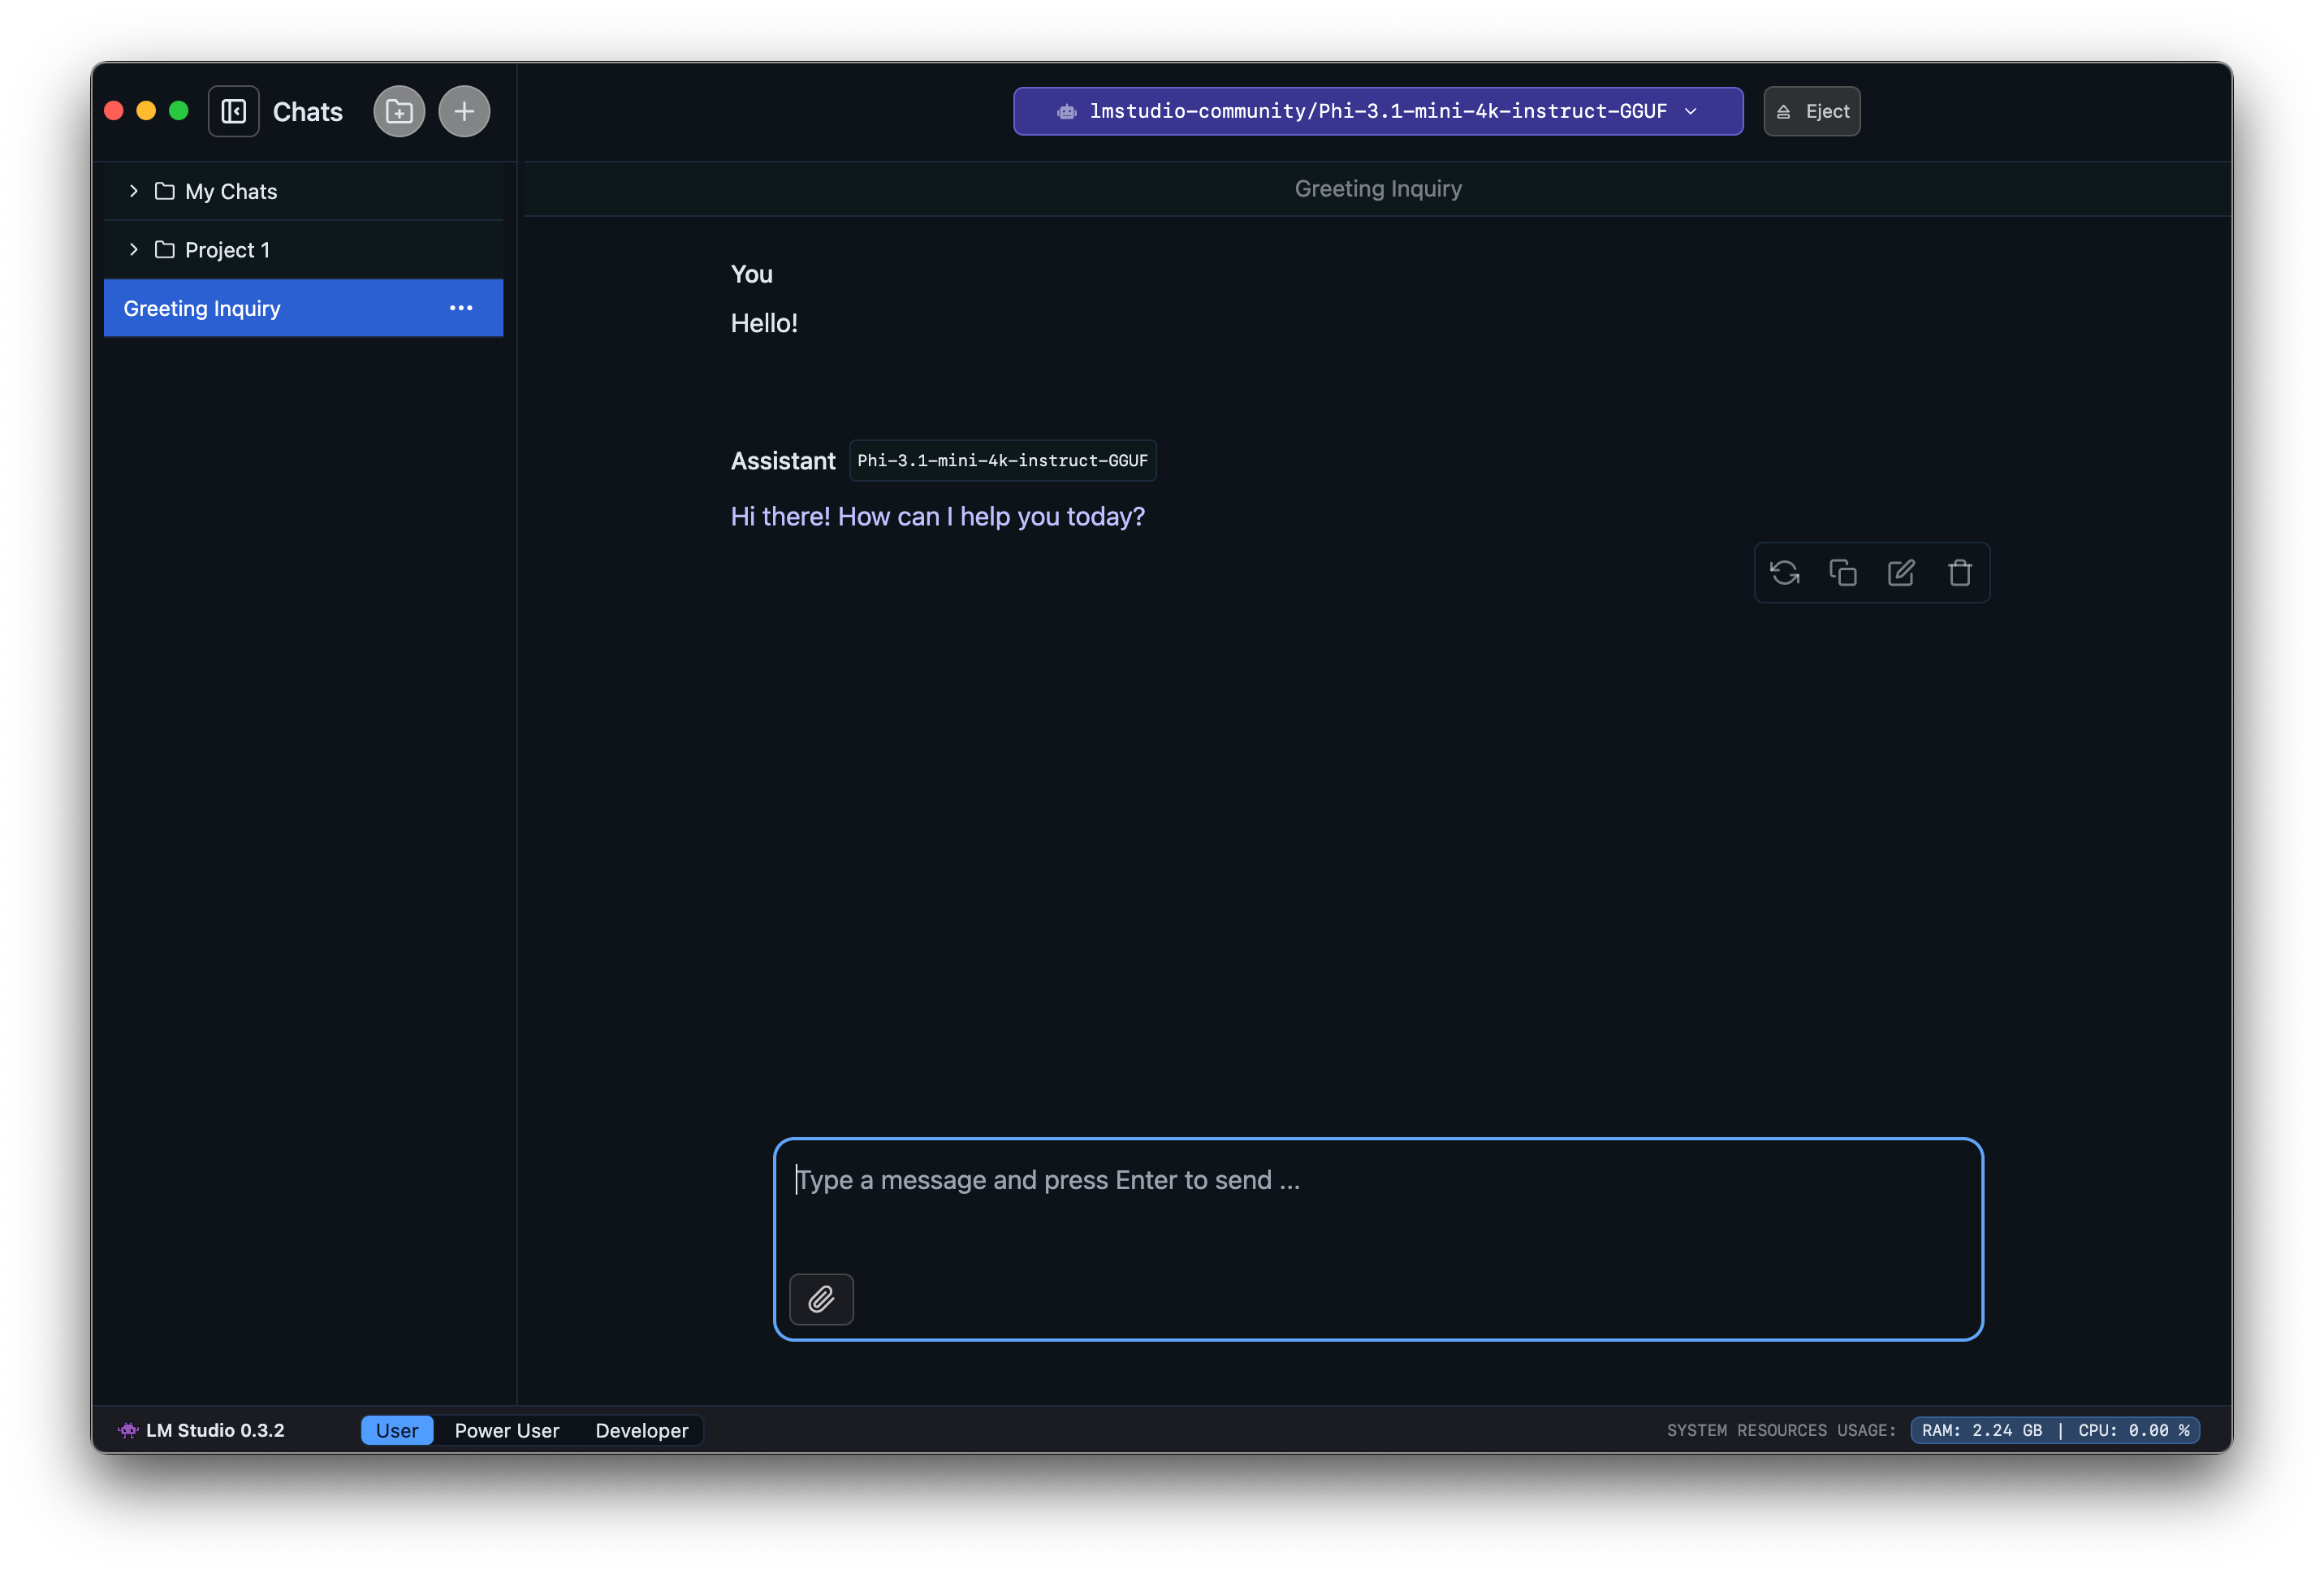
La funzione Chat with Documents accetta file DOCX, PDF e TXT. Il recupero di passaggi pertinenti, spesso chiamato RAG, aiuta a dare al modello un contesto documentale: le risposte vanno comunque confrontate con gli originali.
Ollama: il motore locale da collegare alle automazioni
Ollama permette di scaricare ed eseguire modelli sul computer e di utilizzarli attraverso interfacce e API. In un progetto domestico può fornire il motore linguistico a un altro programma: invece di copiare un testo nella chat, un flusso automatico lo invia al servizio locale e recupera il risultato.
LM Studio e Ollama hanno funzioni in parte sovrapposte. Per orientarsi, userei LM Studio come laboratorio grafico di confronto e Ollama come componente da integrare nei flussi. Anche LM Studio offre API per applicazioni e script: non esiste una divisione obbligatoria tra i due.
Bisogna scegliere davvero l’esecuzione locale. Ollama offre anche modelli cloud: la sua informativa sulla privacy distingue il trattamento dei dati nelle due modalità. Un programma installato sul PC può chiamare un servizio remoto. Per sapere dove avviene l’elaborazione occorre controllare modello, endpoint e integrazioni attive.
n8n sul PC: automazioni senza abbonamento al servizio cloud
n8n si può installare sulla propria infrastruttura, per esempio con Docker. Senza chiave di licenza funziona nella Community Edition gratuita. La versione ospitata dal fornitore e le edizioni commerciali hanno condizioni diverse: gratuito in questo caso significa usare la propria installazione nelle condizioni previste.
n8n rappresenta i processi attraverso nodi: un evento iniziale, un’operazione sui dati, una chiamata a un modello e un risultato. Una catena può partire a un orario prestabilito, leggere documenti e generare un riepilogo. Molte automazioni, come copiare file o verificare un nome, non richiedono affatto un LLM: usare regole semplici dove bastano rende il processo più prevedibile.
La Sustainable Use License di n8n consente, nei suoi limiti, l’uso personale e per attività interne. È una licenza con restrizioni, diversa dalle licenze open source senza quei vincoli. Questo non impedisce il progetto domestico descritto, ma rende impreciso presentare n8n come «open source utilizzabile senza condizioni».
Per collegare i passaggi AI esiste il nodo Ollama Chat Model. n8n coordina il flusso e Ollama esegue il modello locale. Il risultato può tornare in un file sul PC. Se invece il flusso usa Gmail, Google Drive o un’API esterna, quei passaggi coinvolgono servizi online: avere il modello in locale non rende offline l’intera automazione.
Un punto di partenza: il Self-hosted AI Starter Kit
Il kit ufficiale di n8n riunisce n8n, Ollama, il database vettoriale Qdrant e PostgreSQL in un ambiente basato su Docker Compose. È un punto di partenza per prototipi e prove, non un sistema domestico già pronto e configurato per ogni esigenza. La documentazione richiede di adattarlo e proteggerlo prima di un uso continuativo.
Nel video ufficiale si vede l’ambiente in azione. È una dimostrazione del kit, non la prova che qualunque computer riesca a eseguire qualunque modello con le stesse prestazioni.
Video presentato nell’articolo ufficiale n8n sul Self-hosted AI Starter Kit.
Cinque automazioni che darebbero un motivo per tenere acceso il PC
I seguenti sono progetti realizzabili con una configurazione adatta, non funzioni già disponibili appena si installano i programmi. Alcuni richiedono script, nodi aggiuntivi o un sistema OCR per le scansioni.
| Progetto | Flusso proposto | Risultato utile | Controllo umano |
|---|---|---|---|
| Archivio di bollette e contratti | Scansione periodica di una cartella; estrazione del testo; modello locale; verifica dei campi | Indice con fornitore, importo, date e nome del file | Verificare cifre e scadenze prima di usarle |
| Appunti dopo una lezione | Nuovo file di appunti; modello locale; salvataggio di riepilogo e domande | Materiale per ripassare conservato sul PC | Confrontare il riepilogo con gli appunti |
| Documenti da riordinare | Elenco dei file; classificazione proposta; anteprima degli spostamenti | Piano per ordinare l’archivio | Approvare il piano prima di muovere i file |
| Bozze per un professionista | Nuovo documento di richiesta; estrazione delle esigenze; creazione di una bozza | Prima bozza di risposta o proposta | Rivedere contenuto e destinatario prima dell’invio |
| Rassegna da feed RSS | Raccolta online; selezione; sintesi con modello locale; salvataggio | Rassegna con link agli originali | Controllare sintesi e attendibilità delle notizie |
Prendiamo la prima: ogni sera il PC esamina una cartella, identifica i nuovi PDF, estrae il testo e chiede al modello di restituire dati in un formato prestabilito. Un controllo successivo intercetta importi assenti o date non valide; gli elementi dubbi finiscono in una lista da rivedere. Il flusso prepara un indice, non paga bollette né decide al posto della famiglia.
La rassegna mostra bene l’approccio ibrido: le notizie arrivano da Internet, ma la sintesi può avvenire sul proprio hardware. Il collegamento tra servizi e modello è più interessante del singolo chatbot, perché toglie una sequenza di operazioni ripetitive.
Un’altra possibilità è la casa connessa. Home Assistant documenta l’integrazione con Ollama per un agente conversazionale locale. Il controllo dei dispositivi è indicato come sperimentale e richiede modelli con supporto agli strumenti. È un esempio concreto di integrazione disponibile, da distinguere dall’idea di un maggiordomo digitale già affidabile su ogni comando.
Quanto è gratuito? Costi, hardware e limiti dell’AI locale
Con un modello scaricato ed eseguito interamente sul proprio hardware, l’inferenza non comporta una tariffa per chiamata a un fornitore cloud. Anche la Community Edition di n8n può evitare l’abbonamento alla piattaforma ospitata. Il costo complessivo resta però diverso da zero: computer, energia, spazio disco, eventuali backup e tempo per aggiornamenti e manutenzione. Le API esterne possono inoltre avere proprie tariffe.
Per valutare un sistema sempre acceso, farei questo conto: consumo medio in watt diviso 1.000, moltiplicato per ore di funzionamento e prezzo effettivo del kWh. Poi aggiungerei l’eventuale acquisto hardware. Il risparmio rispetto al cloud dipende da utilizzo e prestazioni richieste: non prometterei un ammortamento senza misurarli.
Come riferimento iniziale, i requisiti ufficiali di LM Studio raccomandano almeno 16 GB di RAM; per Windows indicano anche almeno 4 GB di memoria video dedicata come raccomandazione. La memoria necessaria varia con modello, quantizzazione e lunghezza dei testi. Questi numeri non garantiscono che un modello specifico giri velocemente.
Un computer già posseduto potrebbe bastare per prove con modelli piccoli. Un NAS o un mini PC può invece ospitare l’automazione e delegare il modello a un’altra macchina nella rete domestica, se configurati correttamente. Essere sempre acceso non significa essere abbastanza potente per l’inferenza: sono due requisiti diversi.
L’esecuzione locale offre controllo, ma non elimina gli errori del modello né protegge automaticamente file e credenziali. Per iniziare sceglierei flussi in lettura, copie di prova e bozze da approvare. Le azioni che modificano archivi o inviano messaggi meritano un passaggio umano esplicito.
Il ritorno nelle case si misurerà con l’utilità, non con l’etichetta AI
Vedo tre possibilità: il cloud rimane prevalente e il PC serve soprattutto come interfaccia; cresce un uso ibrido con elaborazioni locali e servizi online; oppure una parte di famiglie e professionisti adotta una macchina dedicata alle automazioni. La seconda mi sembra l’ipotesi più convincente, ma è un giudizio argomentato, non un dato di mercato.
Per parlare di rilancio delle vendite serviranno segnali ulteriori: utilizzo frequente delle funzioni locali, acquisti motivati da quelle funzioni e crescita effettiva della domanda domestica. Una quota crescente di computer venduti con componenti AI può semplicemente indicare la sostituzione dell’offerta esistente.
Inoltre, le funzioni potrebbero essere soddisfatte da smartphone, NAS o macchine già in casa. Anche questo rende meno automatico il legame tra AI locale e nuovi acquisti. Il PC ha una possibilità se rende semplici attività oggi frammentate e faticose, a un costo sostenibile.
Il futuro interessante del computer domestico è diventare un assistente operativo di cui possiamo scegliere modelli, dati e compiti. Un archivio consultabile, un laboratorio dove provare modelli e una macchina che esegue automazioni utili. Quando questa combinazione sarà facile da usare anche per chi non vuole passare il sabato a configurare Docker, avremo una ragione concreta per rimettere il PC al centro della casa.
Vuoi portare questi strumenti nel tuo lavoro?
Nei miei corsi e nelle consulenze sull’intelligenza artificiale possiamo partire da un’attività reale, scegliere gli strumenti e progettare una prima automazione con controlli chiari. Se vuoi valutare un workshop su modelli locali, agenti e automazioni per la tua organizzazione, scrivimi tramite il modulo.