
Una fotografia perfetta, una voce credibile, un video che sembra ripreso con il telefono. La domanda arriva sempre più spesso: «È stato fatto con l’intelligenza artificiale?». Google SynthID affronta il problema lasciando una traccia nei contenuti generati dai sistemi che lo adottano. Una filigrana invisibile, riconoscibile da un rilevatore. Mi piace l’idea: invece di affidarsi soltanto all’occhio allenato del detective digitale, il contenuto porta con sé un indizio sulla propria origine. Bisogna però saperlo interpretare.
Che cos’è Google SynthID e perché è nato
Google DeepMind presenta SynthID come una tecnologia per marcare e identificare contenuti generati o modificati con l’AI: immagini, video, audio e testi. Conviene distinguere subito tre elementi: SynthID è la tecnologia; la filigrana è il segnale inserito nel contenuto; SynthID Detector è un’interfaccia per cercarlo.
La genesi è concreta: quando la produzione sintetica diventa credibile, giudicare l’origine dal solo aspetto è fragile. L’approccio di SynthID consiste nell’inserire un segnale durante la creazione, per cercarlo successivamente. È come riconoscere la filigrana di una banconota: una traccia tecnica, che richiede uno strumento appropriato.
La storia: dalle immagini ai testi, fino al Detector
Il 29 agosto 2023 Google DeepMind annuncia la prima beta di SynthID per le immagini, in collaborazione con Google Cloud. Il debutto riguarda immagini prodotte con Imagen su Vertex AI. Google descrive due modelli che lavorano insieme: uno incorpora il watermark, l’altro lo identifica. Il segnale è inserito nei pixel, senza aggiungere un logo visibile.
Nel novembre 2023 SynthID compare anche nell’annuncio di Lyria, il modello di generazione musicale: la filigrana viene applicata ai contenuti audio generati dal modello. Il progetto comincia così ad andare oltre le fotografie.
Il 14 maggio 2024 arriva l’estensione ai testi di Gemini e ai video di Veo. Il 23 ottobre dello stesso anno la ricerca sui testi viene pubblicata su Nature. Nel 2025 nasce il portale SynthID Detector, inizialmente sperimentato con professionisti dei media.
Aggiornamento verificato l’8 ottobre 2026: la pagina ufficiale annuncia l’ampliamento dell’accesso al Detector e cita Google, OpenAI, NVIDIA e Kakao fra i fornitori supportati, indicando Apple come prossimo ingresso. Questo annuncio non autorizza a dedurre che qualsiasi file storico prodotto da quei fornitori sia rilevabile: contano i modelli e i segnali effettivamente supportati.
Come funziona la filigrana invisibile
Immagini e video: il segnale è dentro il contenuto
Per le immagini, il segnale è incorporato nei pixel: non coincide con un testo nel nome del file o con un semplice campo dei metadati. Nel documento del debutto, Google spiega che il sistema è progettato per resistere a modifiche comuni, come compressione e cambiamenti di colore. La robustezza dichiarata non equivale all’immunità a qualunque manipolazione.
Per i video il principio viene esteso ai fotogrammi. Nell’annuncio del 2024 Google descrive un watermark distribuito nel video, progettato per conservare la qualità percepita. Un contenuto può anche mescolare parti sintetiche e parti provenienti da altre fonti: l’esito va letto con attenzione, senza attribuirlo automaticamente a ogni secondo del filmato.
Audio: una traccia che non si ascolta
Per l’audio, Google descrive una filigrana impercettibile all’orecchio e progettata per sopravvivere a trasformazioni comuni. L’annuncio di Lyria e SynthID per la musica cita, fra le altre, compressione MP3, aggiunta di rumore e variazioni di velocità. Anche qui occorre distinguere la resistenza alle trasformazioni testate dalla garanzia assoluta.
Testi: la firma sta nella scelta dei token
Nei testi SynthID-Text interviene nella scelta dei token, parole o frammenti di parole. Il suo Tournament sampling introduce una firma statistica, che il rilevatore può misurare con la chiave appropriata.
Lo studio di Sumanth Dathathri e colleghi, Scalable watermarking for identifying large language model outputs, pubblicato su Nature nel 2024, descrive un esperimento su circa 20 milioni di risposte Gemini, con e senza watermark. Gli autori non rilevano differenze statisticamente significative nel feedback sulla qualità. Il dato riguarda la qualità percepita in quell’esperimento, non un’accuratezza universale del rilevatore.
Il filone scientifico aveva già un riferimento importante in A Watermark for Large Language Models, di John Kirchenbauer e colleghi, presentato a ICML 2023: favorire in modo controllato determinati token durante la generazione permette di lasciare un segnale statisticamente riconoscibile. SynthID-Text sviluppa una propria soluzione di campionamento.
Come usare SynthID: una guida con schermate
1. Verificare un file attraverso Gemini
La guida ufficiale di Gemini alla verifica dei contenuti AI indica il percorso: aprire Gemini, usare il comando per aggiungere file, caricare un’immagine, un video o un audio supportato e porre una domanda di verifica. Un prompt pratico, aderente a quelli suggeriti da Google, è:
Questo file è stato creato o modificato con l’intelligenza artificiale di Google? Verifica la presenza di una filigrana SynthID.
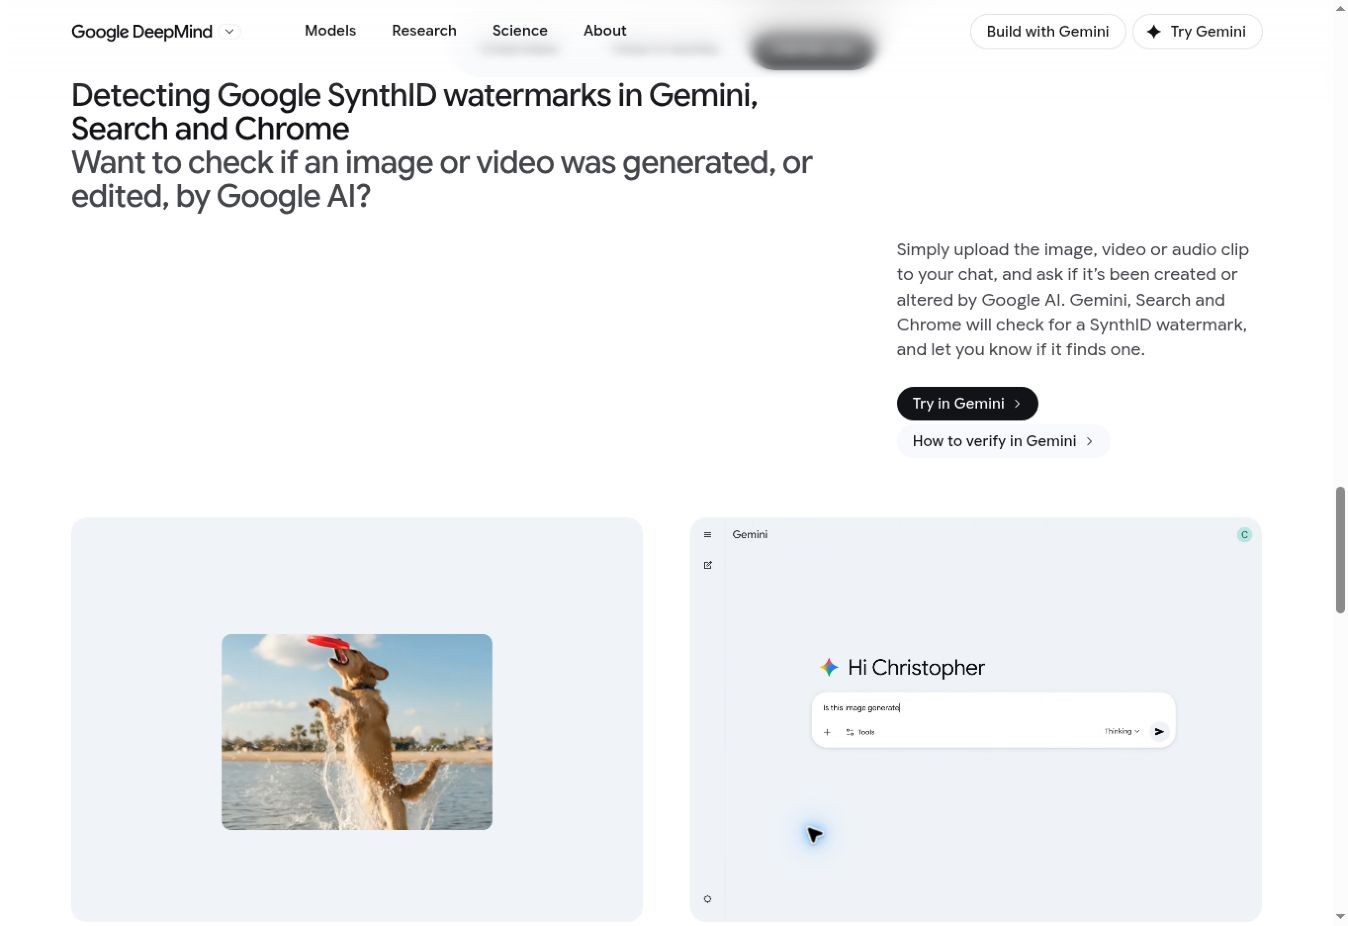
È essenziale distinguere questo percorso dal nuovo portale: la guida di Gemini, al momento della verifica, specifica che Gemini riconosce con SynthID i contenuti degli strumenti Google, mentre la pagina del Detector annuncia il supporto ai partner. Le due interfacce non vanno considerate automaticamente equivalenti.
2. Aprire SynthID Detector
Dalla pagina ufficiale di DeepMind si accede al portale tramite Try now. Si seguono le indicazioni dell’interfaccia per il file supportato e si legge il risultato, insieme agli eventuali dettagli sulla porzione analizzata. L’accesso presenta condizioni d’uso da valutare prima di proseguire. Non confondiamo il portale con un servizio che può esaminare senza limiti qualsiasi contenuto del web.
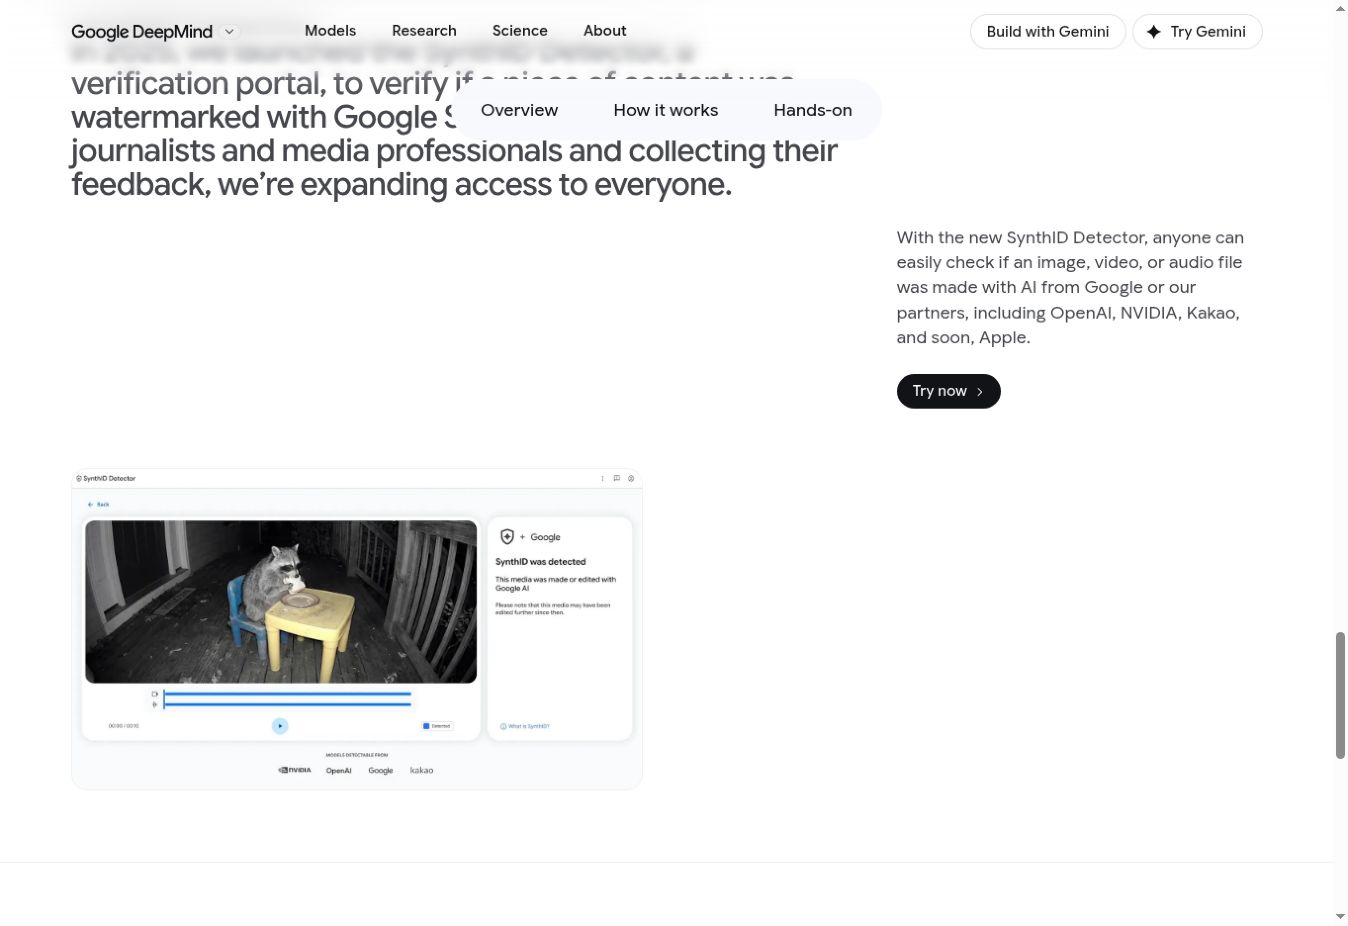
3. Interpretare il risultato senza saltare alle conclusioni
| Esito | Lettura corretta | Passo successivo |
|---|---|---|
| Filigrana rilevata | È presente un segnale compatibile con il sistema supportato. | Leggere attribuzione e ambito dell’esito; verificare fonte e contesto. |
| Filigrana non rilevata | Lo strumento non ha trovato quel segnale. | Mantenere aperta la possibilità di altri sistemi AI o di un segnale non più rilevabile. |
| Esito incerto | L’evidenza non basta per una risposta affidabile. | Cercare ulteriori informazioni e, se disponibile, il file originale. |
Per SynthID-Text la documentazione tecnica Google esplicita che la rilevazione è probabilistica e può prevedere tre stati: marcato, non marcato o incerto. Lunghezza, contenuto e soglie di decisione contano. Non basta una percentuale isolata per emettere un verdetto.
Un video per capire il meccanismo
Questo video del canale ufficiale Google DeepMind introduce la logica della filigrana e della rilevazione. È utile per orientarsi, mentre disponibilità e funzioni aggiornate vanno controllate nella documentazione corrente.
Cinque idee d’uso per aziende, scuole e professionisti
Quelli che seguono sono usi proposti, da adattare al proprio lavoro: non casi aziendali già documentati.
- Marketing: controllare le immagini ricevute. Prima di pubblicare un visual consegnato da un fornitore, chiedere informazioni sull’origine e usare la verifica come indizio aggiuntivo. Conservare file originale, dichiarazione del fornitore ed esito del controllo.
- Redazioni e uffici stampa: aggiungere un passaggio alla verifica. Un video virale va controllato anche cercando pubblicazione originaria, data e contesto. SynthID può aggiungere un’informazione al fascicolo; la verifica della notizia richiede altri riscontri.
- Formazione: insegnare a leggere un esito negativo. Mostrare un’immagine sintetica proveniente da un sistema non supportato. Se il segnale non viene rilevato, chiedere alla classe che cosa possiamo davvero dedurre.
- Comunicazione aziendale: accompagnare i contenuti con informazioni utili. Proporrei un piccolo registro per immagini, audio e video: strumento usato, data, revisore, destinazione ed eventuale intervento AI. Il watermark integra questa disciplina.
- Sviluppatori: sperimentare SynthID-Text sui propri modelli. È un progetto tecnico, che richiede configurazione e validazione del rilevatore; non si attiva scrivendo «aggiungi SynthID» nel prompt di un qualsiasi chatbot.
Per l’ultima idea, il repository ufficiale SynthID-Text offre codice e notebook per riprodurre la ricerca. Il README precisa che quell’implementazione è di riferimento e non destinata alla produzione; rimanda all’integrazione in Hugging Face Transformers per l’implementazione operativa. La guida per sviluppatori Google spiega che si interviene nella generazione senza dover riaddestrare il modello.
Un esercizio da portare in aula: «L’origine non si indovina»
Preparerei tre file di cui conosco la provenienza: una fotografia scattata da me, un’immagine generata da uno strumento Google compatibile e una prodotta con un sistema diverso. Chiederei prima un giudizio visivo, poi una verifica con lo strumento disponibile. Nessun volto o documento riservato è necessario: bastano paesaggi e oggetti.
La scheda del laboratorio avrebbe quattro colonne: provenienza nota, ipotesi dei partecipanti, esito della verifica e inferenza consentita. Per ogni file la domanda decisiva sarebbe: «Che cosa dimostra questo risultato, e che cosa resta da verificare?». Si lavora così sul ragionamento, oltre che sul pulsante da premere. I risultati raccolti sarebbero quelli della sessione, senza presentarli come un benchmark scientifico.
Quali sono i limiti di SynthID?
Il paper su Nature dedicato a SynthID-Text chiarisce due limiti fondamentali: la marcatura deve essere adottata da chi genera il testo e può indebolirsi dopo modifiche o parafrasi. Inoltre i testi brevi offrono meno evidenza statistica. Un risultato negativo non certifica quindi l’autorialità umana.
Una lettura critica complementare è Watermarks in the Sand: Impossibility of Strong Watermarking for Language Models, di Hanlin Zhang e colleghi, ICML 2024. Sotto ipotesi specifiche, gli autori mostrano limiti alla possibilità di avere watermark testuali resistenti a un avversario capace di modificare il testo preservandone la qualità. Gli esperimenti riguardano tre schemi precedenti: non sono una prova diretta che ogni versione di SynthID sia inutilizzabile.
Occorre poi separare origine e verità. Un’immagine sintetica può illustrare correttamente un concetto; una fotografia autentica può essere accompagnata da una didascalia falsa. La filigrana aiuta a ricostruire una parte della provenienza, senza verificare le affermazioni che qualcuno costruisce attorno al file. In una scuola o in un’azienda, non userei un rilevatore come unica base per accusare una persona.
SynthID, metadati e Content Credentials: come si distinguono?
Il watermark inserisce un segnale nel contenuto. Le Content Credentials dello standard della Coalition for Content Provenance and Authenticity, o C2PA, raccolgono invece dichiarazioni sulla provenienza e sulla storia del file, collegate tramite firme crittografiche. La spiegazione ufficiale C2PA chiarisce che possono documentare origine, modifiche e uso dell’AI, senza certificare che ciò che viene rappresentato sia vero. Le tecnologie possono integrarsi, anche attraverso collegamenti basati su watermark.
Se interessa il tema delle tracce lasciate nei testi, ho affrontato anche textGrain e la provenienza dei contenuti testuali. Per usare bene strumenti di questo tipo suggerisco sempre di chiedersi dove viene inserito il segnale, chi può leggerlo e quali trasformazioni possono influenzarlo.
Una firma utile richiede un lettore attento
Per chi si occupa di comunicazione, il valore di SynthID sta nella possibilità di aggiungere un riscontro tecnico al lavoro di verifica. Io lo inserirei in una procedura semplice: raccogliere la fonte, conservare l’originale, cercare i segnali disponibili, documentare il risultato e controllare il contesto. Se manca il segnale, la domanda resta aperta. È proprio questa prudenza interpretativa che vale la pena insegnare.