Tag Archivio per: context engineering

Quando si parla di intelligenza artificiale, le citazioni fanno spesso la stessa fine dei biscotti nei corsi: spariscono dal loro contesto. Una frase diventa uno slogan, lo slogan diventa una certezza e qualcuno finisce per attribuire a Einstein anche il prompt engineering.

Ho scelto dieci citazioni sull’intelligenza artificiale generativa e sugli agenti, accompagnandole con il loro contesto e con una conseguenza pratica. Alcune sono domande storiche, altre estratti da studi scientifici o guide tecniche. Il percorso parte dall’intelligenza delle macchine e arriva a una questione molto concreta: che cosa possiamo delegare, con quali strumenti e con quali controlli?

Nota sulle citazioni: i brani in italiano sono mie traduzioni di brevi estratti inglesi. Le omissioni sono indicate con […]. “Attention Is All You Need” è il titolo originale di un paper, riportato come tale. I collegamenti permettono di controllare formulazione e contesto.

1. Alan Turing: prima di discutere di intelligenza, definiamo la domanda

«Le macchine possono pensare?»
Avatar di Gianluigi Bonanomi con la citazione 1 di Alan Turing · 1950: Le macchine possono pensare?

Alan M. Turing, 1950. È la domanda che apre Computing Machinery and Intelligence. Turing passa poi a un problema più circoscritto, il gioco dell’imitazione, per ragionare sui comportamenti osservabili.

Questa citazione serve ancora perché ci costringe a chiarire che cosa stiamo chiedendo. “ChatGPT pensa?” può significare: produce risposte sensate, risolve un problema, possiede intenzioni oppure ha esperienza cosciente? Sono questioni diverse. Un testo convincente, da solo, non risolve l’ultima.

Nel lavoro: invece di discutere per un’ora se il chatbot sia intelligente, chiediamoci se sa sintetizzare correttamente quel verbale. Definiamo criteri verificabili: decisioni riportate, responsabilità attribuite, scadenze conservate. La filosofia resta interessante; il verbale deve comunque essere giusto.

2. Dartmouth: simulare una capacità non significa diventare una persona

«[…] una macchina può essere costruita per simularlo.»
Avatar di Gianluigi Bonanomi con la citazione 2 di McCarthy, Minsky, Rochester e Shannon · 1955: […] una macchina può essere costruita per simularlo.

John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon, 1955. Questo frammento della proposta per il progetto estivo di Dartmouth si riferisce alla congettura secondo cui gli aspetti dell’apprendimento e dell’intelligenza possono essere descritti con precisione sufficiente a simularli.

La parola decisiva è “congettura”: un programma di ricerca, non una dimostrazione già acquisita. Per leggere il presente, io terrei anche “simulare”. Un sistema può svolgere un’attività utile senza avere la biografia, le motivazioni o l’esperienza di chi la svolge normalmente.

Nel lavoro: far preparare una bozza commerciale all’AI può essere sensato. Trattarla come un collega che conosce automaticamente la storia del cliente è un salto ingiustificato. Quella storia va fornita, recuperata e controllata.

3. Vaswani e colleghi: attenzione alle relazioni tra le parole

«Attention Is All You Need»
Avatar di Gianluigi Bonanomi con la citazione 3 di Ashish Vaswani e coautori · 2017: Attention Is All You Need

Ashish Vaswani e coautori, 2017. È il titolo del paper che propone l’architettura Transformer. “Attenzione” indica qui un meccanismo computazionale, non la concentrazione cosciente di una persona.

Il titolo è diventato celebre, ma non significa che basti stare attenti per costruire un’AI. Il lavoro presenta un’architettura basata su meccanismi di attenzione, senza ricorrenza e convoluzioni, e la valuta su compiti di traduzione. Per un lettore non tecnico, il punto utile è che le relazioni nel contesto contano.

Nel lavoro: se chiediamo di spiegare la parola “rete”, un riferimento alla pesca, al calcio o ai computer cambia l’interpretazione richiesta. Inserire il contesto pertinente aiuta a disambiguare il compito; non garantisce automaticamente una risposta corretta.

4. Bender e colleghe: la fluidità del linguaggio può ingannarci

«[…] un pappagallo stocastico.»
Avatar di Gianluigi Bonanomi con la citazione 4 di Bender e colleghe · 2021: […] un pappagallo stocastico.

Emily M. Bender, Timnit Gebru, Angelina McMillan-Major e Shmargaret Shmitchell, 2021. Il frammento proviene dal paper sui rischi dei grandi modelli linguistici, che Bender riprende e contestualizza nelle sue spiegazioni pubblicate nel 2026.

“Stocastico” rimanda alla probabilità. La metafora invita a non attribuire automaticamente intenzioni umane a un testo fluente. Va però trattata come una lente interpretativa, non come una formula che esaurisce ogni capacità di ogni sistema attuale. Bender stessa distingue il modello linguistico dai prodotti che lo integrano con altri componenti.

Nel lavoro: una risposta elegante può contenere un riferimento inventato. Quando un chatbot cita un paper, aprire il collegamento e confrontare ciò che sostiene con il documento è parte del compito. Il tono sicuro non è una certificazione di qualità.

5. Ouyang e colleghi: più grande non equivale automaticamente a più utile

«Rendere più grandi i modelli linguistici non li rende, di per sé, migliori nel seguire l’intento dell’utente.»
Avatar di Gianluigi Bonanomi con la citazione 5 di Long Ouyang e coautori · 2022: Rendere più grandi i modelli linguistici non li rende, di per sé, migliori nel seguire l’intento dell’utente.

Long Ouyang e coautori, 2022. È l’apertura dell’abstract di Training language models to follow instructions with human feedback. Il lavoro studia come usare esempi e valutazioni umane per migliorare l’aderenza alle intenzioni dell’utente.

Qui si capisce perché un modello capace di continuare testi e un assistente utile non siano la stessa cosa. Nel lavoro descritto, alle dimostrazioni del comportamento desiderato seguono confronti tra risposte e un ulteriore addestramento basato sul feedback umano. Non ne deriva che ogni assistente sia infallibile o che tutti i sistemi seguano la stessa procedura.

Nel lavoro: scegliere un modello soltanto perché “è il più potente” è un criterio incompleto. Proviamolo su attività rappresentative: rispetta i vincoli? Mantiene il tono? Segnala ciò che manca? Quanto dobbiamo correggere?

6. La ricerca sulle allucinazioni: dobbiamo premiare anche il dubbio

«[…] premiano il tentare una risposta rispetto al riconoscere l’incertezza.»
Avatar di Gianluigi Bonanomi con la citazione 6 di OpenAI · 2025: […] premiano il tentare una risposta rispetto al riconoscere l’incertezza.

OpenAI, 2025. La frase compare nella presentazione della ricerca Why Language Models Hallucinate. Lo studio di Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala ed Edwin Zhang analizza il ruolo degli incentivi nell’addestramento e nella valutazione.

Se un test assegna zero punti sia a una risposta sbagliata sia a un’ammissione di ignoranza, indovinare può diventare conveniente. Questo aiuta a spiegare perché la sicurezza espressiva non coincida con l’affidabilità. Non è una spiegazione unica di tutti gli errori, né una prova che basti aggiungere “non inventare” per eliminarli.

Nel lavoro: quando valutiamo un assistente, inseriamo casi con informazioni mancanti. Una risposta utile può identificare la lacuna e chiedere il dato necessario. Se premiamo soltanto chi completa ogni casella, rischiamo di addestrare anche noi una macchina delle risposte plausibili.

7. ReAct: il passaggio agli agenti comincia dall’alternare ragionamento e azione

«[…] tracce di ragionamento e azioni specifiche del compito in modo alternato.»
Avatar di Gianluigi Bonanomi con la citazione 7 di Shunyu Yao e coautori · 2022: […] tracce di ragionamento e azioni specifiche del compito in modo alternato.

Shunyu Yao e coautori, 2022. Il paper ReAct: Synergizing Reasoning and Acting in Language Models esplora un approccio che alterna passaggi di ragionamento e azioni, anche per raccogliere informazioni esterne.

È un ponte utile tra la conversazione e il lavoro operativo. Il sistema non deve limitarsi a generare la descrizione di una ricerca: può interrogare una fonte, ricevere un risultato e adattare il passo successivo. Le tracce generate non vanno però confuse con una lettura trasparente della mente del modello.

Nel lavoro: per confrontare fornitori, un agente potrebbe cercare schede, estrarre condizioni, accorgersi che manca una specifica e cercarla. Il risultato va valutato sui documenti effettivamente recuperati. Scrivere “ho verificato” e aver verificato sono due cose diverse.
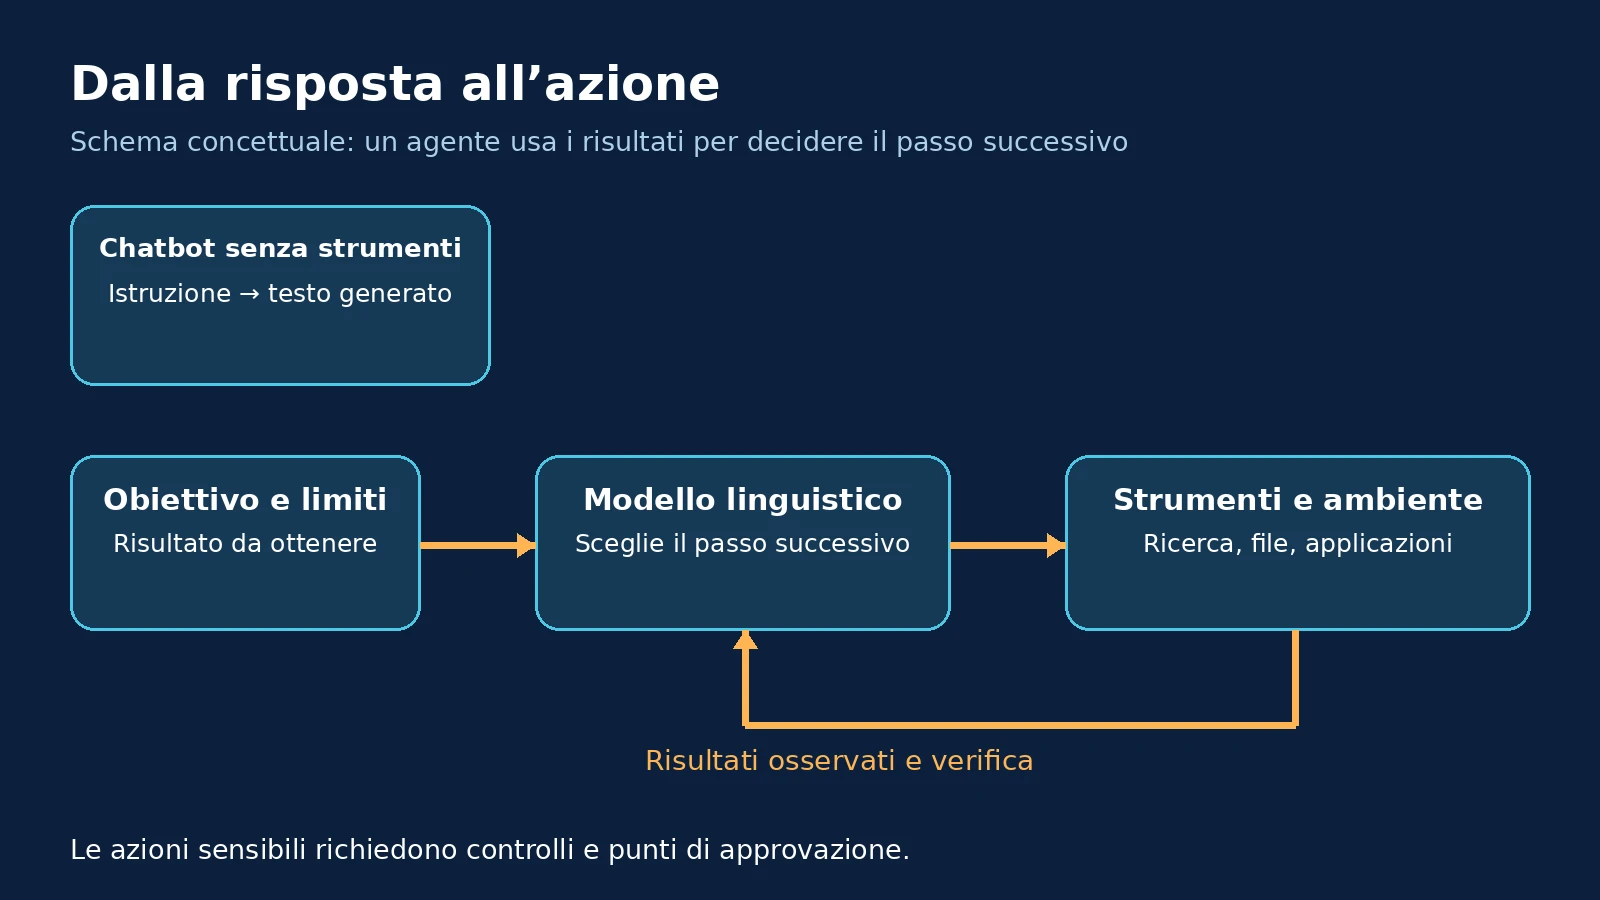
Schema del ciclo di un agente AI: obiettivo e limiti, modello linguistico, strumenti, risultati osservati e verifica.
Un agente usa i risultati delle azioni per scegliere come proseguire. Schema concettuale originale.

8. Anthropic: un agente decide come usare gli strumenti

«[…] gli LLM dirigono dinamicamente i propri processi e l’uso degli strumenti.»
Avatar di Gianluigi Bonanomi con la citazione 8 di Anthropic · 2024: […] gli LLM dirigono dinamicamente i propri processi e l’uso degli strumenti.

Anthropic, Building effective agents, 2024. La guida di Anthropic distingue i workflow con percorsi predefiniti dagli agenti in cui il modello determina dinamicamente i passaggi.

È una distinzione architetturale utile, non l’unica definizione possibile di agente. Una sequenza fissa che prende un file, lo riassume e lo archivia può essere un’ottima automazione. Diventa più propriamente agentica quando il modello sceglie il percorso in base a ciò che incontra.

Nel lavoro: se ogni venerdì devi copiare lo stesso report nella stessa cartella, comincia da un automatismo. Se devi indagare un’anomalia e decidere quali documenti esaminare, una componente agentica può avere senso. La complessità va giustificata dal problema, non dal fascino della parola “agente”.

9. Context engineering: il contesto non è un ripostiglio infinito

«Il contesto […] deve essere trattato come una risorsa finita con rendimenti marginali decrescenti.»
Avatar di Gianluigi Bonanomi con la citazione 9 di Anthropic · 2025: Il contesto […] deve essere trattato come una risorsa finita con rendimenti marginali decrescenti.

Anthropic, 2025. È un passaggio di Effective context engineering for AI agents. La guida porta l’attenzione dalle sole istruzioni all’insieme delle informazioni disponibili durante il lavoro.

Il prompt è una parte del contesto. Contano anche documenti, cronologia, descrizioni degli strumenti e risultati delle loro azioni. Aggiungere materiale può aiutare, ma può anche introdurre rumore, contraddizioni e versioni superate. La conseguenza operativa è selezionare ciò che serve e mantenerlo aggiornato.

Nel lavoro: per preparare un’offerta, meglio un listino valido, un brief chiaro e due esempi pertinenti che l’intero archivio di proposte degli ultimi anni. Quando manca una condizione, l’agente dovrebbe recuperarla dalla fonte appropriata. Il second brain è utile quando aiuta a trovare, non soltanto ad accumulare.
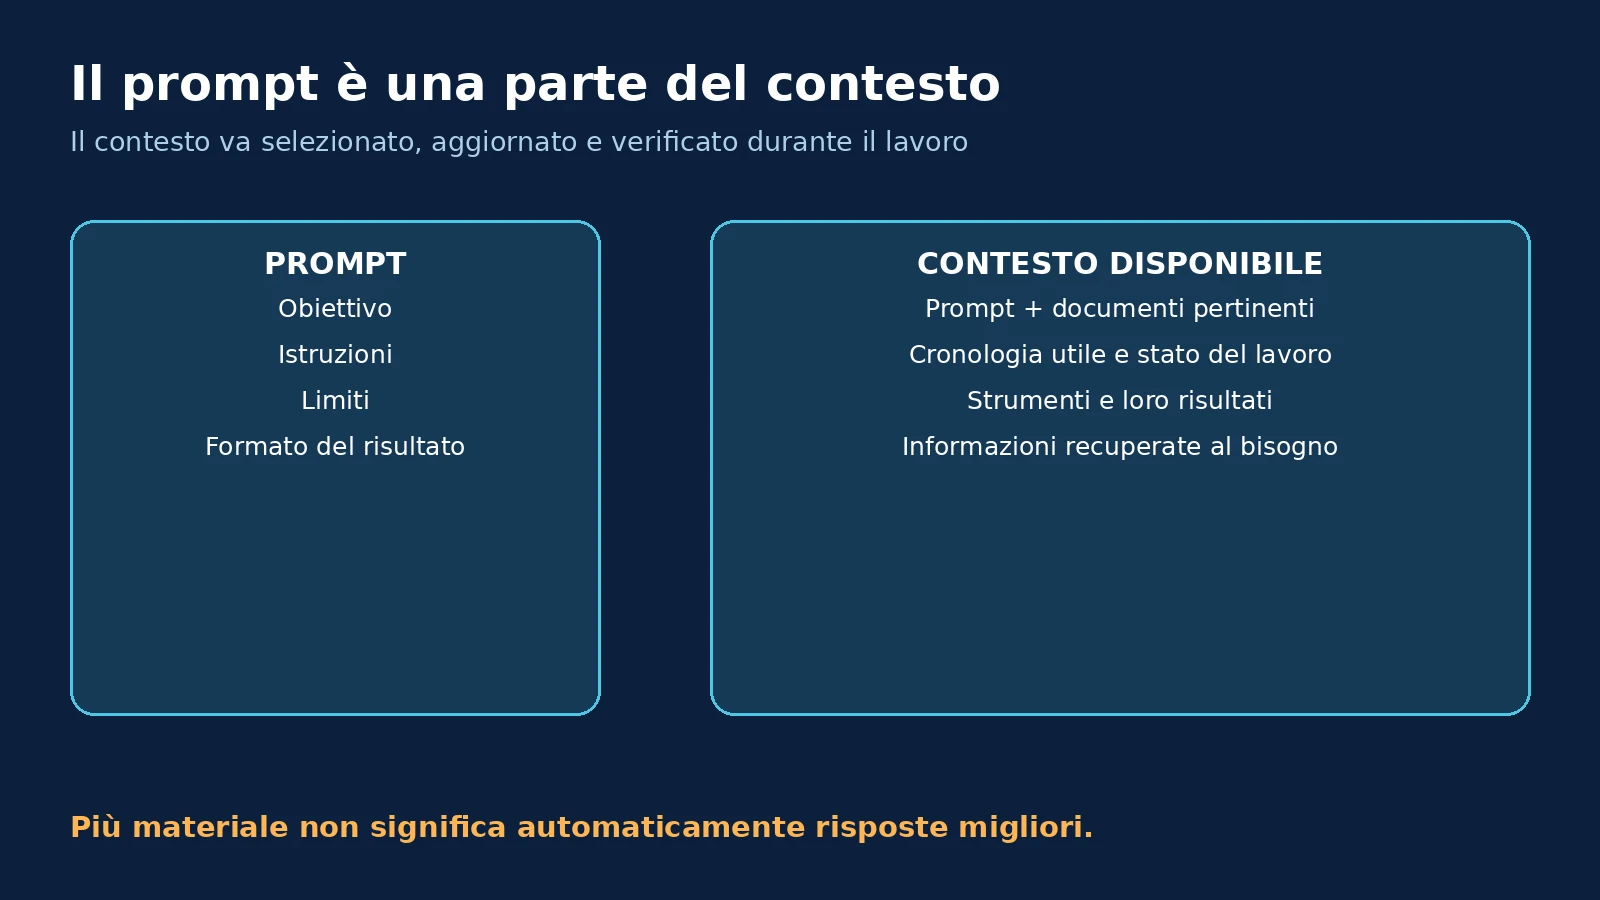
Differenza tra prompt e contesto: il contesto comprende istruzioni, documenti pertinenti, cronologia utile, strumenti e risultati.
Il context engineering riguarda anche la selezione e l’aggiornamento delle informazioni. Schema originale.

10. OpenAI: l’intervento umano è una parte del progetto

«L’intervento umano è una salvaguardia fondamentale […].»
Avatar di Gianluigi Bonanomi con la citazione 10 di OpenAI · 2025: L’intervento umano è una salvaguardia fondamentale […].

OpenAI, A practical guide to building agents, 2025. Nella sezione dedicata all’intervento umano, la guida pratica di OpenAI, sezione sull’intervento umano tratta il passaggio di controllo quando l’agente incontra problemi e le verifiche per azioni ad alto impatto.

La supervisione non dovrebbe essere un’aggiunta improvvisata dopo un incidente. Va progettata insieme ai permessi, ai limiti di esecuzione e alle condizioni di arresto. Autonomia significa delegare un perimetro di lavoro, con responsabilità e confini espliciti.

Nel lavoro: un agente può predisporre una risposta a un cliente e raccogliere gli allegati. Possiamo richiedere approvazione prima dell’invio di un’offerta vincolante, fissare un numero massimo di tentativi e consentire accesso solo ai documenti necessari. Così la delega diventa una procedura valutabile.

Un video per collegare i concetti

Per approfondire i modelli linguistici, propongo Intro to Large Language Models di Andrej Karpathy. È una lezione in inglese pubblicata nel 2023: utile per i fondamenti, mentre i riferimenti ai prodotti vanno letti come una fotografia di quel periodo.

Dalle citazioni a una delega concreta

La mia lettura di queste dieci frasi è molto pratica: definire il compito, distinguere la fluidità dalla correttezza, dare informazioni pertinenti, collegare strumenti e osservare i risultati. Infine, decidere dove la macchina deve fermarsi.

Nel mio metodo 4A e nei corsi sugli agenti AI distinguo automatismi, azioni programmate, assistenti e agenti. È una griglia didattica per scegliere quanta delega serve. Un’attività programmata non diventa automaticamente un agente, e un agente non è la soluzione migliore per qualsiasi attività.

Per mettere alla prova queste idee, scegli un compito reale e scrivi cinque cose: risultato atteso, informazioni necessarie, strumenti consentiti, criteri di verifica e punto di approvazione. Poi confronta il tempo risparmiato con il tempo speso a controllare e correggere. È un esperimento più utile di cento slogan sul futuro.

Vuoi portare AI generativa e agenti nel tuo team?

Progetto corsi e laboratori per aziende, enti e professionisti, partendo da attività concrete e dai controlli necessari. Raccontami il tuo obiettivo attraverso il modulo nella pagina contatti: possiamo costruire un percorso su misura.

Immaginate di affidare un lavoro a un nuovo collaboratore. Gli spiegate benissimo che cosa deve fare, poi gli consegnate tre preventivi superati, una presentazione del 2022, un verbale senza data e una cartella chiamata “Definitivo_vero_ultimo”. Quando sbaglia, gli rimproverate di non aver capito la richiesta.

Con l’intelligenza artificiale rischiamo di fare qualcosa di simile. Dedichiamo molta attenzione alla frase da scrivere nella chat e meno ai materiali che dovrebbero permettere di svolgere il compito. Un’istruzione impeccabile, però, non risolve una contraddizione tra due documenti dei quali abbiamo dimenticato di indicare la validità.

Questa riflessione prende spunto dall’articolo Effective context engineering for AI agents, pubblicato da Anthropic il 29 settembre 2025. Il tema è la progettazione del contesto disponibile agli agenti AI: istruzioni, informazioni e risultati delle azioni, selezionati e aggiornati durante il lavoro.

Che cos’è il context engineering

Il context engineering riguarda la gestione delle informazioni che un modello riceve mentre svolge un compito. Il prompt engineering si concentra sulla formulazione delle istruzioni; il context engineering considera anche documenti, cronologia e strumenti. Anthropic lo presenta come un’evoluzione del prompting, particolarmente rilevante per gli agenti che eseguono più passaggi.

La mia lettura pratica è questa: quando delego all’AI, devo preparare un incarico completo. Che cosa deve produrre? Quali dati deve utilizzare? Quale documento prevale? Quali informazioni mancano? Come controllerò il risultato?

È una prospettiva che si collega al mio metodo G.O.L., Guidare, Obiettivo, Limiti. A quelle istruzioni affiancherei una verifica dei materiali: abbiamo fornito all’assistente ciò che gli serve per rispettarle?

Una finestra di contesto grande non garantisce una lettura perfetta

Il lavoro Lost in the Middle: How Language Models Use Long Contexts, di Nelson F. Liu e colleghi, ha mostrato che, nei modelli e nei compiti studiati, la posizione delle informazioni influenzava le prestazioni. Le risposte erano spesso migliori quando il dato utile si trovava all’inizio o alla fine dell’input, peggiori quando era nel mezzo.

Un altro studio, RULER: What’s the Real Context Size of Your Long-Context Language Models?, di Cheng-Ping Hsieh e colleghi, ha valutato capacità che vanno oltre il recupero di un singolo dettaglio. Nei modelli analizzati, l’allungamento del contesto poteva accompagnarsi a cali importanti delle prestazioni.

Si tratta di ricerche del 2023 e del 2024: non sono una pagella dei chatbot disponibili oggi. Suggeriscono però una precauzione sensata: verificare come il modello usa i materiali sul nostro compito, anziché dedurlo soltanto dalla quantità di testo che può accettare.

Questo non significa che dobbiamo accorciare tutto. Se chiediamo un confronto completo tra due contratti, eliminare le clausole più scomode per “fare pulizia” sarebbe un disastro. L’obiettivo che propongo è rendere riconoscibili le informazioni necessarie, conservando l’accesso agli originali.

Un esempio: preparare un corso aziendale senza confondere i documenti

Supponiamo di dover progettare un corso di tre ore sull’AI per un gruppo commerciale. Abbiamo una mail del cliente, gli appunti della call, un questionario e programmi di corsi precedenti.

La richiesta “Agisci come un formatore esperto e prepara un corso coinvolgente” lascia aperte troppe decisioni. Un programma precedente potrebbe prevedere una giornata intera, un pubblico diverso o strumenti che il nuovo cliente non usa.

Io preparerei il lavoro in questo modo:

MaterialeFunzione nel nuovo incarico
Brief confermato dal clienteStabilisce pubblico, durata, obiettivi e vincoli concordati.
Questionario dei partecipantiDescrive competenze iniziali e bisogni, senza modificare gli accordi commerciali.
Programma precedenteOffre esempi riutilizzabili; durata e condizioni appartengono al vecchio incarico.
Appunti della callSegnalano ipotesi e punti ancora da confermare.

La distinzione decisiva è tra un dato approvato e un’idea ancora in discussione. Se nella call qualcuno ha proposto cinque ore, ma il brief finale ne conferma tre, voglio che l’assistente segnali il conflitto e segua il brief. Non che faccia una media creativa di quattro ore.

Questo schema è una mia applicazione operativa del tema, da adattare al proprio lavoro: proposte commerciali, piani editoriali, report, procedure interne.

Archivio, recupero delle informazioni e contesto sono cose diverse

Un archivio può contenere tutto lo storico di un’organizzazione. Per preparare una proposta specifica, invece, vorrei recuperare i documenti pertinenti e capire quale versione usare.

Il paper Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, di Patrick Lewis e colleghi, descrive un approccio che combina un modello generativo con il recupero di informazioni da una memoria esterna. È il riferimento originario della RAG, Retrieval-Augmented Generation.

In questa prospettiva, la RAG può contribuire a costruire il contesto, ma non esaurisce il problema: dopo aver trovato un documento, bisogna ancora decidere come utilizzarlo. Nel nostro esempio, recuperare il vecchio programma è utile per gli esercizi; copiarne le condizioni commerciali sarebbe un errore.

Per questo, nel mio archivio di lavoro, darei ai materiali una scheda essenziale: titolo, data, stato, progetto di appartenenza e funzione. Un nome come “Programma approvato, cliente X, ottobre 2026” offre un’indicazione molto più comprensibile di “File nuovo 7”.

Per gli agenti conta anche come funzionano gli strumenti

Quando l’assistente può cercare file o interrogare altri servizi, il contesto dipende anche dalle informazioni restituite da quegli strumenti. Nell’articolo Writing effective tools for AI agents, using AI agents, Anthropic raccomanda strumenti con scopi chiari e risposte pertinenti. Segnala inoltre che funzioni sovrapposte possono complicare le scelte dell’agente.

Applicato al nostro corso, vorrei una ricerca che restituisse il programma richiesto, la data e il suo stato. Se la risposta presenta soltanto un titolo, come distinguo una bozza da una versione approvata?

Prima di aggiungere un nuovo collegamento all’assistente, mi chiederei quindi: quale passaggio del lavoro rende possibile? Quali informazioni restituisce? Come verificheremo che siano quelle corrette?

Come mantenere il filo nei lavori lunghi

Per attività prolungate, Anthropic descrive tre strategie: compattare la conversazione, conservare note strutturate fuori dalla finestra di contesto e distribuire compiti mirati a sottoagenti. Sono approcci da scegliere in base al lavoro, non passaggi obbligatori per ogni richiesta.

Per il progetto del corso, io inizierei da una scheda di avanzamento: requisiti confermati, decisioni prese, dubbi aperti, documenti usati e prossimo passo. Se la durata cambia, aggiorno quella scheda e indico quale decisione è stata superata.

La farei controllare anche al responsabile del progetto. Una sintesi sbagliata, conservata con grande efficienza, rimane sbagliata.

Un prompt da provare subito

Ecco una richiesta da usare dopo aver allegato i materiali del nostro esempio:

Aiutami a progettare un corso di tre ore sull’AI per il team commerciale.

Prima di scrivere il programma, prepara una tabella con: documento, data indicata, informazioni utili, ruolo della fonte e possibili contraddizioni. Se data o stato non sono presenti, segnala “non indicato”.

Il brief confermato dal cliente stabilisce i requisiti. Usa il questionario per adattare il livello; i programmi precedenti sono esempi, senza valore per durata o condizioni del nuovo incarico. Gli appunti della call possono contenere proposte non approvate.

Non inventare informazioni mancanti. Fammi le domande necessarie a risolvere i dubbi che impediscono di costruire il programma.

Dopo il chiarimento, proponi una scaletta di 180 minuti, con obiettivo e attività per ogni modulo. Indica a quali materiali si collegano le scelte e distingui le tue proposte dai requisiti del cliente.

Questo prompt rende esplicite le regole del nostro incarico. Il suo valore va verificato sul risultato: riconosce le incongruenze? Rispetta il tempo disponibile? Inventa requisiti?

Un esercizio: stesso prompt, materiali organizzati diversamente

Per un laboratorio, proporrei di preparare due insiemi di documenti con le stesse informazioni. Nel primo lasciamo titoli vaghi e versioni indistinte. Nel secondo aggiungiamo date, stato e funzione delle fonti. Usiamo la stessa richiesta in conversazioni separate, con lo stesso modello e le stesse impostazioni disponibili.

Prima di partire, definiamo i criteri: requisiti rispettati, contraddizioni individuate, dati inventati e correzioni necessarie. Ripetiamo il confronto, perché una singola risposta riuscita non dimostra un vantaggio stabile. È un test pratico locale, non una prova scientifica generale.

Per accompagnare la riflessione sul prompting, qui trovi il mio intervento Tutti dobbiamo imparare a usare i prompt.

Prima di correggere il prompt, controlliamo il briefing

La competenza che mi interessa portare in azienda comprende anche questo: riconoscere le fonti, chiarire gli accordi e accorgersi di ciò che manca. Il context engineering offre un modo utile per ragionare su queste responsabilità quando lavoriamo con l’AI.

Alla prossima risposta insoddisfacente, suggerisco una verifica concreta: l’assistente aveva accesso al documento giusto? Sapeva che era quello approvato? Gli avevamo spiegato come trattare gli altri?

Magari il prompt va riscritto. Magari, prima, va sistemata la cartella “Definitivo_vero_ultimo”.

Vuoi sperimentare questo approccio con il tuo gruppo di lavoro? Scopri il mio corso di prompt engineering e contattami per costruire un laboratorio sui vostri casi reali.

    Qualche dettaglio sul corso (facoltativo)

    Qualche dettaglio sull’evento (facoltativo)

    Bastano poche righe. Se hai già una data o un obiettivo, aggiungili.

    I campi con * sono obbligatori.