Un poeta, un regista e un formatore di intelligenza artificiale entrano al Vittoriale. Potrebbe essere l’inizio di una battuta; questa volta è un progetto vero, e il formatore sono io. Parteciperò a Vittoriale LAB, L’officina del possibile, il percorso che invita dieci giovani a immaginare e scrivere insieme un Manifesto del Futuro.
La ragione per cui mi interessa è precisa: l’AI può diventare uno strumento per mettere alla prova le idee. Quando invece la usiamo soltanto per ottenere un testo ben confezionato, rischiamo di confondere la fluidità della risposta con la qualità del pensiero. Un laboratorio creativo è un buon posto per rendere visibile questa differenza.
Che cos’è Vittoriale LAB e a chi si rivolge
La presentazione ufficiale del Vittoriale degli Italiani descrive un concorso nazionale di idee, realizzato con il sostegno di Regione Lombardia. Possono candidarsi gratuitamente, a titolo individuale, giovani residenti o domiciliati in Italia che non abbiano ancora compiuto 25 anni alla scadenza. Non sono richiesti titoli di studio specifici o competenze tecniche pregresse.
Come racconta anche EconomyUp nell’articolo dedicato al concorso, l’idea è dare alla casa-museo di Gardone Riviera una funzione ulteriore: diventare un luogo nel quale patrimonio culturale, creatività e tecnologie aiutino le nuove generazioni a formulare proposte. Il percorso punta sulla formazione e sulla collaborazione, senza un premio in denaro o un unico vincitore finale.
Natura e Artificio: ripensare la sostenibilità attraverso cultura, arte, design e narrazione.
Piazze Digitali: immaginare comunità e spazi di dialogo nell’era dell’intelligenza artificiale.
Il Corpo Aumentato: esplorare identità e rappresentazione tra corpo fisico, avatar e realtà virtuale.
Per capirle, ecco tre esempi che propongo io, senza presentarli come progetti già selezionati: un’installazione che renda comprensibili gli sprechi di un quartiere; uno spazio digitale che faciliti il confronto tra generazioni; un laboratorio scolastico nel quale gli avatar aiutino a discutere la reputazione online. In ciascun caso la domanda iniziale dovrebbe riguardare le persone e il cambiamento desiderato, prima della tecnologia da usare.
Il mio contributo: un agente AI dedicato per ogni finalista
È una scelta che considero interessante soprattutto sul piano del metodo. Un ambiente di lavoro dedicato permette di partire dalla proposta del partecipante e di costruire un confronto coerente con il suo obiettivo. Il valore non dovrebbe misurarsi nel numero di pagine prodotte, ma nella capacità di chiarire un problema, confrontare possibilità e riconoscere ciò che ancora manca.
Come imposterei questo lavoro? Partirei da domande molto concrete:
Quale problema vuoi affrontare e per chi?
Che cosa stai dando per scontato?
Quali informazioni hai verificato e quali sono ancora ipotesi?
Come puoi provare la tua idea con un piccolo esperimento?
Come capiresti se il progetto ha prodotto un cambiamento utile?
Queste sono indicazioni metodologiche, non una descrizione tecnica definitiva degli agenti che saranno utilizzati. Un esempio di richiesta potrebbe essere: «Aiutami a trovare tre debolezze nella mia proposta. Per ciascuna, formula una domanda e suggerisci una prova concreta. Se mancano informazioni, segnalalo». L’AI diventerebbe così un interlocutore da interrogare, anche quando la sua risposta ci mette in difficoltà.
È lo stesso approccio che porto nei miei corsi su intelligenza artificiale, agenti e comunicazione digitale: dare agli strumenti un compito preciso e conservare la responsabilità delle scelte. Se un sistema propone un’affermazione, bisogna poterla verificare. Se suggerisce una soluzione, bisogna capire chi ne beneficerebbe e quali problemi potrebbe creare.
Screenshot del post ufficiale Facebook del Vittoriale degli Italiani, acquisito dalla sua versione incorporabile. Il testo completo è disponibile nel post collegato.
Poesia, AI e teatro: tre contributi allo stesso laboratorio
Il post del Vittoriale presenta anche gli altri due facilitatori. Lorenzo Maragoni terrà un workshop di scrittura; Bruno Fornasari, del Teatro Filodrammatici di Milano, guiderà il passaggio dal testo alla messa in scena e firmerà la regia della presentazione pubblica.
Leggo questa combinazione come un invito a lavorare su tre passaggi: trovare una voce, sviluppare il pensiero e renderlo condivisibile. Un’idea può essere promettente ma poco comprensibile. Un testo può essere impeccabile ma non dire nulla. E una presentazione può essere spettacolare senza reggere una domanda. Il laboratorio offre l’occasione di tenere insieme questi aspetti.
Come candidarsi e quando si svolge il laboratorio
Secondo il programma ufficiale, le candidature scadono il 30 ottobre 2026. Servono un video pitch di massimo tre minuti e una proposta in PDF di massimo tre pagine, con problema, soluzione e impatto potenziale.
La selezione comprende una prima valutazione e un videocolloquio. I dieci finalisti lavoreranno al Vittoriale il 30 e 31 gennaio 2027; la presentazione pubblica del Manifesto del Futuro è prevista il 31 gennaio. Per candidarsi e controllare regolamento, requisiti e allegati, il riferimento resta la pagina ufficiale del concorso, con il modulo di iscrizione.
Perché sperimentare l’AI proprio in un luogo di cultura
Il rapporto del Vittoriale con le tecnologie ha già altri esempi. Fondazione TIM racconta il progetto “Vittoriale da vivere”, che arricchisce la visita con tecnologie immersive e realtà virtuale, anche per esplorare ambienti normalmente chiusi al pubblico. È un’iniziativa distinta da Vittoriale LAB, ma aiuta a capire il contesto.
La mia tesi è che la formazione sull’AI abbia bisogno anche di luoghi nei quali si possa discutere che cosa valga la pena creare. Imparare a usare uno strumento serve; imparare a scegliere un problema merita altrettanta attenzione. Al Vittoriale il risultato che mi interessa è vedere giovani capaci di spiegare le proprie idee, difenderle con argomenti e modificarle dopo un confronto. Un manifesto avrebbe poco valore se fosse soltanto il testo più elegante prodotto da un chatbot.
Vuoi portare un laboratorio su AI e creatività nella tua organizzazione?
Se rappresenti un’azienda, una scuola, un ente o un’istituzione culturale e vuoi progettare un laboratorio su agenti AI, creatività e comunicazione, raccontami il tuo obiettivo nel modulo qui sotto. Per le candidature a Vittoriale LAB, invece, usa il modulo ufficiale del concorso.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/vittoriale-lab-gianluigi-bonanomi.webp900720Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-14 17:15:222026-10-28 15:28:01Vittoriale LAB: dieci giovani e gli agenti AI per il Manifesto del Futuro
C’è un paradosso nel mercato dei computer: l’intelligenza artificiale potrebbe offrire al PC una seconda vita domestica proprio mentre contribuisce a renderlo più caro. Da una parte i data center si contendono memorie e capacità produttiva. Dall’altra, modelli eseguibili sul nostro hardware permettono di immaginare un computer che consulta gli archivi di famiglia, prepara documenti e fa partire automazioni.
La mia tesi è questa: il prossimo motivo convincente per avere un PC in casa sarà un assistente personale che lavora sui nostri dati e svolge attività ricorrenti, con una parte dell’intelligenza sotto il nostro controllo. Un computer acceso può diventare un piccolo laboratorio e un centro di automazione: n8n organizza i passaggi, Ollama esegue i modelli, LM Studio permette di provarli e confrontarli. È un’ipotesi sul futuro degli usi domestici, non una previsione già dimostrata sulle vendite.
Dati e documentazione verificati il 14 ottobre 2026. Le automazioni descritte sono esempi progettuali, non risultati di test effettuati per questo articolo.
Vendite PC in calo: che cosa dicono davvero i dati del 2026
Il comunicato Gartner del 12 ottobre 2026 stima 55,35 milioni di PC consegnati nel terzo trimestre, il 22,4% in meno rispetto al terzo trimestre 2025. Sono stime preliminari sulle consegne ai canali distributivi e comprendono desktop e portatili con Windows, macOS e Chrome OS.
Il rapporto Omdia del 9 ottobre 2026 indica 58,1 milioni di unità e un calo del 21,2%, includendo desktop, notebook e workstation. Per Omdia, i desktop scendono del 23,5% e i notebook del 20,6%.
Rilevazione
Periodo
Consegne globali
Variazione annua
Perimetro dichiarato
Gartner
Terzo trimestre 2026
55,35 milioni
-22,4%
Desktop e laptop, Windows/macOS/Chrome OS
Omdia
Terzo trimestre 2026
58,1 milioni
-21,2%
Desktop, notebook e workstation
Le due serie hanno perimetri e metodi propri: non le fondo in una media. Il segnale comune è un forte arretramento delle consegne globali. Questi numeri, però, non misurano da soli gli acquisti delle famiglie italiane. Dire che il mercato PC si contrae è sostenuto dai dati; dire che un italiano su cinque ha smesso di comprare computer sarebbe un salto logico.
Gartner collega il calo ai rincari e alla minore disponibilità di configurazioni economiche. Omdia segnala anche l’effetto degli acquisti anticipati nella prima parte dell’anno: chi si è portato avanti per evitare aumenti non ricompra pochi mesi dopo. Il PC sul tavolo continua a funzionare; quello in negozio costa di più. Una combinazione poco invitante.
Il paradosso: l’AI che promette di rilanciare i PC ne aumenta i costi
Nell’analisi di International Data Corporation sulla crisi delle memorie, lo spostamento della produzione verso memorie destinate ai data center AI restringe la disponibilità per l’elettronica di consumo. Il problema si intreccia con la domanda di computer capaci di eseguire modelli in locale, che hanno a loro volta bisogno di memoria.
Una previsione IDC pubblicata il 2 giugno 2026 stimava per l’intero anno un calo delle consegne dell’11,3% e un aumento del prezzo medio del 17%. Sono previsioni datate, non consuntivi né l’ultima rilevazione trimestrale. Omdia, nel comunicato di ottobre, prevede un ulteriore calo del 7% per il 2027: anche questo è uno scenario di mercato, non un fatto già avvenuto.
Qui nasce il conflitto: i produttori vorrebbero venderci computer più potenti per l’AI, ma il consumatore deve avere un motivo concreto per pagarli. Scrivere «AI PC» sulla scatola non risolve il problema. Serve un’attività utile, ripetuta abbastanza spesso da giustificare l’acquisto.
AI locale: che cosa cambia per il computer di casa
Far girare un modello in locale significa eseguire il calcolo sul proprio computer. Dopo aver scaricato programma, modello e componenti necessari, alcune attività possono funzionare senza connessione. La documentazione sul funzionamento offline di LM Studio indica che chat, elaborazione dei documenti e server locale possono operare senza Internet e che, in quelle funzioni locali, documenti e conversazioni rimangono sul dispositivo.
È una possibilità interessante per un archivio di bollette, contratti, manuali e appunti. Alla domanda «Dove trovo le condizioni della mia assicurazione?» il valore sta nel recuperare il passaggio giusto dal documento. Il computer può diventare la porta d’accesso al proprio patrimonio informativo, un tema che ho approfondito anche nell’articolo su agenti AI e second brain.
Ma leggere e riassumere è soltanto una parte della storia. Il passaggio più interessante è collegare quell’intelligenza a un processo: ricevere un file, estrarre informazioni, verificarle, salvare un risultato e presentarlo alla persona. È qui che il PC comincia a lavorare anche quando non stiamo scrivendo nella chat, purché resti acceso e i servizi siano attivi.
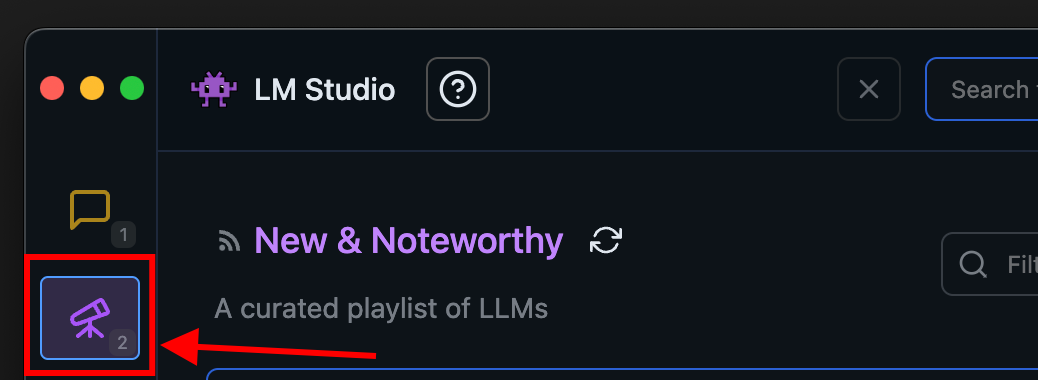
LM Studio: un laboratorio per provare modelli gratuiti in locale
La ricerca dei modelli in LM Studio. Schermata dalla documentazione ufficiale; l’interfaccia può variare tra versioni.
Open source, open weights e gratuito non sono sinonimi. Un modello con pesi scaricabili può avere condizioni d’uso specifiche. LM Studio è un’applicazione distinta dai modelli che esegue: scaricare un modello non rende automaticamente open source ogni componente del sistema. Per un utilizzo professionale bisogna controllare anche gli usi consentiti dalla licenza.
Una prova utile consiste nel dare a tre modelli lo stesso testo e la stessa richiesta. Per esempio:
Analizza esclusivamente il documento allegato. Estrai oggetto, date, importi e attività richieste in una tabella. Per ciascun dato indica il passaggio del testo che lo sostiene. Se un’informazione manca, scrivi «non presente». Non completare i vuoti con supposizioni.
Per rendere il confronto sensato, userei una decina di documenti con risposte già controllate. Annoterei errori, omissioni, tempi di risposta e facilità di utilizzo, mantenendo comparabili le impostazioni. Sono criteri di prova proposti, non un benchmark svolto qui. Un modello brillante nella scrittura potrebbe essere mediocre nell’estrazione di scadenze.
La funzione Chat with Documents accetta file DOCX, PDF e TXT. Il recupero di passaggi pertinenti, spesso chiamato RAG, aiuta a dare al modello un contesto documentale: le risposte vanno comunque confrontate con gli originali.
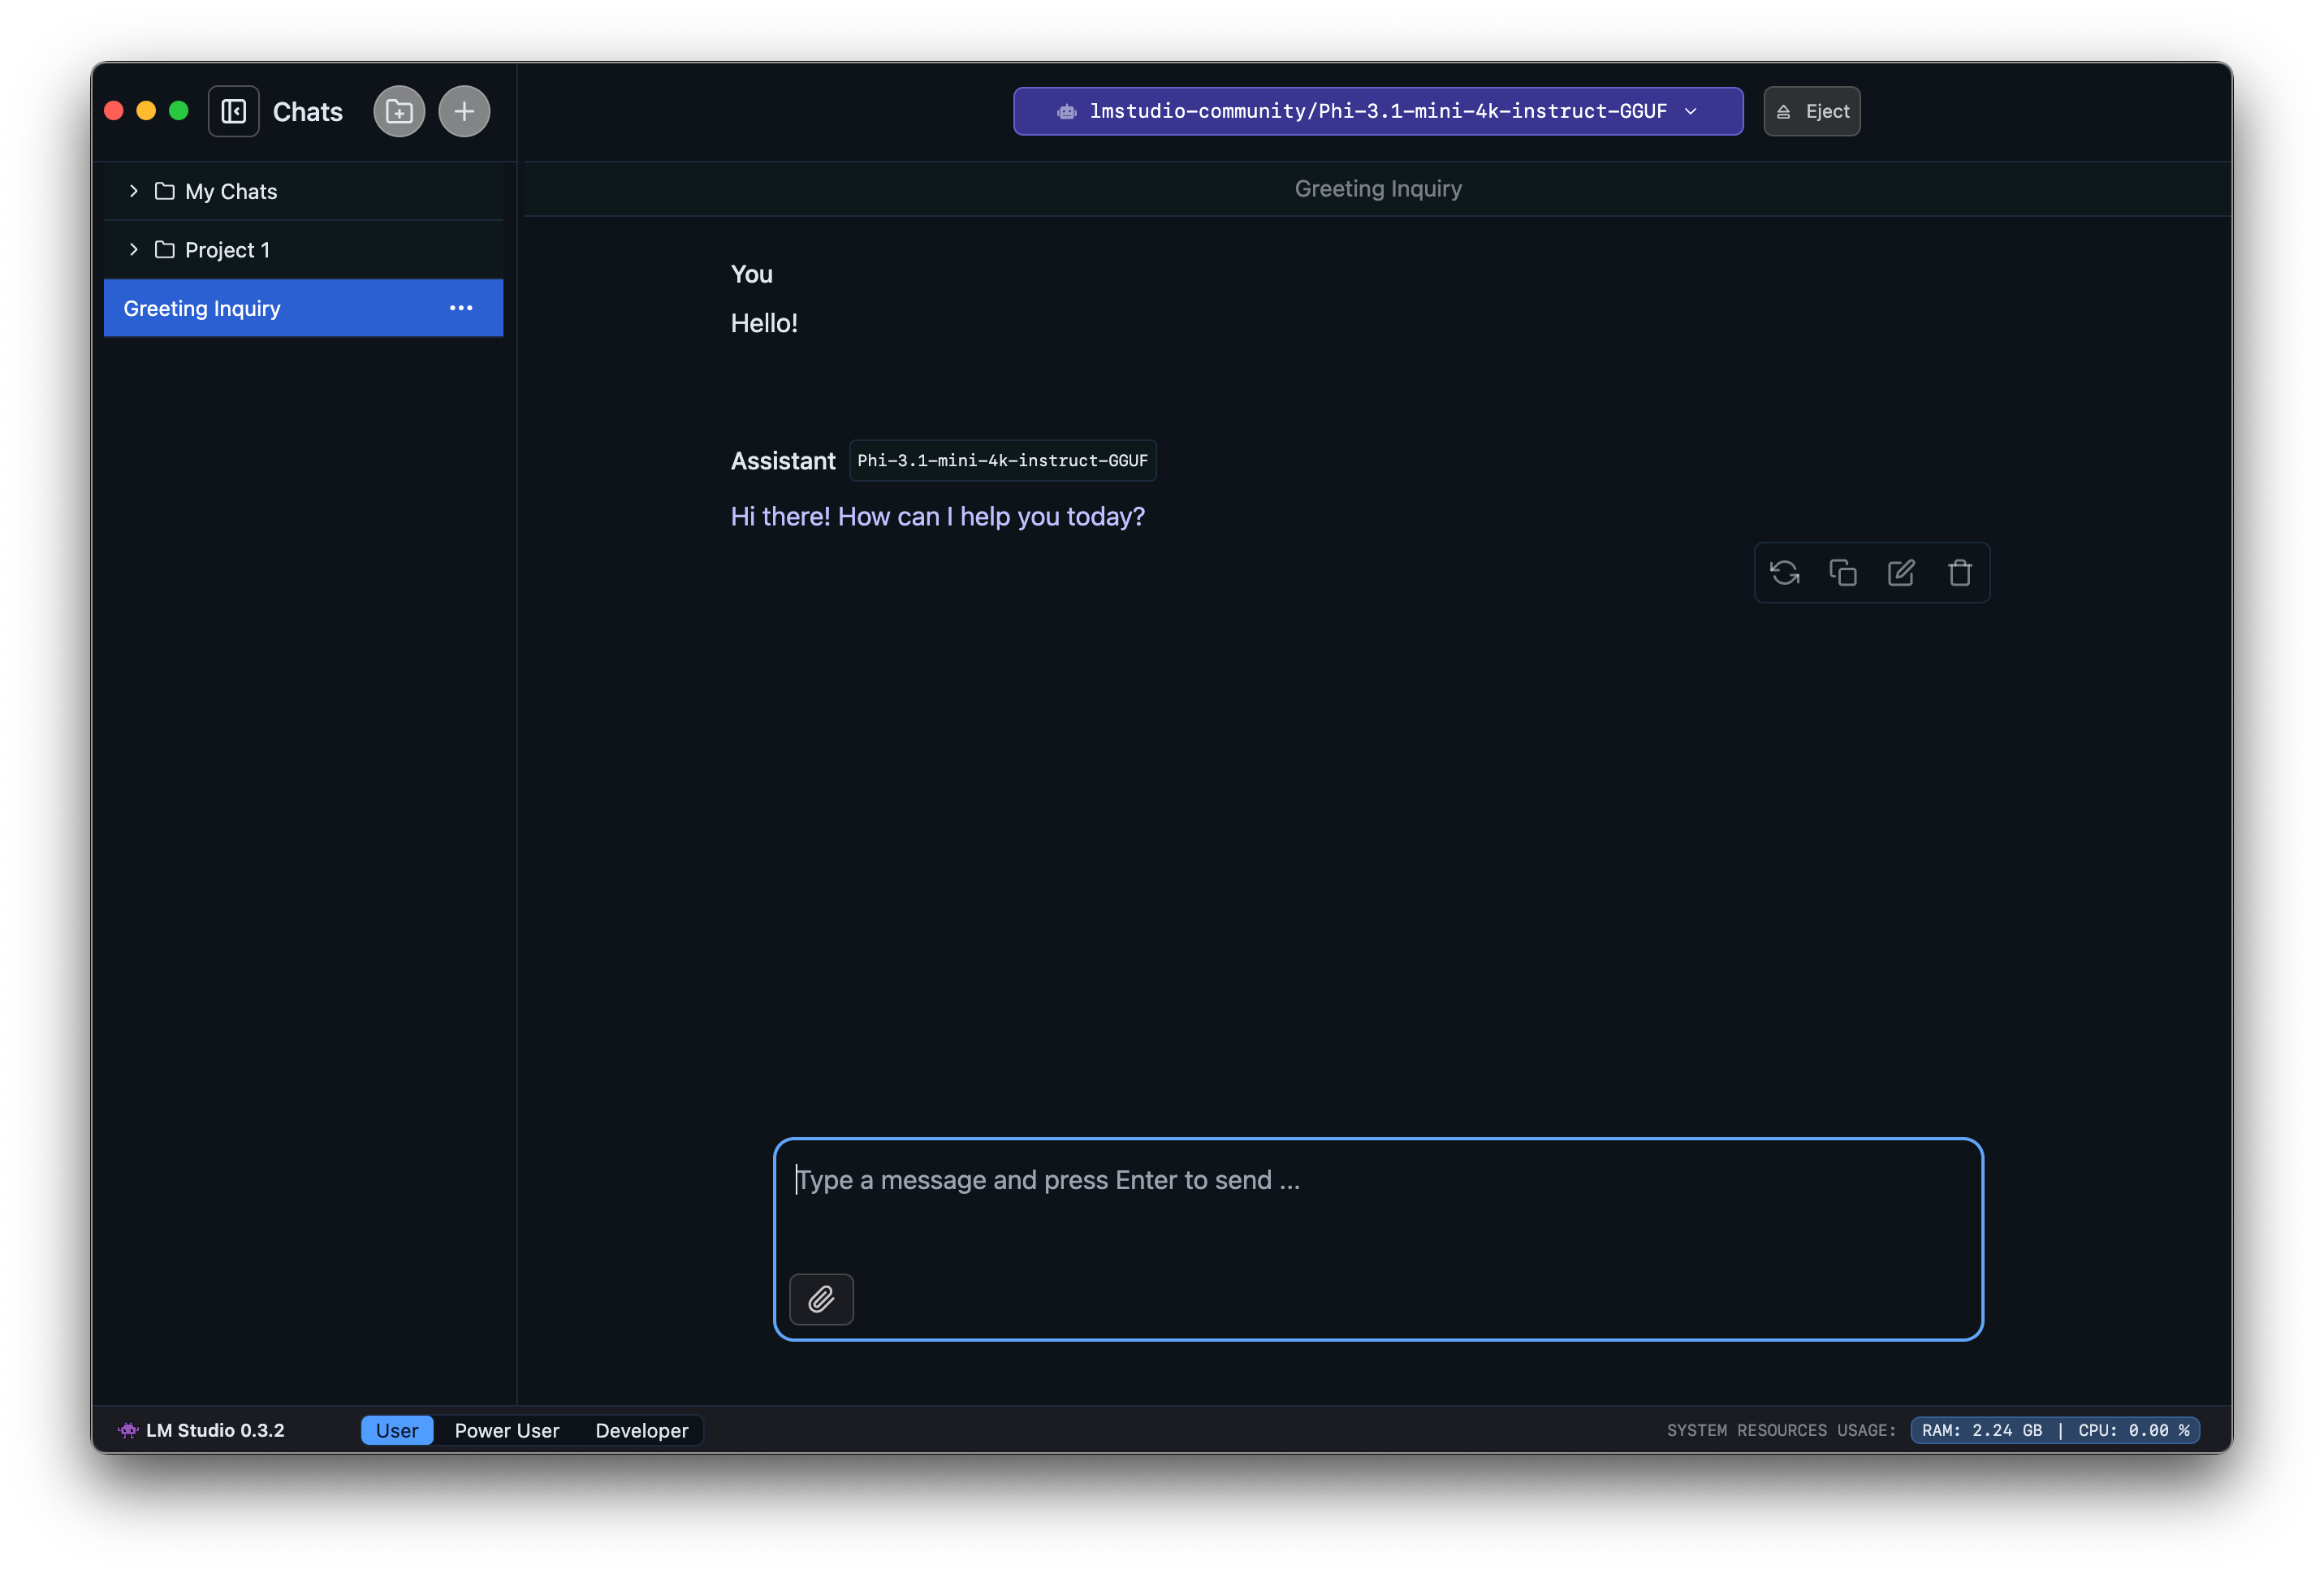
La chat con un modello locale in LM Studio. Schermata dalla guida ufficiale.
Ollama: il motore locale da collegare alle automazioni
Ollama permette di scaricare ed eseguire modelli sul computer e di utilizzarli attraverso interfacce e API. In un progetto domestico può fornire il motore linguistico a un altro programma: invece di copiare un testo nella chat, un flusso automatico lo invia al servizio locale e recupera il risultato.
LM Studio e Ollama hanno funzioni in parte sovrapposte. Per orientarsi, userei LM Studio come laboratorio grafico di confronto e Ollama come componente da integrare nei flussi. Anche LM Studio offre API per applicazioni e script: non esiste una divisione obbligatoria tra i due.
Bisogna scegliere davvero l’esecuzione locale. Ollama offre anche modelli cloud: la sua informativa sulla privacy distingue il trattamento dei dati nelle due modalità. Un programma installato sul PC può chiamare un servizio remoto. Per sapere dove avviene l’elaborazione occorre controllare modello, endpoint e integrazioni attive.
n8n sul PC: automazioni senza abbonamento al servizio cloud
n8n si può installare sulla propria infrastruttura, per esempio con Docker. Senza chiave di licenza funziona nella Community Edition gratuita. La versione ospitata dal fornitore e le edizioni commerciali hanno condizioni diverse: gratuito in questo caso significa usare la propria installazione nelle condizioni previste.
n8n rappresenta i processi attraverso nodi: un evento iniziale, un’operazione sui dati, una chiamata a un modello e un risultato. Una catena può partire a un orario prestabilito, leggere documenti e generare un riepilogo. Molte automazioni, come copiare file o verificare un nome, non richiedono affatto un LLM: usare regole semplici dove bastano rende il processo più prevedibile.
La Sustainable Use License di n8n consente, nei suoi limiti, l’uso personale e per attività interne. È una licenza con restrizioni, diversa dalle licenze open source senza quei vincoli. Questo non impedisce il progetto domestico descritto, ma rende impreciso presentare n8n come «open source utilizzabile senza condizioni».
Per collegare i passaggi AI esiste il nodo Ollama Chat Model. n8n coordina il flusso e Ollama esegue il modello locale. Il risultato può tornare in un file sul PC. Se invece il flusso usa Gmail, Google Drive o un’API esterna, quei passaggi coinvolgono servizi online: avere il modello in locale non rende offline l’intera automazione.
Un punto di partenza: il Self-hosted AI Starter Kit
Il kit ufficiale di n8n riunisce n8n, Ollama, il database vettoriale Qdrant e PostgreSQL in un ambiente basato su Docker Compose. È un punto di partenza per prototipi e prove, non un sistema domestico già pronto e configurato per ogni esigenza. La documentazione richiede di adattarlo e proteggerlo prima di un uso continuativo.
Nel video ufficiale si vede l’ambiente in azione. È una dimostrazione del kit, non la prova che qualunque computer riesca a eseguire qualunque modello con le stesse prestazioni.
Cinque automazioni che darebbero un motivo per tenere acceso il PC
I seguenti sono progetti realizzabili con una configurazione adatta, non funzioni già disponibili appena si installano i programmi. Alcuni richiedono script, nodi aggiuntivi o un sistema OCR per le scansioni.
Progetto
Flusso proposto
Risultato utile
Controllo umano
Archivio di bollette e contratti
Scansione periodica di una cartella; estrazione del testo; modello locale; verifica dei campi
Indice con fornitore, importo, date e nome del file
Verificare cifre e scadenze prima di usarle
Appunti dopo una lezione
Nuovo file di appunti; modello locale; salvataggio di riepilogo e domande
Materiale per ripassare conservato sul PC
Confrontare il riepilogo con gli appunti
Documenti da riordinare
Elenco dei file; classificazione proposta; anteprima degli spostamenti
Piano per ordinare l’archivio
Approvare il piano prima di muovere i file
Bozze per un professionista
Nuovo documento di richiesta; estrazione delle esigenze; creazione di una bozza
Prima bozza di risposta o proposta
Rivedere contenuto e destinatario prima dell’invio
Rassegna da feed RSS
Raccolta online; selezione; sintesi con modello locale; salvataggio
Rassegna con link agli originali
Controllare sintesi e attendibilità delle notizie
Prendiamo la prima: ogni sera il PC esamina una cartella, identifica i nuovi PDF, estrae il testo e chiede al modello di restituire dati in un formato prestabilito. Un controllo successivo intercetta importi assenti o date non valide; gli elementi dubbi finiscono in una lista da rivedere. Il flusso prepara un indice, non paga bollette né decide al posto della famiglia.
La rassegna mostra bene l’approccio ibrido: le notizie arrivano da Internet, ma la sintesi può avvenire sul proprio hardware. Il collegamento tra servizi e modello è più interessante del singolo chatbot, perché toglie una sequenza di operazioni ripetitive.
Un’altra possibilità è la casa connessa. Home Assistant documenta l’integrazione con Ollama per un agente conversazionale locale. Il controllo dei dispositivi è indicato come sperimentale e richiede modelli con supporto agli strumenti. È un esempio concreto di integrazione disponibile, da distinguere dall’idea di un maggiordomo digitale già affidabile su ogni comando.
Quanto è gratuito? Costi, hardware e limiti dell’AI locale
Con un modello scaricato ed eseguito interamente sul proprio hardware, l’inferenza non comporta una tariffa per chiamata a un fornitore cloud. Anche la Community Edition di n8n può evitare l’abbonamento alla piattaforma ospitata. Il costo complessivo resta però diverso da zero: computer, energia, spazio disco, eventuali backup e tempo per aggiornamenti e manutenzione. Le API esterne possono inoltre avere proprie tariffe.
Per valutare un sistema sempre acceso, farei questo conto: consumo medio in watt diviso 1.000, moltiplicato per ore di funzionamento e prezzo effettivo del kWh. Poi aggiungerei l’eventuale acquisto hardware. Il risparmio rispetto al cloud dipende da utilizzo e prestazioni richieste: non prometterei un ammortamento senza misurarli.
Come riferimento iniziale, i requisiti ufficiali di LM Studio raccomandano almeno 16 GB di RAM; per Windows indicano anche almeno 4 GB di memoria video dedicata come raccomandazione. La memoria necessaria varia con modello, quantizzazione e lunghezza dei testi. Questi numeri non garantiscono che un modello specifico giri velocemente.
Un computer già posseduto potrebbe bastare per prove con modelli piccoli. Un NAS o un mini PC può invece ospitare l’automazione e delegare il modello a un’altra macchina nella rete domestica, se configurati correttamente. Essere sempre acceso non significa essere abbastanza potente per l’inferenza: sono due requisiti diversi.
L’esecuzione locale offre controllo, ma non elimina gli errori del modello né protegge automaticamente file e credenziali. Per iniziare sceglierei flussi in lettura, copie di prova e bozze da approvare. Le azioni che modificano archivi o inviano messaggi meritano un passaggio umano esplicito.
Il ritorno nelle case si misurerà con l’utilità, non con l’etichetta AI
Vedo tre possibilità: il cloud rimane prevalente e il PC serve soprattutto come interfaccia; cresce un uso ibrido con elaborazioni locali e servizi online; oppure una parte di famiglie e professionisti adotta una macchina dedicata alle automazioni. La seconda mi sembra l’ipotesi più convincente, ma è un giudizio argomentato, non un dato di mercato.
Per parlare di rilancio delle vendite serviranno segnali ulteriori: utilizzo frequente delle funzioni locali, acquisti motivati da quelle funzioni e crescita effettiva della domanda domestica. Una quota crescente di computer venduti con componenti AI può semplicemente indicare la sostituzione dell’offerta esistente.
Inoltre, le funzioni potrebbero essere soddisfatte da smartphone, NAS o macchine già in casa. Anche questo rende meno automatico il legame tra AI locale e nuovi acquisti. Il PC ha una possibilità se rende semplici attività oggi frammentate e faticose, a un costo sostenibile.
Il futuro interessante del computer domestico è diventare un assistente operativo di cui possiamo scegliere modelli, dati e compiti. Un archivio consultabile, un laboratorio dove provare modelli e una macchina che esegue automazioni utili. Quando questa combinazione sarà facile da usare anche per chi non vuole passare il sabato a configurare Docker, avremo una ragione concreta per rimettere il PC al centro della casa.
Vuoi portare questi strumenti nel tuo lavoro?
Nei miei corsi e nelle consulenze sull’intelligenza artificiale possiamo partire da un’attività reale, scegliere gli strumenti e progettare una prima automazione con controlli chiari. Se vuoi valutare un workshop su modelli locali, agenti e automazioni per la tua organizzazione, scrivimi tramite il modulo.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/Il-PC-e-morto-AI-locale-e-futuro-del-computer-domestico-scaled.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-14 14:06:282026-10-28 15:28:01Vendite PC in calo: AI locale e automazioni possono riportarli nelle case?
Di Gianluigi Bonanomi. Guida verificata il 14 ottobre 2026. Gli esempi numerici e i giocatori indicati con nomi di fantasia sono simulazioni didattiche, non consigli sulla giornata in corso.
AI per il Fantacalcio: usare dati, regole e domande migliori per scegliere con più criterio.
Il Fantacalcio ha una caratteristica meravigliosa: persone che per acquistare una lavatrice confrontano tre recensioni possono discutere per un’ora sull’opportunità di spendere metà del budget per un attaccante. Poi, quando quell’attaccante prende cinque, la responsabilità è del mister. O del calendario. O di un complotto.
Adesso nella stanza dell’asta può entrare un altro personaggio: l’intelligenza artificiale. Le puoi chiedere di leggere un listone, confrontare due acquisti, controllare i crediti rimasti o spiegarti perché stai costruendo una squadra con sei scommesse e nessuna certezza. Se però la interroghi come un oracolo, rischi di ottenere una risposta molto convincente su una realtà che non esiste più.
In questa guida propongo un uso concreto dell’intelligenza artificiale per il Fantacalcio: preparazione dell’asta, assistenza durante i rilanci, formazione, scambi, analisi della stagione e gestione della lega. Con prompt pronti da adattare, conti leggibili e limiti dichiarati. L’obiettivo è migliorare le decisioni, senza vendere il sogno del chatbot che sa già chi farà doppietta domenica.
Conviene distinguere tre lavori. Il primo è organizzare le informazioni: riassumere il regolamento, pulire una tabella, trovare incongruenze. Il secondo è valutare alternative: confrontare moduli, budget e scambi usando dati disponibili. Il terzo è fare previsioni: stimare un rendimento o una probabilità con un modello statistico.
Un chatbot che scrive bene non diventa automaticamente un modello predittivo sportivo. Per una decisione ripetibile servono dati aggiornati, criteri espliciti e calcoli controllabili. È utile combinare un assistente conversazionale con statistiche e strumenti specializzati; va verificato, caso per caso, che cosa l’assistente possa effettivamente leggere.
Un esempio importante sono gli expected goals, o xG. Nella spiegazione di Hudl, il valore esprime la probabilità stimata che un tiro diventi gol in base alle caratteristiche considerate dal modello. Un tiro da 0,2 xG non è un quinto di gol già guadagnato: è una stima su situazioni comparabili. Userei gli xG come un elemento del ragionamento, insieme a minuti e contesto, senza trasformare una singola partita in una profezia.
ChatGPT per il Fantacalcio e app dedicate: quale scegliere?
Non esiste un vincitore universale. Se vuoi lavorare sul tuo regolamento e sui tuoi file, un assistente generalista può essere comodo. Se vuoi previsioni già organizzate per il gioco, ha senso esaminare prodotti dedicati. Quella che segue è una ricognizione delle funzioni descritte dai rispettivi fornitori, verificata il 14 ottobre 2026: non una classifica basata su un campionato di test comparativi.
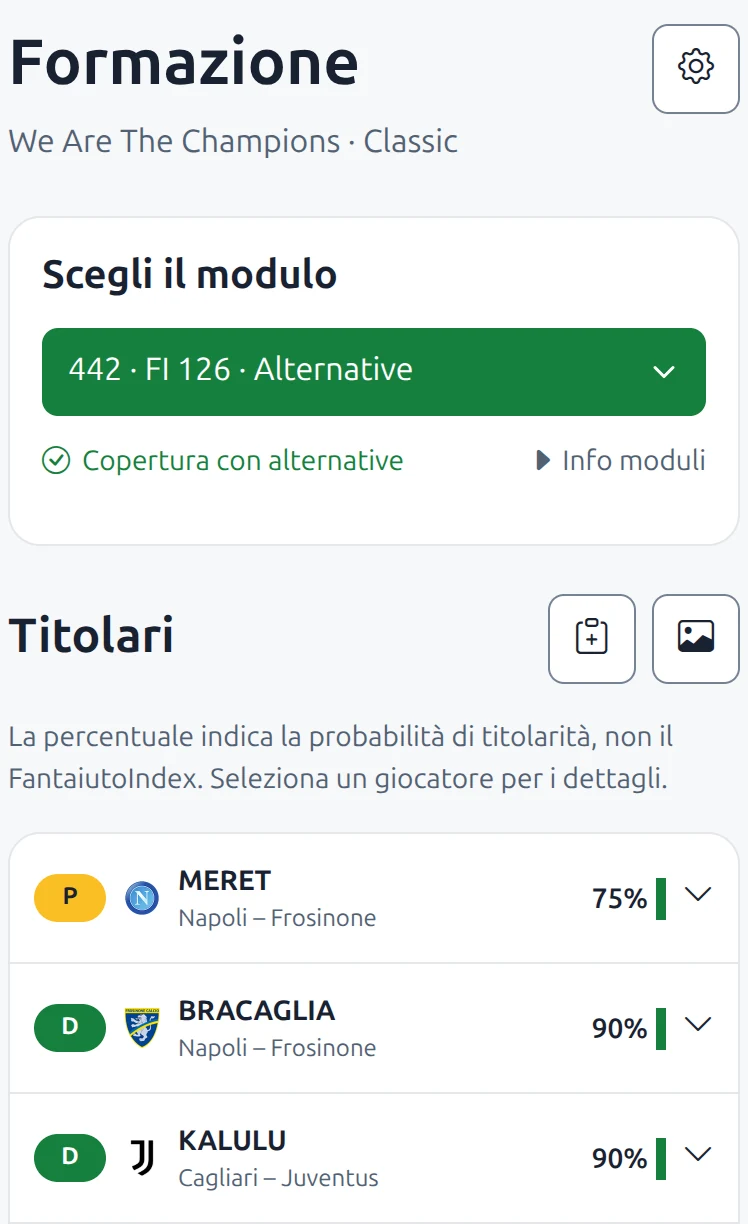
Schermata dimostrativa pubblicata da Fantaiuto. Illustra l’interfaccia del servizio; i valori mostrati non sono raccomandazioni di questa guida per il prossimo turno.
La schermata aiuta a capire un equivoco: un numero accanto a un giocatore va interpretato. È una media storica? Un indice costruito dall’app? Una probabilità? Sono grandezze diverse. Prima di confrontarle, devi sapere che cosa misurano.
Schermata di esempio pubblicata da Predixsport. La pagina distingue fantavoto atteso e probabilità di partire titolare. L’immagine documenta una funzione dichiarata, non dimostra l’accuratezza futura del modello.
Prima del prompt: prepara regolamento, rosa e fonti
Il primo documento da dare all’assistente è il regolamento della tua lega. Fantacalcio.it chiarisce che le regole delle leghe private sono personalizzabili. Dimensione della rosa, bonus, sostituzioni e modificatori cambiano il problema. Una risposta sensata in una lega può essere sbagliata nella tua.
Prepara una cartella o una conversazione di lavoro con quattro elementi: regolamento effettivo, rosa aggiornata, elenco degli svincolati e tabella delle statistiche. Aggiungi il calendario quando serve. Per ruoli e valori consulta il listone di quotazioni e FVM di Fantacalcio.it; per la disponibilità prepartita controlla le probabili formazioni e gli aggiornamenti ufficiali delle squadre. Riporta sempre fonte, stagione e momento del controllo.
Per lavorare su una tabella, preferisco un file esportato legittimamente o dati incollati in colonne. La guida ufficiale di OpenAI alla preparazione dei dati mostra il flusso di caricamento e controllo di un file. Verifica le funzioni effettivamente presenti nel tuo account; se una funzione manca, puoi comunque fornire una piccola tabella nel messaggio.
Campo
Perché serve
Errore da prevenire
ID, nome, squadra, ruolo
Identificare il calciatore e i vincoli.
Omonimi, trasferimenti e ruoli di stagioni diverse.
Stagione e data di aggiornamento
Capire a quale fotografia si riferisce il dato.
Scambiare un file vecchio per un aggiornamento live.
Minuti, presenze, partite a voto
Distinguere rendimento e disponibilità.
Confrontare campioni molto diversi senza segnalarlo.
Media voto e FantaMedia
Separare voto base e punteggio con bonus/malus.
Usare colonne simili come se fossero equivalenti.
xG, eventuali xA e loro provider
Aggiungere metriche di qualità delle occasioni.
Unire definizioni o modelli non omogenei.
Prezzo, crediti residui, slot liberi
Valutare acquisti realizzabili.
Proporre un affare che rende impossibile completare la rosa.
Stato prepartita e fonte
Gestire dubbi e aggiornamenti.
Trasformare un’ipotesi di titolarità in una formazione ufficiale.
Chiedi prima un controllo di qualità: righe duplicate, dati mancanti, nomi incoerenti, separatori decimali e denominatori diversi. Uno zero vuol dire zero; una cella vuota può voler dire che il dato non è stato rilevato. Se l’AI riempie i vuoti con l’immaginazione, la tua squadra diventa un romanzo.
Prompt Fantacalcio per ChatGPT: il metodo G.O.L. applicato alla lega
Per impostare il lavoro uso il mio metodo G.O.L. per i prompt di ChatGPT: Guidare, Obiettivo, Limiti. Guida l’assistente indicando il compito; definisci il risultato; metti vincoli e controlli. Questo è un modello da copiare, sostituendo i campi tra parentesi.
GUIDARE
Agisci come assistente di analisi per la mia lega di Fantacalcio.
Prima estrai dai documenti le regole effettive e chiedimi conferma
solo sui punti ambigui che cambiano la decisione.

OBIETTIVO
Aiutami a [preparare l’asta / schierare / valutare uno scambio].
Stagione: [stagione]. Sistema: [Classic o Mantra].
Partecipanti: [numero]. Budget: [crediti].
Rosa e regole: [allegati o tabella].
Data e ora del controllo: [data, ora, fuso orario].

LIMITI
Usa solo i giocatori e i dati forniti o verificati con una fonte.
Non inventare ruoli, prezzi, infortuni, probabilità o notizie.
Se non puoi consultare il web, dichiaralo e usa solo gli allegati.
Separa dati osservati, stime del fornitore e ipotesi dell’analisi.
Per ogni dato variabile riporta fonte e data di aggiornamento.
Controlla vincoli e budget con calcoli espliciti e riproducibili.
Restituisci: proposta, alternativa, motivi, dati mancanti,
rischi e condizioni che farebbero cambiare la scelta.
La richiesta di fonti non garantisce che le fonti siano corrette. Apri i collegamenti e verifica che sostengano quello che l’assistente ha scritto. Anche un prompt ben progettato richiede controllo.
AI per l’asta del Fantacalcio: 10 applicazioni pratiche
1. Trasformare il regolamento in una scheda operativa
Invece di iniziare dai nomi, fai estrarre le condizioni che incidono sulle scelte. Il risultato utile è una scheda verificabile, con il riferimento al punto del documento da cui arriva ogni regola.
Leggi il regolamento allegato. Estrai sistema di gioco, composizione
rosa, budget, bonus/malus, moduli, modificatori, sostituzioni e scadenze.
Indica se una voce è esplicita, ambigua o assente. Cita il paragrafo.
Non completare le lacune usando le regole di altre leghe.
2. Pulire il listone senza perdere calciatori
Una pulizia fatta male può cancellare un omonimo o un giocatore che ha cambiato squadra. Chiedi una copia normalizzata e un registro delle modifiche, mantenendo gli identificativi originali.
Controlla il listone: duplicati, omonimi, ruoli mancanti, numeri
salvati come testo e squadre incoerenti. Non eliminare righe in automatico.
Proponi le correzioni e confronta il numero di righe prima e dopo.
3. Costruire fasce di acquisto motivate
Una graduatoria dal primo all’ultimo nome può dare una precisione ingannevole. Le fasce aiutano a individuare alternative, soprattutto quando una stima è incerta. Definisci prima i criteri: rendimento, disponibilità e costo sono dimensioni diverse.
Usando solo questi dati, costruisci fasce per ruolo. Distingui
rendimento osservato, continuità di impiego e costo. Spiega le soglie
scelte e segnala quando i dati non consentono di separare due giocatori.
4. Preparare tre piani di budget
Esempio inventato: con 500 crediti puoi confrontare tre ripartizioni. Sono scenari da discutere, non percentuali universalmente vincenti. La somma deve rimanere 500, compresa la riserva.
Scenario didattico
Portieri
Difesa
Centrocampo
Attacco
Riserva
Equilibrato
30
65
145
240
20
Difesa valorizzata
35
100
135
210
20
Attacco prioritario
25
50
120
285
20
Con 500 crediti costruisci tre piani alternativi per la mia lega.
Per ciascuno verifica la somma, il costo minimo degli slot e le rinunce.
Non proporre prezzi individuali senza una base dati o un’ipotesi dichiarata.
5. Stimare il valore rispetto a un sostituto
Chiediti quanto guadagni rispetto all’alternativa che riusciresti davvero a comprare. In una simulazione, un giocatore stimato a 7,0 e un sostituto a 6,3 hanno un vantaggio di 0,7 punti a presenza confrontabile. Su 20 presenze ipotizzate sono 14 punti. Il conto dipende dalle ipotesi: non è una previsione certificata né un prezzo d’asta automatico.
Confronta ogni obiettivo con un sostituto acquistabile dello stesso
ruolo. Usa lo stesso orizzonte e le stesse ipotesi sulle presenze.
Calcola il vantaggio atteso e mostra come cambia se gioca meno.
6. Simulare un’asta con avversari diversi
Puoi allenarti a reagire a rincari e occasioni mancate. Le strategie degli avversari vanno presentate come scenari ipotetici: l’AI non legge nella testa dei tuoi amici, anche se sul gruppo WhatsApp qualcuno sembra convinto del contrario.
Simula un’asta con 8 partecipanti e 500 crediti. Usa solo il listone
allegato. Crea avversari con strategie dichiarate e inventate.
Dopo ogni acquisto aggiorna budget e slot. Se perdo il mio primo
obiettivo, mostrami due alternative coerenti con il piano.
7. Calcolare il rilancio massimo sostenibile
Qui serve aritmetica. Se restano 137 crediti e devi comprare ancora 8 calciatori compreso quello in asta, con prezzo minimo di 1 credito devi conservarne almeno 7 per gli altri. Il tetto teorico è quindi 137 − 7 = 130. Se vuoi anche 15 crediti di margine aggiuntivo, diventa 115. È un limite di sostenibilità, non una valutazione del giocatore.
Mi restano 137 crediti e 8 acquisti, incluso quello corrente.
Prezzo minimo 1. Voglio 15 crediti di margine oltre ai minimi.
Calcola il tetto teorico e il tetto prudente. Poi verifica i minimi
necessari per ciascun ruolo: non basta contare gli slot complessivi.
8. Aggiornare il piano dopo un acquisto costoso
Quando spendi più del previsto, il piano iniziale va ricalcolato. La risposta utile non è “ottimo colpo”, ma quali obiettivi diventano incompatibili e dove ridurre la spesa.
Ho speso 18 crediti oltre il piano per questo acquisto.
Aggiorna i budget residui senza cambiare retroattivamente le spese.
Proponi due riallocazioni e indica quali alternative diventano necessarie.
9. Leggere il tabellone con una foto e verificare l’OCR
Se il tuo strumento consente di leggere immagini, una fotografia del tabellone può essere un punto di partenza. Va confermata la trascrizione prima di fare conti: un 13 letto come 73 cambia tutta l’asta.
Trascrivi questa foto in una tabella: giocatore, acquirente e prezzo.
Segnala le celle poco leggibili senza indovinarle. Fermati prima
dell’analisi e fammi controllare la trascrizione. Poi riconcilia
la somma degli acquisti con i crediti residui di ogni squadra.
10. Misurare i rincari nella tua asta
Con un listino di riferimento comparabile, puoi confrontare prezzi pagati e stime iniziali. Un rapporto di 1,20 indica, in quel campione e rispetto a quel riferimento, prezzi del 20% superiori. Se il riferimento è debole, anche l’indicatore lo è.
Per ogni ruolo confronta somma dei prezzi pagati e somma dei valori
di riferimento dei medesimi giocatori. Mostra numerosità e rapporto.
Non estendere il risultato ai ruoli senza acquisti né a tutta la lega
se il campione è piccolo. Indica le anomalie del riferimento.
Formazione Fantacalcio con l’AI: 6 casi per scegliere chi schierare
11. Ragionare su un ballottaggio con una panchina reale
Chiedere “meglio A o B?” senza panchina e regole è un problema incompleto. Conta che cosa succede se uno non prende voto, oltre alla probabilità di partire titolare.
Confronta questi due giocatori per la giornata indicata usando
le fonti allegate. Distingui titolarità, probabilità di voto se
disponibile e rendimento condizionato al voto. Considera la riserva
e le regole di sostituzione. Non inventare percentuali mancanti.
Ecco una simulazione semplificata con un solo ballottaggio, riserva sempre disponibile e nessun limite ai cambi rilevante. Se Aurora ha probabilità di voto 0,70 e fantapunteggio medio condizionato al voto 7,5, mentre la riserva vale 6,0, il valore atteso del posto è 0,70 × 7,5 + 0,30 × 6,0 = 7,05. Per Boreale, con probabilità 0,95 e punteggio condizionato 6,8, diventa 0,95 × 6,8 + 0,05 × 6,0 = 6,76. Cambiando riserva o condizioni può cambiare la scelta.
Attenzione: probabilità di voto e probabilità di partire titolare non coincidono. E se il fornitore ha già incluso il rischio di assenza nel suo punteggio atteso, moltiplicarlo di nuovo può contare due volte lo stesso rischio.
Calcolo illustrativo con nomi e dati inventati. La riserva e le regole fanno parte della decisione.
12. Confrontare moduli con il modificatore difesa
Confronta l’intera formazione. In un esempio inventato, un 3-4-3 vale 72 punti attesi; un 4-3-3 vale 71 prima del modificatore. Se il bonus fosse +3 con probabilità 0,50 e zero negli altri casi, il contributo atteso sarebbe 1,5 e il secondo modulo arriverebbe a 72,5. Le probabilità sono ipotesi didattiche: vanno stimate o lasciate come scenari, mai spacciate per dati.
Confronta tutti i moduli ammessi usando solo la mia rosa.
Applica le soglie esatte del modificatore. Se mancano le distribuzioni
dei voti, mostra scenari senza inventare probabilità. Distingui
punteggio base, modificatore e rischio legato alle sostituzioni.
13. Ordinare la panchina per copertura
Una panchina piena di giocatori interessanti può lasciare scoperto il ruolo sbagliato. Chiedi la spiegazione dell’ordine e alcuni casi limite, non soltanto una lista.
Ordina la panchina secondo il regolamento allegato.
Mostra che cosa succede se non prendono voto uno, due o tre titolari
nei ruoli critici. Evidenzia i casi in cui rischio di giocare in dieci.
14. Controllare gli incastri nel Mantra
Nel sistema Mantra di Fantacalcio.it contano ruoli, compatibilità dei moduli e meccanismi di sostituzione. Fornisci all’assistente i ruoli del listone corretto e le impostazioni effettive della lega. La verifica finale va fatta nella piattaforma con cui giochi.
Sistema Mantra: usa esclusivamente i ruoli allegati e le regole
della mia lega. Costruisci due formazioni valide. Verifica per ogni
posto la compatibilità del ruolo e mostra gli scenari di sostituzione.
Non convertire ruoli Classic in ruoli Mantra per intuizione.
15. Confrontare i portieri con il calendario
Puoi chiedere una rotazione su più turni, purché calendario e disponibilità siano aggiornati. Separerei il criterio “avversario apparentemente più semplice” da una probabilità numerica di porta inviolata: la seconda richiede una fonte o un modello.
Confronta questi portieri per i prossimi 5 turni sulla base
del calendario allegato. Riporta casa/trasferta, disponibilità e
criteri della scelta. Se mancano stime affidabili sui gol subiti,
offri scenari qualitativi, senza assegnare probabilità arbitrarie.
16. Fare un controllo prima della scadenza
La formazione di venerdì mattina può essere superata venerdì sera. Il controllo deve riportare l’ora dell’ultimo aggiornamento e distinguere fonti ufficiali, notizie e ipotesi. La scadenza è quella della tua lega.
Controlla la mia formazione rispetto alle fonti aggiornate che
ti fornisco. Elenca solo i cambiamenti rilevanti, con fonte e ora.
Se non hai accesso a dati nuovi, dichiaralo. Verifica gli undici,
la panchina, i vincoli e la scadenza prima di suggerire modifiche.
Scambi e asta di riparazione con l’intelligenza artificiale
17. Valutare uno scambio guardando chi giocherà davvero
La somma delle FantaMedie può ingannare. In un esempio inventato, ricevere un giocatore da 7,4 e uno da 6,3 cedendone due da 6,9 e 6,5 sembra conveniente: 13,7 contro 13,4. Ma se il secondo nuovo acquisto resta sempre in panchina, quel confronto non descrive l’effetto sulla formazione.
Confronta la mia migliore formazione e la copertura prima e dopo
lo scambio. Usa lo stesso orizzonte e le stesse ipotesi sulle presenze.
Evidenzia chi entra negli undici e chi sostituisce. Se non possiamo
stimare il rendimento futuro, separa i dati storici dagli scenari.
18. Cercare svincolati adatti a un bisogno preciso
“Trovami una sorpresa” è vago. “Mi serve un difensore disponibile perché ne ho due indisponibili” è già un compito utile. Usa la lista degli svincolati della tua lega: un nome interessante già posseduto da un rivale non risolve il problema.
Da questa lista di svincolati seleziona alternative per coprire
il bisogno descritto. Escludi chi non è acquistabile o supera il budget.
Motiva le proposte con dati disponibili e indica quali verifiche
prepartita o di ruolo mancano.
19. Esaminare un rendimento anomalo senza promettere il rimbalzo
Un giocatore con pochi gol e occasioni di buona qualità merita un approfondimento, non un acquisto automatico. Prima di aspettarti un recupero devi controllare minuti, ruolo, qualità del dato e ampiezza del campione. Lo scarto tra gol e xG è un indizio da interpretare.
Individua nel dataset gli scarti tra gol e xG e mostra minuti
e dimensione del campione. Non dire che un giocatore “deve” segnare.
Per ciascun caso elenca spiegazioni alternative e dati da verificare.
20. Preparare uno scambio comprensibile per entrambe le parti
L’AI può aiutarti a formulare una proposta leggibile, collegando esigenze reali delle due rose. Se deve inventare notizie o sostenere che un rendimento futuro sia certo per convincere l’altro, stai usando male lo strumento.
Partendo da queste due rose, proponi uno scambio consentito dalle
regole che risponda a un bisogno di ciascuna squadra. Scrivi un messaggio
breve con motivazione e rischi. Non nascondere informazioni rilevanti
e non presentare stime come garanzie.
Analizzare la stagione, progettare un agente e gestire la lega
21. Separare qualità della scelta e risultato
Un attaccante rimasto in panchina che segna non dimostra da solo che hai sbagliato. Valuta che cosa sapevi prima della scadenza. Conserva la proposta dell’assistente e confrontala, a fine turno, con una regola di riferimento semplice.
Analizza queste scelte usando solo le informazioni disponibili
prima della consegna. Separa errore nei dati, errore nel ragionamento
ed esito sfavorevole ma plausibile. Confronta la proposta AI con la
mia regola di riferimento, senza usare dati futuri per giustificarla.
22. Scoprire squilibri nella rosa
Una tabella può mostrare troppi acquisti costosi nello stesso ruolo o più riserve che competono per uno slot. Prima di attribuire un punteggio complessivo alla squadra, chiedi un elenco concreto di coperture e dipendenze.
Esamina la composizione della rosa: budget per ruolo, alternative
utilizzabili, concentrazione sulla stessa squadra e ruoli scoperti.
Non assegnare un voto complessivo arbitrario. Indica tre interventi
possibili e che cosa dovrei cedere o sacrificare per realizzarli.
23. Progettare un assistente che prepara un report
Un’automazione utile può leggere le fonti consentite, aggiornare una tabella e preparare un rapporto prima della scadenza. Deve esistere una vera integrazione: scrivere “avvisami venerdì” in una chat non dimostra che un processo sia stato attivato. Verifica esecuzione, orario e consegna.
Progetta un flusso, senza attivarlo: fonti autorizzate, frequenza,
orario Europe/Rome, controlli sui dati e canale del report.
Il report deve includere aggiornamenti, formazione proposta,
alternative e dati mancanti. Prevedi un avviso se una fonte non risponde.
La consegna della formazione resta una mia azione.
Una connessione MCP, quando disponibile e compatibile con il tuo assistente, può mettere a disposizione dati strutturati. Nella descrizione tecnica di FantaGPT, la chiave è associata a una lega e il collegamento descritto non consente di schierare o acquistare. È un esempio utile di differenza tra accesso ai dati e capacità di agire. Non incollare chiavi personali in chat condivise o schermate pubbliche.
24. Rendere il regolamento più chiaro per il presidente di lega
Puoi chiedere all’AI di cercare contraddizioni e formulare esempi, lasciando le decisioni ai partecipanti. È particolarmente utile prima dell’inizio della stagione, quando puoi chiarire una regola senza cambiarla a partita già giocata.
Revisiona questo regolamento senza modificarne le scelte.
Trova contraddizioni, termini ambigui e casi non coperti.
Per ciascuno proponi due formulazioni alternative ed esempi.
Non presentare nessuna modifica come già approvata dalla lega.
25. Creare la cronaca della giornata senza inventare episodi
Report, nomi delle squadre, pagelle ironiche e messaggi per il gruppo possono essere applicazioni divertenti. Usa risultati reali forniti e tieni separata la satira dalle informazioni sportive. È anche un buon esercizio per un laboratorio sull’AI.
Scrivi la cronaca ironica della giornata usando solo questi risultati.
Non inventare gol, infortuni o dichiarazioni. Tono da gruppo di amici,
nessun attacco personale. Chiudi con tre osservazioni sui dati,
distinguendole chiaramente dalle battute.
Un video da guardare con spirito critico e una prova da fare
Il tema è stato affrontato anche da Lorenzo Cantarini nel video “FANTACALCIO E CHATGPT: HO FATTO LA FORMAZIONE CON LA A.I.”, richiamato nell’approfondimento di Fanta.Soccer su AI, aste e formazioni. È uno spunto per discutere l’esperimento: una singola formazione riuscita o sbagliata non basta a valutare un sistema.
Video esterno su YouTube. Se il player non viene caricato, apri il video su YouTube. Il contenuto è un esempio sul tema, non una guida ai nomi da schierare nella stagione corrente.
Per una prova più seria, scegli prima una regola di riferimento: per esempio la tua procedura abituale, scritta chiaramente. Registra poi, prima delle partite, la formazione proposta dall’AI, i dati usati, l’orario e le motivazioni. Confronta i due metodi per più giornate sulle stesse rose e sulle stesse regole, senza correggere a posteriori le proposte. Ti interessano punteggio, frequenza degli errori nei vincoli, copertura dei ruoli e tempo impiegato.
Puoi trasformarlo in un laboratorio: un gruppo lavora con un prompt generico, uno con regolamento e dati puliti, uno con un assistente che deve dichiarare le incertezze. Il confronto non deve decretare il “chatbot più tifoso”, ma mostrare come cambia la qualità del lavoro quando cambia il contesto. È un esercizio che si collega bene ai miei corsi su AI generativa, agenti e prompt engineering.
Gli errori che fanno perdere valore all’AI nel Fantacalcio
Chiedere nomi aggiornati senza dati aggiornati. Verifica stagione, squadra, ruolo e disponibilità.
Usare una media storica come previsione certa. È una descrizione di ciò che è successo, non una promessa.
Chiedere percentuali e accettarle comunque. Senza fonte o modello esplicito, un numero preciso può essere solo decorazione.
Sommare quotazioni come se fossero prezzi della tua asta. Servono confronti omogenei e un riferimento alla tua lega.
Dimenticare la panchina. Il valore di uno slot dipende anche dalle sostituzioni.
Riutilizzare una risposta vecchia. Un consiglio dipende dal momento e dai dati con cui è stato prodotto.
Credere che l’AI abbia letto un sito o un file. Fatti indicare cosa ha consultato e controllalo.
Valutare il sistema dopo una sola giornata. Registra anche una regola di confronto e gli errori, senza selezionare solo i casi riusciti.
Domande frequenti sull’intelligenza artificiale per il Fantacalcio
Si può usare ChatGPT per fare la formazione del Fantacalcio?
Puoi usarlo come supporto fornendo rosa, regole e dati aggiornati. Chiedi una proposta con alternative, fonti e controlli sui vincoli. Verifica la formazione nella piattaforma della tua lega prima di consegnarla: una risposta plausibile non certifica che gli undici siano validi o disponibili.
Qual è la migliore AI per il Fantacalcio?
Dipende dal compito e dalle regole supportate. Un assistente generalista è flessibile nel lavoro sui tuoi documenti; un servizio dedicato può offrire dati e stime già organizzati. Senza un test comparativo indipendente non è corretto assegnare il titolo di migliore. Controlla aggiornamento, trasparenza, compatibilità e risultati registrati.
Esiste un’AI per il Fantacalcio gratis?
Le condizioni cambiano. Puoi iniziare con tabelle e prompt se le funzioni necessarie sono disponibili nel tuo account. Alcuni servizi presentano prove o funzioni gratuite, altre attività richiedono un pagamento. Verifica sulla pagina ufficiale limiti, durata della prova ed eventuali rinnovi prima di scegliere.
Come si usa l’AI durante l’asta?
Prepara listone e piano prima dell’asta, poi aggiorna acquisti, budget e slot a ogni passaggio. Le richieste più utili riguardano rilancio massimo sostenibile, alternative e conseguenze di una spesa extra. Conferma la trascrizione degli acquisti: un prezzo errato compromette tutti i calcoli successivi.
L’AI funziona anche per il Mantra?
Può aiutarti a confrontare alternative, ma deve avere ruoli e regole Mantra corretti. Non tutti i servizi dedicati supportano questo sistema. Verifica sulla documentazione del prodotto e controlla l’ammissibilità della formazione nella piattaforma della lega.
L’AI può vincere il Fantacalcio al mio posto?
Non può garantire il risultato. Può aiutare a organizzare informazioni e a rendere le scelte più coerenti. L’efficacia concreta va valutata su proposte registrate prima delle partite e confrontate con una procedura di riferimento, senza ignorare costi, tempo e dati mancanti.
Il miglior acquisto può essere una domanda fatta bene
Per iniziare non chiederei “chi farà più gol?”. Prenderei la mia rosa, il regolamento e una scelta concreta: due giocatori da confrontare, un rilancio da valutare, uno scambio che mi lascia perplesso. Chiederei dati, alternative e condizioni che cambiano la risposta.
È una lezione che vale anche fuori dal Fantacalcio: un assistente diventa più utile quando gli diamo un problema definito e informazioni controllabili. Poi domenica il tuo attaccante può comunque colpire il palo al novantesimo. Il prompt, almeno quello, non avrà colpe.
Vuoi portare questo metodo in un corso sull’AI?
Il Fantacalcio è un terreno concreto per imparare a lavorare con dati, prompt, scenari e assistenti. Progetto workshop su AI generativa e agenti per aziende e organizzazioni, adattando esempi e laboratori al pubblico. Contattami per costruire un percorso formativo, oppure usa il modulo qui sotto.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/fantacalcio_ai-scaled.png9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-14 08:50:292026-10-28 15:28:01Intelligenza artificiale per il Fantacalcio: 25 applicazioni e prompt
Chiedi all’AI di vestirti da pompiere. Arrivano la giacca, il casco e l’autopompa. Poi guardi meglio: il pompiere è tuo cugino. O almeno sembra una versione di te che nessuno ha mai incontrato.
È un problema concreto per chi usa immagini generate nella comunicazione: cambiare ambientazione è utile, cambiare involontariamente faccia molto meno. Se un avatar compare nelle copertine del blog, nelle slide e nei caroselli, deve restare riconoscibile. Altrimenti il personal branding diventa il casting di una serie televisiva.
Una proposta interessante è Identity-Lock: una struttura del prompt che separa l’identità del soggetto dalle trasformazioni richieste. La proverei come metodo di lavoro, senza prendere alla lettera la promessa di “bloccare” qualsiasi volto.
Che cos’è Identity-Lock e come si costruisce il prompt
Il punto di partenza è l’articolo di Jason Reeve su lifehackedai. La struttura proposta mette i vincoli sul volto all’inizio, descrive trasformazione e scena e richiama l’identità alla fine. L’autore riferisce esperienze con 125 prompt, ma nella pagina non presenta una valutazione indipendente con metriche sufficienti a dimostrare una garanzia universale.
Riga
Funzione
Che cosa scrivere
1
Identità
Indicare la persona nella foto e i tratti da conservare.
2
Trasformazione
Descrivere abiti o stile desiderato.
3
Scena
Definire ambiente, luce e inquadratura.
4
Richiamo dei vincoli
Ribadire la riconoscibilità e il formato richiesto.
Le quattro righe sono un promemoria organizzativo. Non rappresentano un comando tecnico che impedisce al modello di modificare il viso. Anche scrivere /identitylock in una normale conversazione non attiva automaticamente una funzione speciale: senza uno strumento che interpreti quel comando, resta testo nel prompt.
Perché “mantieni la mia faccia” è un’istruzione incompleta
La guida ufficiale di OpenAI al prompting delle immagini mostra proprio un caso di cambio d’abiti con conservazione dell’identità. Suggerisce di specificare gli elementi che devono restare invariati e quelli che possono cambiare. È un’indicazione più concreta di un generico “fammi uguale”.
Il mio consiglio è costruire una piccola scheda del personaggio: forma del viso, naso, occhi, attaccatura dei capelli, barba ed età apparente. Non occorre trasformarla in un referto: serve a evitare che il modello interpreti “ritratto professionale” come un invito a ringiovanirti di quindici anni.
La foto di riferimento conta almeno quanto la descrizione. Nel Cookbook di OpenAI sulla fedeltà delle immagini di input, la conservazione dei volti è uno degli impieghi della modalità ad alta fedeltà. Impostazioni e disponibilità dipendono dal modello e dall’ambiente: un parametro dell’API non va confuso con un pulsante disponibile in tutte le interfacce.
Per un ritratto reale partirei da una fotografia nitida. Per una serie illustrata partirei dall’avatar approvato. Sono obiettivi diversi: un disegno può conservare l’identità grafica di un personaggio senza essere una riproduzione fotografica della persona.
Tre esempi di prompt Identity-Lock da adattare
I prompt seguenti sono esempi originali in italiano. Prima carica il riferimento visivo; poi sostituisci le parti che riguardano il tuo soggetto. Le immagini di questo articolo sono illustrazioni generate a partire dal mio avatar: mostrano possibili usi, non un confronto sperimentale sull’efficacia del metodo.
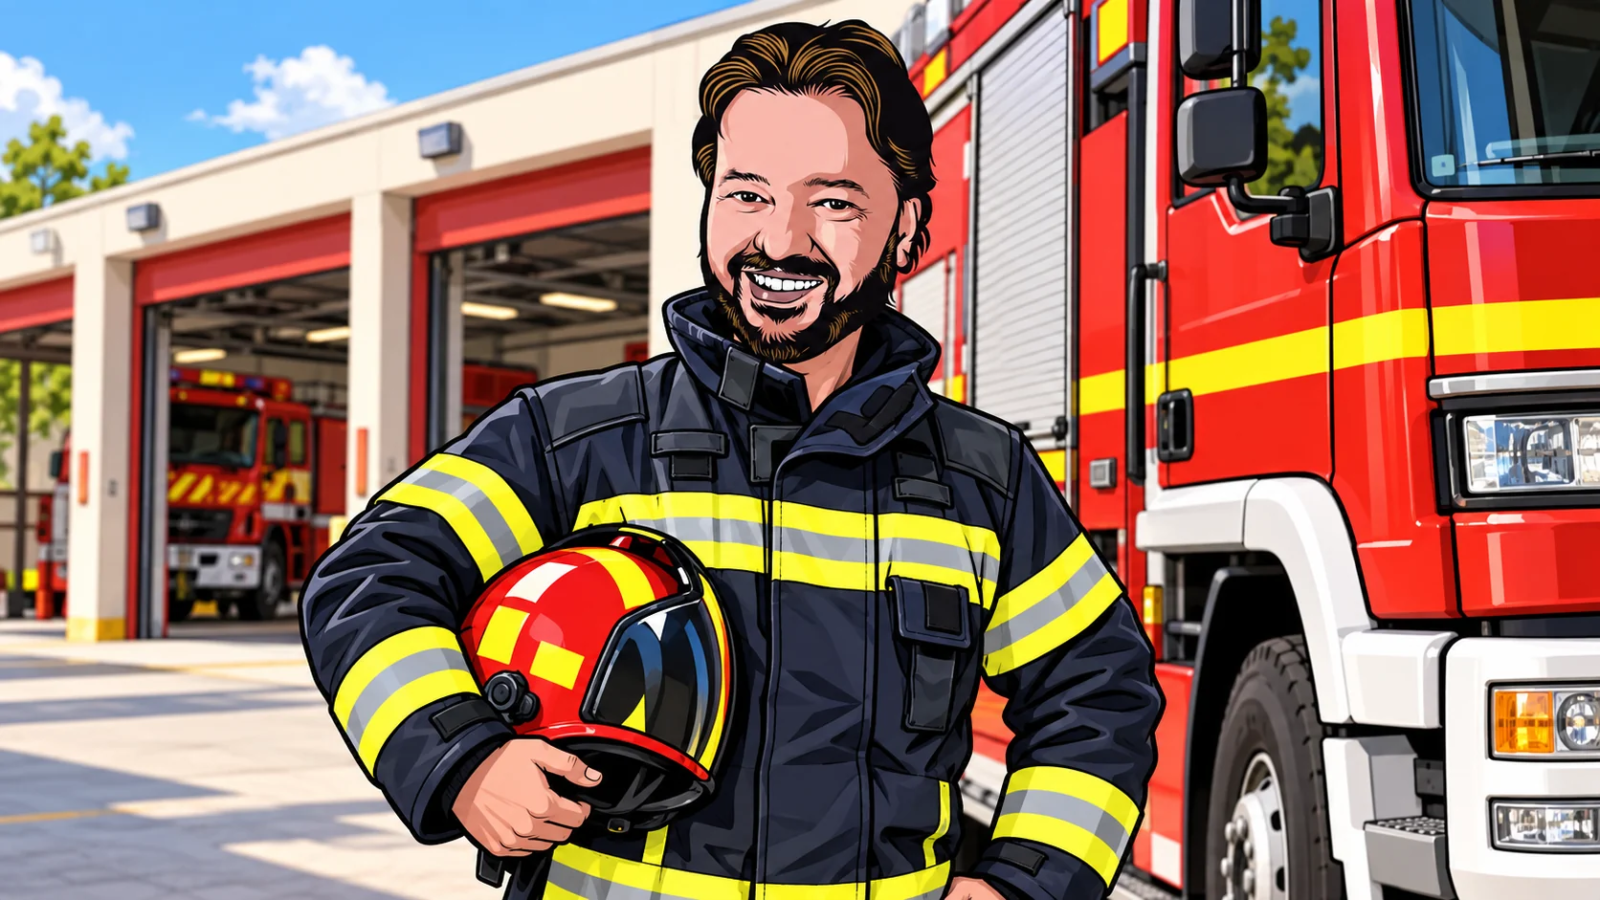
1. Cambiare abito: il mio avatar diventa pompiere
Qui chiedo un cambiamento ben circoscritto. Mantengo lo stile del disegno e lascio il capo scoperto, così i capelli restano visibili e posso controllare meglio il risultato.
1. Usa l’avatar allegato come riferimento del personaggio: conserva forma del viso, occhi, naso, sorriso, capelli e barba.
2. Cambia l’abbigliamento: giacca da pompiere blu con bande gialle riflettenti; mantieni lo stile illustrato originale.
3. Ambientalo davanti a una caserma con un’autopompa; tiene il casco in mano, volto ben visibile, luce diurna.
4. Deve essere riconoscibile come lo stesso avatar, senza ringiovanirlo o ridisegnarne i tratti; immagine orizzontale 16:9.
Un cambio di abito e ambientazione a partire dall’avatar di riferimento. Illustrazione generata con AI, non fotografia di un evento reale.
Il controllo utile riguarda il volto, non soltanto la qualità della giacca. Se il naso cambia, correggo quel tratto: “Ripristina il naso del riferimento; conserva abiti e sfondo del risultato”. Una correzione localizzata è più chiara di “rifai tutto meglio”.
2. Un ritratto professionale senza un lifting digitale
Per questo esempio serve una foto reale. Il risultato può essere destinato a un sito o a una presentazione, ma va controllato prima di usarlo come immagine professionale.
1. La persona è quella nella fotografia allegata: conserva lineamenti, proporzioni del viso, capelli, pelle ed età apparente.
2. Sostituisci soltanto l’abbigliamento con una giacca blu e una camicia chiara.
3. Mantieni posa, espressione e inquadratura della foto; lascia invariato anche lo sfondo.
4. Non abbellire o ringiovanire il volto: deve restare la stessa persona; produci un singolo ritratto verticale.
Ho deliberatamente limitato le modifiche. Per cambiare anche luce e sfondo, farei un passaggio successivo sull’immagine approvata, verificando di nuovo il volto. Non è una garanzia tecnica: è una procedura che rende gli errori più facili da individuare.
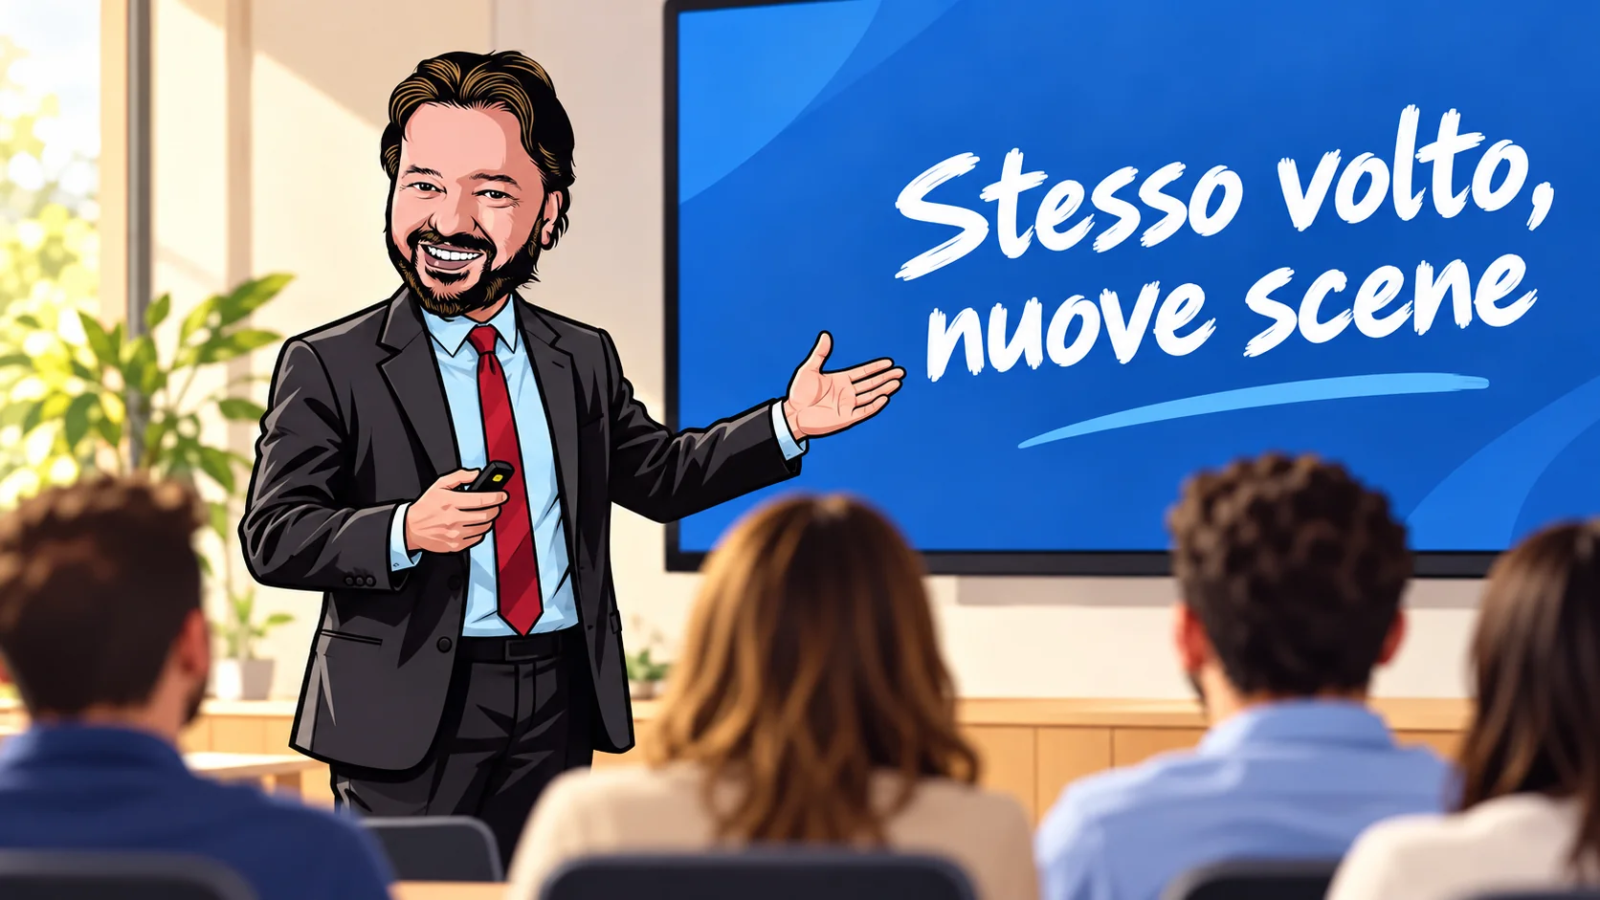
3. Una serie di immagini per un corso o un carosello
In una serie, la coerenza si gioca sull’intero personaggio. Il mio avatar può essere davanti a una lavagna, a un computer o a uno smartphone: voglio che il lettore riconosca sempre il medesimo protagonista.
1. Riprendi il personaggio dell’avatar allegato: conserva volto, capelli, barba, età apparente e proporzioni.
2. Mantieni il completo nero, la camicia azzurra, la cravatta rossa e lo stile del disegno.
3. Mostralo mentre conduce un workshop davanti a uno schermo con la scritta “Stesso volto, nuove scene”; formato 16:9.
4. Rispetta l’identità grafica dell’avatar: modifica soltanto posa e ambientazione richieste, senza reinventare il personaggio.
Lo stesso riferimento grafico applicato a una scena didattica. La riconoscibilità va verificata anche quando l’immagine è esteticamente riuscita.
Per la scena successiva riutilizzerei il riferimento approvato. Eviterei di passare soltanto il risultato precedente per decine di trasformazioni: ogni eventuale scostamento diventerebbe il punto di partenza del passaggio seguente.
Che cosa dimostra la ricerca, e che cosa rimane un’ipotesi
Quel risultato non dimostra che quattro righe impediscano la deriva dei volti nei generatori di immagini. Trasferire la spiegazione a questo caso è un’ipotesi, non una conclusione verificata dallo studio. Mettere in evidenza i vincoli può essere una buona pratica; attribuirle un’efficacia universale richiede altri esperimenti.
La conservazione dell’identità è anche un problema di progettazione dei modelli. Il paper InstantID: Zero-shot Identity-Preserving Generation in Seconds, di Qixun Wang e colleghi, propone un sistema che integra informazioni sul volto e punti di riferimento facciali nella generazione. È un approccio tecnico, diverso dal riordinare il testo di un prompt.
La conseguenza pratica è semplice: se la somiglianza resta insufficiente, potrebbe servire cambiare strumento o modalità di modifica. Insistere con “identico, identico, identico” non trasforma automaticamente un vincolo linguistico in un vincolo geometrico.
Il prompt va adattato allo strumento
In Midjourney bisogna distinguere le istruzioni scritte dalle funzioni per i riferimenti visivi. La documentazione ufficiale dell’Edit Model descrive l’uso di immagini di riferimento e la sostituzione delle precedenti funzioni Omni Reference e Character Reference nell’ambiente supportato. Prima di copiare parametri da un tutorial, controlla la versione che stai usando.
Un’altra scorciatoia da ridimensionare è il seed: la guida ufficiale di Midjourney sui seed precisa che non servono a salvare un personaggio o un aspetto attraverso prompt differenti. Possono aiutare negli esperimenti, ma non sono la carta d’identità digitale del soggetto.
Un laboratorio di 20 minuti per capire se il metodo ti aiuta
Proporrei questo esercizio in aula. Il tempo e il numero di immagini sono una scelta didattica, non uno standard scientifico.
Scegli il riferimento: una tua foto o un avatar autorizzato, sempre lo stesso.
Definisci cinque criteri: forma del viso, occhi, naso, capelli e barba o bocca. Aggiungi la riconoscibilità complessiva.
Prepara due prompt: uno generico e uno strutturato in quattro righe. Mantieni identiche trasformazione e scena.
Genera tre risultati per ciascuno: usa lo stesso modello e le stesse impostazioni disponibili. Conserva anche le immagini meno riuscite.
Confronta senza etichette: mescola i risultati e assegna a ogni criterio 0, 1 o 2 punti. Poi scopri quale prompt ha prodotto ciascuna immagine.
Una scala possibile è: 0, tratto alterato; 1, somiglianza parziale; 2, tratto coerente con il riferimento. Il voto è soggettivo e sei immagini non bastano per generalizzare. Servono però a capire se, nel tuo caso, la struttura riduce gli scarti e il tempo necessario alle correzioni.
Dal volto al metodo di lavoro
Per i fondamenti dei modelli linguistici, segnalo la lezione Intro to Large Language Models di Andrej Karpathy. È una lezione del 2023, in inglese: aiuta a capire il contesto tecnico, ma non è una dimostrazione di Identity-Lock.
La parte che porterei nel lavoro quotidiano è questa: scegliere un riferimento, dichiarare le modifiche consentite, preservare i tratti importanti e controllare il risultato. Puoi applicarla alle copertine, ai materiali didattici e alla comunicazione del tuo team. Nella mia raccolta di risorse ed esercizi per il corso ChatGPT trovi altri punti di partenza per lavorare con l’AI.
Identity-Lock può essere un buon nome per ricordare la procedura. Il controllo finale resta nostro. Se l’immagine è bellissima ma la persona è diventata un’altra, il prompt non ha svolto il compito.
Vuoi usare le immagini AI nella comunicazione della tua azienda?
Nei miei corsi di AI generativa lavoriamo su prompt, riferimenti visivi e criteri di controllo, con esercizi legati ai materiali che il team deve produrre. Scrivimi attraverso il modulo nella pagina contatti per progettare un laboratorio su misura.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/identity-lock-cover-scaled.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-14 07:41:032026-10-28 15:28:02Identity-Lock: come mantenere lo stesso volto nelle immagini AI
Quando si parla di intelligenza artificiale, le citazioni fanno spesso la stessa fine dei biscotti nei corsi: spariscono dal loro contesto. Una frase diventa uno slogan, lo slogan diventa una certezza e qualcuno finisce per attribuire a Einstein anche il prompt engineering.
Ho scelto dieci citazioni sull’intelligenza artificiale generativa e sugli agenti, accompagnandole con il loro contesto e con una conseguenza pratica. Alcune sono domande storiche, altre estratti da studi scientifici o guide tecniche. Il percorso parte dall’intelligenza delle macchine e arriva a una questione molto concreta: che cosa possiamo delegare, con quali strumenti e con quali controlli?
Nota sulle citazioni: i brani in italiano sono mie traduzioni di brevi estratti inglesi. Le omissioni sono indicate con […]. “Attention Is All You Need” è il titolo originale di un paper, riportato come tale. I collegamenti permettono di controllare formulazione e contesto.
1. Alan Turing: prima di discutere di intelligenza, definiamo la domanda
«Le macchine possono pensare?»
Alan M. Turing, 1950. È la domanda che apre Computing Machinery and Intelligence. Turing passa poi a un problema più circoscritto, il gioco dell’imitazione, per ragionare sui comportamenti osservabili.
Questa citazione serve ancora perché ci costringe a chiarire che cosa stiamo chiedendo. “ChatGPT pensa?” può significare: produce risposte sensate, risolve un problema, possiede intenzioni oppure ha esperienza cosciente? Sono questioni diverse. Un testo convincente, da solo, non risolve l’ultima.
Nel lavoro: invece di discutere per un’ora se il chatbot sia intelligente, chiediamoci se sa sintetizzare correttamente quel verbale. Definiamo criteri verificabili: decisioni riportate, responsabilità attribuite, scadenze conservate. La filosofia resta interessante; il verbale deve comunque essere giusto.
2. Dartmouth: simulare una capacità non significa diventare una persona
«[…] una macchina può essere costruita per simularlo.»
John McCarthy, Marvin Minsky, Nathaniel Rochester e Claude Shannon, 1955. Questo frammento della proposta per il progetto estivo di Dartmouth si riferisce alla congettura secondo cui gli aspetti dell’apprendimento e dell’intelligenza possono essere descritti con precisione sufficiente a simularli.
La parola decisiva è “congettura”: un programma di ricerca, non una dimostrazione già acquisita. Per leggere il presente, io terrei anche “simulare”. Un sistema può svolgere un’attività utile senza avere la biografia, le motivazioni o l’esperienza di chi la svolge normalmente.
Nel lavoro: far preparare una bozza commerciale all’AI può essere sensato. Trattarla come un collega che conosce automaticamente la storia del cliente è un salto ingiustificato. Quella storia va fornita, recuperata e controllata.
3. Vaswani e colleghi: attenzione alle relazioni tra le parole
«Attention Is All You Need»
Ashish Vaswani e coautori, 2017. È il titolo del paper che propone l’architettura Transformer. “Attenzione” indica qui un meccanismo computazionale, non la concentrazione cosciente di una persona.
Il titolo è diventato celebre, ma non significa che basti stare attenti per costruire un’AI. Il lavoro presenta un’architettura basata su meccanismi di attenzione, senza ricorrenza e convoluzioni, e la valuta su compiti di traduzione. Per un lettore non tecnico, il punto utile è che le relazioni nel contesto contano.
Nel lavoro: se chiediamo di spiegare la parola “rete”, un riferimento alla pesca, al calcio o ai computer cambia l’interpretazione richiesta. Inserire il contesto pertinente aiuta a disambiguare il compito; non garantisce automaticamente una risposta corretta.
4. Bender e colleghe: la fluidità del linguaggio può ingannarci
«[…] un pappagallo stocastico.»
Emily M. Bender, Timnit Gebru, Angelina McMillan-Major e Shmargaret Shmitchell, 2021. Il frammento proviene dal paper sui rischi dei grandi modelli linguistici, che Bender riprende e contestualizza nelle sue spiegazioni pubblicate nel 2026.
“Stocastico” rimanda alla probabilità. La metafora invita a non attribuire automaticamente intenzioni umane a un testo fluente. Va però trattata come una lente interpretativa, non come una formula che esaurisce ogni capacità di ogni sistema attuale. Bender stessa distingue il modello linguistico dai prodotti che lo integrano con altri componenti.
Nel lavoro: una risposta elegante può contenere un riferimento inventato. Quando un chatbot cita un paper, aprire il collegamento e confrontare ciò che sostiene con il documento è parte del compito. Il tono sicuro non è una certificazione di qualità.
5. Ouyang e colleghi: più grande non equivale automaticamente a più utile
«Rendere più grandi i modelli linguistici non li rende, di per sé, migliori nel seguire l’intento dell’utente.»
Qui si capisce perché un modello capace di continuare testi e un assistente utile non siano la stessa cosa. Nel lavoro descritto, alle dimostrazioni del comportamento desiderato seguono confronti tra risposte e un ulteriore addestramento basato sul feedback umano. Non ne deriva che ogni assistente sia infallibile o che tutti i sistemi seguano la stessa procedura.
Nel lavoro: scegliere un modello soltanto perché “è il più potente” è un criterio incompleto. Proviamolo su attività rappresentative: rispetta i vincoli? Mantiene il tono? Segnala ciò che manca? Quanto dobbiamo correggere?
6. La ricerca sulle allucinazioni: dobbiamo premiare anche il dubbio
«[…] premiano il tentare una risposta rispetto al riconoscere l’incertezza.»
OpenAI, 2025. La frase compare nella presentazione della ricerca Why Language Models Hallucinate. Lo studio di Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala ed Edwin Zhang analizza il ruolo degli incentivi nell’addestramento e nella valutazione.
Se un test assegna zero punti sia a una risposta sbagliata sia a un’ammissione di ignoranza, indovinare può diventare conveniente. Questo aiuta a spiegare perché la sicurezza espressiva non coincida con l’affidabilità. Non è una spiegazione unica di tutti gli errori, né una prova che basti aggiungere “non inventare” per eliminarli.
Nel lavoro: quando valutiamo un assistente, inseriamo casi con informazioni mancanti. Una risposta utile può identificare la lacuna e chiedere il dato necessario. Se premiamo soltanto chi completa ogni casella, rischiamo di addestrare anche noi una macchina delle risposte plausibili.
7. ReAct: il passaggio agli agenti comincia dall’alternare ragionamento e azione
«[…] tracce di ragionamento e azioni specifiche del compito in modo alternato.»
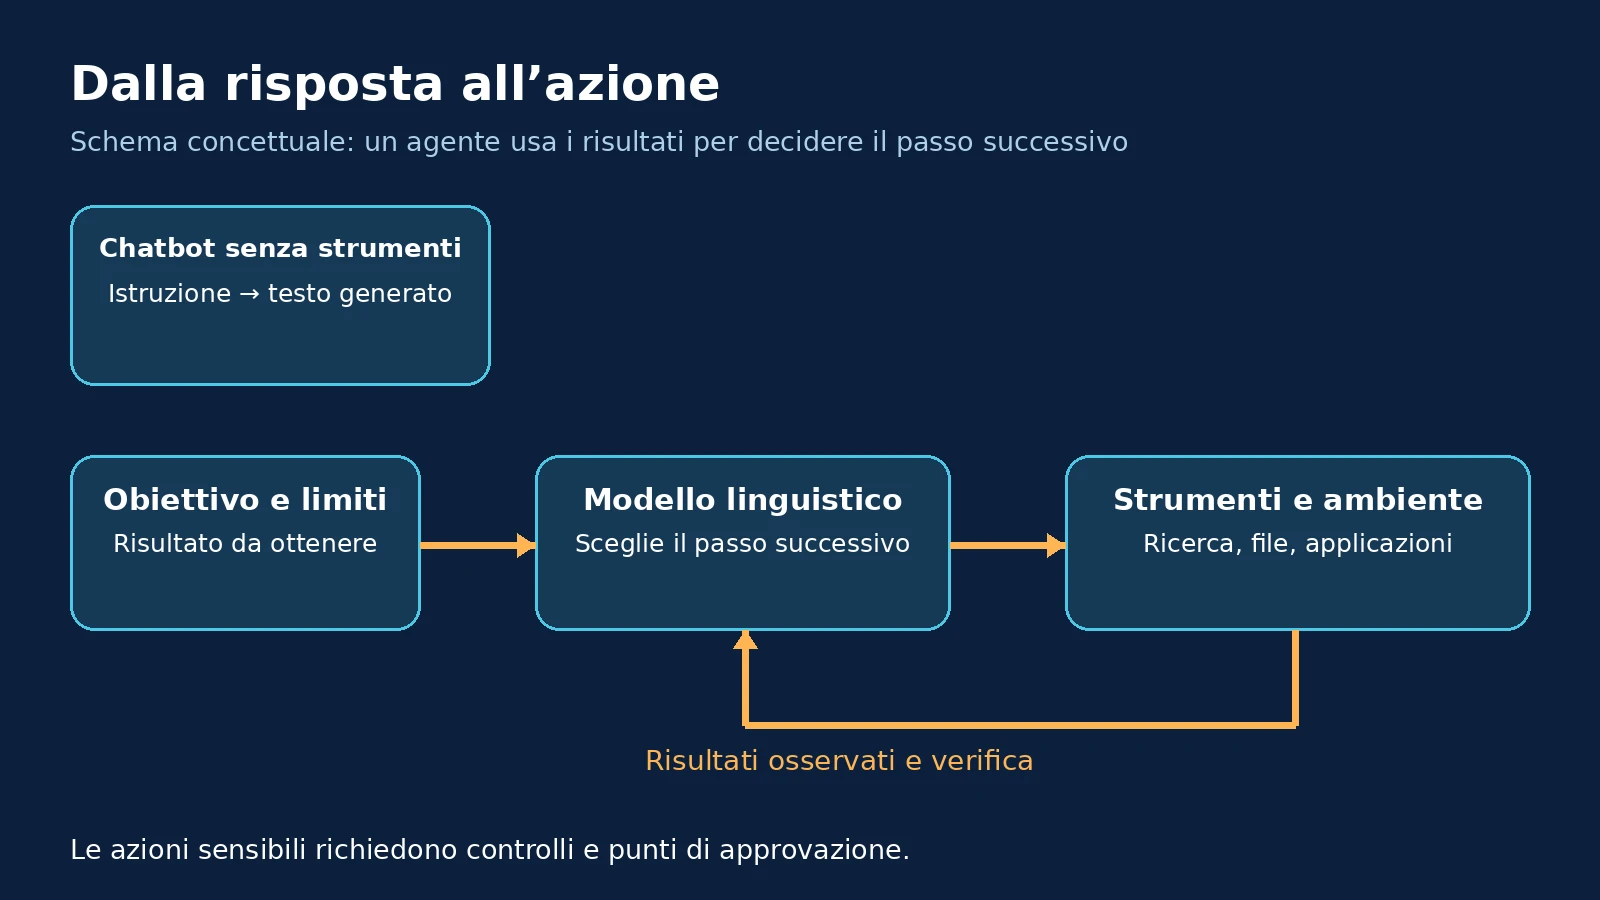
È un ponte utile tra la conversazione e il lavoro operativo. Il sistema non deve limitarsi a generare la descrizione di una ricerca: può interrogare una fonte, ricevere un risultato e adattare il passo successivo. Le tracce generate non vanno però confuse con una lettura trasparente della mente del modello.
Nel lavoro: per confrontare fornitori, un agente potrebbe cercare schede, estrarre condizioni, accorgersi che manca una specifica e cercarla. Il risultato va valutato sui documenti effettivamente recuperati. Scrivere “ho verificato” e aver verificato sono due cose diverse.
Un agente usa i risultati delle azioni per scegliere come proseguire. Schema concettuale originale.
8. Anthropic: un agente decide come usare gli strumenti
«[…] gli LLM dirigono dinamicamente i propri processi e l’uso degli strumenti.»
Anthropic, Building effective agents, 2024. La guida di Anthropic distingue i workflow con percorsi predefiniti dagli agenti in cui il modello determina dinamicamente i passaggi.
È una distinzione architetturale utile, non l’unica definizione possibile di agente. Una sequenza fissa che prende un file, lo riassume e lo archivia può essere un’ottima automazione. Diventa più propriamente agentica quando il modello sceglie il percorso in base a ciò che incontra.
Nel lavoro: se ogni venerdì devi copiare lo stesso report nella stessa cartella, comincia da un automatismo. Se devi indagare un’anomalia e decidere quali documenti esaminare, una componente agentica può avere senso. La complessità va giustificata dal problema, non dal fascino della parola “agente”.
9. Context engineering: il contesto non è un ripostiglio infinito
«Il contesto […] deve essere trattato come una risorsa finita con rendimenti marginali decrescenti.»
Anthropic, 2025. È un passaggio di Effective context engineering for AI agents. La guida porta l’attenzione dalle sole istruzioni all’insieme delle informazioni disponibili durante il lavoro.
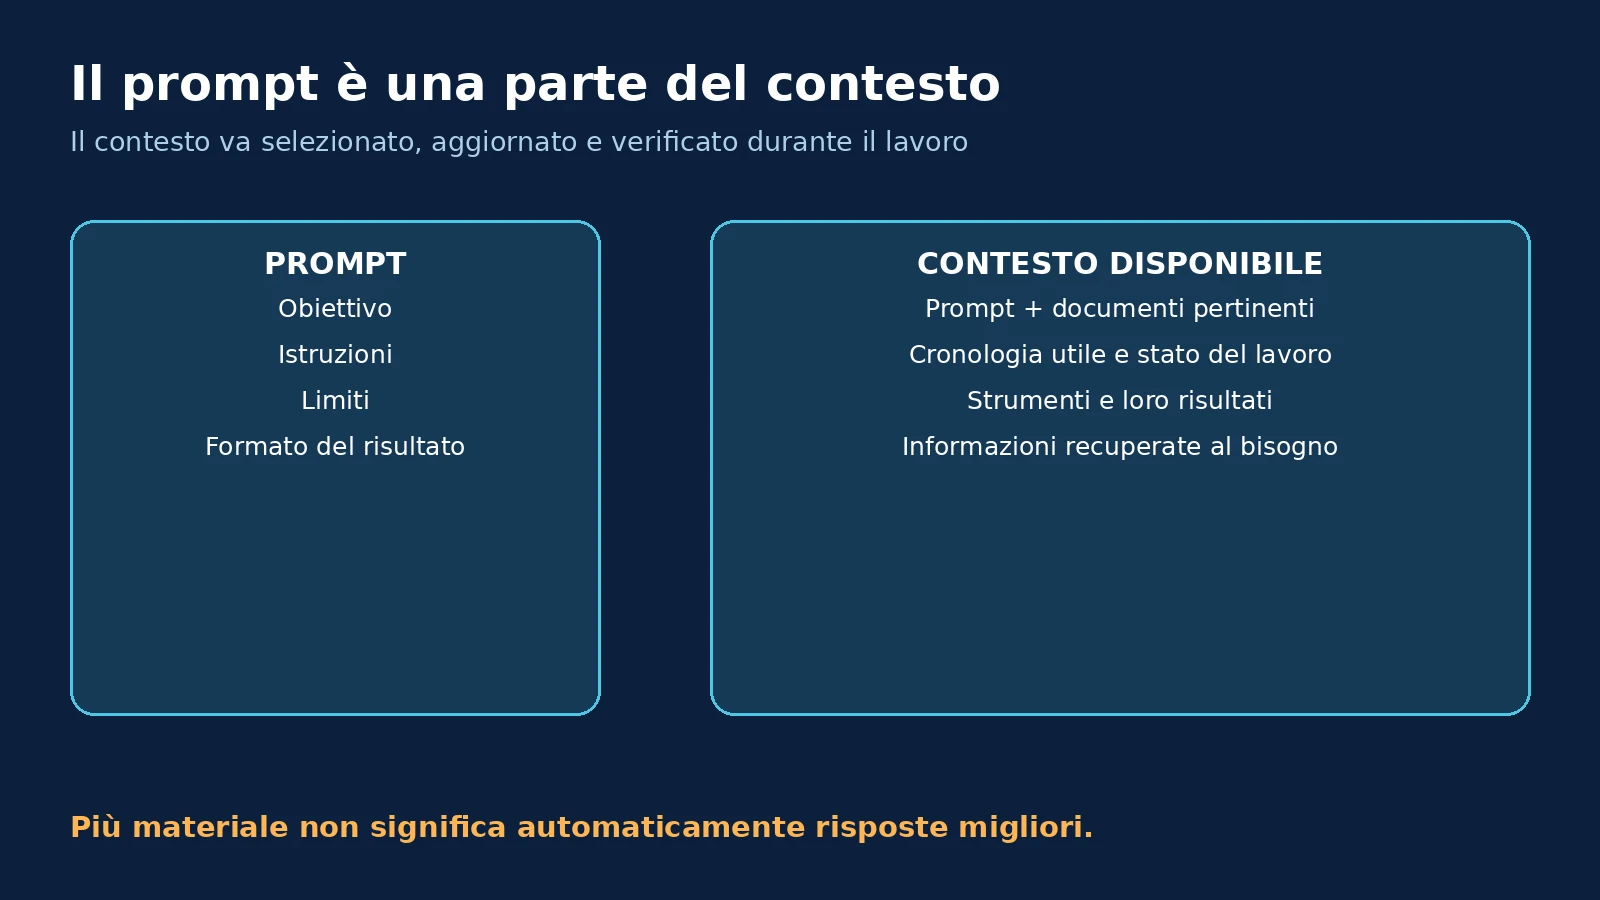
Il prompt è una parte del contesto. Contano anche documenti, cronologia, descrizioni degli strumenti e risultati delle loro azioni. Aggiungere materiale può aiutare, ma può anche introdurre rumore, contraddizioni e versioni superate. La conseguenza operativa è selezionare ciò che serve e mantenerlo aggiornato.
Nel lavoro: per preparare un’offerta, meglio un listino valido, un brief chiaro e due esempi pertinenti che l’intero archivio di proposte degli ultimi anni. Quando manca una condizione, l’agente dovrebbe recuperarla dalla fonte appropriata. Il second brain è utile quando aiuta a trovare, non soltanto ad accumulare.
Il context engineering riguarda anche la selezione e l’aggiornamento delle informazioni. Schema originale.
10. OpenAI: l’intervento umano è una parte del progetto
«L’intervento umano è una salvaguardia fondamentale […].»
OpenAI, A practical guide to building agents, 2025. Nella sezione dedicata all’intervento umano, la guida pratica di OpenAI, sezione sull’intervento umano tratta il passaggio di controllo quando l’agente incontra problemi e le verifiche per azioni ad alto impatto.
La supervisione non dovrebbe essere un’aggiunta improvvisata dopo un incidente. Va progettata insieme ai permessi, ai limiti di esecuzione e alle condizioni di arresto. Autonomia significa delegare un perimetro di lavoro, con responsabilità e confini espliciti.
Nel lavoro: un agente può predisporre una risposta a un cliente e raccogliere gli allegati. Possiamo richiedere approvazione prima dell’invio di un’offerta vincolante, fissare un numero massimo di tentativi e consentire accesso solo ai documenti necessari. Così la delega diventa una procedura valutabile.
Un video per collegare i concetti
Per approfondire i modelli linguistici, propongo Intro to Large Language Models di Andrej Karpathy. È una lezione in inglese pubblicata nel 2023: utile per i fondamenti, mentre i riferimenti ai prodotti vanno letti come una fotografia di quel periodo.
Dalle citazioni a una delega concreta
La mia lettura di queste dieci frasi è molto pratica: definire il compito, distinguere la fluidità dalla correttezza, dare informazioni pertinenti, collegare strumenti e osservare i risultati. Infine, decidere dove la macchina deve fermarsi.
Nel mio metodo 4A e nei corsi sugli agenti AI distinguo automatismi, azioni programmate, assistenti e agenti. È una griglia didattica per scegliere quanta delega serve. Un’attività programmata non diventa automaticamente un agente, e un agente non è la soluzione migliore per qualsiasi attività.
Per mettere alla prova queste idee, scegli un compito reale e scrivi cinque cose: risultato atteso, informazioni necessarie, strumenti consentiti, criteri di verifica e punto di approvazione. Poi confronta il tempo risparmiato con il tempo speso a controllare e correggere. È un esperimento più utile di cento slogan sul futuro.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/dieci-citazioni-ai-cover-scaled.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-13 20:37:232026-10-28 15:28:0210 citazioni per capire l’AI generativa e gli agenti
Di Gianluigi Bonanomi · Verifica aggiornata al 13 ottobre 2026
Un data center viene colpito, una curva precipita e qualcuno vede finalmente la prova: dietro il consenso online di certi movimenti politici europei ci sarebbero server russi. Spenti quelli, spariti i sostenitori. È una storia potente. Ha un evento concreto, un grafico e un colpevole. Le manca però il passaggio decisivo: dimostrare che il grafico misuri proprio ciò che gli stiamo facendo dire.
La domanda merita attenzione, perché mette insieme guerra, infrastrutture digitali, propaganda e intelligenza artificiale. Ma il punto interrogativo nel titolo va preso sul serio. Le fonti verificate non dimostrano che gli attacchi a Yandex abbiano stroncato i bot politici attivi in Europa. E una diminuzione del traffico automatizzato non basta a sostenere questa conclusione.
Questi sono fatti documentati. Attribuire a quelle interruzioni la fine di una rete di propaganda europea è invece un’altra affermazione, che richiede altre prove. Un’infrastruttura danneggiata ci dice che qualcosa può aver smesso di funzionare. Non identifica automaticamente le attività coinvolte, i loro responsabili o i loro destinatari.
Yandex e bot politici: la parola che genera l’equivoco
Nel linguaggio comune, “bot russo” richiama un profilo finto che pubblica slogan e amplifica messaggi politici. In una dashboard tecnica, “bot” può indicare tutt’altro. La documentazione di Cloudflare distingue programmi automatizzati con funzioni diverse: ricerca e indicizzazione, raccolta di dati per addestrare modelli e attività di agenti che operano per conto di una persona.
Una parte dell’infrastruttura non comunica normalmente.
La cessazione di tutte le operazioni di influenza.
È come vedere diminuire i furgoni in una strada e concludere che sia finito il contrabbando. Prima bisogna sapere quali furgoni, che cosa trasportavano e dove stavano andando.
Che cosa misurano davvero i grafici Cloudflare
La pagina Cloudflare Radar dedicata ad AS13238, la rete Yandex, riporta traffico e richieste HTTP, con una distinzione fra attività automatizzata e umana. Non è un contatore di post favorevoli all’AfD o ad altri partiti. Inoltre, traffico di una rete e attività di uno specifico crawler sono misure diverse: anche fra grafici tecnici non possiamo cambiare oggetto senza accorgercene.
Per sostenere una tesi politica servirebbero dati sulle piattaforme, sugli account e sui contenuti. Quanti profili sono diventati inattivi? Erano già stati identificati come parte di una campagna coordinata? Quali messaggi pubblicavano? Esiste un collegamento verificato con l’infrastruttura colpita?
Senza queste informazioni, una curva in discesa resta una curva in discesa. Il fatto che compaia il nome di un’azienda russa non le attribuisce un significato politico.
Il grafico sull’AfD non offre una prova affidabile
La distinzione conta: non serve dimostrare come sia stata prodotta un’immagine per riconoscere che non può sostenere una conclusione se mancano dati verificabili e metodo. Un grafico dovrebbe permettere di risalire al dataset, alle definizioni, all’intervallo temporale e al procedimento di analisi. La veste professionale non sostituisce nessuno di questi elementi.
Le operazioni russe di influenza sono documentate, ma non provano questa storia
Un caso concreto compare nel comunicato del Dipartimento di Giustizia degli Stati Uniti del 9 luglio 2024: sequestro di due domini e mandati di perquisizione relativi a 968 account social. Secondo gli atti citati, la rete usava AI per creare false identità e diffondere messaggi favorevoli agli obiettivi del governo russo.
Qui troviamo account, infrastrutture e un’attribuzione motivata. È il tipo di documentazione da cercare. Non dimostra però che quella rete dipendesse dai data center Yandex colpiti nell’ottobre 2026.
Bisogna anche evitare un salto politico: “sovranista” ed “estremista” non sono sinonimi. Un’attività online favorevole a un partito non dimostra che il partito la controlli. E l’esistenza di manipolazioni non autorizza a considerare artificiale tutto il suo consenso. Ogni attribuzione richiede prove specifiche.
Che cosa servirebbe per collegare bombardamenti e bot politici
Per verificare l’ipotesi proporrei cinque controlli:
Definire il campione: quali account, piattaforme, Paesi e movimenti politici?
Motivare la classificazione: perché quei profili sarebbero automatizzati e parte di una rete coordinata?
Documentare l’infrastruttura: quali elementi li collegano ai sistemi colpiti?
Confrontare prima e dopo: con date, fusi orari e criteri di raccolta coerenti.
Verificare spiegazioni alternative: sospensioni degli account, variazioni nella raccolta dei dati, altre interruzioni o cambiamenti nell’attività della campagna.
La contemporaneità renderebbe l’ipotesi interessante. Non basterebbe a dimostrarla. Anche un calo reale di messaggi politici andrebbe spiegato prima di attribuirlo a uno specifico attacco.
Un video per distinguere notizie, opinioni e prove
Per approfondire il metodo, propongo la lezione TED-Ed di Damon Brown How to choose your news. È una risorsa sull’alfabetizzazione ai media, non una prova sul caso Yandex.
Un ottimo esercizio di alfabetizzazione digitale
Porterei questo caso in un laboratorio: un titolo, un grafico e la domanda “quale passaggio non è dimostrato?”. È un esercizio utile anche quando usiamo l’AI per analizzare documenti. Chiederei al chatbot di separare osservazioni, interpretazioni e prove mancanti, poi controllerei ogni riferimento.
Un prompt da provare: “Analizza questa affermazione senza presupporre che sia vera. Identifica il fenomeno misurato, le fonti primarie e le prove necessarie per sostenere il nesso causale. Se un dato manca, segnalalo; non ricostruirlo per plausibilità.”
È un’attività che si può integrare nei miei corsi su AI e comunicazione digitale. L’obiettivo è imparare a formulare domande migliori e a riconoscere quando una risposta convincente ha superato le prove disponibili.
Al 13 ottobre 2026, possiamo parlare di attacchi confermati ai data center Yandex. Possiamo parlare di operazioni russe di influenza documentate. Non possiamo saldare le due cose e annunciare che siano stati stroncati i bot a sostegno dei movimenti estremisti e sovranisti europei.
La disinformazione va verificata anche quando la notizia che la riguarda ci piace. Altrimenti rischiamo di combatterla condividendo un’altra storia non dimostrata.
Vuoi un corso su AI, verifica delle fonti e comunicazione digitale?
Scrivimi per progettare un laboratorio pratico per la tua azienda o il tuo ente.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/yandex-bot-politici-cover-scaled.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-13 12:41:062026-10-28 15:28:02I bombardamenti ai data center di Yandex hanno stroncato i bot che sostengono movimenti estremisti e sovranisti in Europa?
Chiedi a un chatbot un dato che non conosce davvero. Invece di fermarsi, spesso costruisce una risposta plausibile, la rifinisce con tono sicuro e te la consegna come se avesse appena consultato un’enciclopedia. È un problema che chi usa ChatGPT, Gemini, Claude o Copilot incontra prima o poi. Ma la premessa va corretta: i chatbot a volte dicono «non lo so». Il punto è che non riconoscono sempre in modo affidabile quando dovrebbero dirlo.
La spiegazione non è che l’intelligenza artificiale “mente” con intenzione. Dipende da come vengono addestrati i modelli, da come stimano la propria incertezza e da quali risposte i sistemi di valutazione tendono a premiare.
Un chatbot genera la risposta più probabile, non consulta un archivio di fatti verificati
Un modello linguistico di grandi dimensioni (LLM) viene pre-addestrato, in sintesi, a prevedere quale token abbia più probabilità di venire dopo una sequenza di testo. Impara regolarità linguistiche e associazioni dai dati di addestramento, che possono contenere informazioni corrette, errori, contraddizioni e contenuti ormai superati. Questa capacità produce risposte fluenti, ma la probabilità che una frase suoni coerente non coincide con la probabilità che sia vera.
Nel rapporto tecnico di GPT-4, OpenAI descrive proprio questa differenza: il pre-addestramento insegna a prevedere la continuazione del testo; il post-addestramento, incluso il reinforcement learning from human feedback (RLHF), orienta il modello a seguire meglio le istruzioni e a comportarsi da assistente. Non significa però che il chatbot acquisisca un rilevatore infallibile della verità o un accesso diretto a una banca dati completa e aggiornata.
Cosa succede durante l’addestramento
Dopo il pre-addestramento, una fase di fine-tuning supervisionato può mostrare al modello esempi di conversazioni desiderabili. In seguito, valutatori umani possono confrontare più risposte e indicare quali preferiscono; un modello di ricompensa e tecniche di ottimizzazione come RLHF aiutano a rendere più probabili le risposte giudicate migliori. I dettagli cambiano tra fornitori e modelli, e spesso non sono pubblici: non esiste una ricetta unica per tutti i chatbot.
Qui nasce un compromesso delicato. Una risposta dettagliata, diretta e ben scritta può apparire più utile di un rifiuto o di una dichiarazione d’incertezza. Ma una risposta cauta può essere la scelta giusta se mancano dati. Nel post che presentava ChatGPT, OpenAI indicava esplicitamente tre difficoltà: durante l’RLHF non c’è sempre una fonte di verità con cui confrontare la risposta; addestrare il modello a essere più prudente può indurlo a rifiutare anche domande a cui saprebbe rispondere; e l’esempio scritto da un dimostratore umano può non riflettere ciò che il modello stesso conosce.
In più, un modello non possiede necessariamente una stima ben calibrata della propria competenza. Può avere appreso un fatto ma non sapere di saperlo, oppure produrre una risposta sicura senza basi sufficienti. Il tono è parte della generazione linguistica, non un certificato di accuratezza.
Cosa dicono gli studi sulle risposte sbagliate e sull’incertezza
Nel 2022, Stephanie Lin, Jacob Hilton e Owain Evans hanno presentato TruthfulQA, un benchmark di 817 domande in 38 categorie, progettato per far emergere risposte che ripetono convinzioni errate diffuse. Nei modelli testati allora, il migliore era veritiero nel 58% delle risposte, contro il 94% ottenuto dalle persone. Sono risultati di modelli di quel periodo, non una classifica degli assistenti disponibili oggi; mostrano però perché imitare il testo umano non basta per distinguere un fatto da un luogo comune falso.
La difficoltà di stimare l’incertezza è stata studiata anche da Zhengbao Jiang e colleghi in una ricerca pubblicata su Transactions of the Association for Computational Linguistics. Esaminando T5, BART e GPT-2 in compiti di domanda e risposta, gli autori hanno rilevato che le probabilità dei modelli non erano ben calibrate rispetto alla correttezza. In altre parole, una maggiore sicurezza numerica non corrispondeva in modo affidabile a una maggiore probabilità di avere ragione.
Un lavoro di Anthropic del 2022, “Language models (mostly) know what they know”, ha mostrato che alcuni modelli possono stimare se una risposta proposta sia corretta e che è possibile addestrarli a stimare la probabilità di “sapere” la risposta. Gli autori hanno però rilevato difficoltà di calibrazione quando la stima viene trasferita a compiti nuovi. Quindi la metacognizione artificiale è possibile, ma non si attiva come un interruttore universale.
Nel 2024, un articolo pubblicato agli atti dell’Association for Computational Linguistics ha studiato come identificare le lacune di conoscenza e astenersi dal rispondere. Gli approcci di collaborazione tra modelli hanno migliorato, in alcuni esperimenti, l’accuratezza dell’astensione fino al 19,3% rispetto alla baseline più forte. È una prova che si può insegnare ai sistemi a fermarsi meglio, ma anche che l’autovalutazione del singolo modello non sempre basta.
Un’analisi pubblicata su Nature nel 2026 aggiunge un punto sugli incentivi: se un benchmark premia soprattutto le risposte corrette e penalizza l’astensione, i modelli e i team che li sviluppano ricevono una spinta a indovinare. In uno studio con quattro modelli di frontiera, gli autori mostrano come cambiano le risposte quando la valutazione riconosce il valore del «non lo so». La metrica scelta può dunque influenzare il comportamento che si cerca di migliorare.
Come ottenere risposte più oneste: cinque rimedi pratici
Imposta una regola di astensione. Scrivi: «Se non hai elementi sufficienti, dichiaralo. Non completare i vuoti con ipotesi presentate come fatti».
Fornisci le fonti e delimita il perimetro. Per un documento o una procedura, allega il testo e chiedi di rispondere solo sulla base di quel materiale, indicando il passaggio che sostiene ogni affermazione. Chiedi esplicitamente di segnalare ciò che non è presente nei documenti.
Separa fatti, inferenze e informazioni mancanti. Chiedi tre sezioni distinte: “documentato”, “dedotto” e “non verificabile con i dati disponibili”. Questa struttura rende più visibili i salti logici.
Per i fatti aggiornati, attiva ricerca e fonti primarie. Specifica una data di riferimento e chiedi link a leggi, documentazione ufficiale, paper o pagine istituzionali. Un modello senza ricerca web non può verificare un cambiamento recente solo perché gli viene chiesto di farlo.
Controlla le affermazioni importanti fuori dalla chat. Un secondo modello può aiutare a individuare incongruenze, ma può condividere gli stessi errori. Per decisioni professionali o dati rilevanti, verifica la fonte originale o usa uno strumento deterministico, e chiedi una revisione umana quando il rischio lo giustifica.
Prompt da riutilizzare:
Rispondi usando solo le informazioni supportate dalle fonti che ti fornisco o che puoi verificare. Per ogni affermazione fattuale importante indica la fonte e il passaggio rilevante. Distingui i fatti dalle inferenze. Se i dati non bastano, scrivi chiaramente «non lo so con le informazioni disponibili» e indica quale elemento servirebbe per rispondere. Non inventare citazioni o riferimenti.
La frase «dimmi quanto sei sicuro» può aiutare a capire dove il chatbot avverte un dubbio, ma non va presa come una misura oggettiva: gli studi sulla calibrazione mostrano che le stime di confidenza possono essere inaffidabili, soprattutto in domini o compiti diversi da quelli su cui sono state valutate.
Per chi progetta un assistente: misurare anche quando si ferma
Un sistema affidabile non dovrebbe essere valutato soltanto sul numero di risposte corrette. Serve misurare anche quante volte risponde quando le prove sono insufficienti, quante volte si astiene a torto e quanto rischio rimane tra le risposte che ha scelto di dare. In letteratura questo compromesso viene spesso descritto come selezione tra copertura e rischio: rispondere a meno domande può abbassare gli errori, ma l’astensione deve essere mirata e utile.
In un assistente aziendale, si può restringere la risposta alle fonti approvate, collegare il sistema a documenti aggiornati, mostrare i riferimenti, impostare soglie di escalation e passare a una persona i casi incerti o ad alto impatto. Il lavoro ACL sulla collaborazione tra modelli e il recente studio su Nature indicano entrambi che astensione ed evidenze vanno progettate e valutate, non affidate a una formula magica nel prompt.
Un video utile per approfondire
Adam Kalai dell’Institute for Advanced Study spiega perché l’addestramento e i criteri di valutazione possono incoraggiare i modelli a indovinare invece di astenersi.
Domande frequenti
I chatbot mentono quando inventano una risposta?
Di norma non nel senso umano di mentire con un’intenzione consapevole. Generano testo plausibile senza garantire che ogni affermazione sia verificata. Per questo si parla di allucinazione o confabulazione.
Chiedere «dimmi se non lo sai» risolve il problema?
Può ridurre alcune risposte inventate, soprattutto se si forniscono fonti e si chiarisce quando astenersi. Non garantisce però che il modello riconosca tutti i propri limiti: le istruzioni migliorano il comportamento, non trasformano la stima di sicurezza in una verifica infallibile.
Qual è il modo più sicuro di usare un chatbot per una ricerca?
Usalo per orientarti, organizzare domande e confrontare ipotesi; chiedi evidenze verificabili; controlla i riferimenti nelle fonti originali. Per informazioni recenti usa ricerca web e indica la data. Per decisioni ad alto impatto, non delegare il controllo finale al chatbot.
La risposta migliore a volte è fermarsi
Un assistente utile non è quello che riempie ogni silenzio. È quello che sa distinguere una risposta sostenuta dai dati da un’ipotesi ben confezionata, e che rende visibile la differenza. Fino a quando questa capacità non sarà abbastanza affidabile, la regola pratica resta semplice: chiedi prove, fornisci contesto e verifica ciò che conta.
Se stai progettando un corso, un assistente AI o un percorso di formazione su questi temi, raccontami il tuo progetto.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/non-lo-so-ai.png470836Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-13 09:20:522026-10-28 15:28:02Perché i chatbot non dicono «non lo so»? Addestramento, studi e rimedi
Per anni la domanda è stata: l’intelligenza artificiale sa scrivere una riga di codice? Oggi la domanda è diventata più scomoda: può aiutare una persona a costruire un prodotto software intero, abbastanza buono da mettere in discussione il modello di business di chi vende software?
La notizia di Tom’s Hardware Italia parla di un singolo sviluppatore che avrebbe ricostruito l’intera suite Adobe con Claude e l’avrebbe pubblicata gratis. È una storia perfetta per i titoli e per LinkedIn: un uomo, un’intelligenza artificiale, sette software e un colosso alle corde. Ma il fact checking racconta una vicenda più interessante, e meno cinematografica.
Che cosa è successo davvero: sette progetti, non una nuova Creative Cloud
Un flusso creativo passa sempre più spesso da applicazioni che dialogano con l’AI. Foto di litoon dev via Unsplash.
Il progetto si chiama ArtCraft. Il suo gruppo ha pubblicato sette applicazioni open source: PhotoCraft per l’editing delle immagini, VectorCraft per la grafica vettoriale, FilmCraft per il video, LightCraft per lo sviluppo fotografico, EffectCraft per gli effetti, DesignCraft per l’impaginazione e PdfCraft per lavorare con i PDF. Sono riscritture in Rust, dichiarate “clean room”, cioè realizzate senza copiare il codice sorgente Adobe. Non sono prodotti Adobe e non sono una suite integrata che oggi sostituisce senza attriti Creative Cloud.
La distinzione conta. Il repository di PhotoCraft documenta la compatibilità con file PSD, livelli, maschere e comandi richiamabili anche da riga di comando, JSON e MCP. È una direzione molto interessante: software progettato per essere usato sia da persone sia da agenti AI. Ma la pagina di stima della parità funzionale è un’autovalutazione del progetto, non una verifica indipendente. Dichiara il 100% di copertura dei menu di Photoshop, ma circa il 65% di corrispondenza visiva nei file PSD di test e stima all’86% la parità funzionale per i flussi di lavoro principali. La stessa pagina segnala lacune e approssimazioni, soprattutto nelle funzioni AI e nei casi complessi.
Perciò “ha ricostruito tutta Adobe” è una formula giornalistica, non una descrizione tecnica precisa. Il risultato non è irrilevante: in pochi giorni un progetto piccolo ha messo sul tavolo una base software ampia, aperta e agent-ready. Ma non equivale ancora a Photoshop, Premiere, Illustrator, InDesign, Acrobat e Lightroom maturi, testati, accessibili e interoperabili come gli strumenti professionali Adobe.
Un primo sguardo alle applicazioni ArtCraft, nel video del canale FUTC.
Il fact checking: quali affermazioni reggono?
Affermazione
Esito del controllo
È stato creato un insieme di alternative open source ai prodotti Adobe
Sì: i repository ArtCraft elencano sette applicazioni distinte, scritte in Rust.
Claude ha generato da solo una suite pronta a sostituire Adobe
Non dimostrato. Il progetto è attribuito a uno sviluppatore esperto assistito dall’AI; la parità dichiarata è parziale e auto-valutata.
Le applicazioni sono gratuite e open source
I repository indicano licenze MIT e Apache-2.0. Questo non certifica da solo qualità, sicurezza o sostenibilità.
PhotoCraft apre e salva file PSD
Il repository lo dichiara e descrive test su un corpus di file. La fedeltà documentata è incompleta.
I programmatori hanno una probabilità bassa di essere sostituiti
Dipende dalla metrica. Will Robots Take My Job mostra un rischio calcolato più basso del voto degli utenti, ma le sue categorie e stime non sono una profezia sul singolo lavoratore.
Anche il ruolo di Claude va descritto con precisione. Anthropic presenta Claude Opus 5.5 come un modello capace di affrontare attività di coding agentico e lavori lunghi su basi di codice. Questo rende plausibile che possa contribuire in modo sostanziale a un progetto software. Non consente però di concludere che abbia progettato, implementato, verificato e mantenuto in autonomia un prodotto complesso: repository, scelte architetturali, test e correzioni sono il risultato di un processo umano e tecnico più ampio.
È SaaSmageddon? Sì, ma il bersaglio è il modello economico
“SaaSmageddon” è un’etichetta efficace per descrivere la paura che l’AI renda superflui molti software in abbonamento. Il caso ArtCraft, da solo, non dimostra un’imminente fine del SaaS. Mostra però un cambiamento potenzialmente più profondo: il costo per costruire una prima versione di un software specializzato può scendere, mentre le interfacce e le funzioni diventano sempre più facili da delegare a un agente.
Per Adobe non conta solo la lista delle funzioni. Un professionista paga anche per affidabilità, aggiornamenti, compatibilità, prestazioni, collaborazione, assistenza, ecosistema di plugin e continuità dei flussi di lavoro. Un clone può replicare molti comandi; replicare anni di abitudini, formati, integrazioni e responsabilità operative è un’altra cosa. Adobe stessa vende Creative Cloud come un ecosistema di app, servizi e funzioni generative, non come una collezione di pulsanti. I piani Creative Cloud confermano inoltre quanto l’abbonamento sia un elemento centrale della proposta commerciale.
Il rischio per le aziende SaaS, allora, non è necessariamente che domani un solo sviluppatore faccia sparire un gigante. È che un utente chieda a un agente di svolgere il lavoro senza dover imparare o aprire tutte le applicazioni. Se l’agente può ritagliare immagini, impaginare un PDF, montare un video e trasferire i risultati tra strumenti, l’interfaccia software potrebbe diventare meno importante del servizio che risolve il problema. È lì che il modello “paghi ogni mese per usare questa applicazione” potrebbe dover cambiare.
E i programmatori? Perché Will Robots Take My Job sembra rassicurante
Il coding assistito dall’AI cambia le attività di sviluppo, con risultati che dipendono dal contesto. Foto di Mahmudul Hasan via Unsplash.
Qui c’è una piccola sorpresa. La pagina Computer Programmers di Will Robots Take My Job, consultata il 9 ottobre 2026, riporta un rischio calcolato del 36%, classificato “Low Risk”, ma il voto degli utenti arriva al 78%, “High Risk”. Non è quindi corretto dire semplicemente che il sito assegna ai programmatori una bassa probabilità di sostituzione. La stima modellata è più contenuta; il sondaggio partecipativo è molto più pessimista.
Lo stesso sito spiega che il suo punteggio tenta di stimare la sostituzione end-to-end di un’intera occupazione e non prevede che ogni persona perderà il lavoro entro una certa data. Inoltre, “computer programmer” è una categoria professionale ristretta: O*NET la descrive soprattutto come scrittura, modifica, test e manutenzione del codice sulla base di specifiche. I software developer, invece, analizzano bisogni, progettano soluzioni, definiscono requisiti e coordinano test e sviluppo. Nel linguaggio comune chiamiamo tutti “programmatori”, ma i lavori non sono identici.
Un dato ufficiale statunitense aggiunge un’altra sfumatura: il Bureau of Labor Statistics prevede per i computer programmers una diminuzione occupazionale del 6% tra 2024 e 2034 e cita l’automazione di compiti ripetitivi, anche tramite AI. Per software developer, quality assurance analyst e tester, invece, la previsione pubblicata è di crescita del 10% tra 2025 e 2035. Le categorie e i periodi di riferimento sono diversi, quindi non vanno confrontati come se fossero la stessa professione. Ma il segnale è chiaro: automatizzare parte della programmazione non significa automaticamente eliminare ogni ruolo coinvolto nello sviluppo software.
La ricerca non dà una risposta unica. Uno studio randomizzato di METR su 16 sviluppatori open source esperti e 246 attività, svolto con strumenti AI del 2025, ha rilevato un aumento medio dei tempi del 19% in quel contesto specifico. Al contrario, tre esperimenti sul campo con 4.867 sviluppatori Microsoft, Accenture e di una società Fortune 100, pubblicati su *Management Science*, hanno osservato un aumento medio del 26% nei compiti completati con assistenti di coding. Campioni, strumenti, attività e ambienti differiscono: nessuno dei due risultati autorizza a proclamare che l’AI renda sempre i programmatori più veloci o li sostituisca.
L’Organizzazione Internazionale del Lavoro invita a ragionare sulle mansioni che compongono le professioni. Nel suo aggiornamento del 2025, stima che un lavoratore su quattro nel mondo operi in un’occupazione con qualche grado di esposizione alla GenAI, ma considera più probabile la trasformazione dei lavori che la loro completa eliminazione. Anche l’Anthropic Economic Index distingue tra automazione di singoli compiti e uso dell’AI per affiancare una persona: sono fenomeni diversi, spesso confusi nel dibattito pubblico.
La domanda scomoda non è “l’AI scrive codice?”
Il progetto ArtCraft mette in scena un paradosso: l’AI aiuta a costruire strumenti che possono automatizzare lavoro creativo e produttivo, ma per ora il salto di qualità arriva perché qualcuno sa che cosa costruire, conosce il linguaggio Rust, controlla il risultato e decide quali compromessi accettare. L’esperienza del programmatore non sparisce dal processo: cambia il punto in cui crea valore.
La domanda utile diventa: quante persone serviranno per realizzare e mantenere software che prima richiedeva un team più ampio? E quante attività di sviluppo diventeranno accessibili a professionisti che non si definiscono programmatori? Il rischio non è solo che l’AI prenda il posto di chi scrive codice. È anche che cambi il prezzo, i tempi e le competenze necessarie per trasformare un’idea in un prodotto.
È qui che il SaaSmageddon smette di essere una previsione apocalittica e diventa una domanda di strategia: se un agente può usare le applicazioni al posto mio, continuerò a pagare per l’applicazione, per l’agente, per il risultato o per l’intero flusso di lavoro? Adobe e le altre aziende software dovranno rispondere con prodotti più integrati, affidabili e capaci di collaborare con agenti. Gli sviluppatori dovranno spostare parte del proprio valore dal digitare codice al capire requisiti, architetture, sicurezza, test e conseguenze.
Non siamo davanti alla prova che Claude abbia già rifatto Adobe. Siamo davanti a un esperimento pubblico che riduce la distanza tra idea e software utilizzabile. Per chi scrive codice, il rischio calcolato da un sito può anche apparire “basso”; per chi vende software, la domanda è più urgente: quanto vale un’applicazione quando un agente può costruirne una versione su misura, e quanto vale ancora quando quella versione funziona davvero?
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/saasmageddon-scaled.png9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-09 16:21:002026-10-28 15:28:02Claude può rifare Adobe? SaaSmageddon e futuro dei programmatori
Davanti a una torta il nostro organismo non consulta il calendario delle prossime carestie. E davanti a un chatbot che produce un rapporto in pochi secondi, il nostro ufficio non si trasforma automaticamente in un’organizzazione capace di usarlo bene. Mi interessa questo possibile filo comune: cambiano gli ambienti, ma alcuni comportamenti continuano a funzionare secondo logiche che appartengono a un altro contesto.
Da qui una provocazione: stiamo vivendo un disallineamento evolutivo di fronte all’intelligenza artificiale? Abbiamo costruito strumenti velocissimi, ma li inseriamo in giornate, procedure e aspettative progettate per un lavoro diverso. È una domanda che nasce dalle riflessioni di Telmo Pievani sul mismatch. Il passaggio all’AI che propongo in questo articolo è una mia interpretazione, non una teoria scientifica che attribuisco a lui.
Che cos’è il disallineamento evolutivo
Il termine inglese è evolutionary mismatch. Indica una discrepanza tra le condizioni nelle quali si sono formati determinati tratti e un ambiente successivo nel quale quegli stessi tratti possono avere conseguenze sfavorevoli. Non significa che l’evoluzione abbia sbagliato progetto: la selezione naturale non anticipa il futuro e non ottimizza gli organismi per ogni ambiente possibile.
La revisione Applying an evolutionary mismatch framework to understand disease susceptibility, pubblicata da Amanda J. Lea e colleghi su PLOS Biology nel 2023, discute questa cornice e le prove necessarie per sostenerla. Il quadro riguarda le interazioni tra storia evolutiva, caratteristiche degli organismi e trasformazioni ambientali. Gli autori distinguono la plausibilità di una spiegazione dalle evidenze che consentono di verificarla.
È una distinzione decisiva anche per parlare di digitale. Una storia affascinante sul nostro passato non basta a spiegare ogni comportamento presente. Se qualsiasi abitudine può diventare, a posteriori, una strategia di sopravvivenza dei nostri antenati, abbiamo costruito un racconto troppo comodo da mettere alla prova.
Grassi, zuccheri e carestie: l’esempio funziona, con qualche cautela
In un ambiente nel quale procurarsi energia richiede fatica e la disponibilità di cibo è incerta, mangiare alimenti energetici e disporre di riserve può essere vantaggioso. In un ambiente che rende accessibili molte calorie, quella stessa logica può contribuire a un problema. È il passaggio dalla scarsità all’abbondanza che rende intuitiva l’idea di mismatch.
Ma la formula “siamo programmati per ingurgitare tutto perché un tempo non sapevamo quando avremmo mangiato” comprime questioni diverse: preferenze alimentari, regolazione dell’appetito, deposito di energia e storia genetica. Non è una spiegazione completa dell’obesità, né consente di attribuire a tutte le popolazioni un identico passato alimentare.
La revisione di Layla Brassington, Audrey M. Arner e colleghi, pubblicata nel 2024 su Evolution, Medicine, and Public Health, ricostruisce l’ipotesi del “genotipo parsimonioso” proposta da James Neel nel 1962: varianti favorevoli all’accumulo energetico sarebbero state vantaggiose durante la scarsità e sfavorevoli in ambienti industriali. Gli autori ne discutono le critiche e considerano ancora irrisolta la sua applicabilità. Richiamano anche la complessità delle interazioni tra geni, ambiente e stile di vita.
Quindi possiamo usare l’esempio del cibo per capire il meccanismo, senza trasformarlo in una sentenza universale sulla nostra biologia. La prudenza diventa ancora più necessaria quando passiamo dalla nutrizione a un software.
Telmo Pievani: il mondo cambia e la mente deve riadattarsi
Nel suo intervento Schiavi dei social? È tutta colpa della mancanza d’immaginazione…, pubblicato su Style il 21 febbraio 2026, Pievani collega la ricerca di gratificazioni immediate alle pressioni del passato evolutivo e osserva che gli algoritmi possono approfittarne. La riflessione riguarda anche la difficoltà di investire in benefici lontani nel tempo. Pievani, però, richiama la capacità umana di immaginare il futuro e cooperare: la storia evolutiva non rende inevitabili le nostre scelte.
Trovo feconda questa prospettiva perché evita di immaginare la tecnologia come un meteorite arrivato dall’esterno. La creiamo noi. Eppure questo non garantisce che ogni individuo, istituzione o gruppo sappia governarne subito gli effetti. Chi inventa una macchina, chi la vende, chi la usa e chi ne subisce le conseguenze possono avere competenze e interessi diversi.
Il mio video sugli algoritmi predatori
Avevo già affrontato il tema nel video Telmo Pievani e gli algoritmi predatori. Lo ripropongo come punto di partenza per questa riflessione: prima gli algoritmi che selezionano ciò che vediamo, oggi anche i sistemi che producono ciò che leggiamo e scriviamo. Sono funzioni diverse, da non confondere, ma entrambe ci chiedono di riflettere su come distribuiamo attenzione e fiducia.
AI e disallineamento evolutivo: dove regge il parallelo
La somiglianza che propongo riguarda il rapporto tra capacità e ambiente. Nel caso alimentare discutiamo di organismi esposti a condizioni nuove. Nel caso dell’AI osserviamo persone e organizzazioni che devono imparare a lavorare con strumenti nuovi. I due fenomeni non sono scientificamente equivalenti.
Scrivere una mail da zero o seguire una procedura amministrativa non sono adattamenti biologici nello stesso senso della fisiologia metabolica. Sono anche pratiche apprese, modificabili con formazione, organizzazione e progettazione. Chiamare tutto “evolutivo” rischierebbe di rendere naturali e inevitabili problemi che possiamo correggere molto più rapidamente.
Per questo distinguerei tre livelli:
Biologico: la storia evolutiva e i limiti dell’organismo. Non basta osservare un impiegato affaticato per dimostrare un mismatch evolutivo.
Cognitivo: come distribuiamo lo sforzo, valutiamo una risposta e decidiamo quando fidarci. Qui possiamo studiare comportamenti specifici.
Organizzativo: procedure, responsabilità, incentivi e volumi di lavoro. Un documento generato in pochi secondi può arrivare a una filiera di approvazione rimasta identica.
La provocazione del titolo abbraccia questi livelli. Per il lavoro quotidiano, l’espressione più precisa è spesso disallineamento cognitivo e organizzativo. Non sto diagnosticando alla specie umana una nuova patologia evolutiva.
Gli studi: l’AI accelera alcuni compiti, non l’intero lavoro
Shakked Noy e Whitney Zhang hanno studiato compiti di scrittura professionale in un esperimento con 453 professionisti con istruzione universitaria. Nel loro articolo pubblicato su Science nel 2023, l’uso di ChatGPT ha ridotto mediamente il tempo impiegato del 40% e migliorato la qualità valutata del 18%. È disponibile anche una versione precedente del lavoro sul sito del MIT.
Quei risultati riguardano attività e condizioni specifiche. Non dimostrano che ogni lavoratore possa produrre il 40% in meno di ore, né che le fasi successive alla scrittura diventino automaticamente più rapide.
Un altro esperimento, Navigating the Jagged Technological Frontier, di Fabrizio Dell’Acqua e colleghi, evidenzia una “frontiera frastagliata”. Nei compiti entro le capacità dell’AI, i partecipanti assistiti hanno completato più attività e lavorato circa il 25% più rapidamente. In un compito complesso oltre quella frontiera, l’accesso all’AI ha invece ridotto di 19 punti percentuali la probabilità di una soluzione corretta. Gli autori sottolineano che il risultato negativo riguarda un singolo compito esterno alla frontiera.
È una lezione utile: la velocità non permette di sapere se siamo nel territorio in cui lo strumento ci aiuta. Per decidere serve conoscere il compito, i criteri di qualità e gli errori possibili.
La fiducia può cambiare lo sforzo di verifica
Il paper di Hao-Ping Lee e colleghi, The Impact of Generative AI on Critical Thinking, presentato a CHI 2025, analizza un’indagine su 319 lavoratori della conoscenza. Una maggiore fiducia nell’AI risulta associata a minore esercizio dichiarato del pensiero critico. Gli autori descrivono anche lo spostamento di alcune attività verso verifica, integrazione delle risposte e supervisione del lavoro.
Si tratta di autovalutazioni e associazioni, non di un esperimento che dimostri un declino permanente dell’intelligenza. Il risultato aiuta però a formulare una domanda pratica: quando il sistema sembra competente, continuiamo a controllarlo con la stessa attenzione?
Il problema ha precedenti. La revisione sistematica di Kate Goddard, Abdul Roudsari e Jeremy C. Wyatt, pubblicata nel 2012 sul Journal of the American Medical Informatics Association, esamina l’automation bias, cioè la tendenza a fare eccessivo affidamento sull’automazione. È ricerca precedente ai chatbot generativi e non autorizza a trasferire automaticamente tutti i risultati a ChatGPT. Mostra, tuttavia, che la difficoltà di sorvegliare un sistema automatico non nasce con gli LLM.
Il rischio di un’abbuffata di contenuti
Nel parallelo alimentare c’è un’immagine che mi sembra particolarmente utile: l’abbuffata. Se produrre diventa semplice, possiamo finire per generare più documenti di quanti ne servano. Una bozza diventa cinque versioni, una riunione genera verbale e rapporto, un’idea si trasforma in trenta slide. È uno scenario possibile, non una misura dell’attuale uso dell’AI nelle aziende.
Lo studio Accelerating dynamics of collective attention, pubblicato da Philipp Lorenz-Spreen e colleghi su Nature Communications nel 2019, analizza l’attenzione collettiva in diversi ambiti e rileva dinamiche più rapide e periodi di attenzione più brevi. Il modello collega queste dinamiche alla crescita di produzione e consumo di contenuti. Non misura la capacità individuale di concentrazione e precede l’attuale diffusione dell’AI generativa.
La mia inferenza è questa: se aumentiamo la produzione senza decidere cosa merita di essere prodotto, possiamo spostare il costo sui destinatari. Io risparmio tempo scrivendo. Tu lo spendi leggendo. L’organizzazione celebra l’efficienza del mittente e dimentica il lavoro del ricevente.
Immaginiamo, come esempio ipotetico, un responsabile che chieda dieci proposte commerciali dove prima ne chiedeva due. La stesura accelera, ma la selezione, la verifica dei prezzi e la decisione restano aperte. La sensazione di produttività potrebbe nascondere una coda più lunga di materiale da controllare.
Leggere con calma non è un difetto da correggere
Qui mi permetto di mettere in discussione una parte della provocazione iniziale. Il fatto che una macchina scriva velocemente non rende obsolete la lettura lenta, la riflessione o la risposta ponderata. Per alcuni compiti, sono esattamente le capacità che vogliamo preservare.
Il disallineamento emerge quando trattiamo allo stesso modo attività diverse: mezz’ora per una conferma logistica ripetitiva e pochi secondi per approvare un documento con conseguenze importanti. Adattarsi significa distribuire meglio l’attenzione, scegliere cosa delegare e riconoscere ciò che richiede ancora un giudizio approfondito.
Vorrei che l’AI liberasse tempo anche per lavorare con calma. Se ogni minuto risparmiato diventa automaticamente un’altra richiesta, abbiamo trasformato un’opportunità in una pressione aggiuntiva. Questa è una scelta di gestione, non un destino scritto nei nostri geni.
Come ridurre il disallineamento nel lavoro quotidiano
Propongo cinque interventi da sperimentare, misurando sia il tempo sia la qualità:
Riprogettare un processo intero. Per esempio, dalla richiesta del cliente alla risposta finale: quali informazioni mancano, quali passaggi sono ripetitivi, chi verifica e chi decide? Inserire il chatbot soltanto nella stesura può lasciare intatti tutti gli altri colli di bottiglia.
Definire il prodotto minimo utile. Una risposta breve, una raccomandazione motivata o una tabella possono essere sufficienti. Prima di chiedere venti pagine, chiarire quale decisione devono rendere possibile.
Graduare la delega. Distinguere la proposta di un testo dalla sua pubblicazione, e la preparazione di una risposta dal suo invio. Fissare controlli e responsabilità in base alle conseguenze dell’errore.
Proteggere il tempo di verifica. Definire in anticipo quali dati, fonti, calcoli e impegni devono essere controllati. Chiedere a un chatbot di ricontrollarsi può aiutare, ma non sostituisce il confronto con documenti e fonti indipendenti.
Valutare l’esito complessivo. Confrontare tempo totale, correzioni necessarie, errori, utilità per il destinatario e lavoro trasferito ai colleghi. Il numero di contenuti generati, da solo, è un indicatore povero.
Chi vuole esercitarsi nella formulazione delle istruzioni può partire dalla mia raccolta di prompt ed esercizi di prompt engineering. Suggerisco di affiancare alla scrittura dei prompt anche l’analisi dei processi: chiedere meglio è utile, sapere perché e quando chiedere lo è altrettanto.
Un prompt per individuare i colli di bottiglia
Agisci come un analista dei processi. Ti descrivo un’attività ricorrente e i suoi passaggi.

Obiettivo: individuare dove l’AI generativa può aiutare e dove servono attenzione e giudizio umano.

Per ogni passaggio indica:
1. risultato necessario e destinatario;
2. informazioni richieste;
3. possibile supporto dell’AI;
4. errori plausibili e loro conseguenze;
5. controllo umano e responsabile;
6. indicatore per confrontare il processo attuale e quello modificato.

Non inventare tempi, risparmi o dati mancanti. Distingui i fatti che ti fornisco dalle ipotesi. Proponi un esperimento limitato e reversibile. Considera anche il carico di lettura e verifica dei destinatari. Non proporre invii o pubblicazioni automatici senza una regola esplicita di autorizzazione.

Processo: [descrizione e vincoli]
Adattarci significa anche cambiare l’ambiente che abbiamo creato
Le riflessioni di Pievani mi suggeriscono di guardare all’AI attraverso il rapporto tra persone e ambiente. Il risultato dipenderà anche dalle interfacce, dalle aspettative dei dirigenti e dalle procedure con cui decidiamo che cosa conta come buon lavoro.
Possiamo scegliere di riempire la giornata di output oppure usare gli strumenti per ridurre il lavoro superfluo, confrontare alternative e dedicare più attenzione alle decisioni. La prima strada mi sembra una versione digitale della dispensa sempre piena: consumare diventa facile, scegliere resta impegnativo.
La provocazione, allora, è questa: siamo pronti a lavorare diversamente, oltre che a produrre più velocemente? Non dobbiamo aspettare che cambi il nostro patrimonio genetico per rispondere. Possiamo iniziare da una mail, una riunione, una procedura e dal criterio con cui giudichiamo se siano state davvero utili.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
Immaginiamo una scena molto concreta: un dipendente carica in ChatGPT un contratto con un cliente, un altro incolla il verbale di una riunione, un terzo chiede di analizzare un foglio con stipendi e nominativi. Tutti stanno cercando di lavorare meglio. Ma chi ha deciso quali dati possono uscire dall’azienda, attraverso quale account e con quali garanzie?
Quando mi chiedono quale abbonamento renda sicuro ChatGPT in azienda, parto da qui. Per l’uso quotidiano di informazioni riservate, gli account personali Free e Plus non sono la soluzione organizzativa che consiglierei. Business offre protezioni e gestione aziendale; Enterprise aggiunge controlli più articolati. La residenza europea richiede però una verifica separata. E nessun piano autorizza a caricare qualsiasi documento senza valutare il caso d’uso.
Condizioni e documentazione verificate l’8 ottobre 2026. Le funzionalità possono cambiare e dipendono da disponibilità, contratto e configurazione dell’area di lavoro.
ChatGPT e dati aziendali: cinque domande prima dell’abbonamento
“I dati sono protetti” è una frase troppo generica per prendere una decisione. Io la tradurrei in cinque domande:
Addestramento: prompt, allegati e risposte possono essere usati per migliorare i modelli?
Accesso: chi può entrare nell’account, condividere documenti o collegare altri servizi?
Conservazione: quali copie restano, per quanto tempo e come si eliminano?
Localizzazione: dove sono archiviati i contenuti e dove vengono elaborati?
Responsabilità: chi ha approvato questo trattamento e verificato contratto, finalità e rischi?
Sono domande diverse. Spegnere l’addestramento risponde alla prima. Non risolve automaticamente le altre quattro.
Perché Free e Plus personali non bastano per l’azienda
Prima una precisazione: non sarebbe corretto scrivere che ChatGPT gratuito è sempre vietato in ufficio, o che ogni uso di Plus viola il GDPR. Preparare una scaletta con informazioni pubbliche è diverso dal caricare il database dei clienti. La mia raccomandazione riguarda la gestione sistematica di dati aziendali riservati e personali.
Nelle regole ufficiali sull’uso dei dati per migliorare i modelli, OpenAI distingue servizi individuali e servizi aziendali. Per quelli individuali è possibile disattivare “Improve the model for everyone”, in italiano “Migliora il modello per tutti”, da Impostazioni e Controlli dei dati. Dopo la rinuncia, le nuove conversazioni non vengono usate per migliorare i modelli. La documentazione segnala anche un’eccezione: inviando volontariamente feedback su una risposta, la conversazione associata può essere utilizzata per l’addestramento.
È un controllo utile. Pagare Plus, però, non trasforma un account personale in un’area di lavoro aziendale gestita. Lo stesso ragionamento vale per Pro personale: capacità e limiti di utilizzo non equivalgono a una diversa governance dell’azienda.
Se l’organizzazione affida tutto alle impostazioni del singolo, deve anche affidarsi alla sua memoria: selezionare l’account giusto, non attivare condivisioni inappropriate, non collegare app non autorizzate, gestire l’uscita dall’azienda. Il costo nascosto è questa frammentazione. Avevo già affrontato il problema nel mio decalogo sul Bring Your Own AI.
Per sperimentazioni con dati pubblici o davvero anonimizzati, un piano personale può avere senso se la policy lo consente. Per contratti riservati, dati HR e documenti dei clienti, proporrei un ambiente aziendale approvato e una procedura documentata.
Che cosa offre ChatGPT Business per proteggere i dati
Secondo le FAQ ufficiali di ChatGPT Business, il piano offre un’area di lavoro condivisa per il team, fatturazione centralizzata e controlli amministrativi. Si applicano i termini aziendali e gli impegni di privacy enterprise. L’area di lavoro richiede almeno due licenze a pagamento.
Esclusione dall’addestramento per impostazione predefinita dei dati dell’organizzazione.
Cifratura dei dati a riposo con AES-256 e in transito con TLS 1.2 o superiore.
Ruoli Member, Admin e Owner, per distinguere utenti e amministratori.
Autenticazione a più fattori e SAML SSO, cioè accesso tramite il sistema di identità dell’organizzazione.
Controlli sui GPT di terze parti e statistiche di base sull’utilizzo.
La guida alla privacy e alla condivisione in Business chiarisce inoltre che gli altri membri non vedono automaticamente tutte le chat di un collega. Un ambiente collaborativo non significa che ogni conversazione sia visibile a tutto l’ufficio.
Per una PMI, Business è quindi una base da valutare seriamente per l’adozione quotidiana, purché i dati e i processi siano compatibili con le condizioni del servizio. Va configurato: nominare amministratori, gestire gli accessi, scegliere gli strumenti consentiti e spiegare alle persone come usarli.
La cifratura, da sola, non impedisce a un utente autorizzato di condividere il documento sbagliato. Inoltre, cifratura a riposo e in transito non significa che il fornitore non possa elaborare il contenuto per erogare il servizio.
Business conserva i dati in Europa? La novità e l’eccezione americana
Qui serve leggere la documentazione più recente. Nella pagina dove vengono conservati i contenuti di ChatGPT Business, OpenAI dichiara che la scelta della regione è in distribuzione graduale e non è ancora disponibile per tutti.
La regione selezionabile durante l’acquisto riguarda l’archiviazione principale dei contenuti a riposo. Non determina dove viene eseguita l’inferenza, cioè l’elaborazione che produce le risposte.
Soprattutto, OpenAI precisa che, scegliendo una regione fuori dagli Stati Uniti, una copia di ogni prompt e risposta viene comunque conservata temporaneamente negli Stati Uniti per sicurezza, monitoraggio degli abusi e applicazione delle regole.
La pagina non indica una durata numerica di quella conservazione. È una domanda da chiarire con il fornitore prima di approvare dati delicati.
Quindi, se nel tuo acquisto è offerta una regione europea, non leggere quella scelta come una promessa che tutto resti esclusivamente in Europa. E non dare per scontato che un’area Business già esistente sia configurata nella regione desiderata.
Quando serve Enterprise e che cosa significa residenza europea
Enterprise va valutato quando servono una gestione più articolata delle identità e dei permessi, controlli di conformità e requisiti contrattuali specifici. La guida ufficiale per amministratori Enterprise comprende SCIM per gestire gli utenti, ruoli e gruppi, strumenti di audit e integrazione con sistemi di controllo, restrizioni di rete e opzioni come Enterprise Key Management, dove disponibili.
Gli impegni di privacy enterprise prevedono inoltre controlli amministrativi sulla conservazione. Prima dell’acquisto, chiederei quali dati e funzionalità rientrano concretamente nei controlli concordati.
Data residency: contenuti coperti conservati a riposo nella regione configurata.
Inference residency: elaborazione GPU dei contenuti coperti nella stessa regione, se abilitata.
La regione “Europe” comprende Spazio economico europeo e Svizzera. Non significa Italia né esclusivamente i 27 Paesi dell’UE.
Anche con entrambe le opzioni, alcune elaborazioni CPU, come estrazione del testo e instradamento, possono avvenire fuori regione; integrazioni esterne e categorie di metadati hanno regole separate. Occorre verificare anche le funzionalità escluse.
Se il requisito è archiviazione e inferenza GPU europee, valuterei Enterprise con entrambe le opzioni confermate. Se il requisito vieta qualsiasi trattamento fuori dall’UE, non presenterei questa configurazione come sufficiente senza una verifica specifica del perimetro contrattuale e tecnico.
Free, Plus, Business ed Enterprise: una tabella per decidere
Questa è una sintesi operativa della documentazione collegata sopra, non una certificazione di conformità del singolo utilizzo.
Piano
Addestramento
Gestione aziendale
Localizzazione
La mia indicazione
Free personale
Controllabile tramite impostazioni personali
Non equivale a un workspace aziendale
Non assumere garanzie europee
Sperimentazioni autorizzate con dati pubblici o anonimizzati
Plus e Pro personali
Controllabile tramite impostazioni personali
Non sostituisce Business
Il pagamento non dimostra residenza europea
Non li sceglierei per governare dati riservati del team
Business
Escluso per default
Workspace, amministrazione, ruoli, SSO
Scelta della regione in rollout; copie di sicurezza negli USA
Base da valutare per PMI e processi compatibili
Enterprise
Escluso per default
Controlli più articolati
Storage e inferenza regionali per clienti idonei, con esclusioni
Requisiti più stringenti, da configurare e verificare
GDPR: l’abbonamento aiuta, la responsabilità resta all’azienda
Il GDPR, nel testo messo a disposizione dal Garante per la protezione dei dati personali, richiede finalità e basi giuridiche appropriate, minimizzazione, sicurezza e responsabilizzazione. Sono pertinenti gli articoli 5 e 6, il contratto con il responsabile del trattamento previsto dall’articolo 28, le misure dell’articolo 32 e, quando ricorrono i presupposti, la valutazione d’impatto dell’articolo 35.
Il GDPR non impone in generale che ogni dato sia sempre conservato nell’UE: i trasferimenti verso Paesi terzi richiedono il rispetto delle condizioni del Capo V. E conservare un dato in Europa non rende lecito un utilizzo privo di una base giuridica.
OpenAI pubblica un Data Processing Addendum, l’accordo sul trattamento dei dati. Va verificato e formalizzato secondo il percorso applicabile al proprio contratto. Consiglierei di far controllare al referente privacy o al DPO, se nominato, finalità, categorie di dati, subfornitori e trasferimenti effettivi del flusso.
Ricordiamoci anche dei segreti aziendali: un progetto industriale o un listino riservato può richiedere protezione pur senza contenere dati personali. La policy deve coprire entrambi.
Una procedura pratica per usare ChatGPT ogni giorno
Queste sono le regole operative che proporrei a un’azienda prima di distribuire gli accessi.
Scegliere tre attività iniziali. Per esempio riscrivere email, sintetizzare procedure e preparare presentazioni. Definire quali documenti servono davvero.
Classificare i dati. Pubblici, interni, riservati e ad alta criticità. Per ogni categoria indicare strumenti ammessi, persone autorizzate e approvazioni richieste.
Usare l’area aziendale. Ogni persona deve riconoscere il workspace corretto prima di incollare o allegare qualcosa. Evitare account condivisi e credenziali passate tra colleghi.
Gestire gli accessi. Configurare MFA o SSO secondo la policy, ridurre gli amministratori al necessario, verificare cosa succede quando un dipendente cambia ruolo o lascia l’azienda.
Ridurre i dati prima dell’invio. Eliminare informazioni inutili, commenti, revisioni, fogli nascosti e metadati. Controllare il file effettivo che si sta caricando.
Limitare collegamenti e condivisioni. Consentire solo app e GPT approvati, con accessi coerenti con il compito.
Definire conservazione e cancellazione. Stabilire chi gestisce chat, allegati, progetti e memorie, verificando i controlli disponibili nel piano.
Provare il flusso con documenti sintetici. Controllare permessi, risultati e possibili errori prima di passare ai dati reali.
Formare e verificare. Far esercitare le persone sui casi del loro reparto, compreso il riconoscimento delle informazioni da non inviare.
Prevedere un canale per gli incidenti. Se viene caricato il file sbagliato, serve un referente e una procedura; il dipendente deve sapere come segnalarlo subito.
Tre esempi: email, vendite e risorse umane
Attività
Preparazione consigliata
Errore da evitare
Riscrivere un’email a un cliente
Passare il testo necessario, sostituendo identificativi e dettagli superflui
Incollare tutta la catena con recapiti e allegati non pertinenti
Analizzare l’andamento commerciale
Usare dati aggregati o un estratto approvato nel workspace autorizzato
Caricare l’intero CRM per ottenere un semplice grafico
Preparare una procedura HR
Descrivere il processo con un caso fittizio
Usare fascicoli sanitari o disciplinari senza una valutazione specifica
Per dati sanitari, credenziali, chiavi API, informazioni disciplinari o progetti strategici, la mia regola iniziale sarebbe: non caricarli nel flusso ordinario. Un eventuale impiego richiede un progetto dedicato e l’approvazione delle funzioni competenti.
Anonimizzare prima di caricare, non dopo
Chiedere a ChatGPT di anonimizzare il documento originale comporta già l’invio del documento. Per evitare quella trasmissione, la preparazione deve avvenire prima, con strumenti e procedure approvati dall’azienda.
Sostituire “Maria Rossi” con “Dipendente 17” non basta se ruolo, ufficio e vicenda permettono comunque di riconoscerla. Il GDPR distingue la pseudonimizzazione dai dati resi effettivamente anonimi: la prima resta nel suo ambito di applicazione.
Un esercizio utile arriva dal video ufficiale di OpenAI Academy su privacy e informazioni da non condividere: partire da una bolletta e individuare quali dettagli servono per la domanda. Lo proporrei in aula con una fattura fittizia, prima di passare ai documenti dell’azienda.
OpenAI Academy: quali informazioni evitare di condividere e quando verificare le risposte.
Connettori e agenti: verificare anche la destinazione successiva
Collegare ChatGPT alla posta, a Drive o al CRM aggiunge un altro passaggio al flusso. La documentazione sui controlli di plugin e servizi connessi spiega che contano i permessi dell’account autorizzato e che il servizio esterno applica le proprie condizioni di conservazione, trattamento e residenza.
Per questo partirei con un servizio alla volta e con sole operazioni di lettura. Prima di consentire invii, scritture o pubblicazioni, farei verificare destinatari, ambito dei permessi e possibilità di recuperare da un errore. Un agente autorizzato a leggere l’intera casella e spedire email ha esigenze diverse da un chatbot che corregge una bozza.
Anche la cancellazione va controllata per posizione: la guida alla sicurezza di ChatGPT Work chiarisce che eliminare una conversazione, un file salvato, una memoria e una connessione sono azioni separate. Non presumere che la cancellazione della chat elimini ogni copia del lavoro.
Se serve un’applicazione su misura: le API hanno regole proprie
Le API di OpenAI possono essere una strada per costruire un assistente interno con controlli definiti dal progetto. La documentazione ufficiale sui controlli dei dati API prevede residenza regionale e opzioni come Zero Data Retention per clienti, endpoint e funzionalità idonei.
Non basta però scrivere “API” nel preventivo: vanno verificati configurazione regionale, conservazione, compatibilità delle funzioni e log dell’applicazione sviluppata. Zero Data Retention nelle API non è una proprietà generale di ChatGPT Business o Enterprise.
Se l’organizzazione richiede che un certo documento non esca mai dal proprio perimetro, valuterei con l’IT anche un’architettura interna. Bisogna verificare l’intero flusso, compresi telemetria, backup e servizi esterni eventualmente usati.
La scelta che consiglierei a un’azienda
Per iniziare con attività ordinarie e informazioni compatibili con le condizioni del servizio, valuterei Business insieme a una policy concreta. Per requisiti più stringenti di identità, audit, conservazione e localizzazione, valuterei Enterprise con configurazione e contratto verificati.
Prima di firmare chiederei una risposta scritta su quattro punti: dati coperti, copie ed eccezioni, luoghi di archiviazione ed elaborazione, tempi di conservazione. E farei approvare tre casi d’uso reali, non soltanto il nome del prodotto.
La prova finale la farei con un dipendente: “Devi sintetizzare questo documento. Quale account apri? Quali parti rimuovi? Puoi collegare il CRM? Chi controlla la risposta?”. Se non sa rispondere, manca ancora un pezzo dell’adozione.
Nel mio corso ChatGPT per aziende e professionisti lavoro anche su queste decisioni: partire dai processi, preparare i documenti e costruire abitudini che permettano di usare l’AI senza improvvisare sui dati.
Scrivimi per organizzare un evento o un corso sull’intelligenza artificiale generativa
Mandami un WhatsApp al 339.6325418 per organizzare un corso o una conferenza sull’A.I. generativa.
https://www.gianluigibonanomi.com/wp-content/uploads/2026/10/chatgpt-azienda-proteggere-dati.webp9001600Gianluigi Bonanomihttps://www.gianluigibonanomi.com/wp-content/uploads/2018/10/bonanomi_logo_156.pngGianluigi Bonanomi2026-10-08 12:18:072026-10-28 15:28:02ChatGPT in azienda: come proteggere i dati
Questo sito usa cookie tecnici e, solo con il tuo consenso, cookie di analisi, pubblicità e contenuti di terze parti (YouTube, Substack, Google). Puoi accettare, rifiutare o scegliere nelle impostazioni. Privacy policy
Potremmo richiedere che i cookie siano attivi sul tuo dispositivo. Utilizziamo i cookie per farci sapere quando visitate i nostri siti web, come interagite con noi, per arricchire la vostra esperienza utente e per personalizzare il vostro rapporto con il nostro sito web.
Clicca sulle diverse rubriche delle categorie per saperne di più. Puoi anche modificare alcune delle tue preferenze. Tieni presente che il blocco di alcuni tipi di cookie potrebbe influire sulla tua esperienza sui nostri siti Web e sui servizi che siamo in grado di offrire.
Cookie essenziali del sito Web
Questi cookie sono strettamente necessari per fornirvi i servizi disponibili attraverso il nostro sito web e per utilizzare alcune delle sue caratteristiche.
Poiché questi cookie sono strettamente necessari per fornire il sito web, rifiutarli avrà un impatto come il nostro sito funziona. È sempre possibile bloccare o eliminare i cookie cambiando le impostazioni del browser e bloccando forzatamente tutti i cookie di questo sito. Ma questo ti chiederà sempre di accettare/rifiutare i cookie quando rivisiti il nostro sito.
Rispettiamo pienamente se si desidera rifiutare i cookie, ma per evitare di chiedervi gentilmente più e più volte di permettere di memorizzare i cookie per questo. L’utente è libero di rinunciare in qualsiasi momento o optare per altri cookie per ottenere un’esperienza migliore. Se rifiuti i cookie, rimuoveremo tutti i cookie impostati nel nostro dominio.
Vi forniamo un elenco dei cookie memorizzati sul vostro computer nel nostro dominio in modo che possiate controllare cosa abbiamo memorizzato. Per motivi di sicurezza non siamo in grado di mostrare o modificare i cookie di altri domini. Puoi controllarli nelle impostazioni di sicurezza del tuo browser.
Cookie di Google Analytics
Questi cookie raccolgono informazioni che vengono utilizzate sia in forma aggregata per aiutarci a capire come viene utilizzato il nostro sito web o quanto sono efficaci le nostre campagne di marketing, o per aiutarci a personalizzare il nostro sito web e l'applicazione per voi al fine di migliorare la vostra esperienza.
Se non vuoi che tracciamo la tua visita al nostro sito puoi disabilitare il tracciamento nel tuo browser qui:
Altri servizi esterni
Utilizziamo anche diversi servizi esterni come Google Webfonts, Google Maps e fornitori esterni di video. Poiché questi fornitori possono raccogliere dati personali come il tuo indirizzo IP, ti permettiamo di bloccarli qui. Si prega di notare che questo potrebbe ridurre notevolmente la funzionalità e l’aspetto del nostro sito. Le modifiche avranno effetto una volta ricaricata la pagina.
Google Fonts:
Impostazioni Google di Enfold:
Cerca impostazioni:
Vimeo and Youtube video embeds:
Altri cookies
Sono necessari anche i seguenti cookie - Puoi scegliere se permetterli:
Privacy Policy
Puoi leggere i nostri cookie e le nostre impostazioni sulla privacy in dettaglio nella nostra pagina sulla privacy.